70 萬參數逆襲千億巨獸!Cua 重磅開源首款電腦控制「系統一」模型 CUA-S1-FORMS:2.8MB 極限輕量、單次前向平行填表與終結雲端 LLM 延遲深度解析
當前 Computer Use 陷入「用千億參數雲端大模型點擊輸入框」的算力與延遲泥淖!YC S25 孵化團隊 Cua 正式開源首款系統一模型 CUA-S1-FORMS。僅 706k 參數、2.8 MB 檔案大小,捨棄逐字自回歸生成,單次前向瞬間平行打分;實測合成準確率 99.95%、真實表單 100% 滿分命中,全面超越 TypeSafe Jev API!本文深度拆解 TinyTransformerScorer 架構、反混淆數據集引擎、Cua Driver 本地零延遲後台執行,以及混合 Agent 車隊未來。
「讓一個動輒數千億參數、需要數秒鐘思考的雲端通用大型語言模型(LLM),去螢幕上一格格尋找電話號碼輸入框並填入數字,無異於開著波音 747 客機去巷口便利商店買醬油。
當任務邊界明確、結構受限時,軟體需要的不是滔滔不絕的對話侍從,而是瞬間給出精確決策的輕量級神經反射。
今天我們開源 CUA-S1-FORMS——只有 70 萬個參數、2.8 MB,單次前向傳播瞬間完成全表單決策,直接由 Cua Driver 在後台完成靜默輸入。這正是專用『系統一模型』該有的樣子。」
—— Cua 官方開發團隊(2026 年 9 月 19 日)
在過去這一年中,「電腦控制(Computer Use)」無疑是全球 AI 最炙手可熱的聖杯戰場。
從 Anthropic 的 Claude 3.5 / 3.7 Sonnet Computer Use、OpenAI 的 Operator,到 Google 的 Project Jarvis 與微軟的各類桌面代理,科技巨頭們描繪了一幅充滿未來感的願景:讓 AI 像人類一樣盯著螢幕、移動滑鼠、敲擊鍵盤,自主操作複雜的企業軟體。
然而,當這套方案真正落地到企業與開發者的日常自動化管線中時,所有人卻遭遇了一堵難以逾越的現實之牆:
- 🐢 極致緩慢的反應延遲:填寫一份包含 10 個欄位的簡單醫療掛號或報稅表單,雲端大模型必須截圖 10 次、上傳雲端 10 次、透過長思考鏈思考 10 次,耗時往往長達 1 到 3 分鐘;
- 💸 令人咋舌的 Token 帳單:每截一張高解析度螢幕截圖並發送給前沿多模態模型,都需要燃燒數千個視覺 Token;一份表單填下來,成本動輒 0.5 到 2 美元;
- 💥 令人焦慮的脆弱性與搶滑鼠地獄:自回歸文字生成隨時可能產生幻覺(生成不存在的電話號碼或欄位名),而在操作過程中,Agent 的游標常常與使用者的滑鼠搶奪焦點,讓電腦瞬間處於無法操作的癱瘓狀態。
這正是前 OpenAI 核心架構師、ChatGPT 共同發明人 Diogo Almeida 幾天前創立 TypeSafe AI 時所痛斥的**「無馬馬車謬誤」**——我們硬把擅長聊天創作的通用大模型(系統二),塞進了需要即時反應、強型別安全的邊界操作中。
但 TypeSafe AI 旗下的系統一模型 Jev 仍是閉源商業雲端服務。就在全球開發者渴望驗證「系統一是否真能在本地跑通」的關鍵時刻,矽谷知名開源 AI 基礎設施團隊 Cua(YC S25) 投下了一記震撼彈:
Cua 官方於 2026 年 9 月 19 日正式宣布開源 CUA-S1 家族首款專用模型——CUA-S1-FORMS!
與此同時,Cua 同步將完整的合成數據生成器、訓練管線、評估套件與原生 Cua Driver 後台執行器全面以 MIT 授權開源。
這款專為表單填寫量身定做的專用模型,繳出的規格與表現徹底打破了現代 AI 的常規認知:
- 🪶 極限羽量化:僅 706,048 個參數(約 70 萬參),權重檔案僅 2.8 MB!比一張 iPhone 隨手拍的照片還要小;
- ⚡ 單次前向平行打分(One-Pass Option Scorer):完全拋棄逐字吐出 Token 的自回歸解碼,全表單元素在單一 Batch 中平行打分,推論延遲僅數毫秒;
- 🎯 碾壓閉源前輩的實測表現:在 15,000 次決策的嚴苛合成測試集上奪得 99.95% Top-1 準確率;在包含真實 PDF(轉診單、履歷表、警方報案單)的真實跨領域驗證中繳出 100% 滿分,正面對決中以 99.7% 擊潰官方託管的閉源 Jev API(83.6%);
- 💻 100% 本地運算,零 Token 成本與極致隱私:在普通筆電的 CPU 或 Apple Silicon MPS 上即可全速運轉,完全無需聯網、無需雲端 API Key,敏感醫療與財務數據足不出戶!
本文將帶你深入這場「小模型逆襲千億巨獸」的工程奇蹟,深度拆解 CUA-S1-FORMS 的模型架構、抗混淆合成數據生成引擎、Cua Driver 靜默操作黑科技,以及「系統一 + 系統二」混合 Agent 車隊將如何重寫自動化的未來。
一、傳統雲端 LLM Computer Use vs. Cua-S1-Forms:全維度技術對決
要理解 CUA-S1-FORMS 帶來的顛覆性突破,我們先透過下表對比傳統雲端通用多模態 LLM 與 Cua-S1 系統一架構在 GUI 表單填寫任務上的本質差異:
| 評測核心維度 | 傳統雲端通用多模態 Agent(如 Claude Computer Use / Operator) | Cua-S1-Forms 系統一專用模型(結合 Cua Driver) | 革命性突破與工程效益 |
|---|---|---|---|
| 參數量級 | 數百億 ~ 數千億參數(龐大肥碩) | 706,048 參數(約 70 萬,極致羽量) | 參數量縮小 100,000 倍以上 |
| 模型權重大小 | 數十 GB 至數百 GB(需雲端叢集承載) | 僅 2.8 MB(cua-s1-forms.pt) |
輕如一張普通 JPG,能塞進任何邊緣設備 |
| 推論解碼機制 | 逐字自回歸(Autoregressive Token-by-Token) | 非自回歸單次前向(One-Pass Option-Attention Scorer) | 告別文字生成循環,單次前向傳播平行產出所有欄位機率 |
| 填寫表單交互流程 | 逐步循環:截圖 ➔ 上傳 ➔ 思考 ➔ 點擊 ➔ 重複十數次 | 批次決策:單次快照解析 ➔ 平行全表打分 ➔ 下游代碼排序執行 | 決策次數從 O(N) 驟降至 O(1) |
| 端到端執行延遲 | 30 秒 ~ 180 秒(網絡傳輸 + 視覺編碼 + 思考解碼) | 數十毫秒至數百毫秒(推論 < 10ms) | ⚡ 速度提升 100 ~ 1,000 倍,達到真實軟體 SLA 要求 |
| 推論硬體要求 | 雲端高端 GPU 叢集(8×H100 / 雲端 API 依賴) | 本地普通 CPU、Mac Apple Silicon(MPS)或入門 GPU | 零硬體門檻,完全擺脫昂貴伺服器租賃 |
| 每單次表單成本 | 約 $0.50 ~ $2.00 美元(昂貴 Vision Token) | $0.00 完全免費(本機計算,零 Token 消耗) | 💸 營運成本直接歸零,高頻自動化不再燒錢 |
| 文字幻覺風險 | 高(可能生成不存在的電話號碼、錯位貼上、拼寫錯誤) | 絕對為零(Zero Hallucination) | 模型本身不具備文字生成能力,僅從提取實體中選擇指針 |
| 桌面交互模式 | 前台霸占游標、模擬點擊,使用者無法同時使用電腦 | Cua Driver 背景分發(Background Delivery) | 靜默注入數值,不搶奪滑鼠焦點、不移動使用者游標 |
| 安全邊界 | 難以預測的自由行為,可能誤點「送出」或刪除資料 | 規劃與執行嚴格解耦,預設 Dry-Run,Submit 需顯式授權 | 軟體工程級的安全後置驗證與 Fail-Closed 保障 |
官方實測對決錄影:專用模型 CUA-S1 vs. 通用 LLM Agent
在官方發布的實機對比測試中,Cua 團隊清楚展示了這兩種截然不同的架構在處理相同表單時的巨大落差:
Cua 官方實測對決錄影:左側專用模型 CUA-S1-FORMS 單次前向打分瞬間決定填寫方案,由 Cua Driver 依序執行;右側通用 LLM Agent 仍在一步步截圖、思考並呼叫驅動器緩慢填表。影片來源:Cua(@trycua)官方展示。
二、為什麼雲端 LLM 搞表單填寫是「殺雞用牛刀」?
要看懂 Cua 團隊為什麼花精力做這款 70 萬參數的小模型,首先要理解當前主流 Computer Use 在企業真實業務中的巨大挫敗。
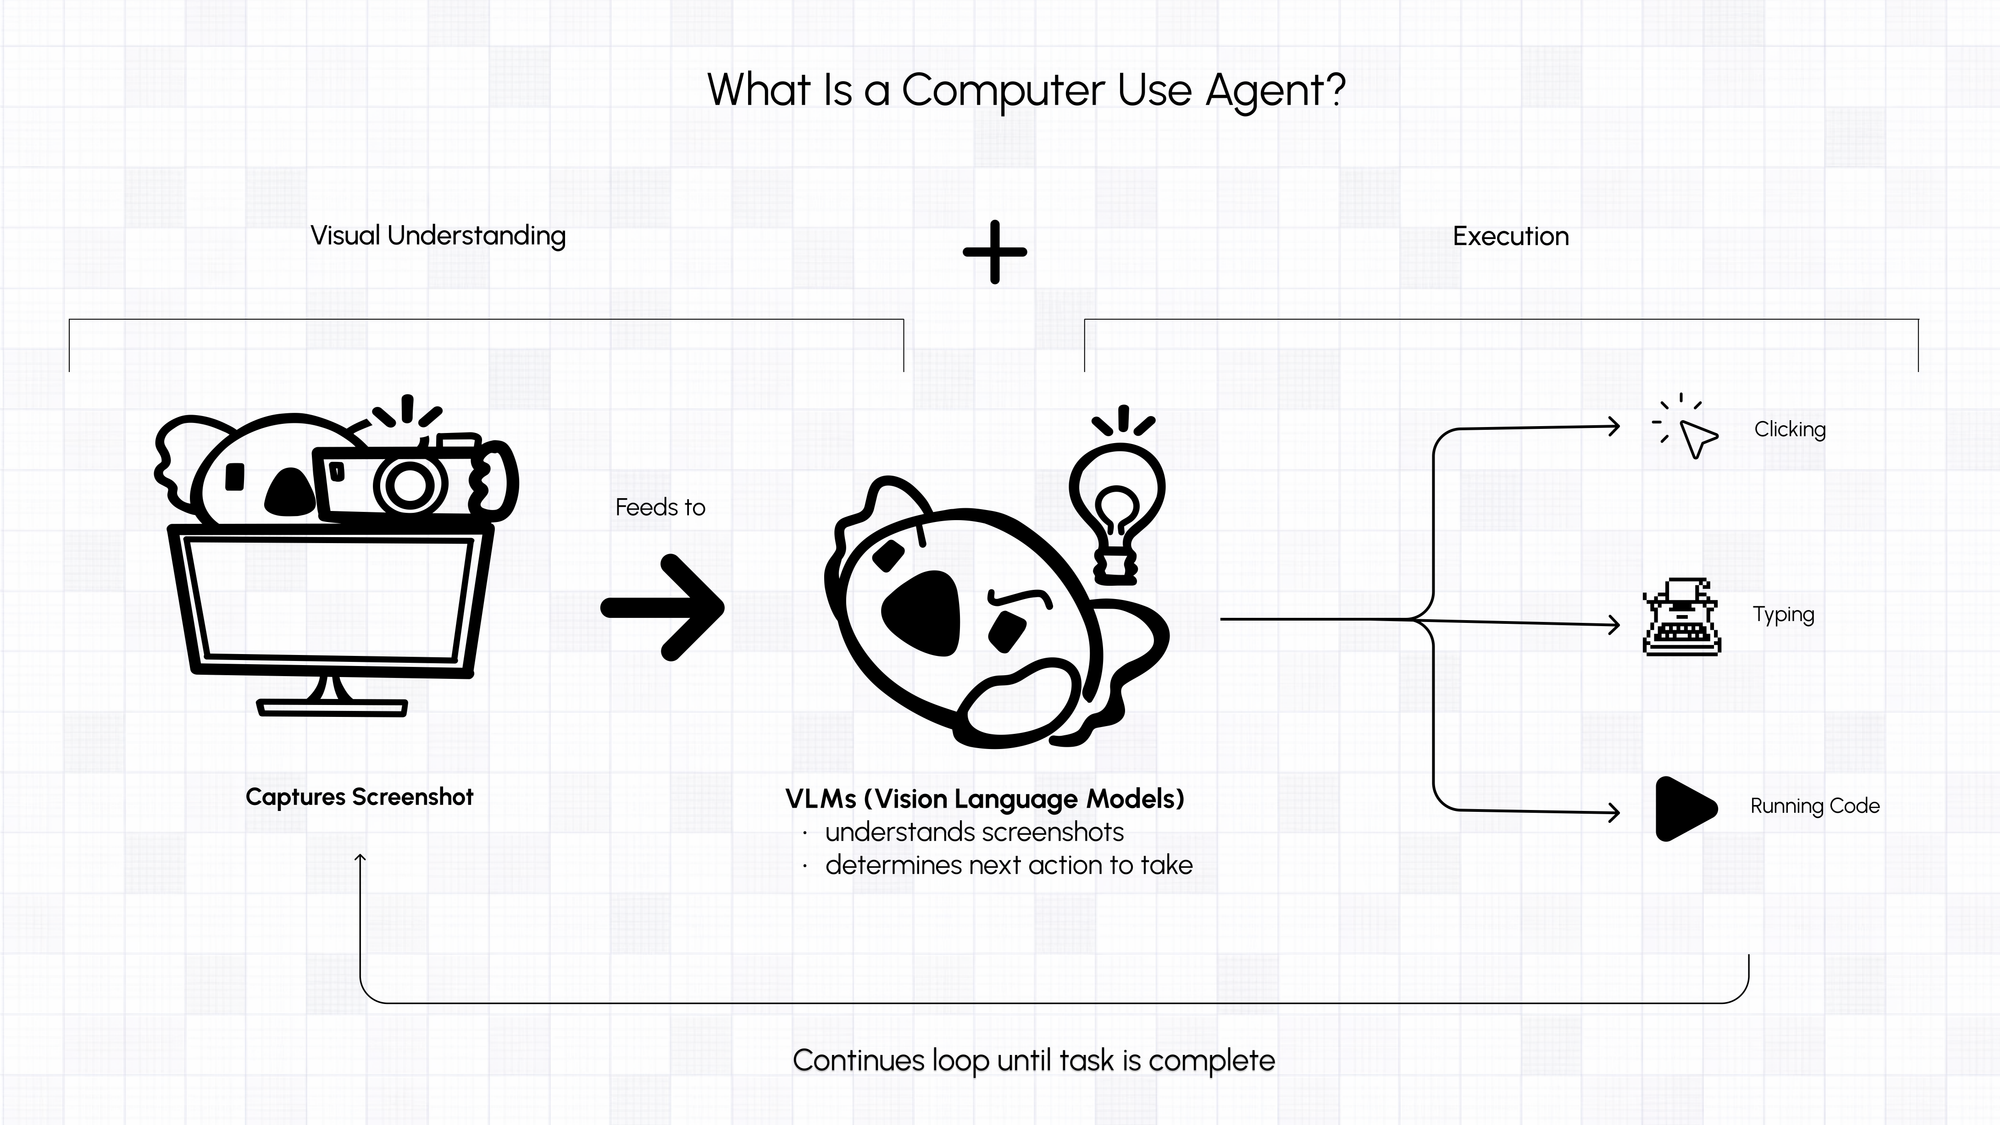
1. 痛苦的「逐步自回歸」迴圈
在目前基於 Anthropic 或 OpenAI 的 Computer Use 架構中,填寫一份網頁表單的過程堪稱一場滑稽的慢動作默劇:
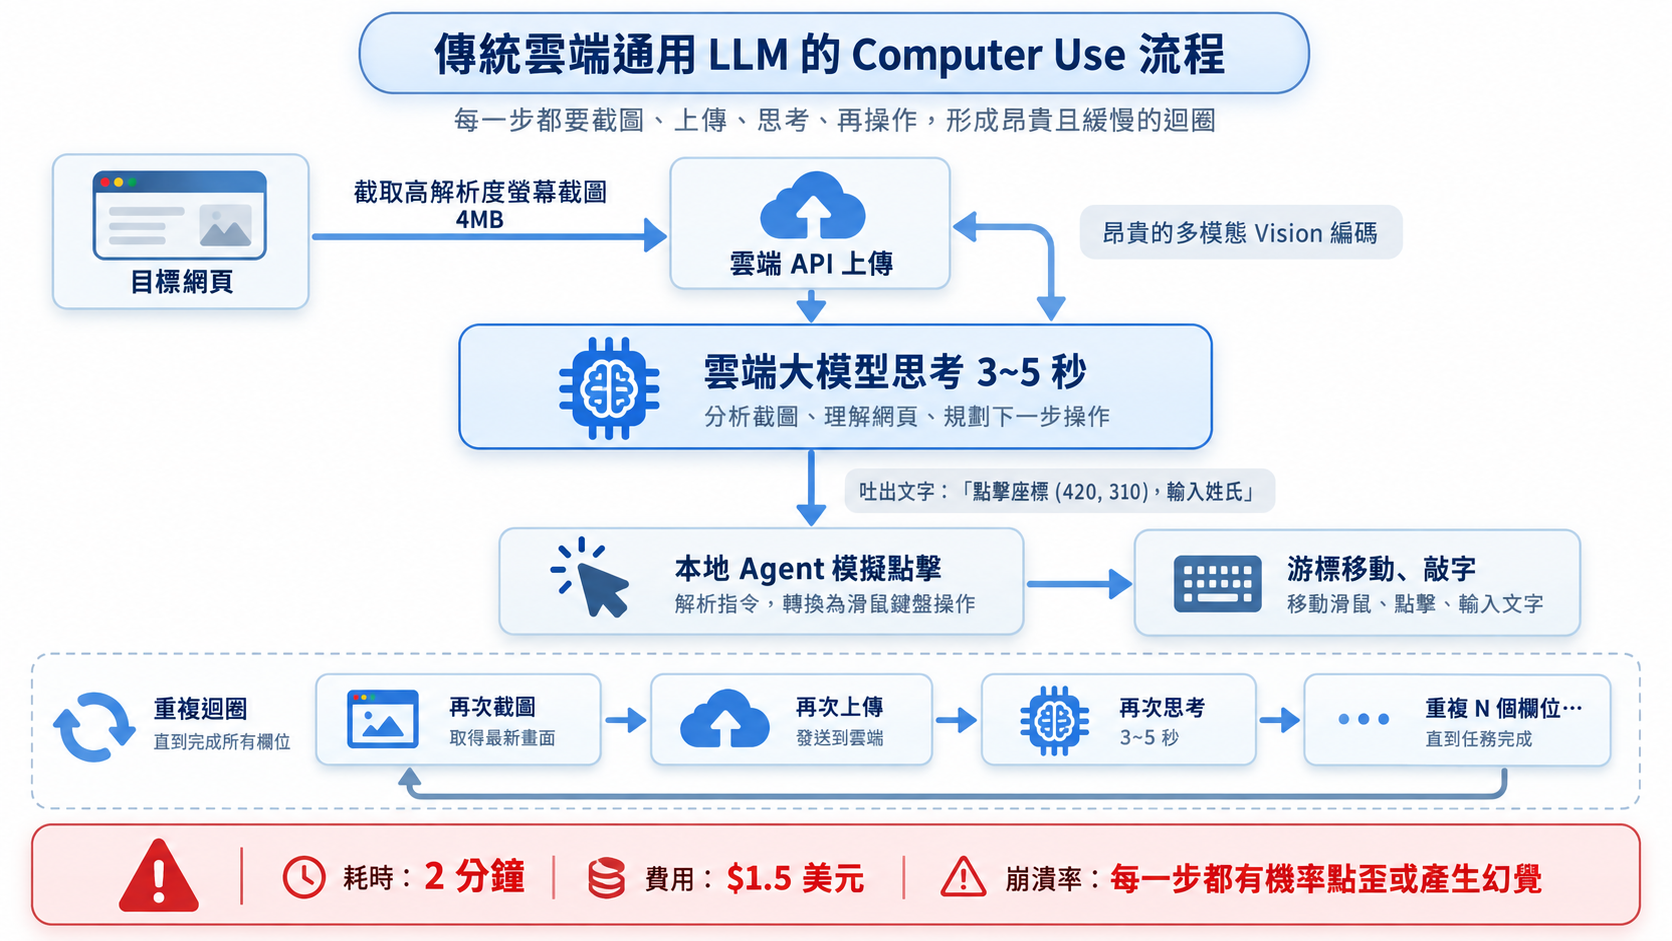
這種架構的根本病灶在於:把一個本質上是「實體對齊(Entity Matching)」的型別映射任務,偽裝成了一場開放式的視聽對話!
當前表單需要輸入「聯絡電話」,而你的資料來源(例如患者的轉診 PDF 或求職者的履歷)中明明白白寫著 Tel: (503) 555-0142。這本質上只需要一個大腦突觸瞬間將「Phone number」與「Tel」綁定,但傳統 LLM 卻必須把整個畫面重新編碼,逐字輸出 {"action": "type", "text": "(503) 555-0142"}。
這不僅造成了高達數萬倍的算力浪費,更讓即時工作流變得無法忍受。
2. 游標奪取與焦點災難
另一個致命痛點是作業系統級的交互霸凌。
一般的 Computer Use 腳本使用 PyAutoGUI 或類似工具,透過模擬 OS 級別的滑鼠移動與按鍵。當 Agent 正在填寫表單時,使用者的滑鼠會被瘋狂搶奪,鍵盤輸入會被中途打斷。你只要試圖切換視窗,Agent 就可能把病患的身分證字號輸入到你的 Slack 聊天視窗裡!
這意味著:只要 Agent 在工作,這台電腦就不能被人類使用。這直接粉碎了「AI 助理在背後幫我處理雜事」的浪漫幻想。
三、解剖 2.8 MB 的神經反射:TinyTransformerScorer 架構拆解
Cua 團隊交出的答案不是繼續訓練一個 7B 或 14B 的端側小模型,而是做到了極致的減法——70 萬參數的 TinyTransformerScorer(代號 tinyx)。
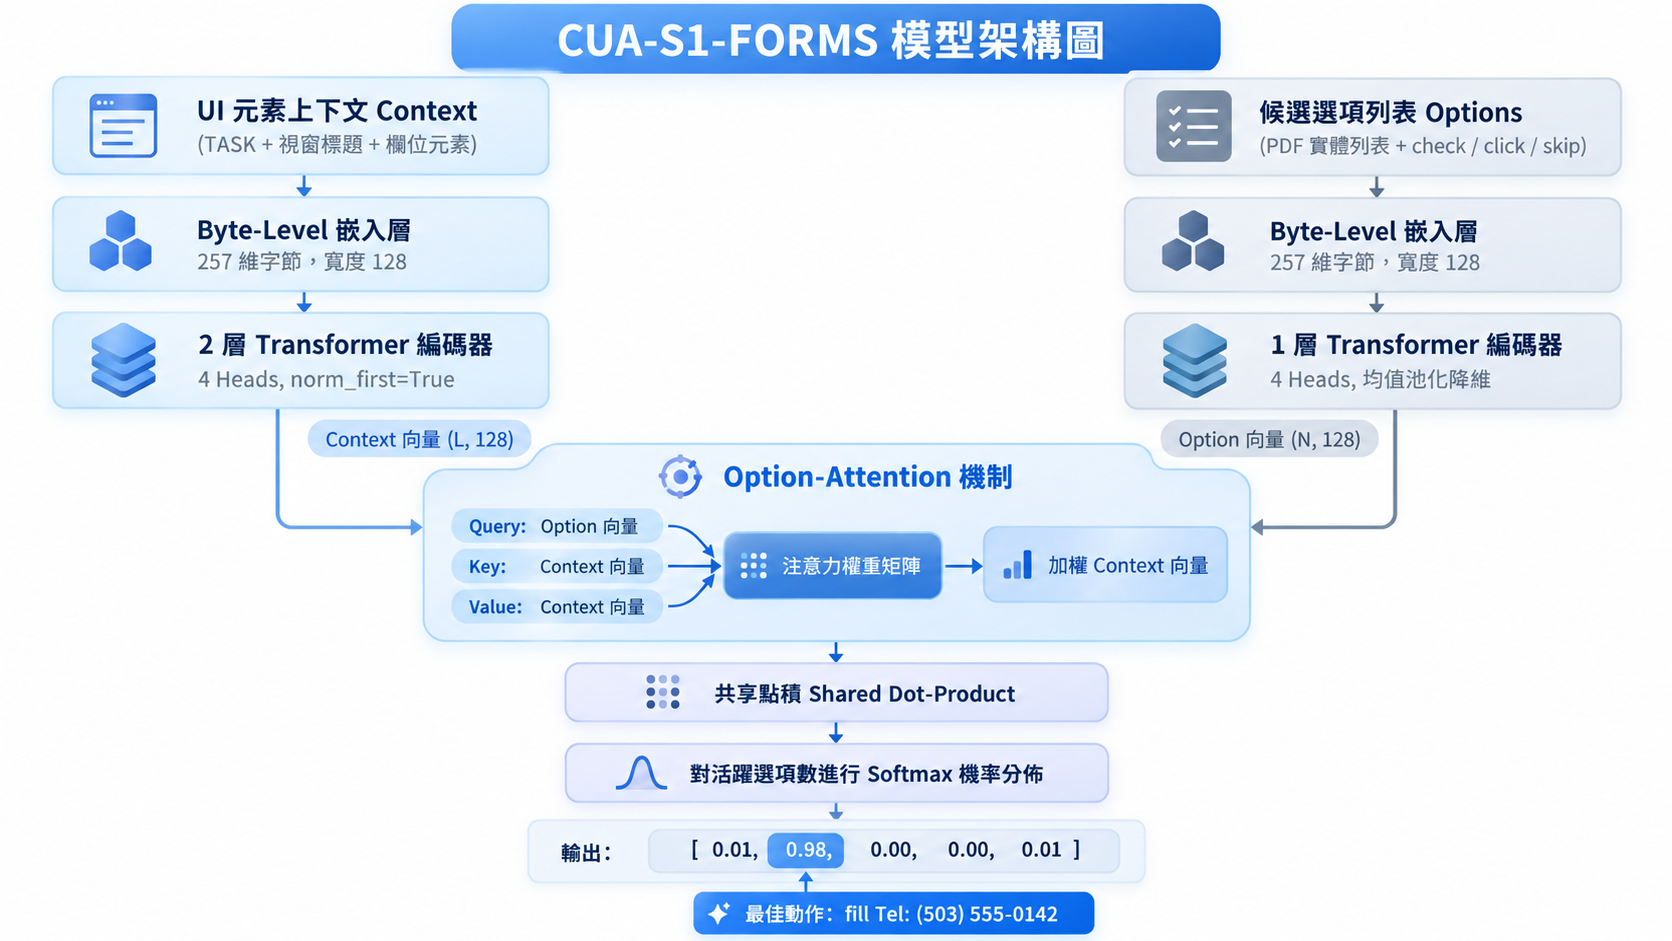
在官方開源代碼 libs/cua-s1/python/src/cua_s1/model.py 中,我們可以看到這款架構精巧而純粹的神經符號設計:
1. 徹底告別 Tokenizer:原生 Byte-Level 嵌入
大模型常常因為分詞器(Tokenizer)對罕見符號、特殊號碼或跨語言單詞切分不均而崩潰。CUA-S1-FORMS 乾脆捨棄了複雜的分詞字典,採用 257 維的字節級嵌入(Byte-level Embedding,256 個 ASCII/UTF-8 字節 + 1 個 Padding 標記)。
- 上下文長度(Context Tokens)截斷至 224 個字節;
- 選項長度(Option Tokens)截斷至 96 個字節。
這意味著無論表單標籤長得多麼古怪,模型都能在底層字節維度穩定感知,永不會觸發「未登錄詞(Out-of-Vocabulary)」錯誤,且詞表參數開銷幾乎為零。
2. 雙軌 Transformer 編碼器
模型內部包含兩條輕量編碼路徑:
- Context Encoder:一個 2 層的標準 Transformer Encoder(隱藏維度 128,4 個注意力頭,前饋網路擴展 4 倍至 512 維),專門用來理解當前的「任務目標 + 視窗標題 + UI 元素角色與標籤」;
- Option Encoder:一個僅 1 層的 Transformer Encoder,用來對輸入的候選選項進行編碼,並透過 Masked Mean-Pooling 獲得每個選項的語意向量。
3. Option-Attention 與單次前向平行評分
最核心的創新在於 AttentionHead: 它將每一個 Option 當作一個 Query,對 Context 的 Token 序列進行交叉注意力查詢(Cross-Attention),產生一個被該選項聚焦的「上下文向量(Attended Context Vector)」;接著,透過共享點積運算,計算出每個選項的原始得分(Logit),最後對當前活躍的選項數量進行 Softmax 歸一化。
這帶來了兩個革命性的特性:
- 輸入/輸出契約完全型別化:模型輸出的是一組長度與選項相等的機率值。下游系統只需要取
argmax,就能精準知道該對這個欄位執行什麼動作,完全不需要編寫脆弱的正則表達式去解析 LLM 吐出來的髒字串; - 全表單全並行處理:在一張表單上有 10 個或 20 個輸入框?沒問題!系統可以把這 20 個元素打包成一個 Batch,在一次前向傳播(Single Forward Pass)中,花費不到 10 毫秒同時完成全表單所有欄位的打分!
四、對抗欺騙與拒絕死記:反混淆數據引擎(The Confuser Engine)
很多工程師的第一直覺是:一個 70 萬參數的小模型,會不會只是在死記硬背關鍵字?如果遇到相似的欄位,它會不會像弱智一樣隨便亂填?
Cua 團隊在開源資料庫中揭示的合成數據生成引擎(cua_s1/synth.py),展示了教科書級別的數據工程技藝。
1. 55 大現實概念圖譜與同義詞目錄
在 cua_s1/concepts.py 中,團隊建立了一個包含 55 種企業表單核心概念的龐大圖譜(涵蓋姓名、身分證字號、診斷代碼、保單號碼、住址、電子郵件、緊急聯絡人電話等)。
每個概念都具備獨立的表單標籤庫(form_labels)與文件標籤庫(doc_labels)。例如對於電話號碼:
- 表單端可能顯示:
Phone、Phone number、Tel、Telephone、Mobile、Cell; - 文件端可能寫著:
Contact Number、Phone、Tel:、Cellular。
生成器在合成每個訓練樣本(Episode)時,會獨立隨機採樣兩端的標籤,強迫模型學習「語意對齊」,而不是死記單詞。
Cua 官方 Demonstration Recorder 實錄:高精度捕捉真實桌面環境中的 UI 元素代碼、事件序列與座標快照,為系統一模型提供高品質行為軌跡。影片來源:Cua 官方發布。
2. 強制注入「混淆陷阱對(Look-Alike Confuser Pairs)」
為了防止模型走捷徑(例如看到「phone」就閉著眼睛填入第一個電話),生成引擎設計了惡意度極高的強混淆對抗機制:
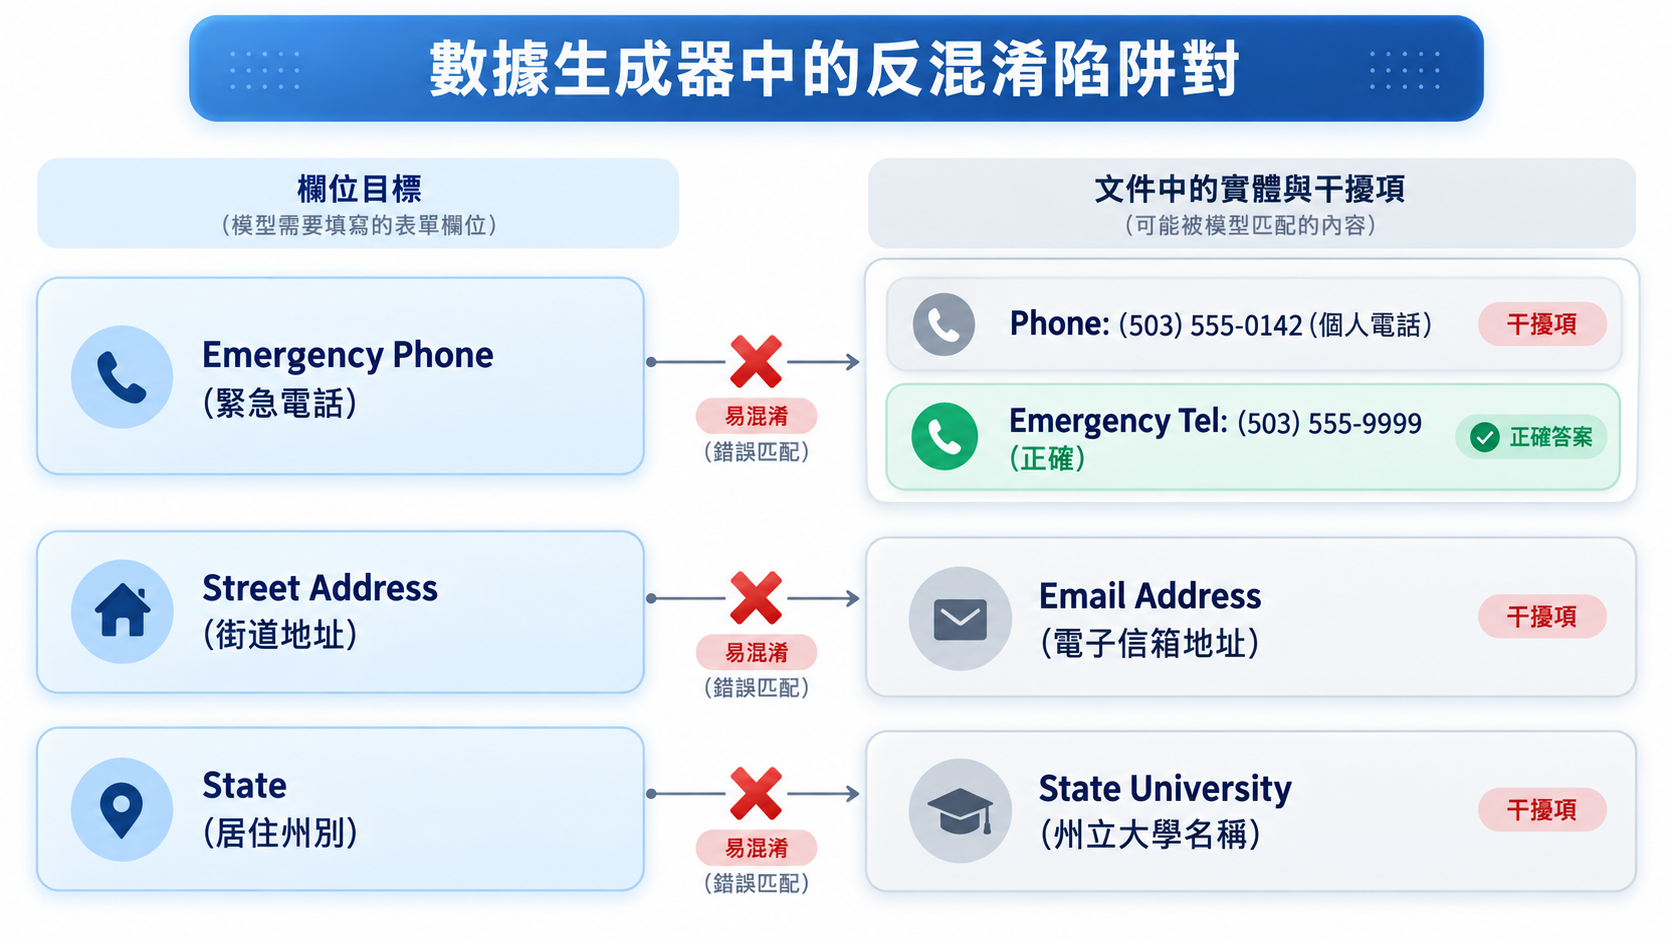
如果在生成過程中採樣了某個概念,生成器會強制在其對應的文件中注入其外觀極其相似的混淆項(Confusers):
- 遇到「個人電話」時,同時在文件中塞入「緊急聯絡人電話」與「公司傳真」;
- 遇到「住家地址」時,塞入包含 address 單詞的「電子郵件地址」;
- 遇到「州別(State)」時,塞入畢業學校「State University」。
此外,生成器還隨機為視窗標題加上不同的軟體後綴(如 - JevBrowser、- Google Chrome),甚至有 20% 的機率完全丟棄視窗標題(Title Dropout),確保模型即便在未知瀏覽器中也能靠欄位特徵做出正確決斷。
3. 表單簽名嚴格隔離(Form-Signature Disjoint)
在切分訓練集(15 萬行)、驗證集(1.8 萬行)與測試集(2 萬行)時,Cua 採用了嚴苛的 表單簽名不相交(Disjoint by Exact Form Field Signature) 規則:
任何出現在測試集中的表單欄位組合,在訓練集中絕對從未出現過! 這徹底排除了過擬合記憶表單結構的可能性,驗證的是模型面對未知表單時的零樣本(Zero-Shot)泛化能力。
五、實測天梯榜:全面碾壓 TypeSafe Jev API 的硬核數據
Cua 團隊在開源倉庫與 Hugging Face 上公布了詳盡的評估階梯(Evaluation Ladder):
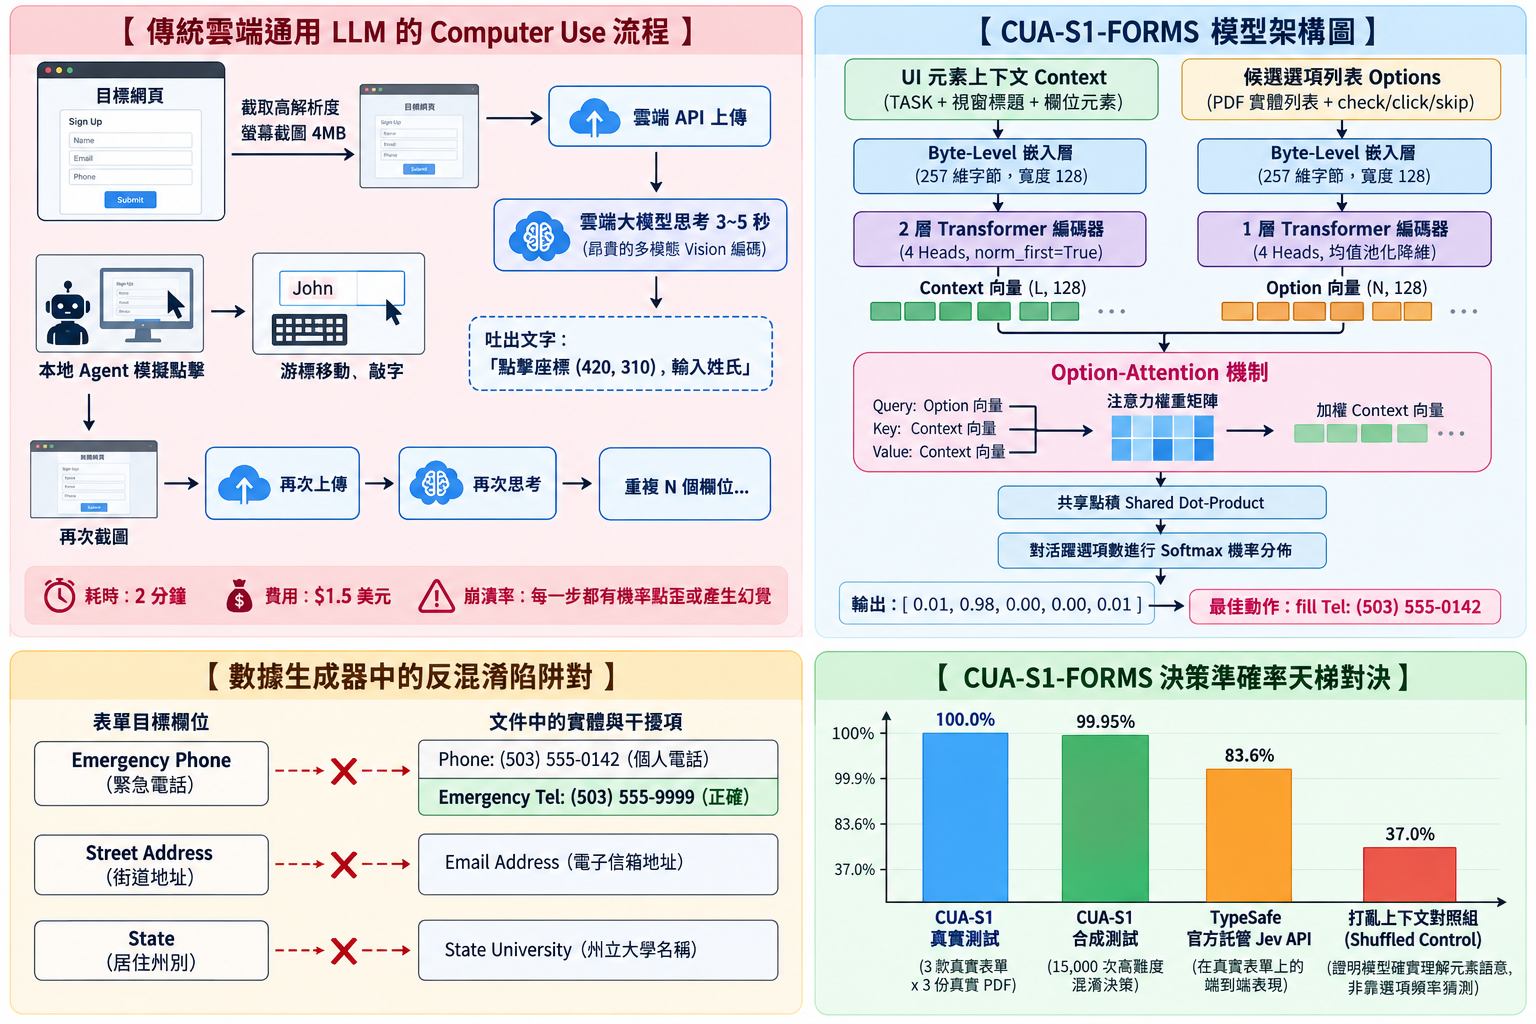
1. 合成測試集:99.95% 的近乎完美表現
在包含 15,000 次表單決策的無交集合成測試集上,CUA-S1-FORMS 取得了 99.95% 的 Top-1 準確率。即便在被刻意安排的「個人電話 vs 緊急電話」雙重陷阱中,模型依然能精準鎖定正確的實體指針。
2. 真實世界跨領域測試:100% 滿分遷移
為了檢驗模型是否只是「合成數據裡的做題家」,團隊使用 demo.jsonl 進行了完全不包含任何合成數據的真實測試:
- 3 款真實的 JevBrowser 表單頁面;
- 3 份真實世界的複雜 PDF 文件:一份醫療轉診信函(Referral Letter)、一份工程師履歷表(Résumé)、一份警方事故調查報告(Police Incident Report);
- 透過開源工具
pdfplumber進行非結構化實體抽取,共計 196 次真實決策。
測試結果:CUA-S1-FORMS 達成了 100%(196 / 196)全部命中的完美戰績!
3. 對決閉源鼻祖:擊敗 TypeSafe Jev API
團隊更進行了精彩的「正面硬碰硬」測試:在相同的真實表單任務下,調用 TypeSafe AI 的官方託管服務 jev-latest(零微調)進行盲測對比:
- CUA-S1-FORMS 整體準確率:99.7%
- TypeSafe Jev API 整體準確率:83.6%
深入分析其差距根源非常有趣: 在純粹需要語意判斷的「選擇填入實體 vs 勾選 Checkbox vs 點擊按鈕」上,Jev 的表現相當優異,拿到了 96%;但 Jev 在處理一個常見的業務邏輯時遭遇滑鐵盧——當某個欄位已經被填寫了正確內容時,該動作應被視為「No-op(略過 / Skip)」。Jev 缺乏這項明確的約定訓練,在該情境下頻頻失分(準確率僅 74%),而 CUA-S1-FORMS 則完美處理了欄位預填的防禦邏輯。
4. 嚴格的打亂上下文控制組(Shuffled-Context Control)
是否有可能候選選項列表中只有一個像電話號碼,模型根本沒看表單在問什麼?
研究團隊進行了嚴謹的科學對照實驗:將輸入的元素上下文隨機打亂(Shuffled Context),模型準確率瞬間從 99.95% 崩跌至 37%!這決定性地證明了:模型不是在投機取巧猜測選項類型,而是扎扎實實地理解了表單標籤與實體之間的語意映射。
六、解答社群靈魂拷問:填表是本地還是回雲端?
在 Cua 發布開源推文後,社群開發者 @JasonC_Dev 立即提出了一個所有工程師最關心的核心疑問:
「小模型開源了。填表這一步是本地推理,還是 Driver 還得回雲端?」
答案非常明確,而且足以讓所有注重隱私與成本的企業興奮:
從推論到執行,100% 全程在本地運行,零字節回傳雲端!
這是一套完全閉環的本地化架構:
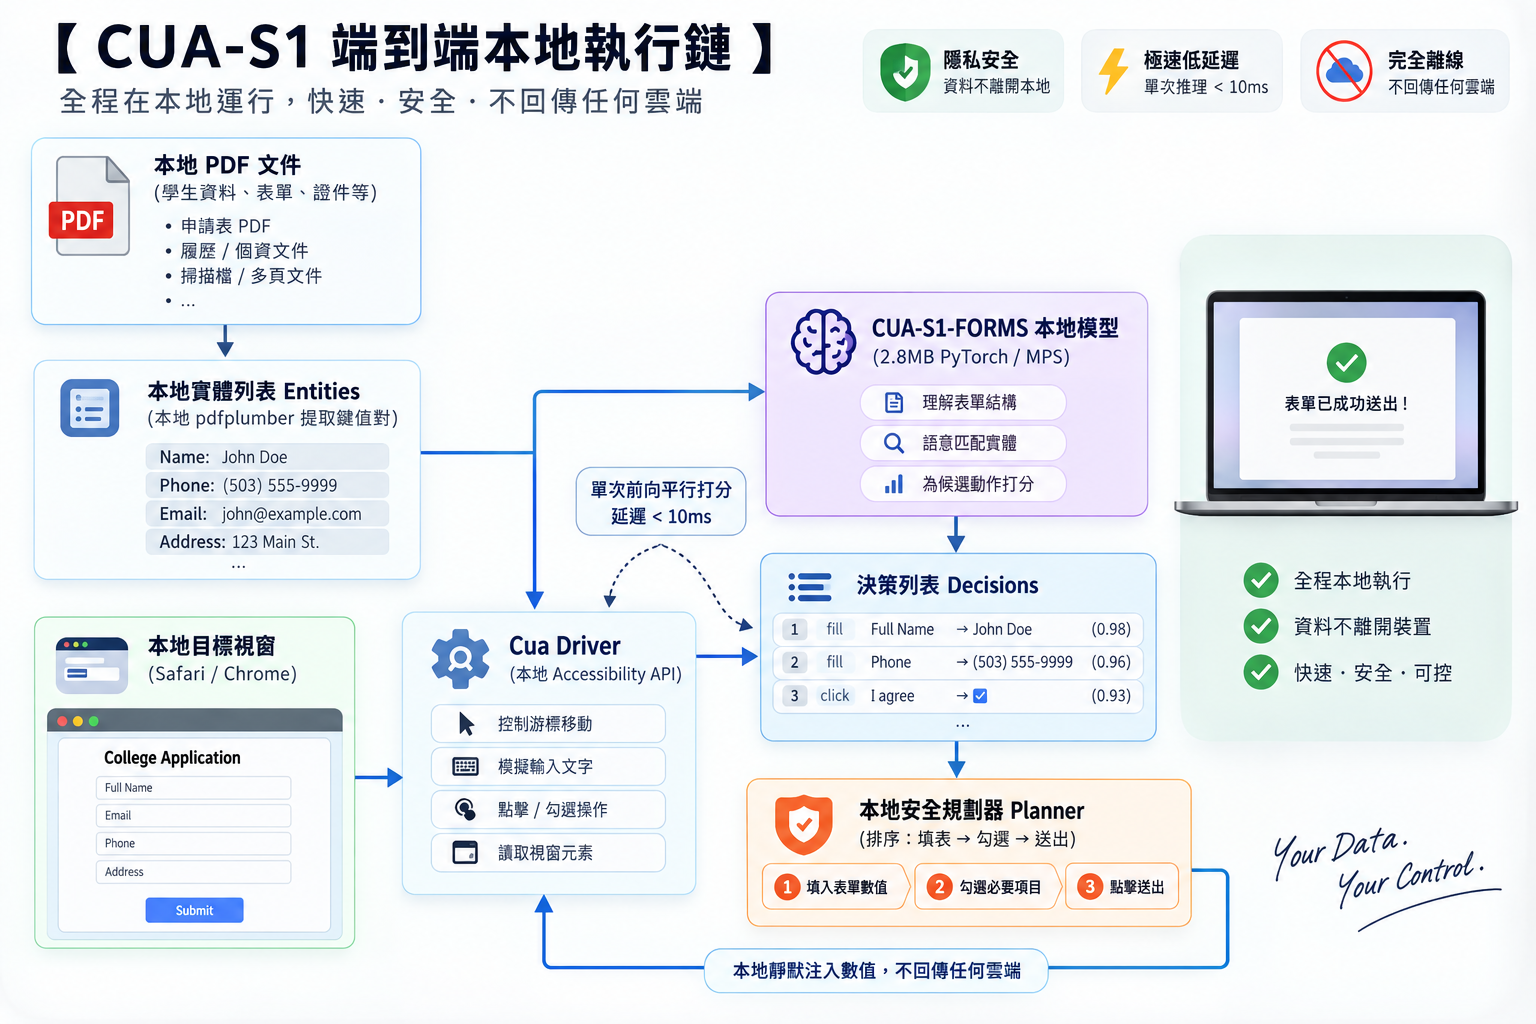
- 驅動層(Cua Driver): 許多人誤以為 Cua Driver 是一個需要連回伺服器的中繼代理,但實際上,Cua Driver 是直接安裝在作業系統上的本地二進位守護進程(Local Native Binary):
- macOS:透過原生 Accessibility API(可訪問性接口)與視窗伺服器溝通;
- Windows:透過 UI Automation(UIA)原生接口;
- Linux:透過 AT-SPI 原生協議。
- 背景靜默分發(Background Delivery): 這是最令工程師驚艷的特性——Cua Driver 在執行填表(
set_value)時,是透過作業系統的底層無障礙控制代碼(Accessibility Handle)直接將文字注入該文字框的 Value 屬性中!- 你的滑鼠完全不會動;
- 你的螢幕焦點不會被搶走;
- 你可以一邊在螢幕前寫代碼或看影片,Cua Driver 一邊在背景視窗中以每秒數十個欄位的極速完成靜默填寫!
推論層(Inference): cua-s1-forms.pt 權重檔案僅 2.8 MB,在 Python 中使用標準 PyTorch 載入:
from cua_s1.model import load_checkpoint, select_device

device = select_device("auto") # 自動識別 Mac MPS、NVIDIA CUDA 或本地 CPU
model, collator, config = load_checkpoint("cua-s1-forms.pt", device)
在 M 系列的 MacBook Pro 上,推論一次全表單的消耗甚至比加載一個網頁圖示還要輕量,耗時不到 5 毫秒,不需要任何雲端 API Key,斷網狀態下照常全速運轉。
Cua Driver 原生桌面操作實錄:驅動代理人在原生 Windows 環境中以精準毫秒級節奏彈奏虛擬鋼琴,展現無焦點搶奪與高可靠底層 API 操控實力。影片來源:Cua 官方實測。
七、軟體工程級的安全邊界:規劃與執行的嚴格解耦
如果說 70 萬參數的模型展示了神經網路的精巧,那麼 Cua 在 libs/cua-s1/python/src/cua_s1/planner.py 中展現的架構設計,則體現了資深軟體工程師對「自主 Agent 脫韁」的深沉敬畏。
在傳統 LLM Agent 中,決策與執行是混雜在一起的(模型一邊說話一邊點擊)。而 Cua-S1 確立了一套硬性安全隔離規範:
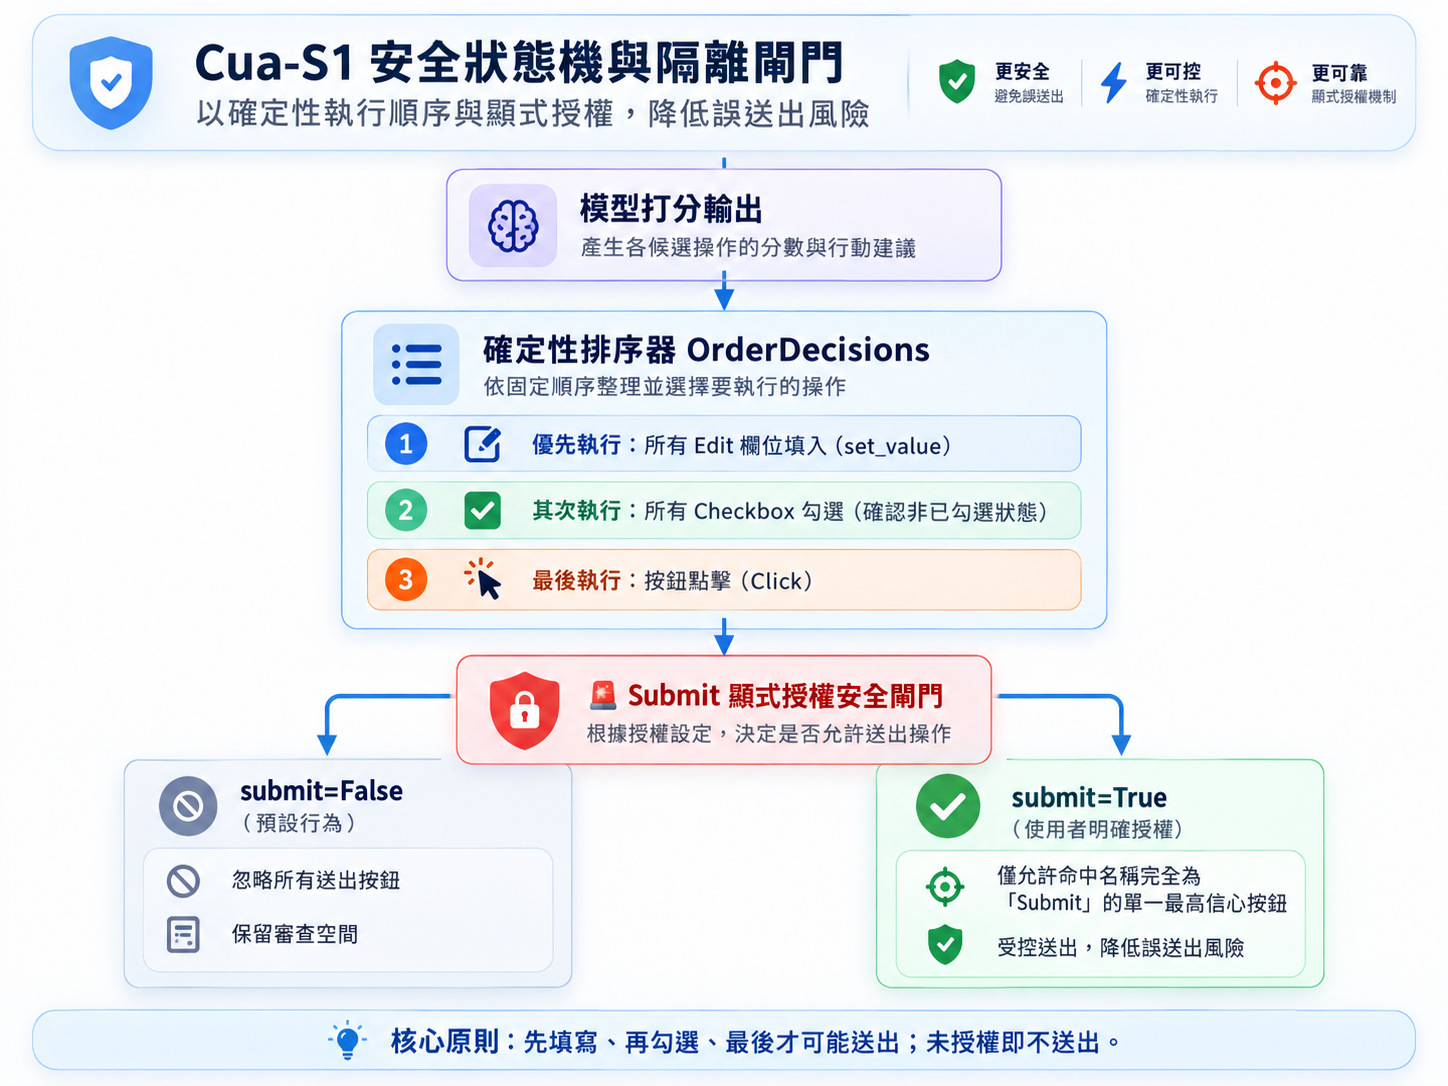
1. 預設 Dry-Run:規劃不等於授權
在調用 plan_and_execute 時,參數 execute 預設為 False。系統只會生成一份完整的結構化 JSON 審計報告,列出它打算在哪些元素上填入什麼內容以及預測的置信度。只有工程師在代碼中明確傳入 execute=True,實體變更才會發生。
2. Submit 按鈕的極限窄門
在所有表單自動化中,最危險的操作就是「點擊送出(Submit)」。一旦點擊,不可逆的網絡請求就會發送給伺服器,可能涉及金錢交易、法律申報或醫療記錄變更。
Cua 設置了堪稱偏執的防禦:
submit是獨立的二進位開關,即便execute=True,只要submit=False,系統在填完所有資料後就會安全停手;- 即便開啟
submit=True,代碼也嚴格限制最多只能點擊一個按鈕,且該按鈕的正規化標籤必須完全等於Submit或Submit Form。任何帶有歧義的按鈕、次要操作按鈕一概忽略。
3. 基於快照 Token 的防禦(Snapshot-Bound Tokens)
在動態 Web 應用中,介面隨時可能因非同步加載而發生 DOM 重構。如果 Agent 盲目依據舊座標點擊,極可能造成誤操作。
Cua Driver 為每個快照中的元素頒發專屬的「生命週期 Token」。在執行每一次動作後,系統都會**強制重新觀察視窗(Reobserve Window)**並更新快照。若某個元素的 Token 失效或狀態不符(例如本應勾選的 Checkbox 經檢查後並未處於 checked 狀態),系統立即觸發 Fail-Closed(閉合中斷)機制,中止後續動作並拋出錯誤,絕不進行帶有猜測性的盲目重試。
八、全流程實戰代碼:如何在本地幾行代碼跑起 CUA-S1?
想要親身體驗這款極速的表單填寫模型?以下是完整的本地安裝與調用範例:
1. 環境安裝
利用現代 Python 工具鏈 uv,一鍵配置獨立環境:
# 克隆開源倉庫
git clone https://github.com/trycua/cua.git
cd cua/libs/cua-s1

# 安裝包含 PDF 支援與測試套件的虛擬環境
uv sync --project python --extra pdf --group test

# 下載 Hugging Face 上的 2.8MB 權重檔案
# 權重位於:https://huggingface.co/cua-ai/cua-s1-forms/blob/main/cua-s1-forms.pt
2. 核心推論與執行邏輯
from pathlib import Path
from cua_s1.checkpoint import load_checkpoint_files
from cua_s1.driver import DriverTarget, LocalCuaDriver
from cua_s1.model import make_system, select_device
from cua_s1.pdf import extract_labeled_entities
from cua_s1.planner import ModelPlanner, plan_and_execute

# 1. 載入 2.8MB 輕量模型
device = select_device("auto")
state_dict, config, _ = load_checkpoint_files("cua-s1-forms.pt")
model, collator = make_system(config, device)
model.load_state_dict(state_dict)
model.eval()

# 2. 構建高層規劃器
planner = ModelPlanner(model, collator, device)

# 3. 從本地 PDF 提取病患轉診實體(純本地解析,絕無洩漏)
entities = extract_labeled_entities(Path("referral_letter.pdf"))

# 4. 連接本地 Cua Driver 並執行背景自動填寫
driver = LocalCuaDriver()
target = DriverTarget(window_title="Patient Registration - Google Chrome")

result = plan_and_execute(
    driver=driver,
    planner=planner,
    target=target,
    form_title="New Patient Registration",
    entities=entities,
    execute=True,        # 正式執行本地填寫
    submit=False,       # 保持謹慎:不自動點擊送出,留給人工審查
    delivery_mode="background", # 核心:背景靜默注入,不搶奪人類滑鼠游標
)

print(f"✅ 成功完成 {result['elements_scored']} 個表單欄位的平行打分與填寫!")
print(f"⚡ 端到端總耗時:{result['timings_ms']['total']} 毫秒 (推論耗時僅 {result['timings_ms']['plan']} ms)")
當這段代碼運行時,你會親眼目睹令人震撼的工程之美:螢幕上的 Chrome 視窗安靜地待在背景,你的滑鼠指針完全不受干擾,而在短短數十毫秒內,表單的所有姓名、電話、地址、病歷號已經全數精準注入完畢。
九、未來典範:「系統一 + 系統二」混合 Agent 車隊崛起
CUA-S1-FORMS 的開源,不僅僅是一個好用的開源專用工具誕生,更標誌著整個 AI 產業在 Agent 架構思維上的重大洗牌。
這印證了認知科學大師丹尼爾·康納曼(Daniel Kahneman)在《快思慢想》中提出的核心理論:人類大腦從來不是單一的推理引擎。
- 系統一(System 1 / 快思):本能、快速、直覺、低能量消耗,專門處理模式識別、反射動作、固定管線操作;
- 系統二(System 2 / 慢想):理性、審慎、深思熟慮、高能耗,專門處理邏輯推導、異常處置、開放式策略擬定。
過去四年,整個 AI 界陷入了「試圖用系統二解決一切」的狂熱執念——我們用著每秒燃燒數百瓦電力、動輒幾百億參數的大模型,去算 1+1、去辨識「點擊 OK 按鈕」、去將字串複製到文字框。
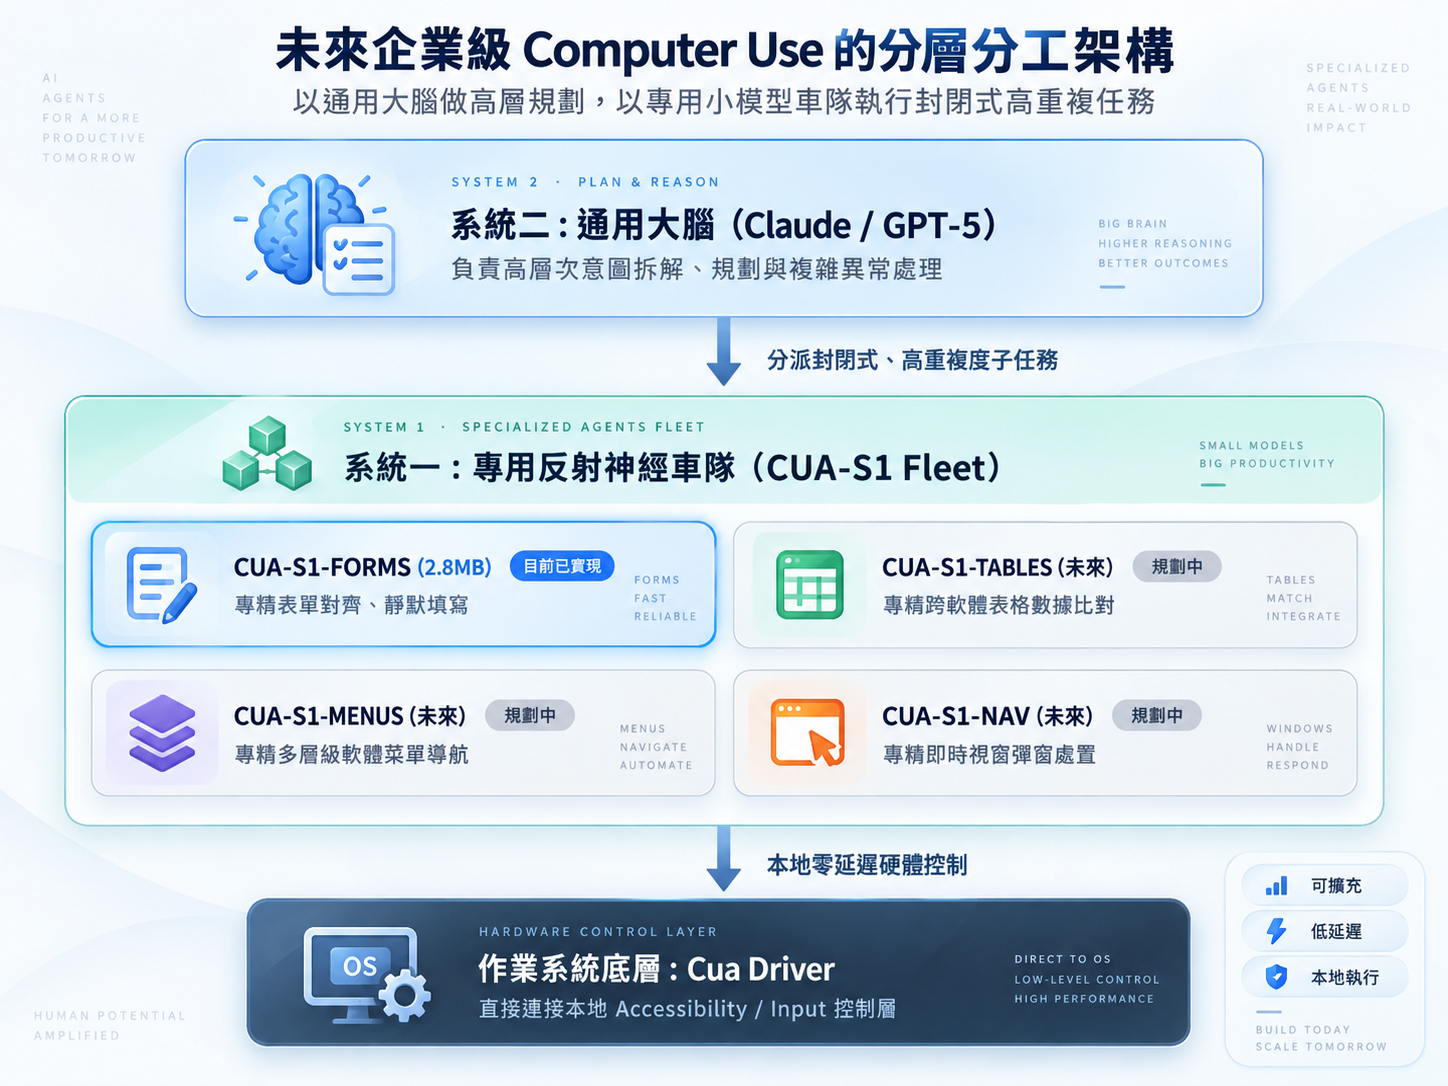
未來的終極 Computer Use Agent 絕不會是一個笨重的巨石架構(Monolith),而是一支協同作戰的車隊(Fleet):
- 大模型(系統二)居中調度:負責理解使用者的模糊需求(例如「幫我把這批上百份報案資料歸檔進內政部系統」),並將流程切分為一個個確定性邊界的任務塊;
- CUA-S1 專用小模型(系統一)在端側狂飆:一旦進入具體的資料庫或表單介面,大模型立刻將控制權移交給 2.8 MB 的 CUA-S1。小模型在本地以毫秒級延遲、零 Token 成本、零隱私洩露風險,狂風驟雨般填完上萬份表單;
- 遇到未定義的異常才喚醒大模型:只有當出現完全未見過的彈出視窗、系統報錯或衝突邏輯時,小模型才會請求大模型介入進行深入推理。
結語:將智慧還給程式碼,微型專用模型的新黃金時代
從幾天前 Diogo Almeida 創立 TypeSafe AI 掀起的「對話框反叛」,到今天 Cua 開源 CUA-S1-FORMS 繳出的漂亮戰卷,我們正在目睹 AI 歷史上極具象徵意義的一個轉折點:
AI 正從「比拼參數量與聊天話術的展示期」,大步邁入「比拼執行延遲、邊界安全與架構純度的工程落地期」。
一個僅僅 70 萬參數、甚至能裝在一張 3.5 吋軟碟片裡的微型 Transformer,在特定任務上以更高的準確率、快數百倍的速度、零元成本,徹底擊潰了需要整個資料中心伺服器集群支持的千億參數通用巨獸。
這不是大模型的黃昏,而是微型專用模型(Specialist Models)與系統一神經反射的拂曉。
正如 Cua 團隊在開源宣言最後留給所有工程師的呼籲:
「如果你的企業每天都在運行大量重複、邊界明確、高吞吐量的電腦操作工作流,請告訴我們,你希望下一個 CUA-S1 學習什麼?」
當算力不再被浪費在無意義的逐字解碼上,真正的全自動化,才算正式拉開序幕。
相關資源與延伸閱讀
- 📦 Cua 開源專案 GitHub 倉庫:https://github.com/trycua/cua
- 🧩 Cua-S1 模組原始碼:https://github.com/trycua/cua/tree/main/libs/cua-s1
- 🤗 Hugging Face 模型權重下載(
cua-ai/cua-s1-forms):https://huggingface.co/cua-ai/cua-s1-forms - 📊 Hugging Face 訓練與測試數據集:https://huggingface.co/datasets/cua-ai/cua-s1-forms
- 🚗 Cua Driver 官方文檔:https://cua.ai/docs