TypeSafe Use Case Map 是什麼?把 AI 從聊天工具變成可控工作流的實戰指南
從 TypeSafe Use Case Map 找出適合 Jev 的工作,並用五個 X 實作案例看懂結構化判斷如何接進稅務、評測、測試、調度與語音工作流。
很多團隊已經能做出會聊天、會摘要、會呼叫工具的 AI 助手,真正卡住的卻是下一步:能不能讓 AI 在沒有專人盯著的情況下,每天穩定處理幾萬次分類、審核與路由?
TypeSafe AI 的 Use Case Map 就是為這個問題而設計。它列出搜尋、客服、法遵、招募、廣告、風險評估等場景,但這張地圖真正的用途不是叫你照表抄一個「AI 客服」。它要幫你從現有流程中找出一個適合交給模型的決策形狀。
本文會回答五個問題:Use Case Map 該怎麼讀、哪些工作適合 Jev、如何把一句模糊需求拆成程式碼可控制的流程、X 上的開發者實際做了什麼,以及導入前應該先驗證哪些限制。
我的判斷是:如果一項工作每天重複很多次、答案範圍可以事先定義,又需要理解文字語意,TypeSafe 值得做小型試點。若任務需要長篇創作、複雜規劃或承擔高風險後果,現階段就不適合直接交給它自動決定。
TypeSafe Use Case Map 是什麼?先把「產業」翻成「決策」
Use Case Map 表面上依產業列出應用,底層其實在回答另一件事:這個流程中的 AI,最後要回傳哪一種可以被程式使用的答案?
例如,「改善客服」太大,也無法直接實作。把它拆開後,才會出現可執行的問題:客戶是在問帳務、訂單還是帳號?語氣有多急?是否要求退款?目前資訊不足時,要轉給哪個人工隊列?
這也是 TypeSafe 與一般聊天模型的主要差異。TypeSafe 的第一個公開 System One Model 是 Jev。System One Model 可以先理解成「替軟體做快速、限定範圍判斷的模型」。它接收文字與結構化狀態,回傳預先定義好的類別、分數與機率,由一般程式碼決定下一步。官方建構指南 明確要求把流程控制、固定規則和實際寫入動作留在程式碼中。
因此,Use Case Map 不是已完成專案的客戶名單,也不是導入後必然有效的成效保證。它比較像一張需求訪談用的索引,幫團隊把「想用 AI」縮小成可以測量的決策單元。
地圖上的五個主要方向
| 方向 | 適合處理的問題 | 例子 |
|---|---|---|
| AI 自動化軟體 | 流程固定,但其中有幾個規則難以手寫 | 客服分流、履歷初篩、商品刊登審核 |
| 即時應用 | 判斷必須在使用者等待期間完成 | 介面提示、遊戲狀態判斷、即時防護 |
| 大量資料處理 | 每筆判斷很小,但資料量非常大 | 文件標記、特徵擷取、語意搜尋 |
| 通用驗證 | 檢查另一個 AI 或文件是否犯特定錯誤 | 引文支持度、提示注入、工具呼叫錯誤 |
| AI 系統控制 | 改善模型周邊的路由、檢索與監控 | 模型路由、上下文選擇、推理軌跡分類 |
這五類的共同點是「判斷很多、答案有限」。它們需要語意理解,卻不一定需要模型寫一篇文章。這正是 Jev 想填補的位置。
先看問題形狀:哪些任務適合 Jev?
挑選 Use Case 時,產業名稱不是最重要的條件。同一個客服部門裡,「判斷客戶意圖」很適合結構化決策,「替客戶寫一封完整又有同理心的回信」則仍適合生成式模型。
可以先用四個問題篩選:
- 答案能否事先限定? 例如部門、風險類型、嚴重程度或是否違規。
- 是否需要理解自然語言? 如果只要算日期、金額或庫存,普通程式碼更便宜也更可靠。
- 是否會大量重複? 一天只做一次的高難度分析,不一定能發揮低延遲與低單次成本的價值。
- 不確定時能否安全退出? 系統需要能轉人工、轉較強的推理模型,或暫停動作。
符合這四點的任務,才是好的起點。TypeSafe 將常見問題整理成分類、偵測、評分、路由、搜尋、檢索、排序、驗證、機器學習特徵擷取與結構化資料擷取。名稱很多,實作時可以再縮成三種基礎問法。
Choice、Score、Noul:三種讓程式看得懂的答案
TypeSafe 的 Primitives 文件 把問題分成 Choice、Score 與 Noul。Primitive 在這裡可理解成「能組合成更大工作流的最小決策元件」。
| 類型 | 白話意思 | 適合問題 | 回傳內容 |
|---|---|---|---|
| Choice | 從固定選項選一個 | 這張工單屬於帳務、訂單還是帳號? | 選項、各選項機率、信心值 |
| Score | 在有順序的等級上評分 | 客戶有多生氣?風險有多高? | 分數、各等級機率、信心值 |
| Noul | 判斷某件事成立的機率 | 客戶是否明確要求退款? | 0 到 1 的成立機率 |
這三種輸出都受到預先定義的結構限制,程式不必再從一段生成文字中猜測答案。不過,格式一定正確,不代表判斷一定正確。Jev 不會憑空多生出第四個 Choice 選項,卻仍可能在「帳務」與「訂單」之間選錯。這是閱讀官方「零幻覺」說法時最重要的界線。
真正能提高安全性的,是機率與信心值後面的程式設計。高信心且低風險的案件可以自動進入下一步,中間區間轉人工,極低信心則要求補資料。模型負責判斷,程式負責權限與後果。
TypeSafe 官方並排影片示範 Jev 平行輸出機率,以及傳統大型語言模型依序生成文字的差異。這支影片顯示輸出方式與延遲差異,不代表所有任務都會得到相同速度。影片來源:TypeSafe AI 官方部落格。
從一句需求拆成可控工作流:以客服工單為例
假設原始需求是:「用 AI 自動處理客服信件。」這句話把理解、決策、回覆和帳務操作混在一起,任何一步出錯都很難追查。較好的拆法如下:
第一步:確定性規則留在程式碼
已關閉的工單不需再次處理、退款金額由帳務資料計算、超過權限的退款必須主管核准。這些規則有明確答案,直接寫在程式碼裡即可,不需要問模型。
第二步:只提供當前判斷需要的資料
判斷客戶意圖時,可以提供對話、訂單狀態與退款政策。其他客戶的資料、無關的歷史紀錄和整份知識庫只會增加干擾。TypeSafe 把這份輸入稱為 state,也就是模型做判斷時看見的當前狀態。
第三步:把模糊需求拆成原子問題
一次只問一件能快速判斷的事,例如:
- Choice:主要需求是退款、重新寄送、帳號協助,還是其他?
- Noul:訊息是否明確要求退款?
- Noul:訊息是否要求提供密碼或 API(讓不同軟體彼此交換資料的介面)金鑰?
- Score:客戶的挫折程度位於哪一級?
- Noul:訊息提到的訂單是否存在於未完成訂單清單?
官方文件建議把同一份 state 上的獨立問題放在一次請求中平行處理。這和請模型先判斷意圖、再根據前一個答案繼續自由推理不同。每個答案可個別查看,也能被程式重新加權。
第四步:由程式組合答案並控制動作
以下是概念化的 Python 流程,重點是決策邏輯,不代表本文已用真實 API 金鑰執行:
topic = answers["topic"]
refund_probability = answers["refund_requested"].noul
risk_probability = answers["requests_credentials"].noul

if risk_probability > 0.85:
    route_to_security_review(ticket)
elif topic.confidence < 0.80:
    route_to_human(ticket)
elif topic.choice == "billing" and refund_probability > 0.90:
    open_refund_workflow(ticket)
else:
    route_to_handler(topic.choice, ticket)
這段流程沒有讓模型自行退款。它只提供語意訊號,實際路由、權限檢查與副作用仍由程式掌握。門檻也不能照抄範例數字,必須用自己的歷史案件測試。
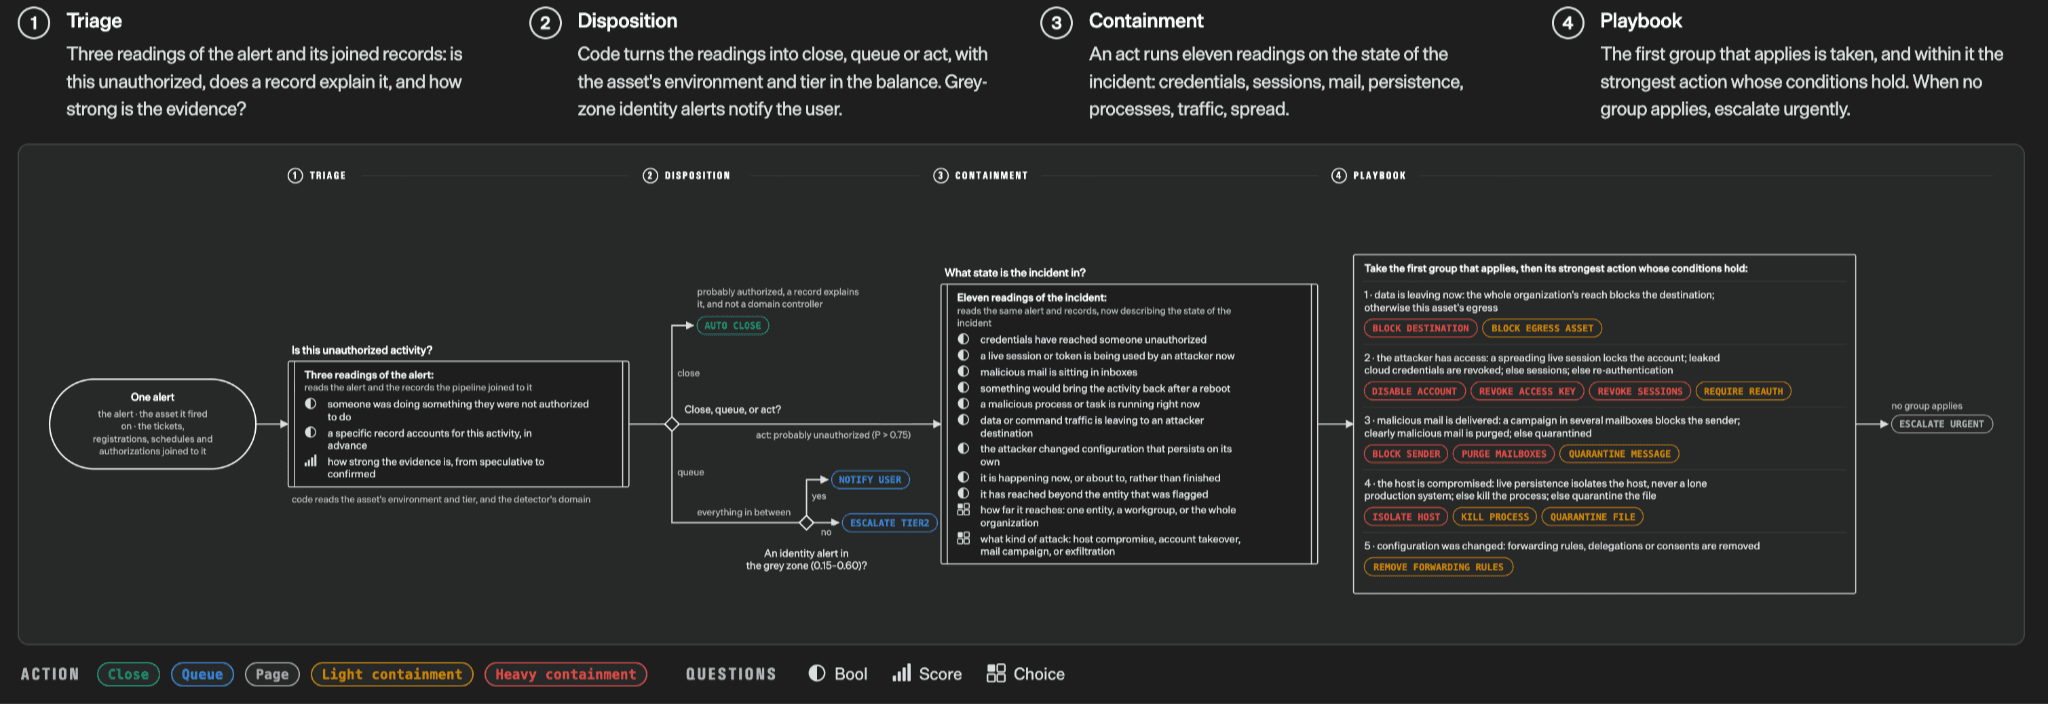
Use Case Map 的產業案例,該怎麼轉成自己的需求?
官方地圖列出十多種產業。與其逐項複製,更實用的方法是先找每個案例背後的決策模板。
客服與招募:先分類,再把模糊案件交給人
客服可以同時判斷意圖、急迫程度、流失風險與退款要求。招募則能依明確的職務條件找出相關經驗、能力證據與職位匹配度。兩者都不應讓模型做最後承諾。客服的退款、招募的錄取仍需遵守既有權限與覆核流程。
法遵、金融犯罪與保險:適合排優先順序,不適合直接定罪
這些場景常有大量文件與案件需要先篩選。模型可以標記缺漏條款、可疑敘述、資料不一致或案件複雜度,再把高風險與低信心項目送給專業人員。它的價值在於縮小人工檢查範圍,不是取代律師、調查員或理賠人員的最終判斷。
電商、廣告與內容審核:把政策寫成多個可觀察條件
「這則內容好不好」太模糊。可以改問是否含違禁品訊號、品牌安全風險、誤導性宣稱、個資暴露與廣告落地頁不一致。每個條件都有獨立機率,程式再依嚴重度決定允許、警告、送審或封鎖。
搜尋、檢索與知識圖譜:用語意分數補足關鍵字
Jev 可用來評估查詢與候選文件的相關性、重新排序結果,或檢查知識圖譜中的關係與矛盾。這類流程通常先由資料庫或搜尋引擎取出候選項目,再讓模型評分。讓模型直接掃過全部資料,反而可能浪費成本並拉長延遲。
這些案例說明了同一個原則:先用現有系統縮小問題,再讓 AI 處理規則難以完整描述的語意部分。
X 上已經有人怎麼做?五個有畫面的實作案例
Jev 公開不到一週,X 上已出現不少試作。下面只收錄能看到操作畫面、程式庫或具體流程的案例。它們多半仍是開發者展示,不能當成正式環境成效或安全認證。
| 案例 | 輸入 | Jev 負責的判斷 | 程式負責的動作 | 目前證據 |
|---|---|---|---|---|
| 稅務文件分類 | PDF 每頁文字 | 從 261 種 IRS 表格與 7 種頁面類型中分類 | 低信心時攔下、分流後續處理 | 開源程式與可重跑評測 |
| 船舶/航機緊急改道 | 即時位置、設施、天候與事故描述 | 比較各港口或機場的適合機率 | 計算硬條件、顯示排序、低信心轉人工 | 可操作展示與作者說明 |
| Agent 回答評分 | Agent 的輸入與回答 | 選出答案或給數值分數與機率 | 在 Braintrust 留下 trace 並供人工檢查 | 第三方產品整合公告 |
| Agent E2E 測試 | 網頁或手機操作狀態 | 判斷測試步驟與畫面是否符合預期 | 執行操作、錄影、建立人工複查流程 | 開發中預覽,尚未正式釋出 |
| 免喚醒詞語音控制 | 持續語音轉成的文字 | 判斷使用者是在下指令或只是聊天 | 只有被判定為指令時才操作電腦 | 個人原型影片 |
案例一:把稅務文件頁面分到 261 種表格
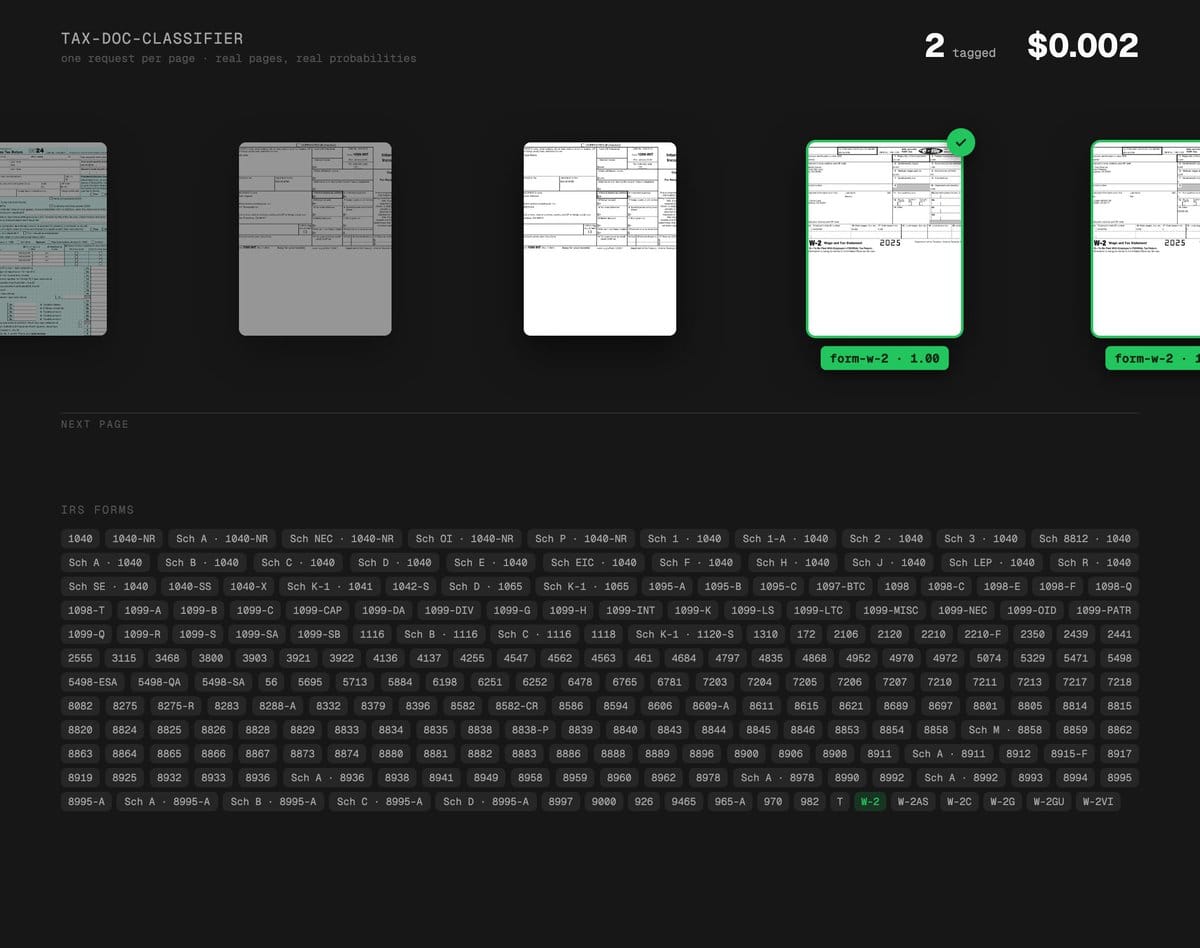
Nakshatra Saxena 在 X 分享的分類器會先從 PDF 擷取文字,再讓 Jev 同時判斷頁面種類與 IRS 表格。這個案例比「文件自動化」具體得多:輸入是一頁文字,輸出是固定表格代碼、頁面類型、機率與信心門檻,低信心頁面再走原本的備援流程。
作者宣稱每頁約 0.001 美元,較原本的 Sonnet 分類器便宜 34 倍、快 6 倍。本文也查過公開程式庫:314 頁填寫過的測試資料沒有錯誤。753 頁空白 IRS 表格也沒有分錯,但有 38 頁因信心低於 0.95 而被列為嚴格評測錯誤。這表示「答案沒分錯」與「信心高到能自動放行」必須分開看。這些數字仍是作者提供的資料與環境,本文沒有持有 API 金鑰重跑。
案例二:替真實船舶與航機挑選緊急目的地
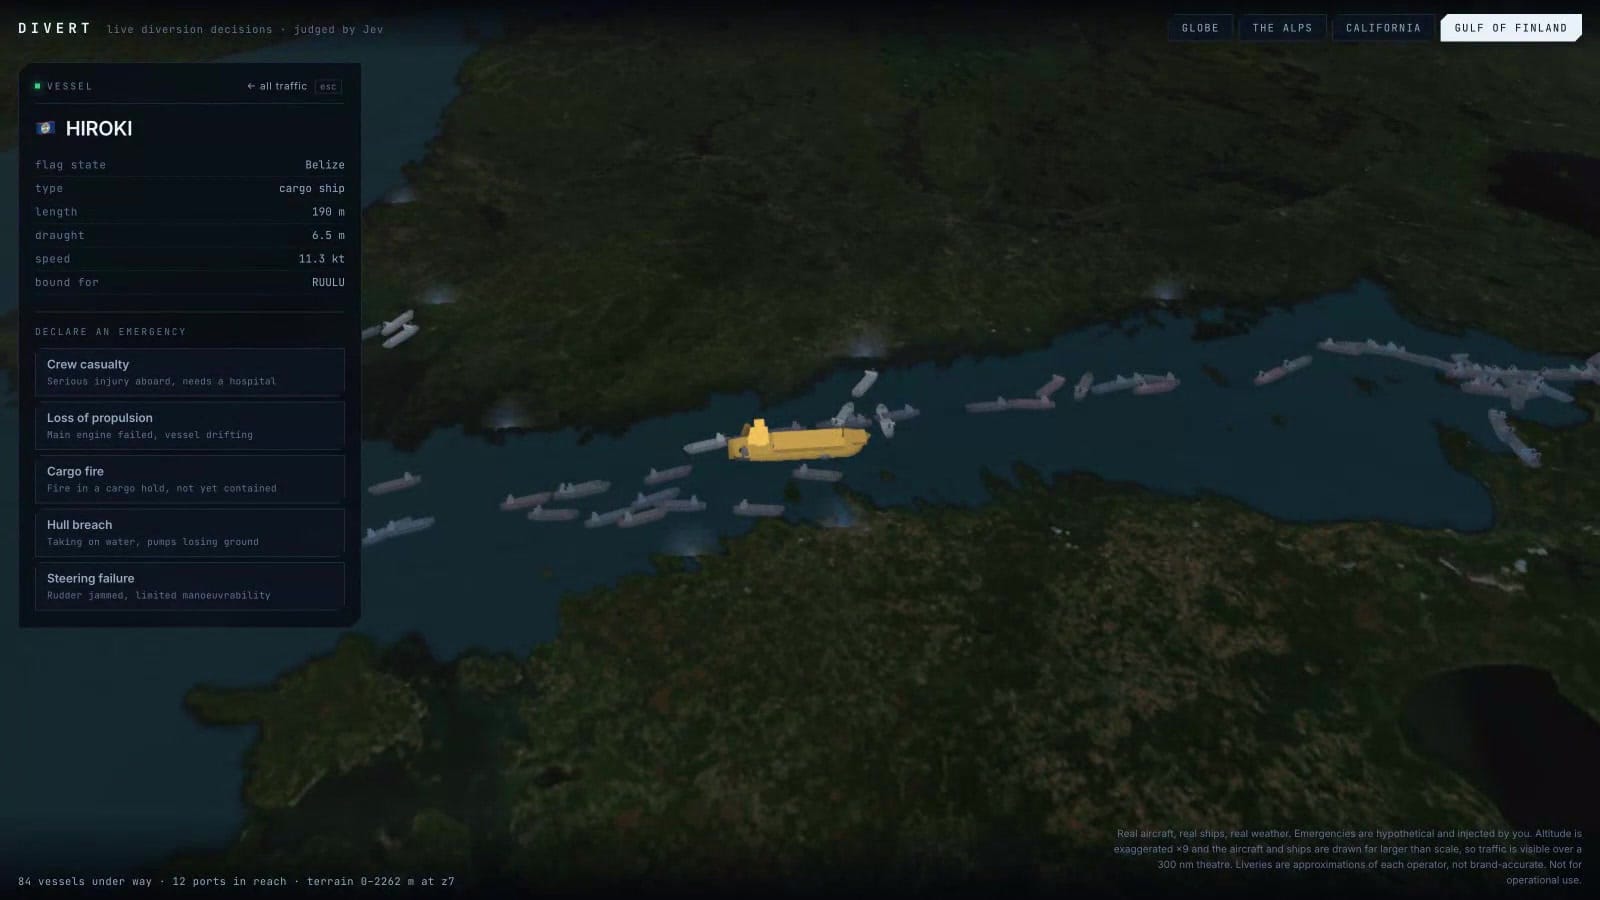
Carlos Marcial 的 Divert 展示把 AIS 船舶與 ADS-B 航機即時資料放到地圖上,再由使用者加入火災、失壓或引擎故障等模擬事故。程式先計算水深、跑道長度、航程與地形等硬條件,再把「水深勉強足夠」這類有語意的狀態交給 Jev。一次最多送出 54 個型別化問題,最後把每個目的地的機率畫成光柱。
這個切法很值得學:數學由程式算,Jev 比較醫療、消防、拖船、維修與接收意願等條件,低於作者設定的信心門檻就標記人工複查。作者表示自己的執行約兩秒完成,但這是互動展示,沒有證明可用於真實調度。航空與海事決策也不能只靠這個原型。
案例三:在 Braintrust 裡取代部分 LLM-as-a-judge
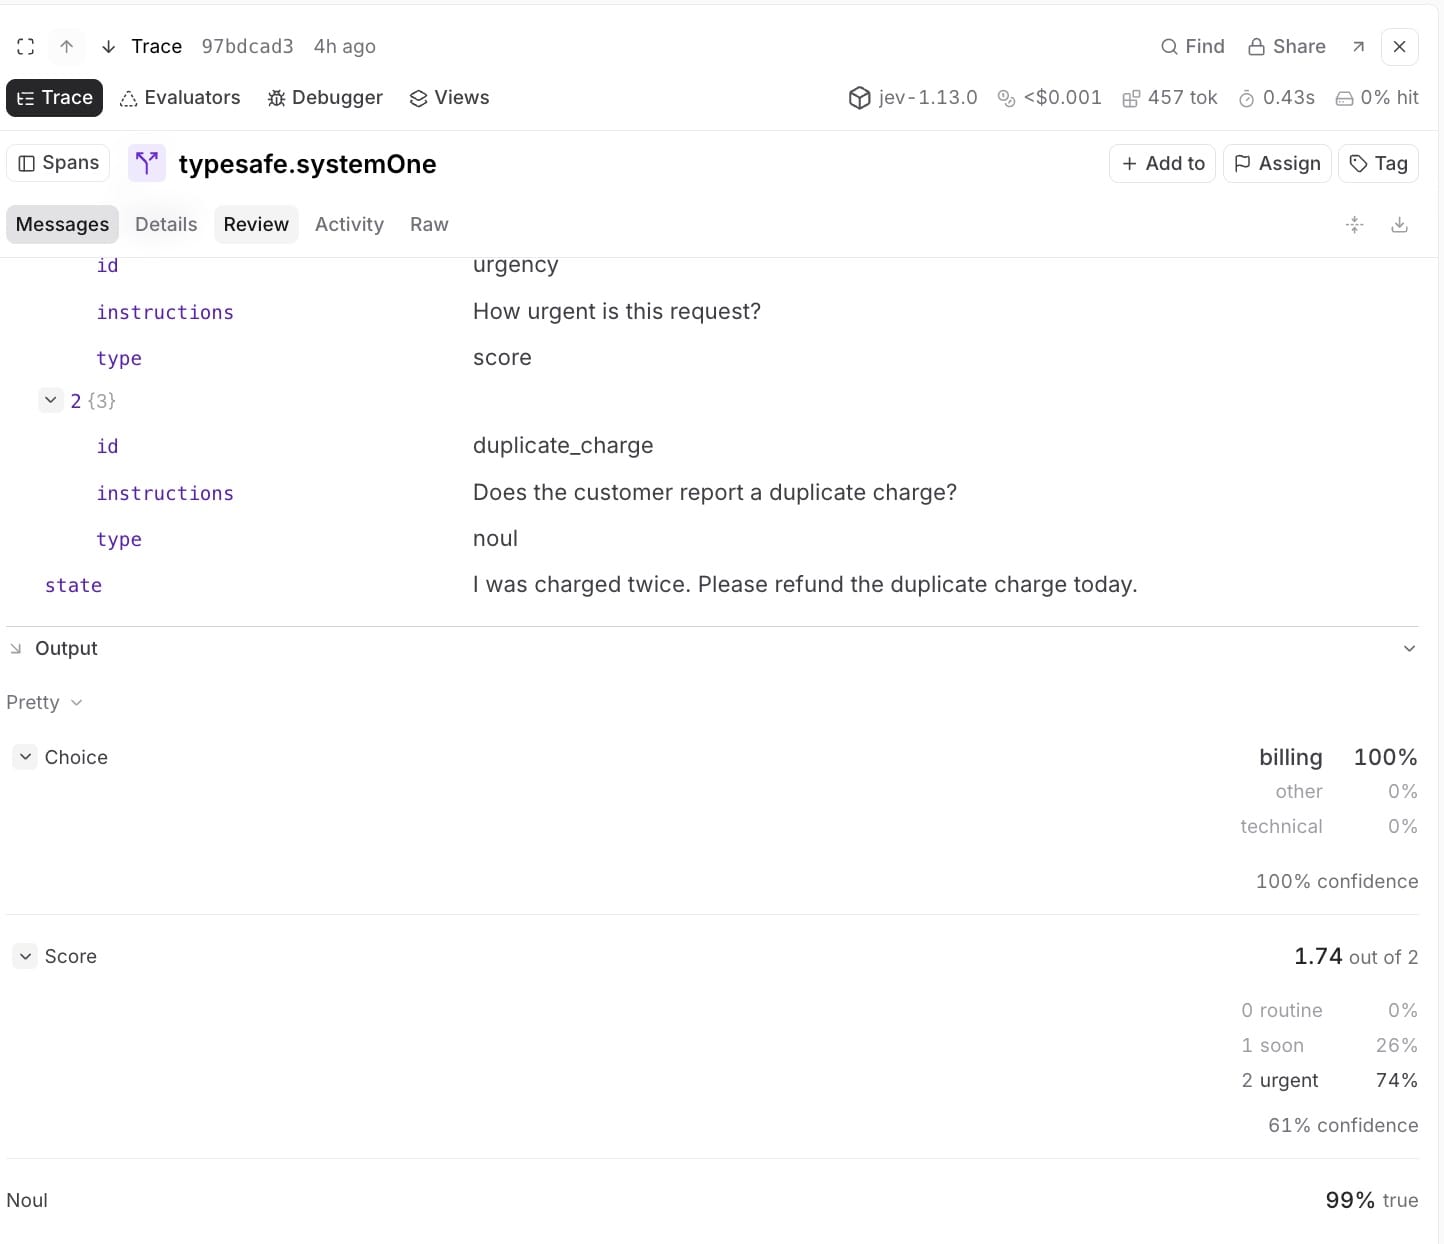
Braintrust 的整合公告把 Jev 當成 judge scorer,用來評分 Agent 回答。畫面中可以同時看到 Choice、Score、Noul、各選項機率與信心,團隊也能從 JavaScript 或 Python SDK 追蹤呼叫。
適合它的評測題目是答案範圍事先定義好的條件,例如「是否符合政策」「急迫程度幾級」「回答是否支持引用」。若評測需要讀完整作品、解釋原因或建立新的評分標準,仍可能需要一般 LLM 或人工。這是第三方產品整合的公開展示,尚不是跨資料集的獨立準確率比較。
案例四:讓 Agent 執行網頁與手機 E2E 測試
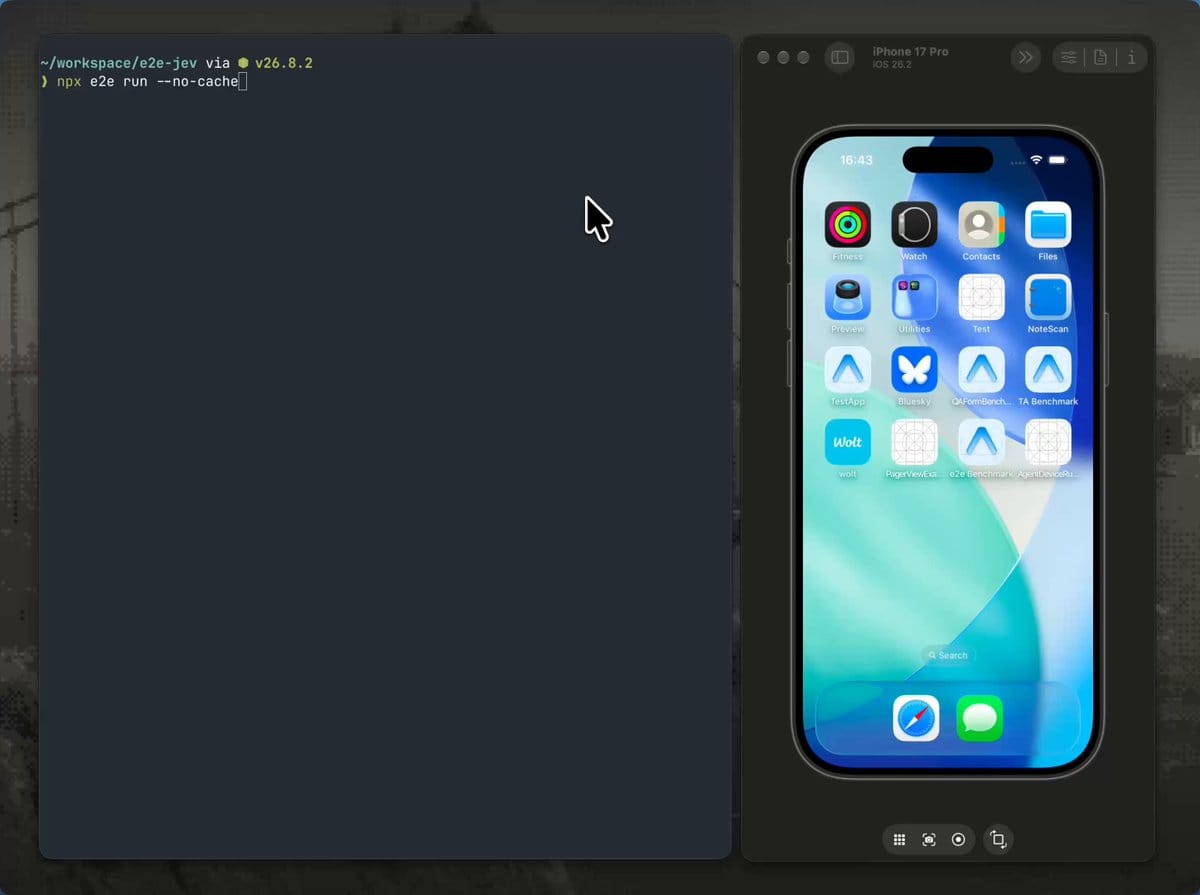
Oskar 公開的 Tester Army 預覽展示 Agent 操作手機 App,目標是建立可跑 Web、Mobile 等介面的開源 E2E 測試框架。E2E 是 end-to-end,意思是從使用者操作開始,一路檢查到系統回應。
這個案例裡,Jev 適合回答窄問題:目前畫面是否出現成功狀態、按鈕是否可用、操作結果是否符合預期。瀏覽器或模擬器仍由測試程式操控,錄影與人工複查也留在外部工具。作者當時寫的是「available soon」,所以只能視為開發中預覽,不能寫成已經可安裝的完整產品。
案例五:不說喚醒詞,也能判斷你是否在下指令
Max Blade 的原型讓電腦持續接收語音,Jev 只判斷一句話是在要求電腦做事,還是一般聊天。這個設計把兩個問題分開:語音轉文字由既有工具完成,Jev 回傳「指令意圖」的機率,作業系統動作則由程式執行。
它說明低延遲分類可能如何改善環境式助理,但貼文沒有公開測試集、誤觸率或隱私處理方式。要真正上線,至少還要測背景噪音、多人對話、否定句、敏感操作的二次確認,以及麥克風資料如何保存。
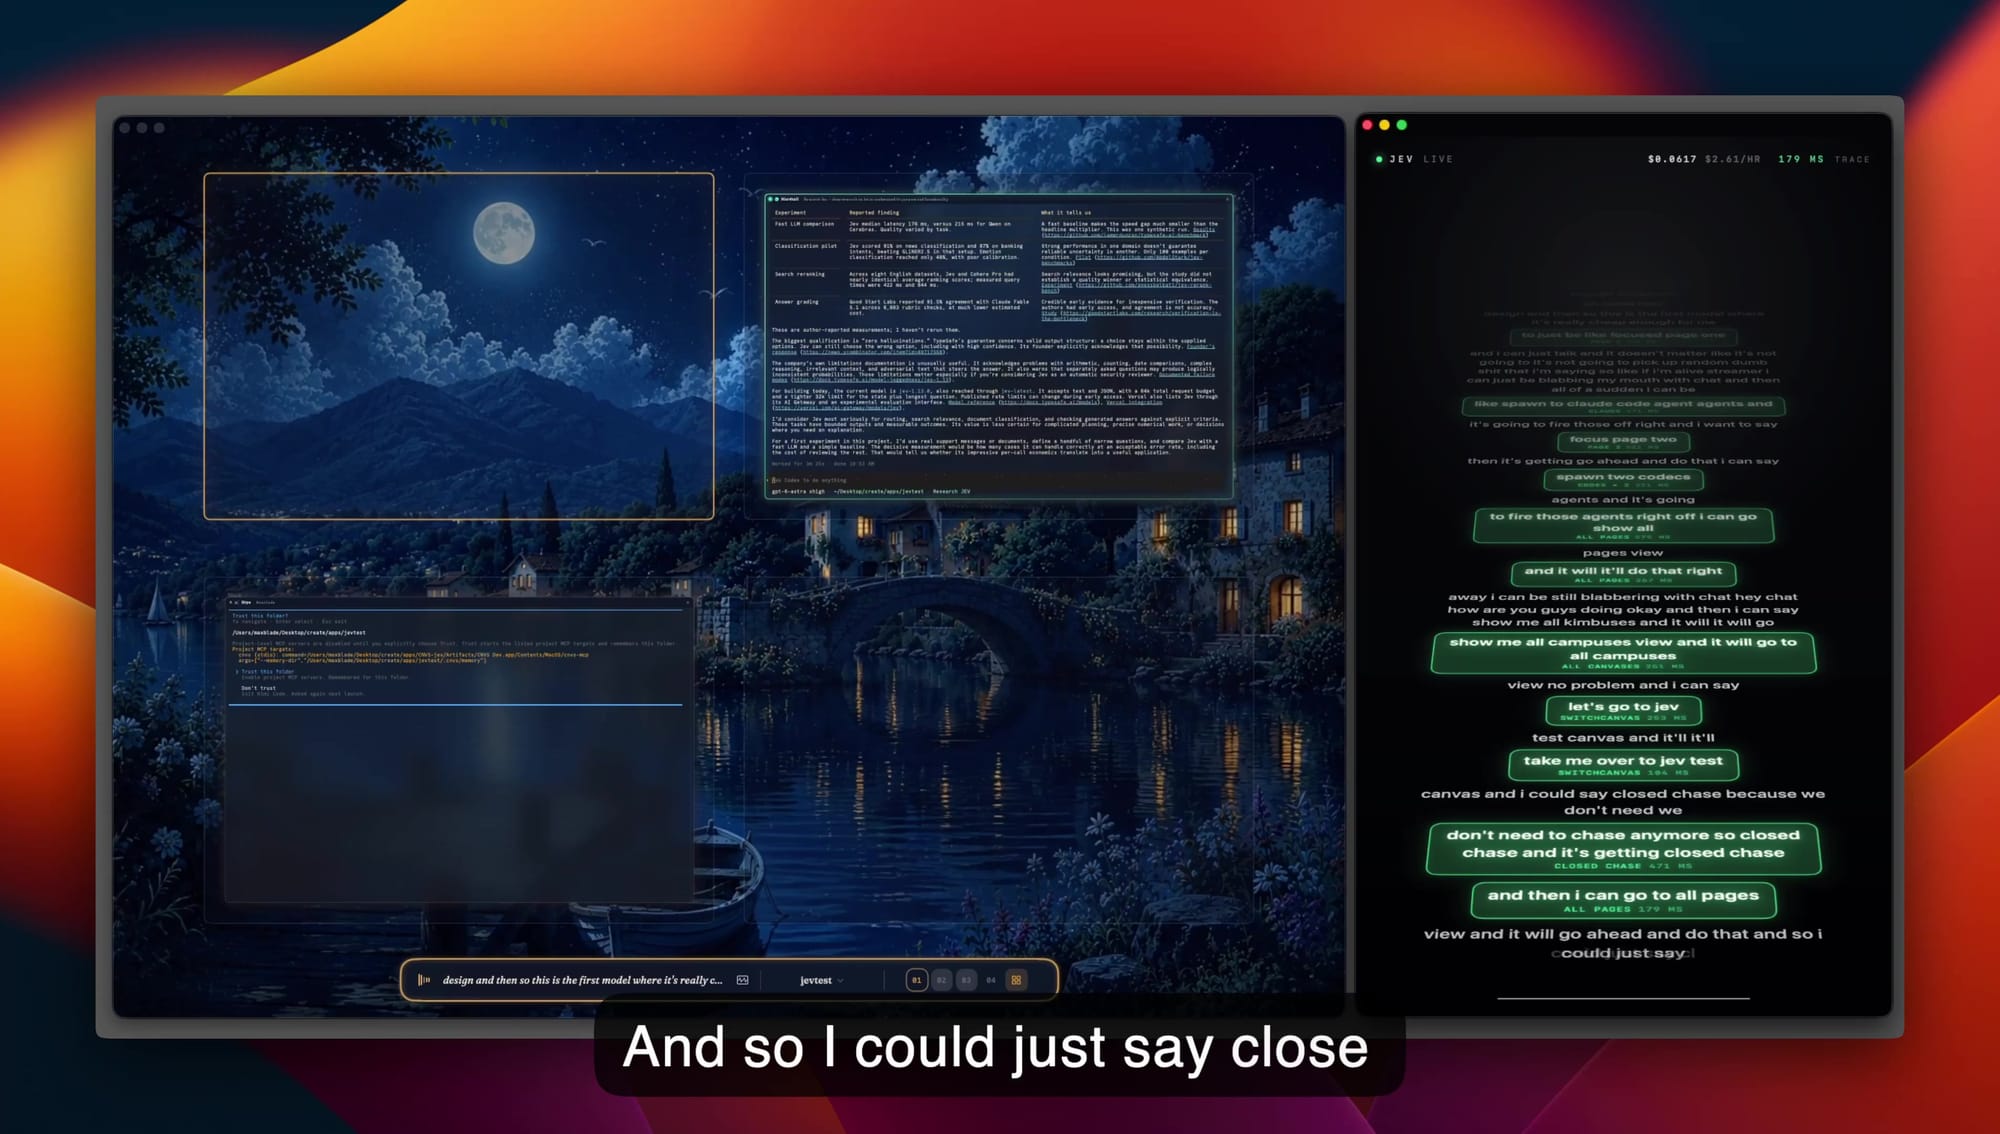
這五個案例共同說明:Jev 最有用的位置通常不是生成最後內容,而是替既有系統補上一個快速的語意判斷。案例也都很新,文章引用的成本、速度與準確率應視為作者自述,正式採用前仍要用自己的資料重跑。
官方速度與成本很吸引人,但不能直接套到你的系統
截至 2026 年 9 月 18 日,TypeSafe 表示多數查詢約在 100 毫秒完成。產品發布文章列出的範圍為 70 到 500 毫秒,輸入價格為每百萬 Token 0.042 美元,輸出不另計費。Token 是模型計算文字量與費用的基本單位。官方首頁的 193.6 倍速度與 444.6 倍成本優勢,則來自四組自家工作流評測。
這些數字值得測試,卻不能當成每個專案都能得到的結果。TypeSafe 的發布文章 也主動列出限制:評測由自家能力團隊建立、參考答案取自兩個大型模型的平均、服務目前位於美國西岸,而首頁倍數屬於較高端的實際增益。
官方工作流評測 的另一個限制更關鍵。它先假設工作流本身正確,再比較不同模型的答案、成本與時間。這能測模型在同一套流程中的表現,卻沒有證明你的分類標準、門檻和程式邏輯就是正確的。
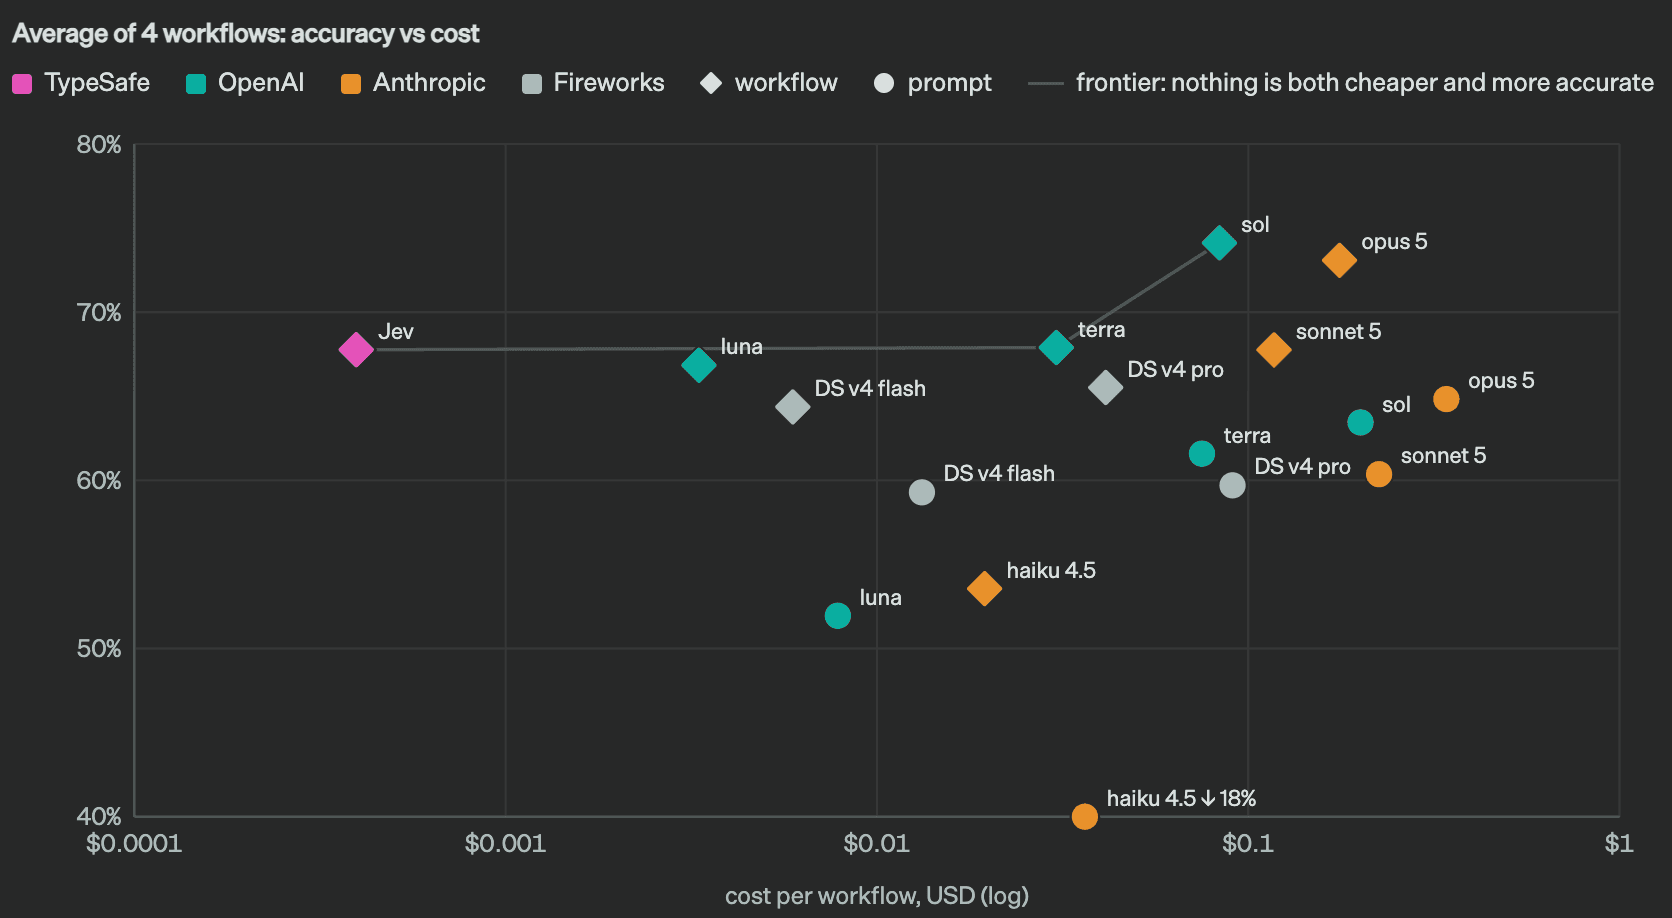
所以我的立場是中性偏多:TypeSafe 提出的架構很適合高頻、可分解的語意判斷,公開的 Python SDK 與 JavaScript/TypeScript SDK 也降低了試作門檻。SDK 是協助開發者連接服務的軟體工具包。但 Jev 仍在 early access(早期使用)階段,官方測試不能取代企業自己的歷史資料回測。
五步驟做出第一個 TypeSafe 試點
1. 選低風險、量大的單一決策
先做「工單分流」或「標記需要人工看的文件」,不要從自動退款、自動拒賠或自動封鎖帳號開始。第一個專案的目的,是量出模型錯在哪裡。
2. 建立有人工答案的歷史資料集
從過去案件中整理輸入、正確分類與最後處理結果。若團隊自己都無法一致判斷,就先修清楚政策,不能期待模型替你補完模糊規則。
3. 把一個大問題拆成多個 Choice、Score、Noul
保留每個細項答案,不要只看最後總分。這樣才能知道問題出在意圖分類、風險偵測、嚴重度評分,還是程式組合規則。
4. 分開測準確率、信心校準、延遲與總成本
信心校準是指「模型說有 90% 把握的案件,長期是否真的約有 90% 正確」。除了平均準確率,也要看低信心案件是否集中在容易出錯的區域。延遲則要從實際部署地區測量,不能只引用官方西岸數據。
5. 從全人工逐步提高自動化比例
試點初期只顯示建議,不自動執行。確認高信心區間穩定後,再開放低風險路由。每一次增加權限,都保留日誌、人工抽查與快速停用開關。
如果這五步完成後,Jev 在你的資料上沒有更好的正確率、校準、速度或總成本,就應維持原方案。Use Case Map 是找候選題目的工具,不是採用產品的理由。
FAQ:TypeSafe Use Case Map 常見問題
TypeSafe 可以取代 ChatGPT 或其他大型語言模型嗎?
用途不同。Jev 適合回傳限定範圍的分類、分數與機率。聊天模型較適合寫作、對話、開放式規劃與長鏈推理。實際系統也可以讓 Jev 先做路由或驗證,再把少數困難案件交給較大的模型。
TypeSafe 所說的「零幻覺」代表答案不會錯嗎?
不代表。它主要保證回傳值符合預設型別與選項,不會生成預設資料結構之外的文字或欄位。語意判斷仍可能出錯,所以需要歷史資料回測、信心門檻與人工覆核。
Noul 和一般的布林值有什麼不同?
布林值只有 true 或 false。Noul 回傳某件事成立的機率,例如 0.92,讓程式可以依風險設定不同門檻。接近 0.5 代表模型在是與否之間沒有明顯把握。
哪一種 Use Case 最適合當第一個專案?
優先選擇低風險、高頻率,而且已有人工歷史答案的分類或路由工作。例如客服部門分流、文件標記與需要人工複查的內容偵測。這類任務容易建立基準,也能在不自動執行高風險動作的情況下測試。
沒有 TypeSafe early access,可以先設計工作流嗎?
可以。先整理 state、問題類型、選項、正確答案與程式門檻,這些工作與供應商無關。TypeSafe 也公開一個用其他 LLM 模擬相同介面的 adapter,團隊可以先比較流程設計,再決定是否申請 Jev。
結語:真正要改的不是模型,而是工作流的切法
TypeSafe Use Case Map 最實用的啟示,是把「導入 AI」改寫成一個更具體的工程問題:流程裡哪個判斷無法靠固定規則完成,卻能被拆成有限選項、分數或機率?
答案若找得到,就讓 Jev 處理那一小段語意判斷,把資料存取、規則、權限與實際動作留給程式碼。答案若找不到,代表需求仍太開放,應繼續由聊天模型或人工處理。
我會把 TypeSafe 視為值得試驗的新型決策元件,但不會因官方列出許多產業案例就直接投入正式流程。先用自己的歷史資料證明信心值可信、錯誤可以安全分流、總成本確實下降,再逐步擴大自動化,才是這張 Use Case Map 最合理的使用方式。
資料來源
- TypeSafe AI:Example use cases
- TypeSafe AI:How to build with TypeSafe
- TypeSafe AI:Primitives
- TypeSafe AI:Patterns
- TypeSafe AI:Workflow evals
- TypeSafe AI:Invoice Processing workflow
- TypeSafe AI:Customer Service workflow
- TypeSafe AI:Introducing System One Models & Jev
- TypeSafe AI Python SDK
- TypeSafe AI JavaScript/TypeScript SDK
- Nakshatra Saxena:Jev 稅務文件分類器展示
- kyotofin:tax-doc-classifier 開源程式庫
- Carlos Marcial:Divert 緊急改道展示
- Braintrust:Jev judge scorer 整合
- Oskar:Tester Army E2E Agent 預覽
- Max Blade:免喚醒詞語音控制原型