Perplexity Computer 推出 Effort Mode!四段滑桿調節推理深度與模型編排:「Spend Dial」如何終結 Agent 的 Token 燃燒焦慮?
Perplexity 於 2026 年 9 月 17 日為旗下自主代理 Computer 推出全新「Effort Mode(努力模式)」。透過 Omnibar 中的四段滑桿,使用者可輕鬆設定任務努力程度與預算,由系統自動分配思考深度與調度底層最佳模型。
2026 年 9 月 17 日,Perplexity 官方部落格正式發布文章《Computer adds effort mode for model selection》,宣布為旗下旗艦自主 AI 代理系統 Perplexity Computer 推出全新重量級功能——Effort Mode(算力努力模式 / 努力程度控制)。
這項更新直接整合於 Perplexity Computer 介面頂部的 Omnibar(多功能命令列),提供直觀的四段式滑桿:Light(輕度)、Standard(標準)、High(深度)與 Ultra(極致)。
使用者只需拖動滑桿,就能像轉動音量旋鈕一樣,精確設定「這項任務值得投入多少思考心力與點數預算」;而後台複雜的多模型挑選、思考鏈長度分配(Reasoning Depth)與子任務拆解路由,則全權交由 Perplexity 智慧編排引擎(Orchestrator)在毫秒內自動完成。
「我們在 Computer 的 Omnibar 中加入了努力程度控制滑桿。這是一個專為使用者打造的『支出旋鈕(Spend Dial)』:在預算與深度之間自由權衡,把挑選底層模型的繁瑣工作交給 Perplexity;若需要完全掌控,亦可隨時切換回高階自訂模式。」
—— Perplexity 官方產品團隊
在過去一年中,AI Agent(智慧代理)雖展現了自動執行長鏈路任務的驚人潛力,但**「Token 燃燒焦慮」與「模型選擇困境」**始終是橫亙在使用者與企業面前的兩大巨石。使用者常因一項簡單的表格抓取,眼睜睜看著頂級模型進行冗長的「過度思考(Over-thinking)」並迅速燒乾帳戶點數;又或在面對龐大的跨領域研究時,因選錯輕量模型而導致任務中途夭折。
Perplexity 繼日前推出本機零 Token 運行的 Portable Computer(Windows RTX / Mac) 後,本次在雲端核心戰場揮出重拳,透過 Effort Mode 重新定義了人機協作的成本控制範式。本文將為你全方位深度拆解 Effort Mode 的架構邏輯、檔位劃分、背後的經濟學效益、橫向競品對比,以及最實用的工作流決策指南。
Perplexity 官方展示 Computer 代理系統執行多步驟任務、瀏覽器操作與代碼處理之自動化流程。影片來源:Perplexity 官方。
一、從「挑選模型」到「設定預算」:AI 交互的範式大轉移
要理解 Effort Mode 的里程碑意義,必須先回顧過去兩年使用者操作 AI 的演進脈絡:
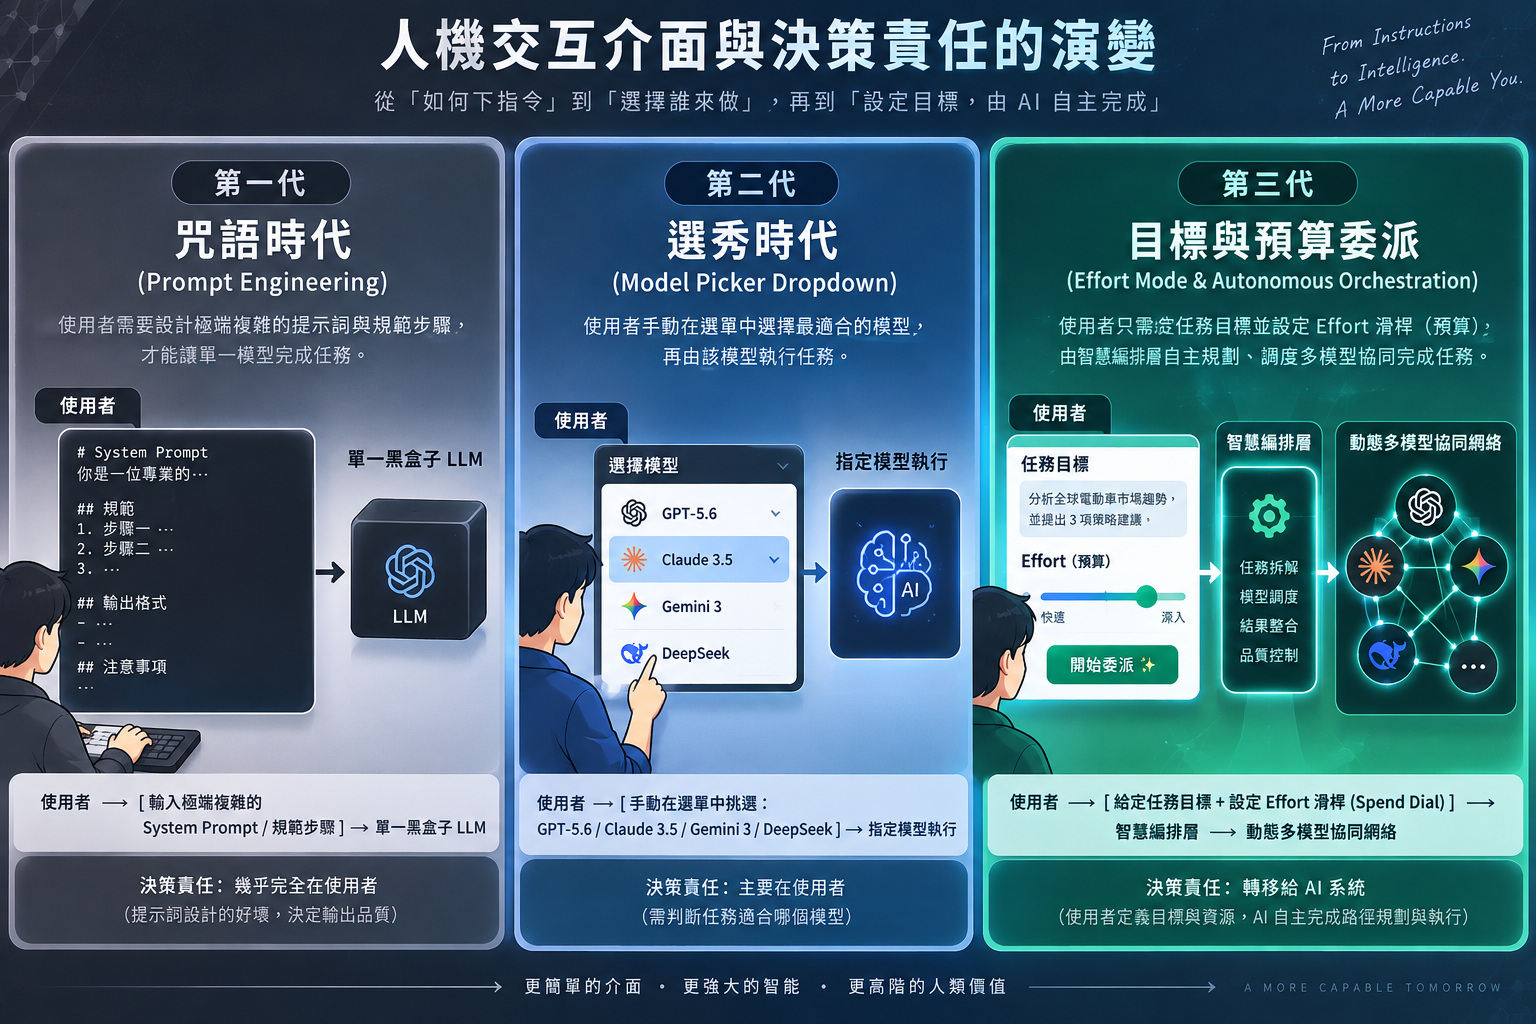
1. 傳統「模型下拉選單」的認知負擔
在傳統 AI 平台中,介面上總是擺著一排琳瑯滿目的下拉選單:GPT-5.6、GPT-5 Mini、Claude 3.5 Sonnet、Claude 3 Opus、Gemini 1.5 Pro、Gemini 3.8 Flash……
這種設計迫使一般工作者、法務審查員或行銷企劃必須具備「AI 硬體與評測專家的知識」:
- 寫文案該選 Claude 還是 GPT?
- 抓取 50 頁 PDF 的表格,到底哪一個模型成本最低且不會胡言亂語?
- 模型到底會思考 5 秒還是思考 2 分鐘?這次執行會花掉我 5 點還是 50 點 Credit?
對於專注於解決實際業務問題的使用者而言,「挑選模型」根本不是自由,而是一種沉重的認知負擔。
2. 代理工作流的「Token 燃燒焦慮(Token Burn Anxiety)」
當互動形態從「單問單答(Chat)」升級為「多步驟代理(Agent)」時,問題更加嚴峻。
一個 Agent 任務(例如:「收集 10 間競品的定價策略並產出 Excel 表格」)往往包含:目標分解、網頁檢索、點擊模擬、文字剖析、數據清洗、語法自我除錯(Self-Correction)與格式排版。
在缺乏思考深度與預算限制的情況下,系統極易陷入以下兩種極端困境:
- 過度思考(Over-thinking)與點數蒸發:
對於單純的網址爬取或文字格式轉換,頂級推理模型可能自作聰明地展開數千個 Token 的「深度推理」,耗時數分鐘且消耗昂貴的點數,造成嚴重的資源浪費。 - 偷工減料(Under-thinking)與邏輯崩潰:
若使用者為了省錢手動選用輕量化模型,當 Agent 遇到稍微複雜的邏輯轉折或代碼報錯時,便缺乏足夠的思考深度去自我修正,最終產出殘缺的垃圾結果。
Perplexity Effort Mode 的誕生,正是為了解決這道兩難題——它把「技術參數的決策權」收回系統後台,把「價值與預算的控制權」還給使用者。
二、Omnibar 四段滑桿拆解:Light、Standard、High、Ultra
在 Perplexity Computer 的網頁版介面中,Omnibar 命令列內新增了具備四個刻度的實體滑桿。每個檔位不僅代表了不同的推理深度(Reasoning Depth),更在底層對應了截然不同的模型調度策略與點數消耗速率:
[ Light ] ──────── [ Standard ] ──────── [ High ] ──────── [ Ultra ]
 輕量極速            日常標準(預設)        深度推理            旗艦極致
 低成本 / 低延遲      平衡甜蜜點           長鏈推演            多代理平行壓榨
1. Light(輕度模式):極速執行與預算護城河
- 核心哲學: 成本最小化、極短響應時間、杜絕任何不必要的「腦補推理」。
- 底層模型調度: 優先啟用高輸送量、低延遲的緊湊型模型(如經由 Perplexity 特調優化的小型開源模型或輕量雲端模型),強制將思考鏈限制在極簡狀態。
- 點數消耗特性: 最低檔位消耗。相比 Standard 模式,每次任務可節省約 60% 至 75% 的 Credit 支出。
- 最佳適用場景:
- 大批量檔案與試算表的格式統一與重新命名。
- 明確事實的單一檢索(例如:「查詢台積電最新一季的每股盈餘」)。
- 文本簡單摘要、信件草稿格式排版。
- 固定規則的數據提取(從 10 份規格書中抽出尺寸與重量數據)。
2. Standard(標準模式):日常生產力的平衡甜蜜點(預設)
- 核心哲學: 兼顧執行品質、推演速度與合理點數支出的「黃金分割線」。
- 底層模型調度: 動態配置主流中高階多模態模型,賦予適度的自我檢查與反思修正能力(Reflection Step 1~2 輪)。
- 點數消耗特性: 基準計費(1.0x 基準消耗率)。
- 最佳適用場景:
- 一般多步驟網路調查與競品概況彙整。
- 跨 3~5 份文檔的重點交叉對照與研討總結。
- 日常 Python 數據視覺化圖表生成。
- 常規社交媒體推廣文案矩陣與行銷企劃大綱。
3. High(深度模式):嚴密邏輯與複雜除錯專家
- 核心哲學: 智力與邏輯優先,允許系統花費充裕時間構建深度思考鏈,深入探究邊緣案例(Edge Cases)。
- 底層模型調度: 調動國際頂級前沿推理模型(如 Anthropic Claude 3.5 Sonnet 等級或具備 Extended Thinking 的頂級架構),釋放龐大的 Reasoning Tokens 空間,啟動多輪代碼驗證與錯誤回溯機制。
- 點數消耗特性: 較高消耗率(約為 Standard 的 2.5x 至 3.5x),點數隨實際運算複雜度動態浮動。
- 最佳適用場景:
- 包含數十項會計科目的複雜財務報表勾稽與異常毛利診斷。
- 多語言法律合約條款風險評估與違約責任鏈條對照。
- 中大型軟體專案之模組重構、API 封裝與單元測試編寫。
- 科學文獻研讀與多篇論文方法論之批判性綜述。
4. Ultra(極致模式):不計代價的算力全開與多代理協同
- 核心哲學: 旗艦級壓榨、容錯率極低之重大決策輔助、探索未知領域的終極算力支援。
- 底層模型調度: 啟動 Perplexity Computer 最高規格的「多代理平行作業(Multi-Agent Fleet)」;針對同一核心命題,調用不同陣營的頂尖模型進行平行推演、互為批判(Adversarial Review)與交叉驗證,將思考鏈擴展至極限。
- 點數消耗特性: 最高檔位消耗(依據任務執行深度,可能達 Standard 的 5x 至 10x 以上)。
- 最佳適用場景:
- 跨國併購(M&A)案前期的全維度商業盡職調查(Due Diligence)架構規劃。
- 橫跨數千行代碼的系統級架構遷移與底層效能瓶頸重構。
- 跨數十家機構產業研報的深度戰略情報推演與宏觀經濟預測模型構建。
- 複雜學術數學證明、演算法理論驗證與極限邊界推導。
三、四檔 Effort Mode 完整參數與規格矩陣
為方便讀者快速掌握各檔位的本質差異,本站團隊整理出以下詳細對照表:
| 評比維度 | Light(輕度) | Standard(標準 - 預設) | High(深度) | Ultra(極致) |
|---|---|---|---|---|
| 介面位置 | Omnibar 滑桿第 1 刻度 | Omnibar 滑桿第 2 刻度 | Omnibar 滑桿第 3 刻度 | Omnibar 滑桿第 4 刻度 |
| 運算目標 | 速度與成本最優先 | 品質與成本最佳平衡 | 邏輯嚴密性與深度優先 | 零妥協之極致交付品質 |
| 底層模型組合 | 緊湊型低延遲模型 | 通用前沿主力模型 | 頂級深度推理模型 | 旗艦多模型協同陣列 |
| 思考鏈 (Thinking) | 極短 / 近乎即時回應 | 中等長度思考鏈 | 深度思考鏈 (多輪反思) | 最大上限思考鏈 + 交叉驗證 |
| 錯誤自修復次數 | 0 ~ 1 次(快速失敗) | 1 ~ 2 次反覆迭代 | 3 ~ 5 次深入除錯嘗試 | 無限次自我驗證直至收斂 |
| 相對 Credit 消耗 | 約 0.25x ~ 0.4x | 1.0x(基準值) | 約 2.5x ~ 3.5x | 約 5.0x ~ 10x+(視鏈路長度) |
| 平均任務響應延遲 | 數秒以內完成 | 15 ~ 45 秒 | 1 ~ 3 分鐘 | 3 ~ 10 分鐘以上(背景非同步) |
| 多代理平行能力 | 關閉(單線程執行) | 輕度循序調用 | 支援關鍵子任務平行處理 | 全面啟動多子代理平行協同 |
| 適合對象 | 日常雜務、批次數據清洗 | 一般辦公白領、文字工作者 | 軟體工程師、財務法務分析師 | 架構師、高階研究員、企業決策層 |
四、智慧編排底層揭密:「Spend Dial」如何動態調度多模型?
許多人好奇:當使用者把滑桿切換到「High」時,Perplexity 是單純把整個 Prompt 丟給某個昂貴的模型嗎?
答案是:完全不是。
如果只是單純轉發 Prompt,那只是一個套殼 API,根本配不上「Computer」這個名稱。Perplexity 這次在 Effort Mode 背後展示的,是一套成熟的**「預算感知型多模型動態編排器(Budget-Aware Multi-Model Orchestrator)」**。
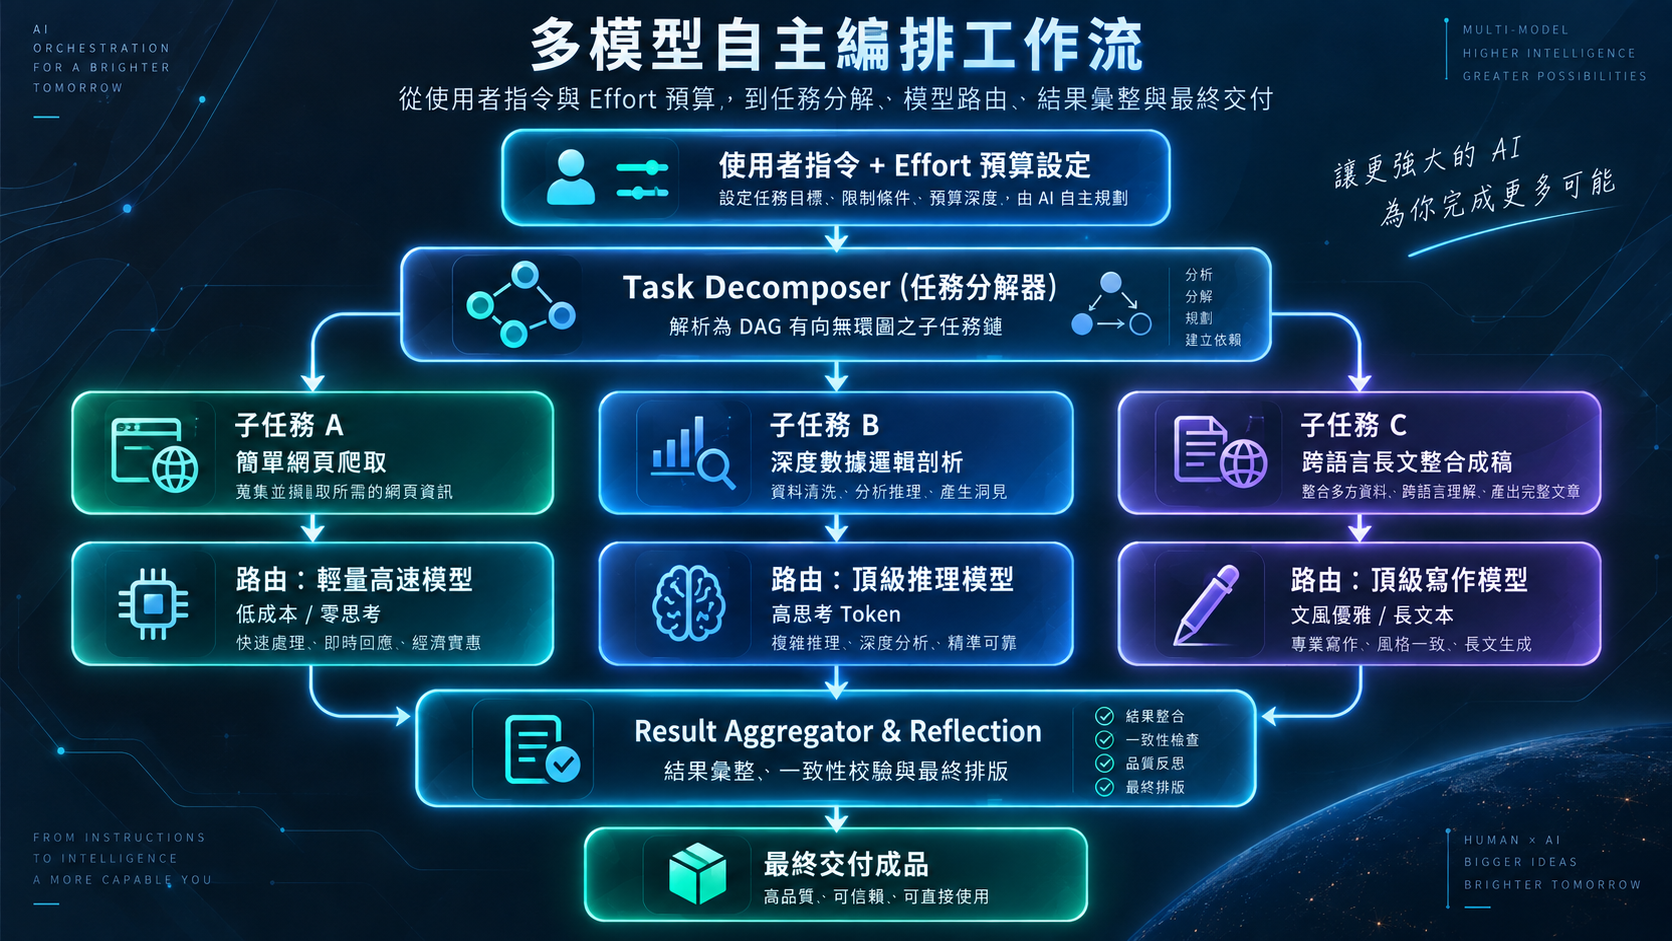
1. 任務分解與 DAG 圖構建
當使用者在 Omnibar 輸入指令並設定好 Effort 等級後,系統的 Task Decomposer 首先會將使用者的目標拆解成一張有向無環圖(DAG, Directed Acyclic Graph)。
例如「研究 5 家 AI 晶片新創公司的融資與架構,並生成投資比較表」:
- 子任務 1:Google / 專業資料庫搜尋 5 家公司公開資訊(屬性:I/O 密集、需要最新全網檢索)。
- 子任務 2:從抓取回來的 HTML 中萃取估值、投資人與產品線數據(屬性:結構化解析、單純提取)。
- 子任務 3:分析各家架構差異、推演競爭護城河與潛在技術壁壘(屬性:高度抽象推理、深度邏輯比對)。
- 子任務 4:彙整成格式工整的 Markdown / CSV 表格並撰寫結論(屬性:文字組織與格式化輸出)。
2. 預算約束下的「差異化模型路由」
在沒有 Effort Mode 之前,使用者若選了頂級模型,子任務 1、2、3、4 會全部由頂級模型執行,造成嚴重的算力浪費;若選了便宜模型,則子任務 3 會嚴重翻車。
而在 Effort Mode 架構下,系統會將你設定的 Effort 級別視為**「整體任務的運算邊界(Compute Budget Envelope)」**:
- 在 Standard 或 High 模式下,Orchestrator 會自動將子任務 1 和 2 路由給成本極低、速度極快的高效模型處理;
- 節省下來的寶貴運算預算與思考額度,則全數集中灌注給子任務 3,調用具備最強邏輯演繹能力的前沿旗艦模型進行深度思考;
- 最終的子任務 4 再調用文筆流暢的大上下文模型進行統整收尾。
這種「粗活便宜幹、重活全力砸」的動態混編架構,正是 Effort Mode 能夠在維持極高交付品質的同時,大幅降低整體點數開銷的核心秘密。
五、極客的堅持:何時該切換回 Custom Controls(自訂模式)?
儘管四段滑桿極大程度地降低了大眾使用者的門檻,但 Perplexity 並未採取「一刀切」的傲慢做法,而是明智地保留了 Custom Controls(自訂控制模式)。
在 Omnibar 旁邊,使用者隨時可以點擊進入進階自訂介面,手動指定任務所要呼叫的特定模型品牌、指定版本與自訂推理參數。
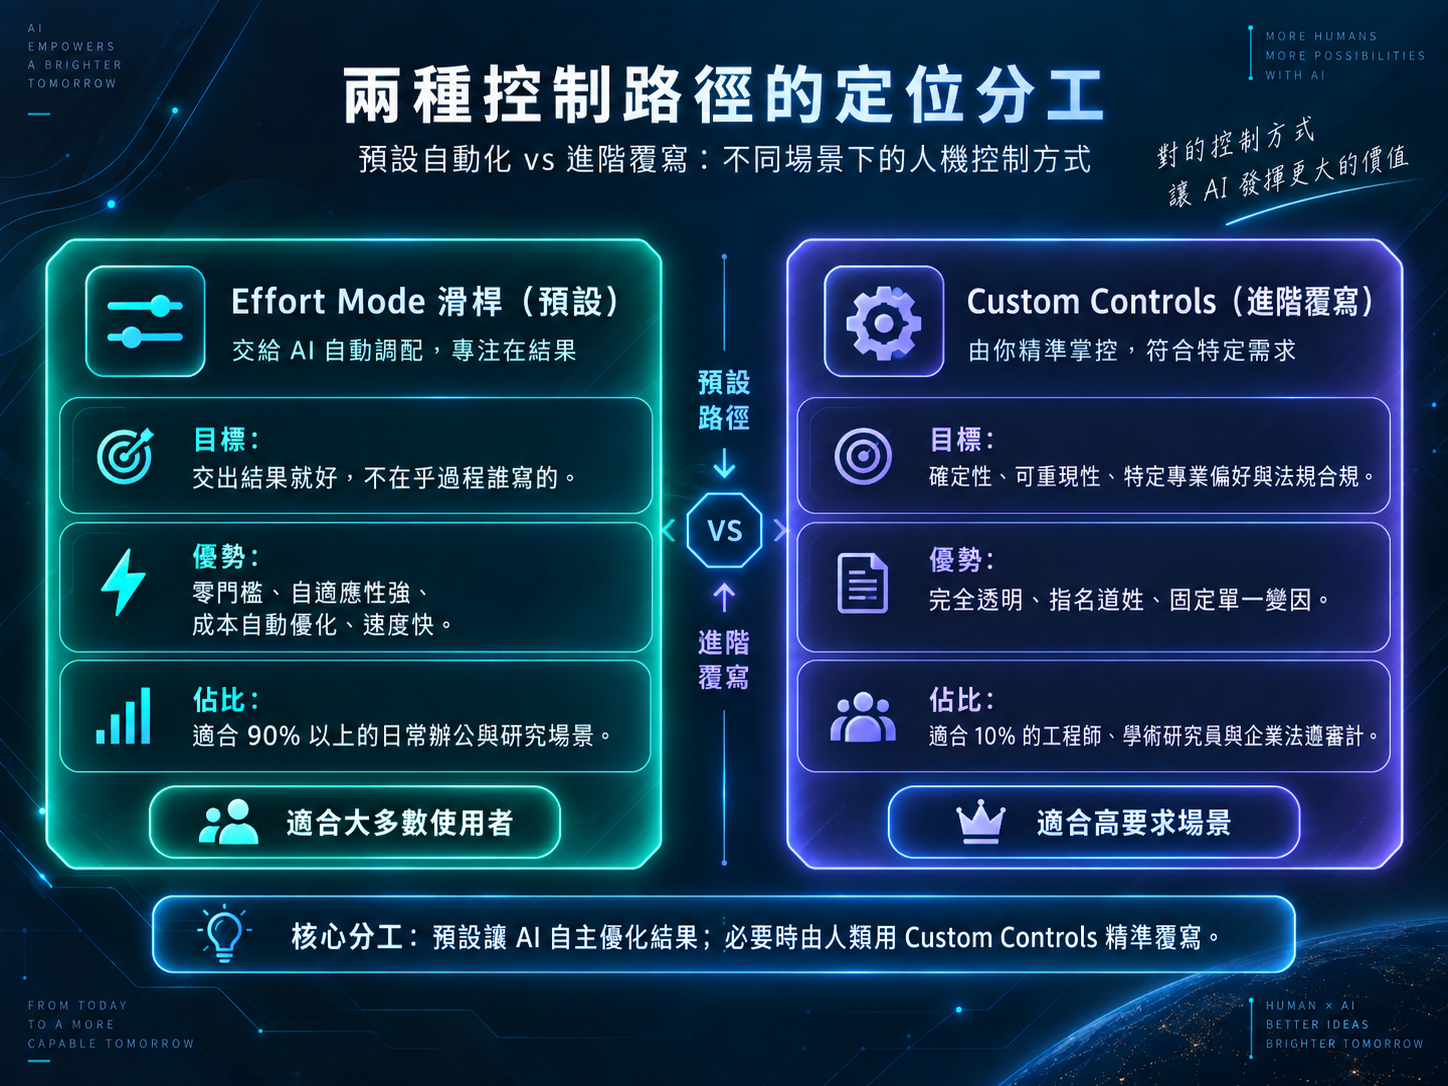
哪些情境強烈建議切回 Custom Controls?
- 工程基準測試與模型橫評(Benchmarking):
軟體工程師若正在評估某一項代碼在庫遷移時「Claude 3.5 Sonnet 與 GPT-5.6 到底誰寫的單元測試覆蓋率更高」,此時絕不能讓 Orchestrator 自行混合路由,必須在 Custom Controls 中鎖定單一模型,以保持實驗變因的絕對純粹。 - 企業法規與數據合規限制(Compliance & Data Governance):
某些跨國企業或金融機構與特定雲端巨頭簽署了專屬的資料保密協議(例如合約中嚴格規範「內部業務數據僅可經過通過某項 SOC2 認證的特定模型處理」)。此時團隊必須手動指定合格模型,避免資料流經未受審批的第三方架構。 - 特定文風或特殊語言任務的極致要求:
資深創作者或在地化翻譯人員往往對各家模型的「筆觸靈性」有極高敏感度。例如公認某些模型在中文繁體語感、成語典故與諷刺修辭上表現更自然,而另一些模型則略顯生硬機械。此時直接指名特定模型,能省去後續多次調整風格的麻煩。
六、橫向大評比:Perplexity vs. OpenAI / Google / Claude 之推理控制戰
「讓使用者控制 AI 的思考努力程度」並非 Perplexity 憑空創造,而是 2025 至 2026 年整個生成式 AI 領域最受矚目的架構趨勢。然而,各大巨頭切入的角度大相逕庭:
| 評比維度 | Perplexity Computer | OpenAI (o系列 / Reasoning Effort) | Google Gemini (Extended Thinking) | Anthropic Claude (Thinking Budget) |
|---|---|---|---|---|
| 最新功能名稱 | Effort Mode | Reasoning Effort Parameter | Extended Thinking Budget | Extended Thinking / Token Budget |
| 互動載體 | 四段式視覺滑桿 (Omnibar) | 下拉選單 (Low / Med / High) 或 API 參數 | 滑桿或時間設定 (思考秒數/Token) | 參數設定 (max_thinking_tokens) |
| 多模型跨品牌路由 | 原生支援(自動調度多陣營頂級模型) | ❌ 僅限 OpenAI 自身 o 系列模型 | ❌ 僅限 Google 自家 Gemini 模型 | ❌ 僅限 Anthropic 自家 Claude 模型 |
| Agent 自動工具調用 | 全自動閉環(整合瀏覽、代碼、Office、API) | 需搭配 Operator 或自建 Assistants API | 整合 Google Workspace 雲端工具 | 整合 Computer Use / MCP 工具協議 |
| 成本透明度 | 高(以「Spend Dial」概念連結點數) | 中(需依 Prompt/Output Token 換算) | 中(依計費等級或進階訂閱抵扣) | 中(明訂 Thinking Token 計費標準) |
| 主要定位 | 終端通用工作者 (Digital Worker) | 頂級底層推理引擎 / 數學專家 | 跨模態全能知識助手 | 代碼編程與長文本深度思考之王 |
深度洞察:Perplexity 的不對稱競爭優勢
從上述對照可以清晰看出 Perplexity 的獨特戰略定位:
- OpenAI、Google 與 Anthropic 是「模型生產商(Model Producers)」,他們的思考控制功能本質上是在為自家單一模型微調超參數(Hyperparameters)。
- Perplexity 則是「智慧聚合與編排平台(Intelligent Aggregator & Orchestrator)」。Perplexity 不必承擔每一款基礎模型耗資數十億美元的龐大預訓練風險,它的核心護城河在於**「誰能以最低的成本、最直覺的介面,把全天下最好的模型組織成一支替人類打工的 Agent 特遣隊」**。
Effort Mode 的推出,讓 Perplexity 成為業界第一個成功將**「跨模型動態路由」與「推理深度彈性預算」**完美合體的產品。
七、實戰決策指南:4 大檔位最佳使用情境 Playbook
為了讓讀者在開啟 Perplexity Computer 時不再猶豫不決,本站整理出這套**「實戰檔位對照矩陣」**,建議直接收藏參考:
情境 1:極速日常(鎖定 Light 檔)
- 任務指令: 「讀取我上傳的 CSV 銷售資料,將所有日期格式轉換為
YYYY-MM-DD,篩選出金額大於 10,000 元的訂單,並另存為新的 Excel 檔案。」 - 為何選 Light: 邏輯完全確定,不涉及任何主觀判斷或複雜推演,開啟 High 只會浪費點數空轉。
情境 2:標準日常研討(鎖定 Standard 檔)
- 任務指令: 「搜尋近兩週全球關於固態電池商用化進展的 5 大代表性新聞,整理各家技術路線(氧化物 vs 硫化物)、預計量產年份,並列出原文引用來源。」
- 為何選 Standard: 需要網路檢索與多來源事實比對,Standard 的思考深度足以勝任交叉查核,同時在數十秒內快速交付。
情境 3:專業高壓產出(鎖定 High 檔)
- 任務指令: 「分析這家 SaaS 公司的近三年財報 PDF。請特別計算其 CAC Payback Period 與 Magic Number,指出毛利率下滑的具體成本項目,並以財務分析師視角列出 3 大核心經營隱憂。」
- 為何選 High: 財務數據之間存在隱蔽的勾稽關係,必須依賴深度推理鏈(Multi-step Reasoning)進行層層推導與公式驗證,避免傳統 LLM 容易出現的數字幻覺。
情境 4:重大突破與系統重構(鎖定 Ultra 檔)
- 任務指令: 「這是一個由 15 個檔案組成的舊版 Node.js 專案代碼庫。請為我重構成 TypeScript 架構,引入現代化依賴注入模式,補齊所有關鍵路徑的 Jest 單元測試,並撰寫完整的遷移說明文檔與 Dockerfile。」
- 為何選 Ultra: 涉及全域依賴關係重整、語法轉型與邊界條件覆蓋。Ultra 模式會指派多個子代理分別進行「代碼拆解」、「型別定義」、「測試執行」與「相互代碼審查(Code Review)」,以全方位算力確保程式碼可直接編譯運行。
八、常見問題深度 FAQ
Q1:Effort Mode 每次執行到底扣除多少 Credit 點數?
答: Perplexity Computer 的點數扣除採用「基礎費率 × 實際運算工時/Token 規模」的彈性計費模式。
- Light 模式下,每次呼叫的基本底價極低,且因限制思考鏈長度,整體消耗通常僅有 Standard 的四分之一左右。
- Ultra 模式則沒有嚴格的點數上限,系統會根據任務分解出的子任務數量、呼叫的頂級旗艦模型次數與生成的推理 Token 實時累加扣款。
- 建議在執行極為龐大的開放式任務前,先以 Standard 模式跑出任務大綱,確認方向正確後再升級至 High 或 Ultra 進行精細化深耕。
Q2:如果在 High 或 Ultra 模式下,任務因外部網路中斷或報錯而失敗,點數會退還嗎?
答: 根據 Perplexity 官方的計費容錯政策,若中斷是由於 Perplexity 伺服器端超時、基礎模型無回應或沙盒系統崩潰所致,系統會自動判定為異常並全額回退該次任務消耗的 Credit;但若任務已成功完成運算並給出推導結論,僅是結論未達使用者主觀預期,則視為正常運算消耗不予退還。
Q3:Effort Mode 目前可以在哪些平台上使用?行動端何時支援?
答: 截至 2026 年 9 月 17 日首發日,Effort Mode 已正式上線於 Perplexity Computer 網頁端(Web)。官方已明確表示,iOS 與 Android 行動應用程式以及 macOS / Windows 桌面端客戶端的適配更新正在進行最後測試,預計將在接下來的幾週內陸續推播更新。
Q4:這項雲端 Effort Mode 與日前發布的「Portable Computer 本機版」有何關係?
答: 兩者是 Perplexity 構築的「雲地協同(Hybrid Agent Ecosystem)」兩大支柱:
- Portable Computer(本機版): 鎖定擁有 24GB VRAM(如 NVIDIA RTX 3090/4090/5090)的硬體用戶,強調敏感資料 100% 留在本機沙盒運行,享受「零 Token 費用」的無限本地推論。
- 雲端 Computer(含 Effort Mode): 鎖定廣大沒有頂級顯卡的個人與企業用戶,提供無硬體門檻的完整雲端前沿算力,並透過 Effort Mode 賦予使用者精準控制雲端帳單的能力。
- 未來兩者預計將進一步打通:使用者在本機跑雜務,當遇到瓶頸時,可直接透過 Omnibar 的 Effort 滑桿決定「以何種規格的雲端算力升級支援」。
九、本站觀點:告別「算力焦慮」,邁向負責任的 AI 採購新時代
Perplexity 這次在 Computer 中推出 Effort Mode,看似只是一個小巧的 UI 滑桿更新,但其背後所折射出的,是整個生成式 AI 產業從**「技術盲目狂熱」步入「冷靜務實商業化」**的關鍵分水嶺。
在過去兩年的 AI 淘金熱中,業界充斥著一種「唯參數論」的迷思——彷彿只要端出最大的模型、跑最長的思考鏈,就是最頂尖的技術。然而在現實商業世界中,算力從來不是免費的午餐。企業財務長(CFO)與個人付費者早已對難以預測的 Token 帳單感到疲憊與恐懼。
Perplexity 的聰明之處在於,它敏銳地捕捉到了使用者的核心心理:「我不需要知道引擎裡有幾個氣缸,我只需要知道踩下油門後,我能跑多快、會耗多少油。」
將「複雜的多模型編排架構」隱藏在「極簡的四段預算滑桿」身後,不僅大幅提升了非技術人員的操作信心,更為 AI 代理的大規模商業化普及鋪平了最後一哩路。
對於廣大知識工作者而言,未來的競爭優勢不再是誰能記住更多的提示詞咒語,也不是誰能背出最新模型的基準測試分數,而是**「精準評估一項任務的商業價值,並為其分配合適的努力預算」**。Perplexity Effort Mode 的登場,無疑為這場生產力革命提供了一把最趁手的調度量尺。
相關重要參考來源
- Perplexity 官方公告:《Computer adds effort mode for model selection》 (2026-09-17)
- Perplexity Hub:《Introducing Perplexity Computer: The General-Purpose Digital Worker》
- 產業深度評析:SQ Magazine《Perplexity Computer Adds Powerful Effort Controls for Model Selection》(2026-09-17)
- 本站歷史深度解析:《Perplexity Portable Computer 登陸 Windows!RTX 顯卡本機跑 AI Agent 深度解析》