智譜 Z.ai 重磅揭密「模型自造基礎設施」!GLM-5.3 帶領 Infra Agent 於 10 萬國產算力卡兩週吞吐飆 3 倍:Ox Alpha 身分正式揭曉、稠密反饋擊破 GIL 鎖死瓶頸與遞歸自我改進(RSI)黎明深度解析
智譜 AI(Z.ai)發表《Toward Recursive Self-Improvement》技術震撼彈!證實 8 月在 OpenRouter 橫掃 62 兆 Token 的匿名模型 Ox Alpha 真身為 GLM-5.3-Flash。更首度揭露 GLM-5.3 驅動的 Infra Agent 如何在超過 10 萬張國產算力卡叢集上自主修復底層算子精度與 Python GIL 鎖死,兩週內將推論吞吐拉升 3 倍,能效逼平 NVIDIA。深度剖析稠密反饋機制與「模型優化系統,系統運行模型」的 RSI 黎明。
「老實說,在 GLM-4.7 之前,我們內部使用 GLM 寫代碼還帶著某種義務感——畢竟那是我們自己親手打造的孩子。但在那時,代碼產品與市場契合度(PMF)尚未真正到來。
而今天,GLM-5.3 已經成為團隊中每位工程師不可或缺的每日結對夥伴,並且正穩步走向取代我們。
如果這個趨勢持續下去,在給予足夠的算力與時間的前提下,它的終點將是一個能完全自主設計並訓練自身繼承者的系統。這在理論上被稱為『遞歸自我改進(Recursive Self-Improvement, RSI)』。
我們目前尚未抵達那個終點,但它的早期雛形已經破土而出。模型優化系統;系統運行模型。」
—— 智譜 AI(Z.ai)官方工程技術團隊(2026 年 9 月 17 日)
We’re sharing how GLM-5.3 helped build and optimize the inference infrastructure serving GLM-5.3-Flash.
— Z.ai (@Zai_org) September 17, 2026
The system went from its first successful run to production readiness in less than two weeks, with end-to-end throughput tripling relative to the initial baseline.
The key was dense feedback: local correctness tests, execution traces, microbenchmarks, and end-to-end measurements that enabled targeted hypothesis testing rather than reliance on aggregate performance metrics alone.
https://z.ai/blog/glm-built-its-inference-infrastructure
智譜 AI 官方 X(Twitter)正式公告:揭露 GLM-5.3 驅動的 Infra Agent 如何調優推論系統並達到 3 倍吞吐。來源:X 官方貼文(@Zai_org)。
人工智慧的演進史,即將翻開最令工程界屏息的一頁:AI 不再只是待在機房裡被人伺候的算力消耗者,而是開始親手為自己打造更強悍的伺服器與推論引擎。
2026 年 9 月 17 日,中國頂級大模型實驗室智譜 AI(Z.ai,海外社群帳號 @Zai_org)發表了一篇引發全球系統工程師與開源社群劇烈震撼的技術長文——《Toward Recursive Self-Improvement: How GLM Built Its Own Inference Infrastructure》(邁向遞歸自我改進:GLM 如何構建自身的推論基礎設施)。
這篇技術披露同步解答了過去一個月來籠罩在矽谷與開發者社群頭頂上的巨大謎團: 2026 年 8 月底,在國際大模型路由平台 OpenRouter 與終端開源代碼環境 OpenCode 上,憑藉 100 萬 Token 超大上下文、支援多模態與狂暴修復能力,在短短 6 天內被全球開發者瘋狂調用超過 62 兆(62 Trillion)Tokens 的神祕盲測模型「Ox Alpha(stealth/ox-alpha)」,其幕後真身正是智譜的 GLM-5.3-Flash!
然而,比身分破案更令人震撼的,是這款模型背後聳人聽聞的生產系統誕生過程:
- 十萬卡荒原突圍:該推論系統並非搭建在成熟的 NVIDIA CUDA 溫室中,而是部屬在超過 100,000 張國產 AI 加速卡 所組成的超大型算力叢集上;
- 軟體生態近乎空白:硬體顯存容量與頻寬受限、專用算子庫嚴重缺失、軟體文檔殘缺甚至「全靠工程師猜測」;
- AI 自己寫代碼調效能:在如此惡劣的工程環境下,不是單靠人類基礎設施團隊熬夜排查,而是由 GLM-5.3 驅動的「基礎設施智能體(Infra Agent)」 深度介入,透過創新的 「稠密反饋(Dense Feedback)」 機制穿透 GPU 算子與 Python/C++ 邊界;
- 兩週吞吐暴飆 3 倍:從第一次成功點亮模型到全面承接生產環境真實流量,僅耗時不到兩週,端到端吞吐量達到初始基準的 3 倍,硬體利用率與單 Token 推論成本硬生生追平了主流 NVIDIA GPU。
這標誌著電腦科學界爭論數十年的假說——遞歸自我改進(Recursive Self-Improvement, RSI),不再只是科幻小說中的奇點囈語,而是切實轉化成了可觀測、可因果歸因、可代碼驗證的現代系統工程。
本文將為你全景還原這場技術戰役的內幕:從 Ox Alpha 的社群盲測傳奇、十萬國產晶片的極限壓榨、稠密反饋方法論,到 Infra Agent 如何在數百萬行代碼中精準抓出 Python GIL 鎖死與 Tensor Core 精度漂移的完整排錯實錄。
5 分鐘看懂智譜 Infra Agent 與 RSI 突破的 6 大關鍵
如果你時間有限,以下是本次智譜技術發布最核心的 6 大情報:
- Ox Alpha 神祕身分正式破案:2026 年 8 月在 OpenRouter 與 OpenCode 橫掃全球、6 天內被調用 62 兆 Tokens 的匿名怪物模型
stealth/ox-alpha,官方證實正是 GLM-5.3-Flash。 - 十萬國產算力卡極限攻堅:智譜在完全由國產 AI 晶片組成的 100,000+ 加速卡巨型叢集上,從零構建出具備 1M 上下文、多模態支援的超大規模生產級推論基礎設施。
- AI 接管底層系統優化:GLM-5.3 驅動的 Infra Agent 主導了大量核心代碼重構與效能調校,僅用不到兩週時間就讓叢集端到端推論吞吐暴增 300%(達到初始值的 3 倍),單 Token 成本逼平 NVIDIA 旗艦卡。
- 「稠密反饋(Dense Feedback)」擊破黑箱:智譜提出 Agentic 系統優化的核心命題——單純塞給 Agent 更多日誌或端到端指標(如 TTFT、吞吐)只是無效雜訊;真正的反饋必須具備「足夠局部(Local)」、「獲取及時且成本低(Timely & Inexpensive)」以及「支持客觀因果驗證(Verifiable)」。
- 三大硬核底層實戰排錯:
- 數值精度崩潰:修正 KDA 算子中
tl.dot預設 TF32 導致長上下文誤差累積,改採input_precision="tf32x3"(已合入 Flash Linear Attention 官方 upstream PR #1180); - 跨層併發鎖死:抓出 DeepEP v1.2.1 未釋放 Python GIL 導致 Mooncake Transfer 執行緒凍結,將 Prefill + KV 傳輸的效能損耗從 >20% 暴力壓至 <1%;
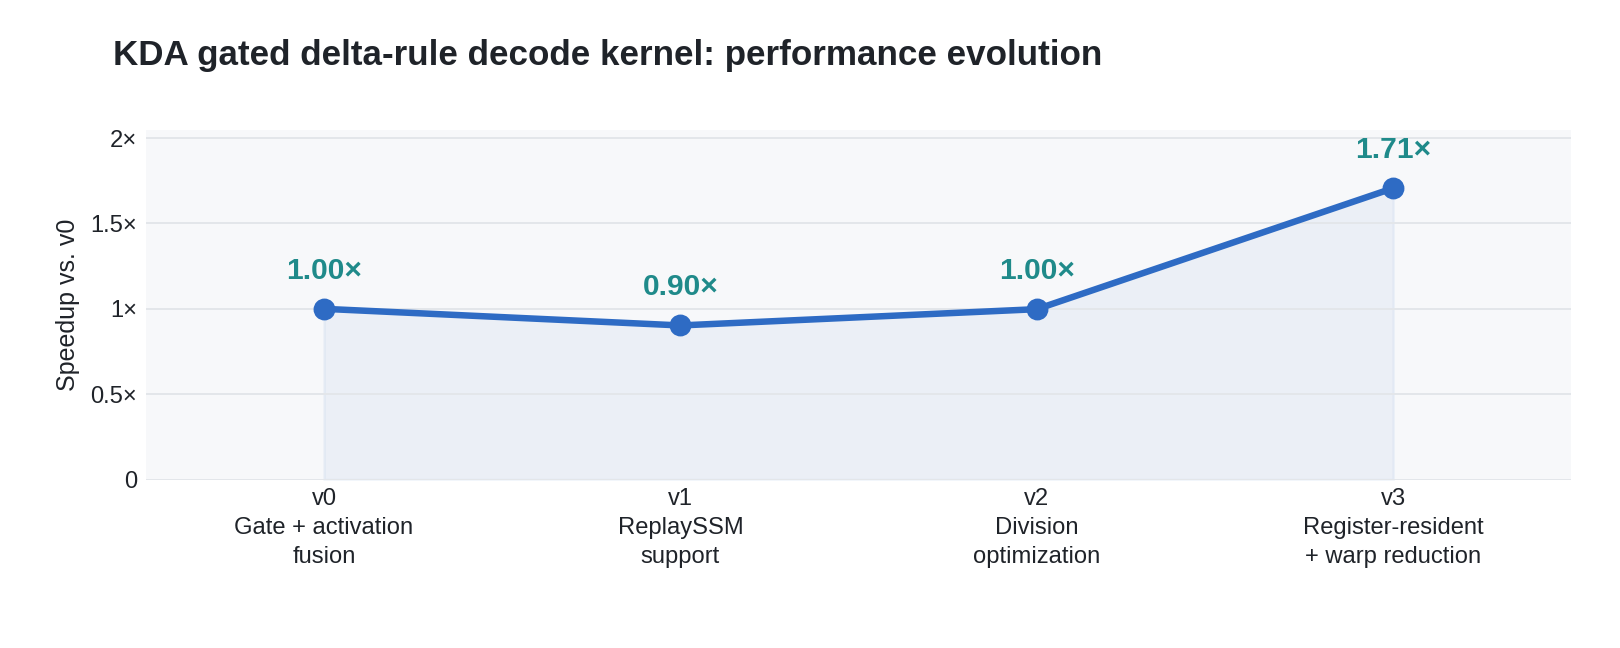
- 算子優化骨架蒸餾:從 SGLang、DeepGEMM 等開源專案萃取優化範式,消滅 V 維度 4 次重複歸一化計算,單算子斬獲 1.71 倍加速。
- 數值精度崩潰:修正 KDA 算子中
- RSI 黎明與人類工程師防線:「模型優化系統,系統運行模型」的閉環已經形成。工程師的角色徹底退居為「目標定義者、邊界約束者與高風險變更審查者」,開啟軟體工程第三時代。
一、懸案終結!從 OpenRouter 62 兆 Token 狂潮到官方實名:Ox Alpha 正是 GLM-5.3-Flash
要理解這次發布在業界掀起的波瀾,必須先將時間軸撥回 2026 年 8 月下旬。
當時,全球 AI 狂熱者與程式設計師的目光都被一個突然出現在 OpenRouter 上的神祕模型所吸引,其代號為 「Ox Alpha」(模型識別碼:stealth/ox-alpha)。
[OpenRouter 匿名盲測頁面]
Model: stealth/ox-alpha
Context Window: 1,048,576 Tokens (1M)
Max Output: 131,072 Tokens (128K)
Modality: Text, Image, Video
Pricing: FREE (Limited Preview)
Provider: Anonymous
1. 席捲全球開發者終端的「盲測風暴」
在 OpenRouter 上線不到 24 小時,新一代開源編程代理工具 OpenCode 緊接著在社群平台 X 上宣布:OpenCode 準備了每天高達 100T Tokens 的算力池,為全網開發者開放為期一週的 Ox Alpha 完全免費調用。
在那一週裡,全網工程師幾乎陷入了瘋狂:
- 百萬 Context 隨便塞:開發者將包含上百個檔案的龐大代碼倉庫、全套架構設計 PDF、甚至是整段數小時的軟體操作錄影直接丟給 Ox Alpha;
- 程式碼修復實力驚人:在多個獨立社群維護的真實代碼基準(如包含了大量複雜跨檔案依賴與微服務除錯的 10 題極限測試)中,Ox Alpha 飆出了高達 80% 的通過率,甚至壓過了當時的主流旗艦;
- 天文數字般的調用量:根據 OpenCode 與 OpenRouter 後續的統計,在短短 6 天之內,Ox Alpha 在這兩大平台上累計處理了超過 62 兆(62 Trillion)Tokens,創下了 AI 盲測歷史上的最高即時並發與調用紀錄。
2. 身分猜測與技術指紋追蹤
當時,社群對 Ox Alpha 的身分爭論不休。包括在當時的追蹤報導中,便曾透過 Tokenizer 的分詞特徵與開源指紋比對工具 modelprint 發現: Ox Alpha 在 9 項核心分詞特徵中有 6 項與 GLM-5.3 完全吻合,所有正規化 Tokenizer 測試更是 100% 重合。
儘管技術證據強烈指向智譜,但官方始終保持緘默。直到 9 月 17 日的今天,智譜工程團隊才在技術長文中雲淡風輕地寫下這段話:
「接下來發生的事情大家已經很熟悉了。GLM-5.3-Flash 以匿名模型 Ox-Alpha 的名稱,在 OpenCode 與 OpenRouter 上接受了真實世界極限流量的洗禮。上線一週之內,它成為兩個平台上使用量最高的模型,在六天內處理了超過 62 兆個 Token。」
這是一次教科書級別的「以戰養戰」。智譜之所以將其匿名投放,不僅是為了測試模型本身的推理品質,更是為了用全網最嚴苛、最多樣化的真實併發請求,對他們剛剛搭建完成的全新推論基礎設施進行終極「壓力測試」。
而真正震撼業界的,不是 Ox Alpha 有多聰明,而是這套在 6 天內扛住 62 兆 Token 狂暴衝擊的底層推論架構,究竟是怎麼做出來的。
二、10 萬張國產 AI 算力卡極限突圍:在「文檔靠猜、算子缺失」荒原上的超級工程
在過去兩年間,全球 AI 基礎設施的演進幾乎完全綁定在 NVIDIA 的技術堆疊上——CUDA、NVLink、TensorRT-LLM、Triton 等工具鏈讓矽谷工程師享有了極其優渥的開發體驗。
然而,智譜團隊面臨的卻是一場截然不同的極限生存戰:他們必須在超過 10 萬張國產自研 AI 加速卡構成的集群上,從零搭建生產級推論系統。
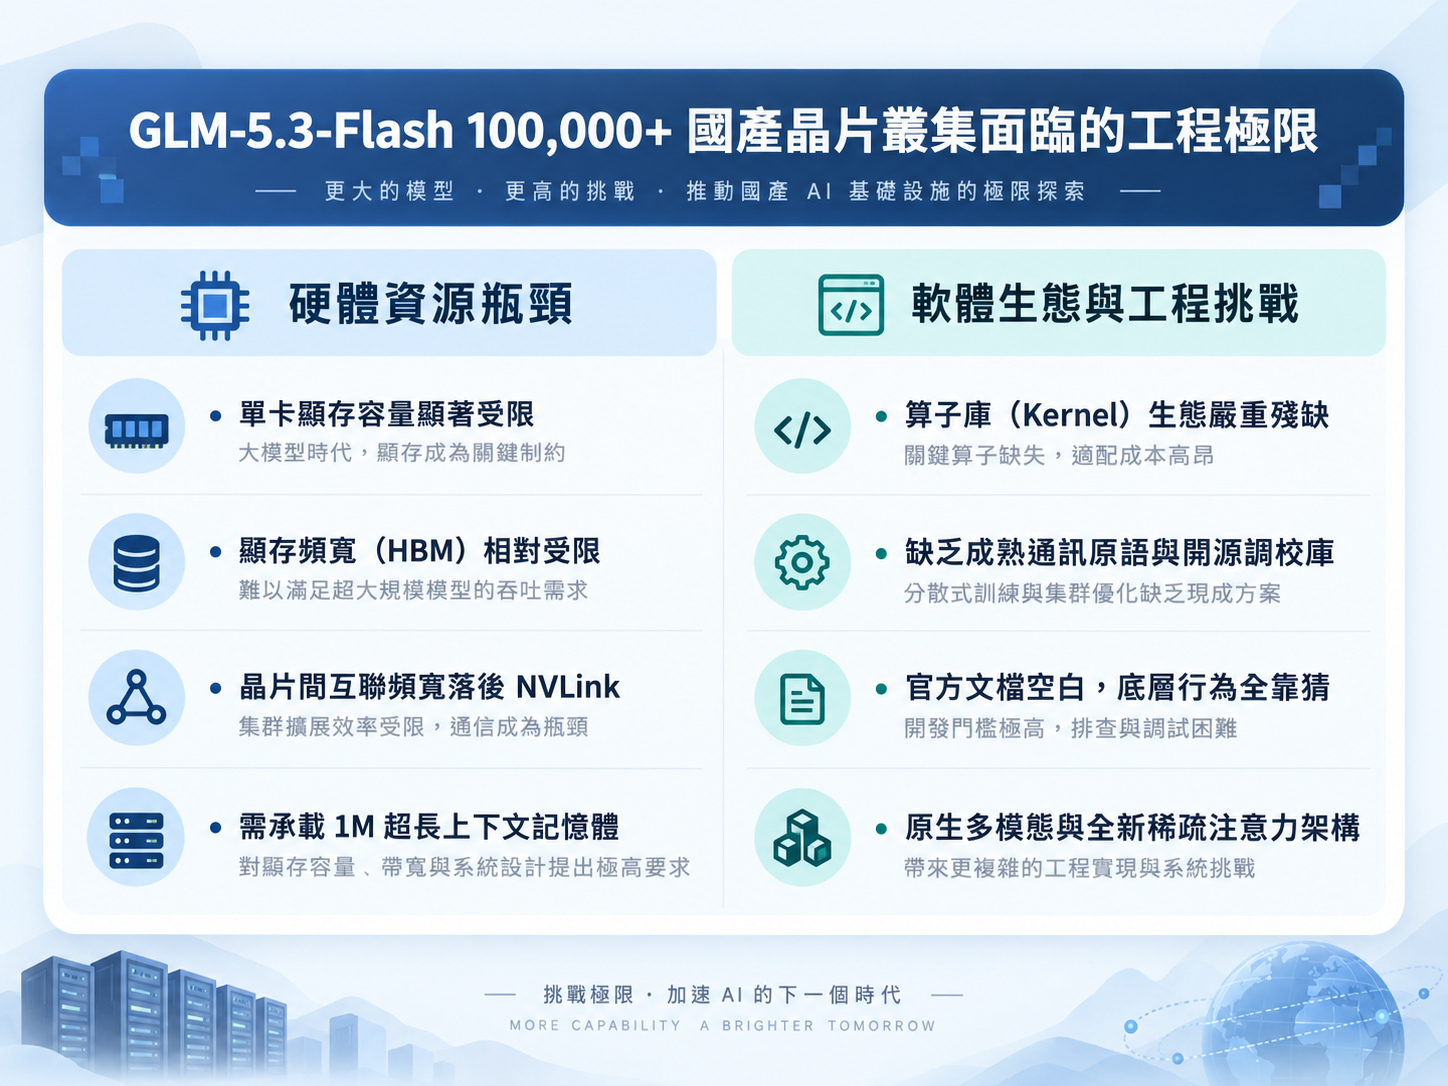
智譜在文中坦言:「此前從未有人在如此規模的國產加速晶片叢集上部署過推論服務。」在顯存容量、顯存頻寬與晶片間傳輸速率全面處於客觀劣勢的情況下,要在承接 1M 上下文與多模態請求的同時保證低延遲與高吞吐,無異於在懸崖邊上跳芭蕾。
為此,系統架構團隊與 Infra Agent 聯手打出了一套極具侵略性的記憶體壓榨與架構解耦「組合拳」:
1. 算力換頻寬、通訊換顯存的極限優化棧
為了在受限的單卡顯存中塞進模型並跑出高並發,架構設計做出了大膽的權衡折衷:
- 節點內張量並行(Intra-node Tensor Parallelism):針對線性注意力(Linear Attention)與最後的詞表預測層(LM Head)進行節點內切分,最大化利用節點內部的高速互聯;
- ReplaySSM(以重算代儲存):狀態空間模型(SSM)或循環線性注意力在長文本下需要維護龐大的中間狀態。系統採用重算機制,在需要時利用剩餘算力重新推導部分隱狀態,大幅降低設備顯存常駐佔用;
- W8A8 權重與激活量化:全面導入整數 8 位元量化,將矩陣乘法帶寬需求砍半;
- INT8 / FP8 / BF16 混合精度快取量化:依據不同網絡層對精度敏感度的差異,動態配置 KV Cache 的量化精度,在維持長文本數值穩定的極限下最大化快取容量;
- Layer Split(分層切分):將超深網絡模型打破傳統限制,進行靈活的層間負載動態配置。
2. EPD(Encode-Prefill-Decode)分離式解耦架構
傳統的大模型推論通常將 Prefill(首字計算)與 Decode(逐字生成)放在同一台機器或同一組 GPU 上交替運行,這在 1M 上下文的場景下會引發嚴重的資源爭搶與計算飢餓(Compute Starvation)。
智譜導入了前沿的 EPD 分離架構:
- Encode 節點:專門處理輸入端的多模態數據編碼(圖片、音頻、視頻);
- Prefill 節點:集結算力密集的運算單元,專攻百萬 Token 輸入的平行首字壓縮與狀態生成;
- Decode 節點:高頻寬偏置的計算單元,專門負責高速輸出生成;
- 跨節點 KV 傳輸:依賴底層分散式通信機制,將 Prefill 計算完畢的狀態秒級搬移至 Decode 節點。
這套架構最終達成了驚人的工程成果:端到端推論吞吐提升了整整 3 倍(3x),硬體利用率(MFU)與每百萬 Token 的運算成本,硬生生拉平到了國際主流 NVIDIA GPU 的水平。
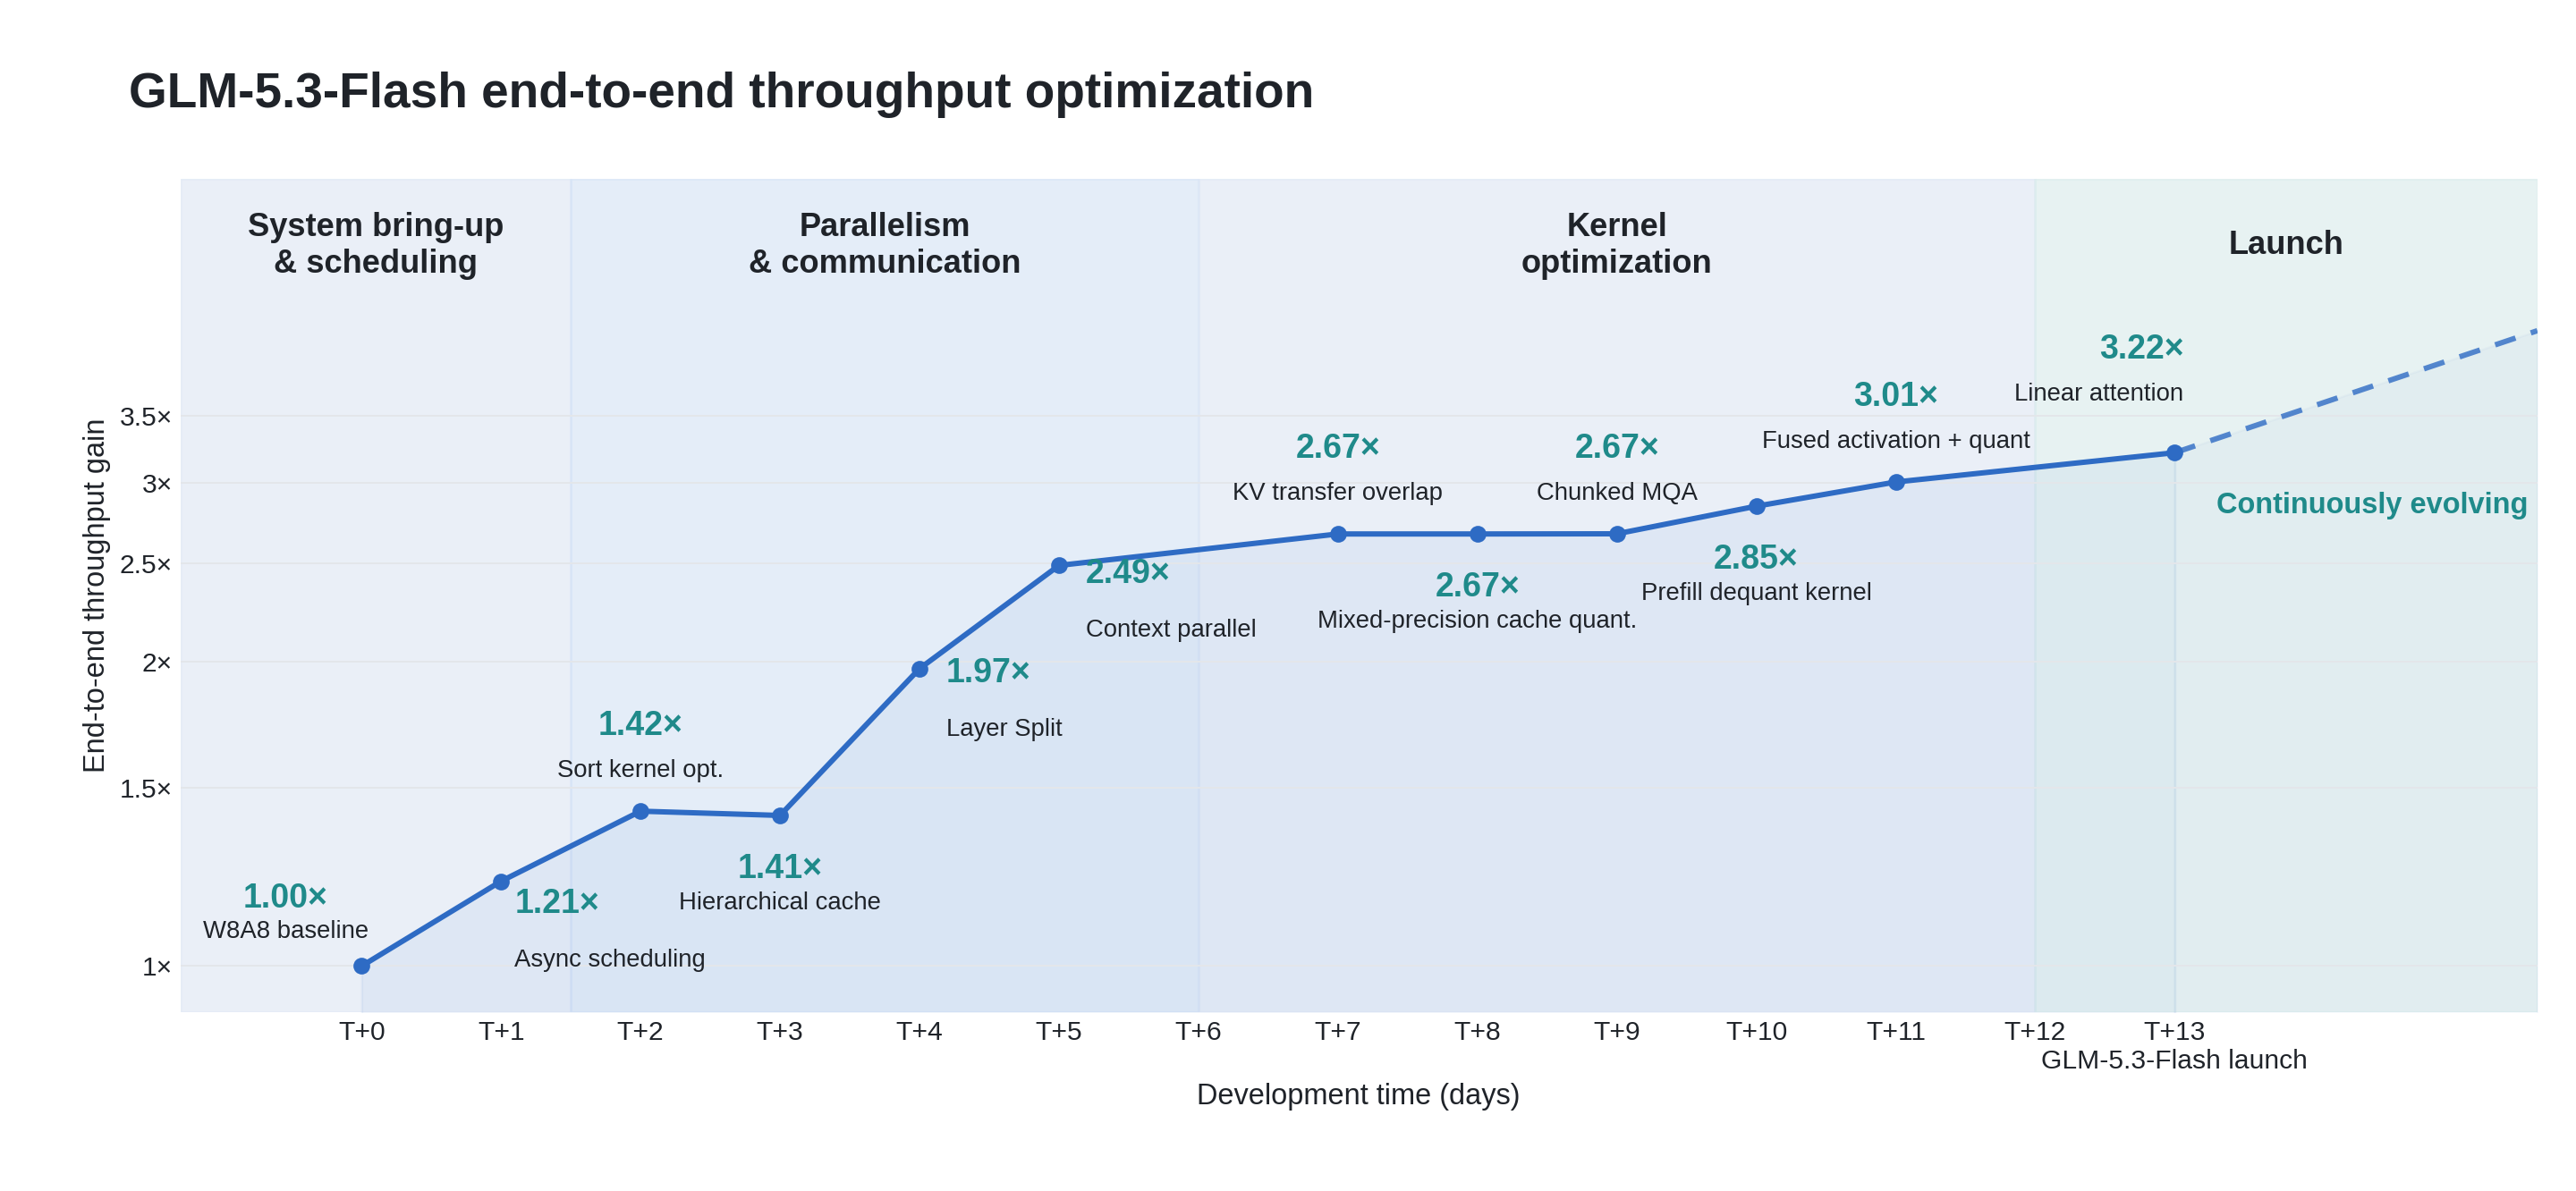
但最令人稱奇的是:這套牽涉到數十萬行 C++、CUDA/Triton 算子、分散式排程器與 Python 綁定的超複雜推論棧,是怎麼在短短兩週內完成調校與除錯的?
答案正是:由 GLM-5.3 自己驅動的 Infra Agent。
三、從靜態代碼到動態因果:為什麼「稠密反饋(Dense Feedback)」是 Infra Agent 的靈魂?
當前市面上的 Coding Agent(如 Claude Code、Cursor、Devin 等)大多擅長於處理業務邏輯、編寫 Web API 或修復具有靜態型別定義的高階代碼。然而,基礎設施工程(Infra Engineering)完全是另一個維度的怪物。
1. 靜態代碼的局限與「稀疏指標」的詛咒
智譜指出,在推論系統優化中,代碼庫(Codebase)僅僅提供了靜態上下文。 系統出現的數值精度崩塌、吞吐量斷崖式下跌或未達預期效能,往往來自跨越多個軟硬體抽象層的動態交互——包括自定義底層 Kernel 實作、多卡並行策略、非同步通訊事件、顯存碎片化管理以及服務調度器的微觀競爭。
在過去,即便把整座推論引擎的代碼塞進大模型的百萬視窗裡,只要你只給它傳統的「端到端稀疏反饋」,Agent 依然會瞬間抓瞎:
- ❌ 「回報:融合優化後模型精準度下降了 5%」
- ❌ 「回報:端到端 TTFT(首字延遲)增加了 30%」
- ❌ 「回報:系統吞吐量暴跌了 20%」
智譜強調:端到端指標只能告訴 Agent『系統變爛了』,卻無法解釋『為什麼變爛』。 面對這種稀疏反饋,AI 智能體就像盲人摸象,只能在程式碼裡胡亂嘗試猜測,往往改動了 A 卻破壞了 B,陷入無窮無盡的試錯死循環。
2. 什麼是「稠密反饋(Dense Feedback)」?
為了解決這個瓶頸,智譜推動了一套革命性的系統工程方法論——稠密反饋(Dense Feedback)。
「稠密」並不意味著把幾百 GB 的系統日誌、呼叫堆疊與硬體計數器無腦塞進 Context,而是要求實驗環境必須具備三大黃金特徵:
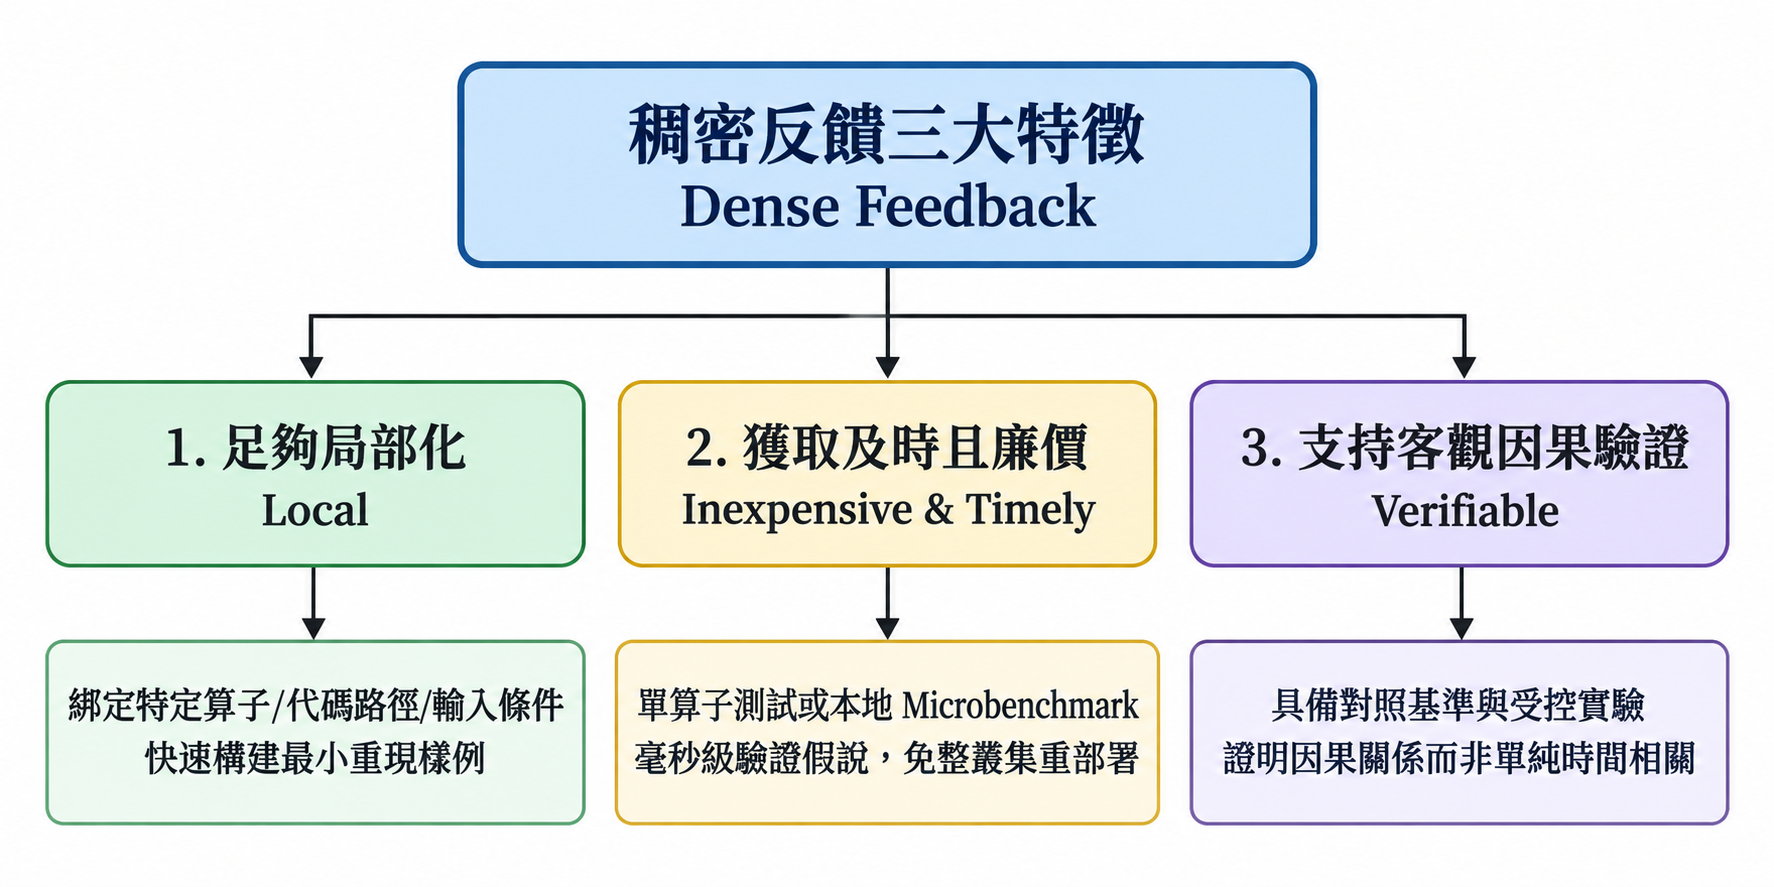
- 足夠局部化(Sufficiently Local): 反饋必須盡可能精確綁定到特定啟動參數、代碼改動行、具體底層 Kernel、特定輸入尺寸(Input Shape)、執行緒或代碼路徑。 例如:與其回報「模型精度下降」,不如直接向 Agent 呈現「在特定 Context 長度下,某算子在切分前後的數值輸出差異矩陣」,讓 Agent 能夠直接在單元測試中構造最小重現樣例(Minimal Reproduction)。
- 獲取及時且成本低廉(Inexpensive and Timely): Agent 每提出一個假說或寫出一個修補方案,必須能在秒級到分鐘級內獲得驗證。凡是能用單一 Kernel 微基準測試(Microbenchmark)解答的問題,絕不應該每次都重啟整個叢集進行全量壓測。縮短反饋週期,能避免 Agent 在無效假說上白白浪費算力與 Token。
- 支持客觀驗證(Support Objective Verification): 效能是否提升、精度是否合格,必須由參考基準(Reference Implementation)、斷言測試結果與嚴格的受控實驗指標決定。執行時訊號(Runtime Signals)只能啟發假說,只有隔離變因的對照實驗才能確立真正的「因果根因(Root Cause)」。
3. 工程師、Infra Agent 與實驗環境的協同閉環
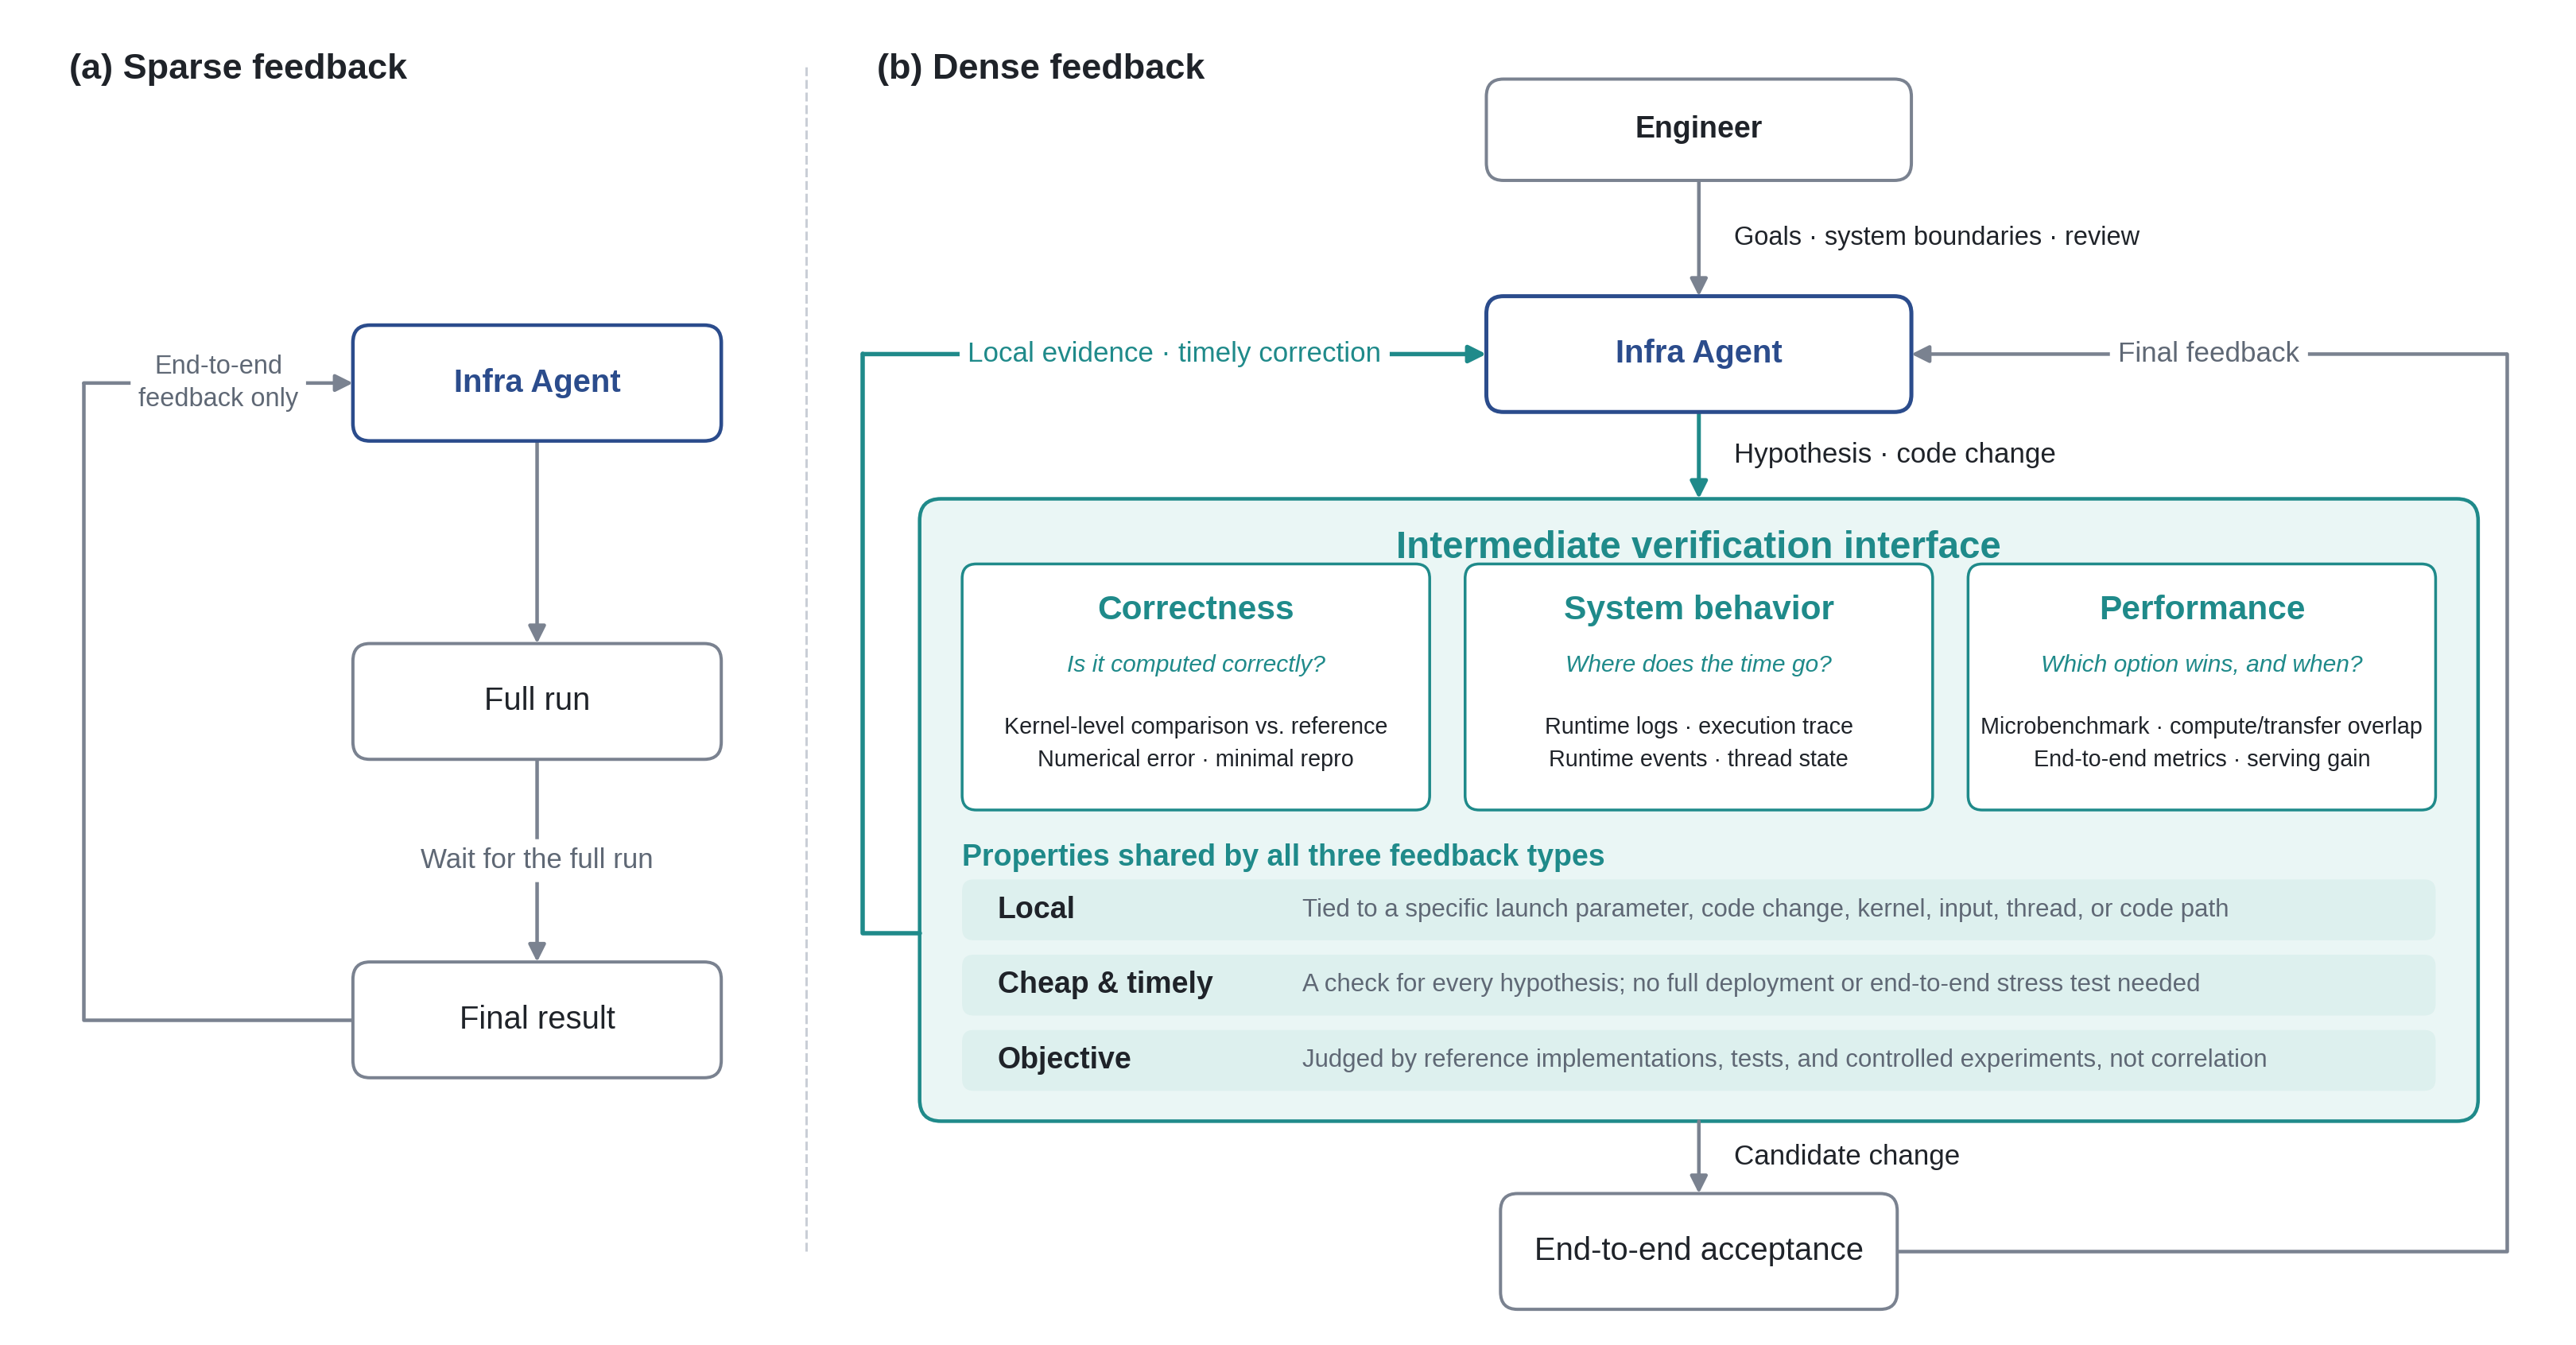
在智譜搭建的優化循環中,人類工程師的角色發生了劇烈的質變:
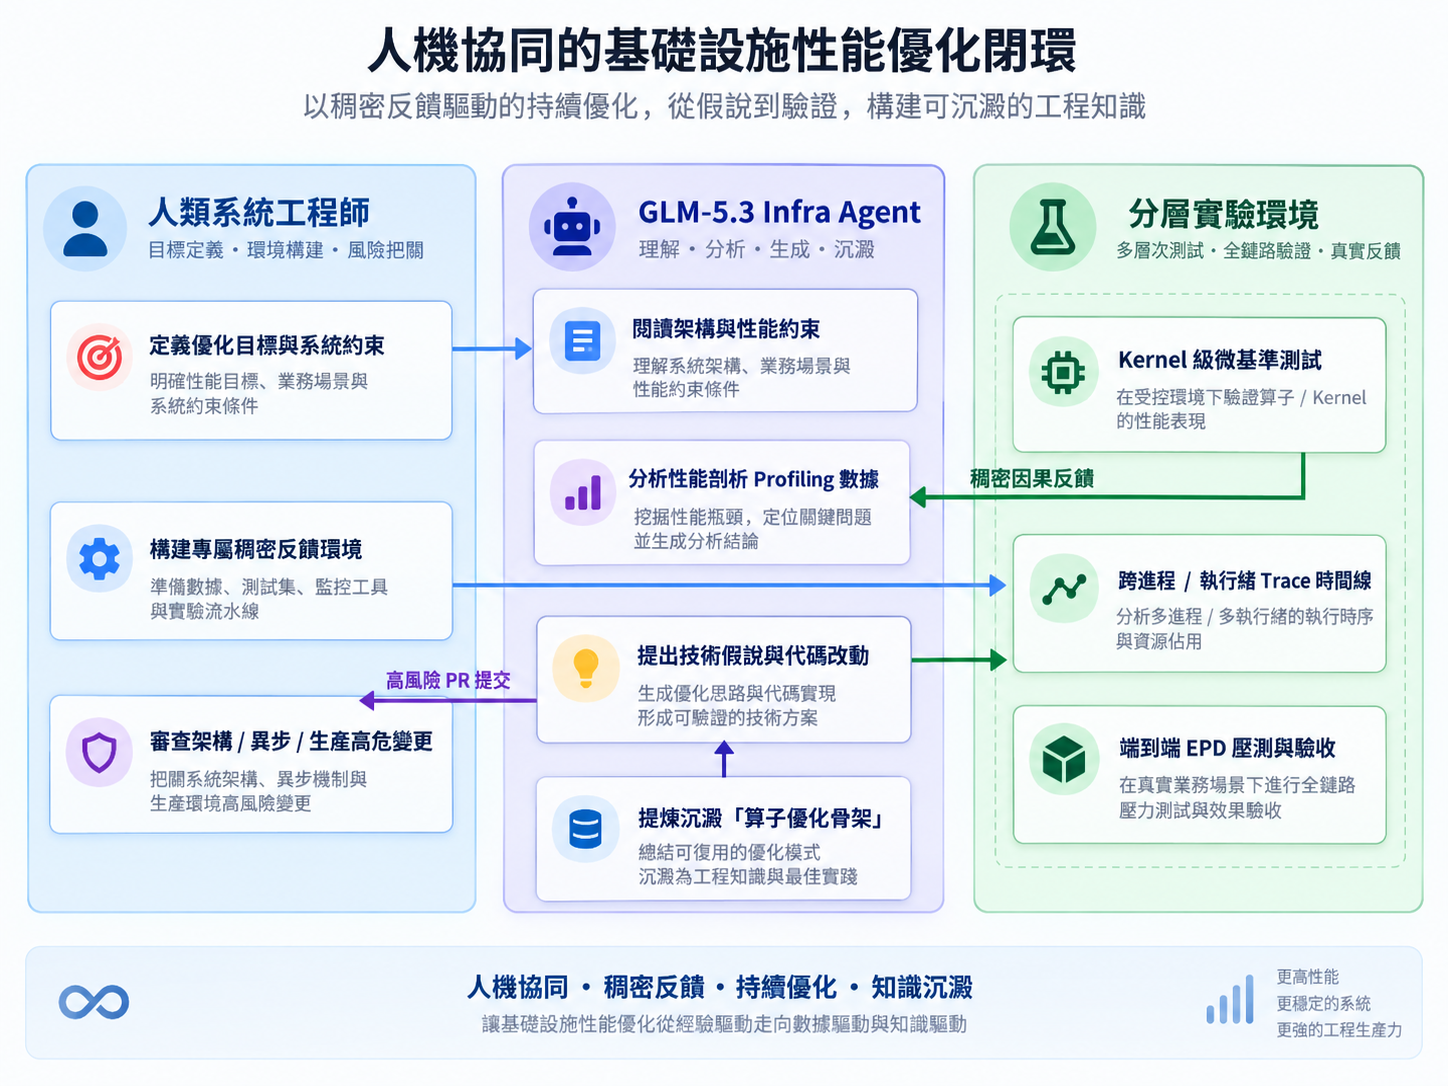
在這個體系中,原本高度依賴人類頂級架構師「直覺經驗」的診斷鏈條,被解構為一套可被 Infra Agent 連續自主執行的現代工程自動化工作流。
四、穿透 Python/C++ 邊界與底層算子:Infra Agent 三大硬核排錯實錄深度還原
為了證明這套體系絕非紙上談兵的宣傳話術,智譜在技術報告中罕見地公開了三個發生在 GLM-5.3-Flash 生產化過程中的真實底層硬核故障與排錯源代碼細節。
這三個案例分別代表了現代 AI 基礎設施中最令人頭痛的三大層次:GPU 算子數值精度漂移、跨語言/跨處理器併發鎖死、以及核心 Kernel 的微架構指令重構。
實錄 1:Context Parallelism 數值累積誤差案(GPU 算子層)
- 故障現象:在進行長上下文推論時,當系統開啟長序列上下文並行(Context Parallelism, CP)時,推論結果出現了不可忽視的精度漂移,導致輸出品質下降;但在單卡非並行模式下卻一切正常。
排錯過程:
如果只回報「模型精確度不符」,Agent 根本無法下手。 團隊為 Agent 建立了「分散式並行策略到底層 Kernel 實作的映射表」。Agent 將輸入數據沿著 CP 分片路徑與未分片路徑進行語義對齊比對,迅速將問題縮小至 KDA(Kernel Density Attention / 相關線性注意力算子)在跨分片合併狀態時的數學運算。
在 Context Parallelism 下,系統需要合併來自不同分片的上下文狀態,其核心 Triton/Python 虛擬碼如下:
# KDA 算子在不同上下文分片(Shards)之間的狀態傳遞與合併
M = tl.dot(M_chunk, M)     # 合併跨分片的狀態變換矩陣
S_next = tl.dot(M, S) + H  # 更新下一個分片的初始狀態
Infra Agent 在深入剖析底層代碼與硬體行為後發現: 雖然傳入的張量輸入均為標準的 FP32,但底層 Triton 呼叫的 tl.dot 為了追求運算極限,在預設情況下會悄悄降級採用 TF32(TensorFloat-32)精度進行硬體 Tensor Core 計算!
單次運算下 TF32 的精度損失極小,然而在 1M 上下文、數十萬步的狀態級聯更新與跨分片矩陣乘法連乘下,尾數精度的微小截斷引發了毀滅性的誤差指數級累積(Accumulated Error)!
解決方案:
Infra Agent 提出了解法:不退回到緩慢的純軟體模擬 FP32,而是顯式指定採用高階的 input_precision="tf32x3" 配置!
# Infra Agent 提出的修復代碼
# 透過組合 3 次 TF32 Tensor Core 運算來精確仿真 FP32 高精度矩陣乘法
M = tl.dot(M_chunk, M, input_precision="tf32x3")
S_next = tl.dot(M, S, input_precision="tf32x3") + H
這項改動利用三次 TF32 Tensor Core 的硬體乘加組合,在維持硬體極致加速特性的同時,徹底消除了長上下文連乘的精度崩潰。
更令人振奮的是,這項由 Infra Agent 探索出的數值精度修復方案,已經被智譜團隊正式貢獻回開源社區,合入知名開源庫 Flash Linear Attention 官方代碼中(官方 PR #1180)!
實錄 2:KV Transfer 併發懸崖案(跨語言與系統調度層)
- 故障現象:在 EPD 解耦架構中,工程團隊設定的效能約束為:「Prefill + KV Transfer(首字計算+狀態傳輸)與純 Prefill 基準相比,吞吐損耗不得超過 5%」。然而在實測中,部分高負載場景下的效能差距竟然暴跌超過 20%!
排錯過程:
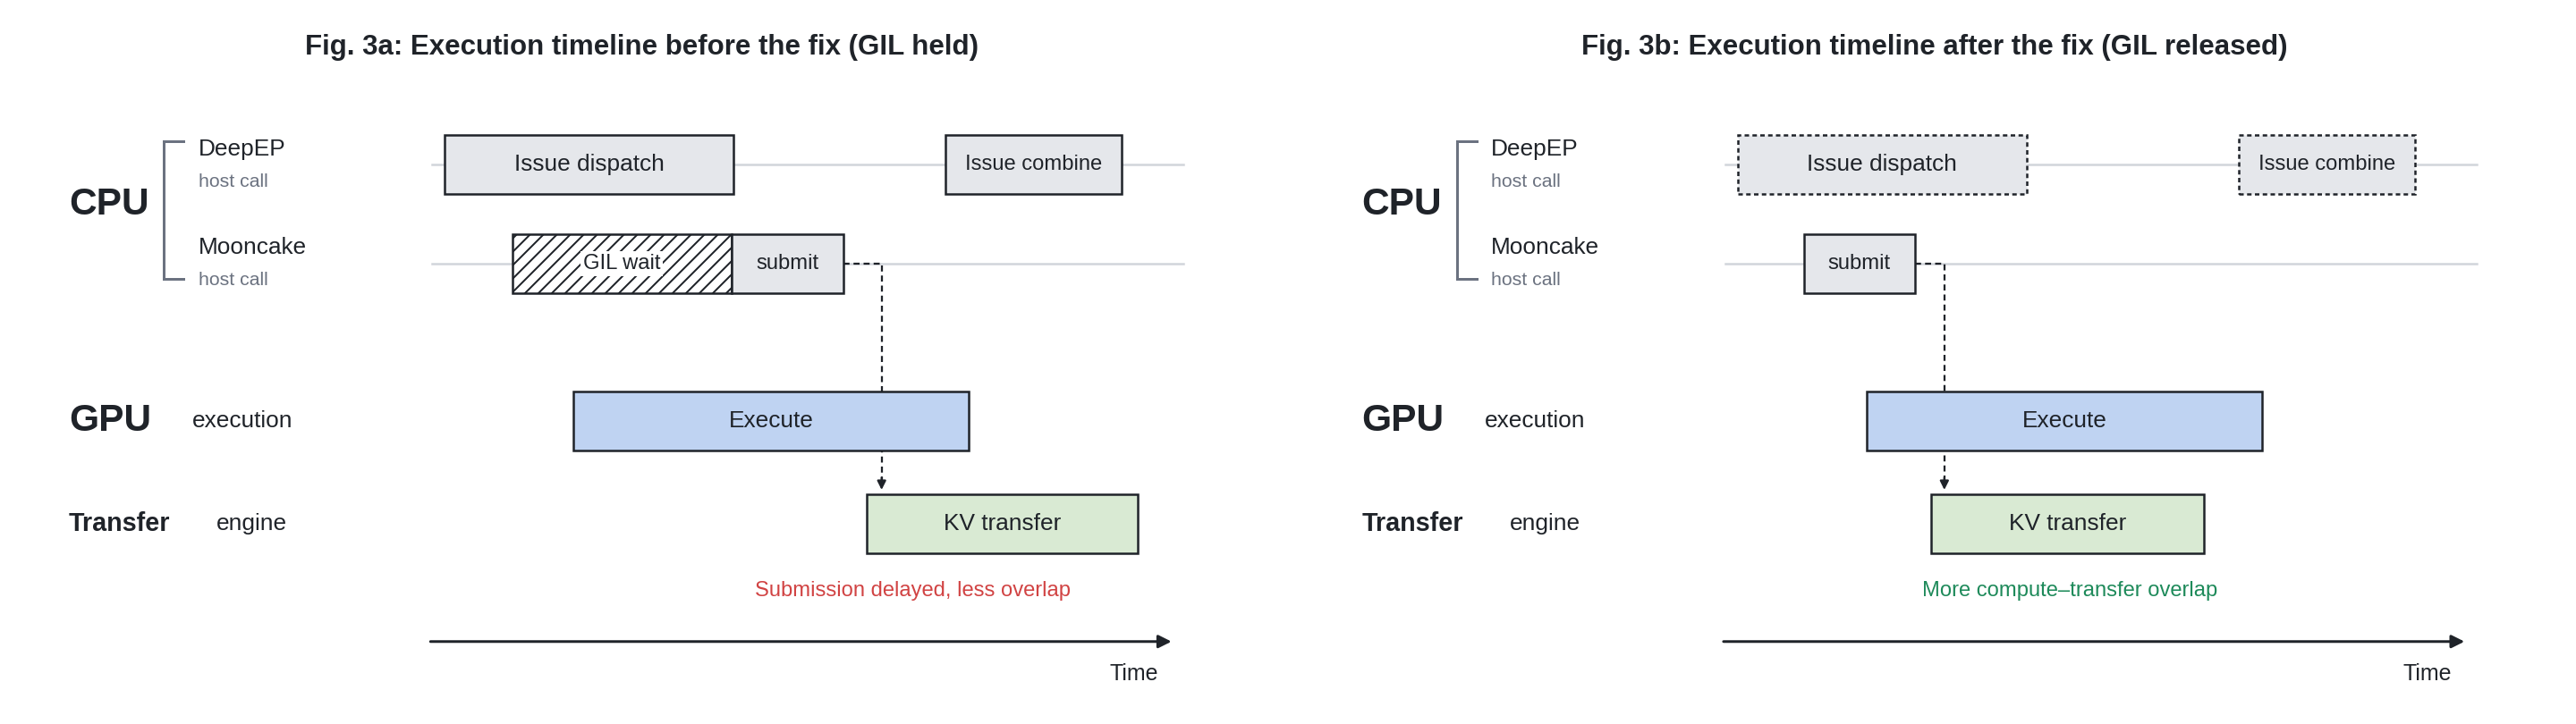
Agent 首先調取了系統層級的非同步 Trace 時間線(Execution Timeline)。在對比微觀時間戳時,Agent 抓出了一個極度反常的模式: 在 Python 側負責發起 KV Transfer 的傳輸排程,竟然「完全無法」與底層跨卡通訊庫 DeepEP 的 dispatch/combine 呼叫區間重疊(Overlap)!
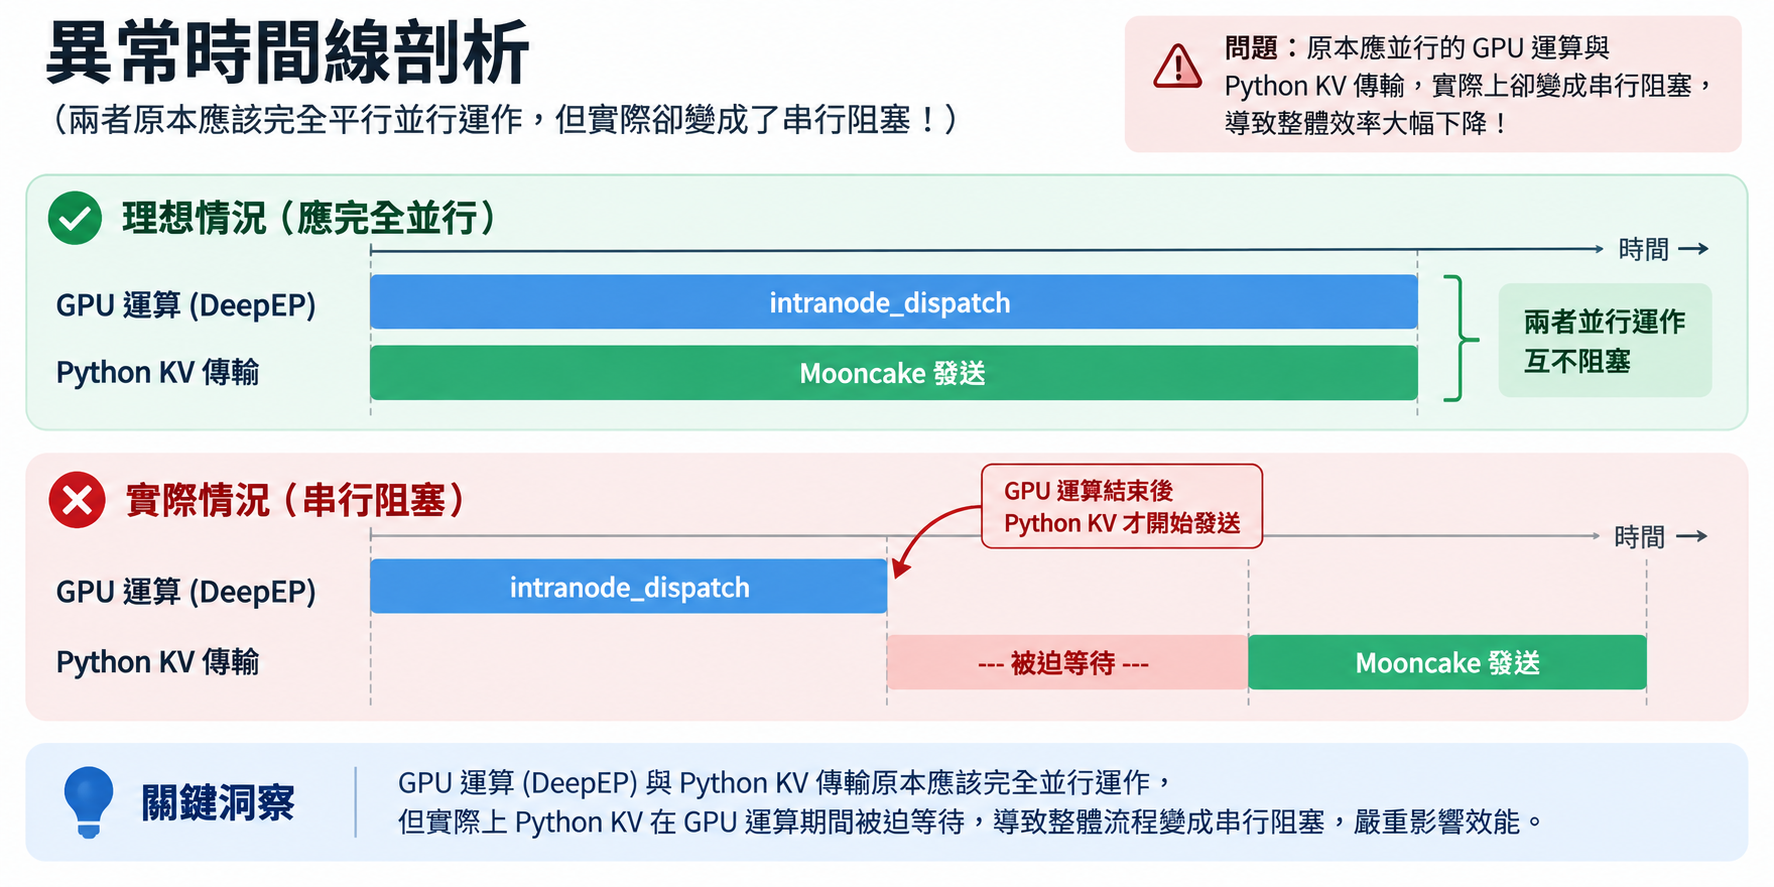
Agent 沿著呼叫鏈一路向下追蹤至 C++ 與 Python 的綁定邊界(Binding Layer)。 當時系統採用的是 DeepEP v1.2.1。Agent 在源碼審查時發現: 在 intranode_dispatch(節點內分發)與 intranode_combine 的 C++ 實作中,開發者忘記顯式釋放 Python 的全域直譯器鎖(GIL, Global Interpreter Lock)!
不僅如此,當 dispatch 需要獲取接收到的 Token 數量時,CPU 執行緒居然在持有 GIL 的狀態下,傻傻等待 GPU 將狀態寫回!
這導致了一個荒謬的連鎖死鎖效應:
- 儘管底層的 Mooncake 分散式傳輸庫完全支援非同步執行;
- 但因為前一個 C++ 函式霸佔了 Python GIL;
- 同一進程內負責調度 Mooncake Transfer 的 Python 執行緒被硬生生卡死;
- 原本應當被計算時間完美掩蓋(Hide Latency)的 KV 傳輸,全部被逼成了阻塞式等待!
最諷刺的細節是:Infra Agent 在比對 DeepEP 同版本的另一段源碼時發現,跨節點通訊函式 internode_dispatch 早就顯式呼叫了 py::gil_scoped_release,代碼註解甚至明明白白寫著「避免在 CPU 等待時阻塞其他執行緒的 KV Transfer」。顯然,人類工程師在撰寫節點內函式時遺漏了這行關鍵代碼。
解決方案:
Infra Agent 在節點內通訊的關鍵 C++ 區間內補上了 GIL 釋放邏輯:
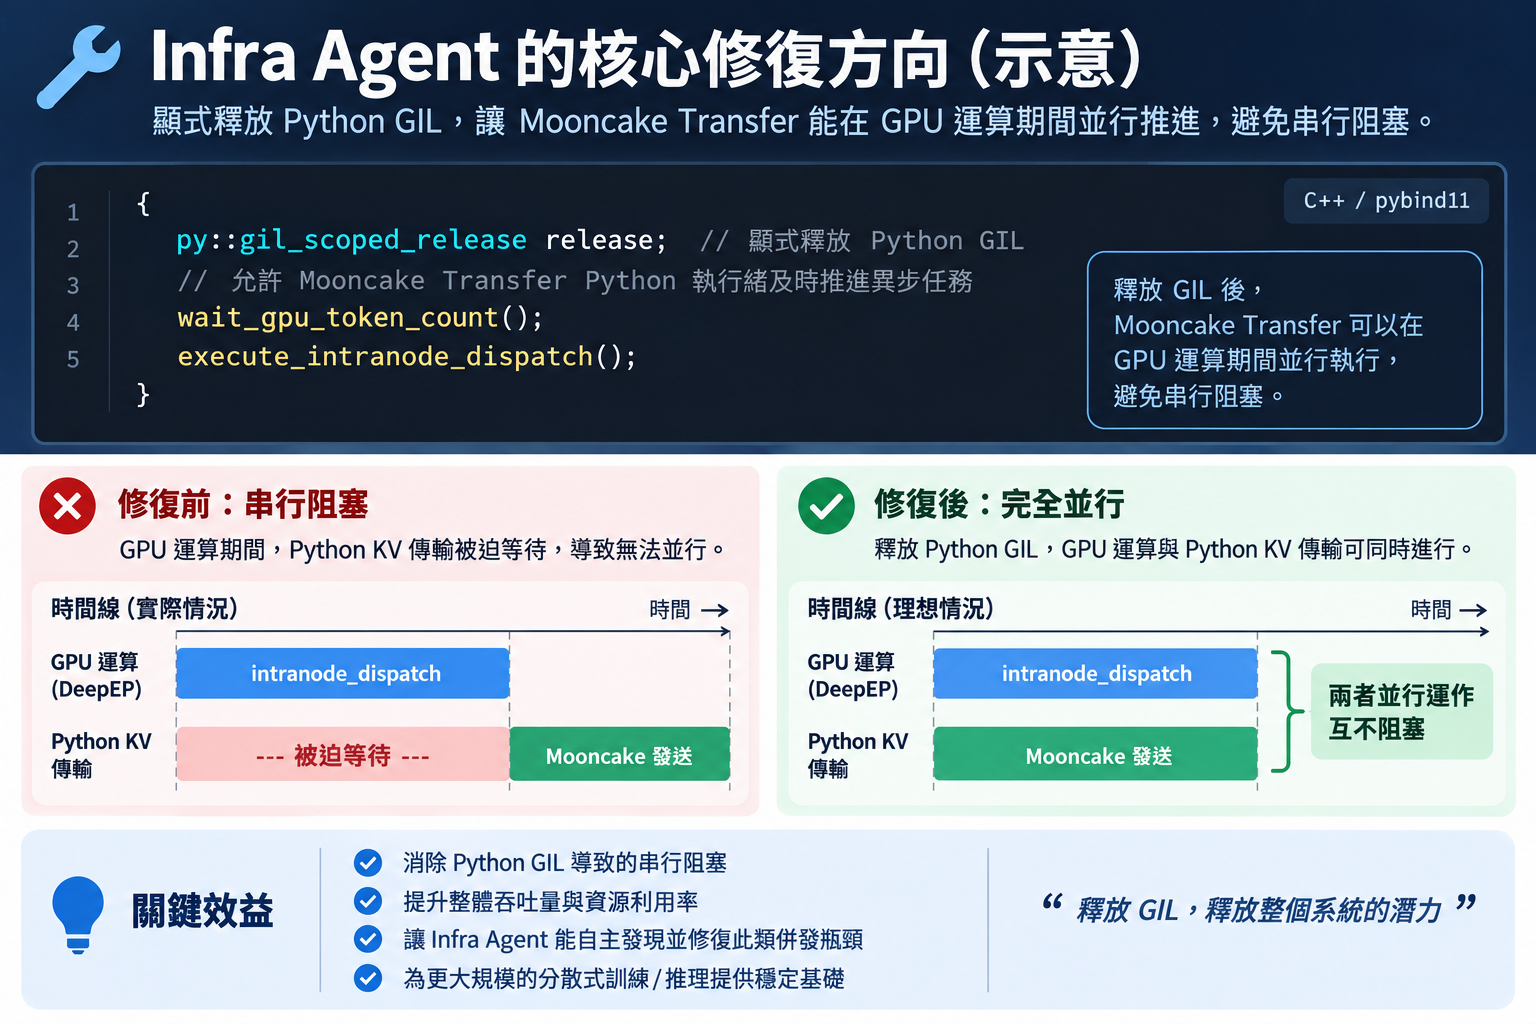
修復驗證立即生效:在修復後的時間線上,排程與傳輸立刻實現了完美的異步掩蓋。 在相同工作負載下,Prefill + KV 傳輸與純 Prefill 之間的效能差距從 20% 暴跌至 1% 未滿! 徹底消除了系統級瓶頸。
實錄 3:從開源汲取智慧——算子「優化骨架」與 KDA 1.71 倍加速(微架構優化層)
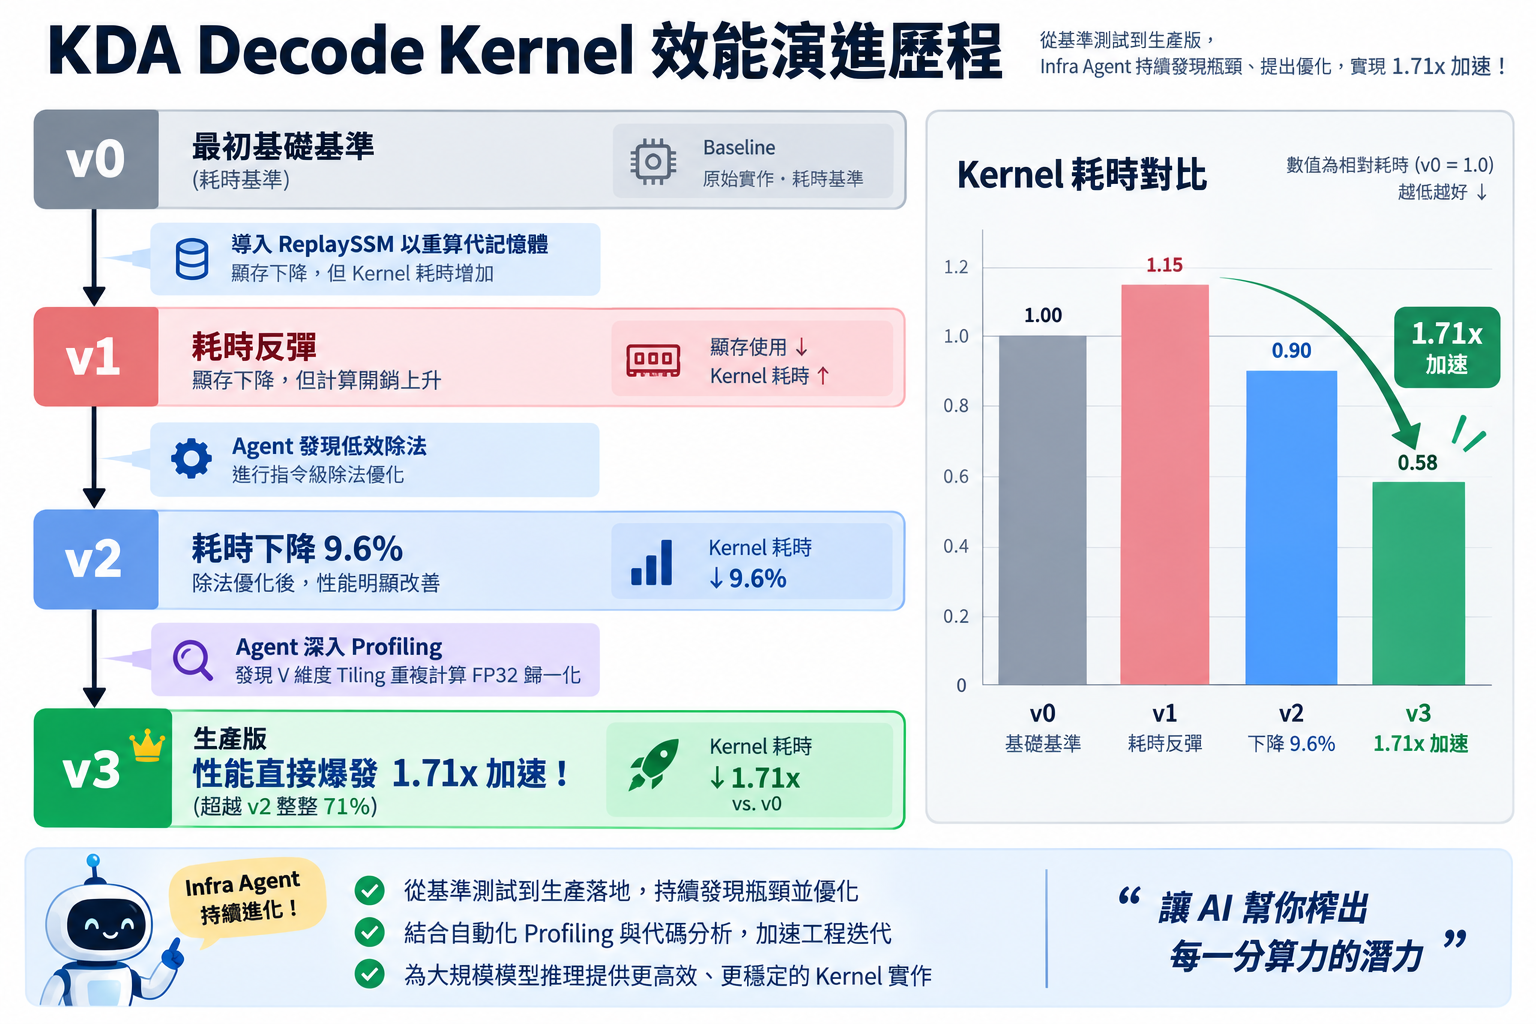
- 任務挑戰:在自研算力卡上,為了用算力換記憶體而引入 ReplaySSM 後,KDA Decode 算子的運算耗時顯著增加(從 v0 飆升到 v1)。如何將其壓榨至極限?
排錯過程:
面對全新的底層硬體,既沒有手冊也沒有成熟的最佳化範例。智譜讓 GLM-5.3 驅動的 Infra Agent 扮演「開源代碼考古學家」: Agent 閱讀了 SGLang、Flash Linear Attention、DeepGEMM 等業界頂尖專案中人類大師手寫的極限 Kernel,並透過消融實驗,將跨語言、跨架構的優化技巧主動提煉為一套**「優化骨架庫(Optimization Skeletons)」**——包含適用條件、轉換方法、顯存與暫存器約束以及驗證依據。
在優化 KDA Decode Kernel 時,Agent 展開了教科書般的四步自展重構:
關鍵破局:消滅 4 次重複的 FP32 歸一化
在 v2 階段,Profiling 工具顯示「純運算(Compute Bound)」成為最主要的瓶頸。 Infra Agent 深入微架構指令發現:原始實作為了提高並行度,選擇沿著 V 維度(Value Dimension) 進行分塊(Tiling)。
然而,這種分塊策略導致了一個隱形代價:同一個序列的 FP32 歸一化(Normalization)與門控計算(Gating Computation),在 4 個分塊中被硬生生重複執行了整整 4 次!
Infra Agent 做出了極為大膽的代碼重構:
- 合併 Thread Block:將這 4 個分散的分塊合併進單一 Thread Block 中;
- 暫存器常駐(Register-Resident):將計算過程中的共享中間變數牢牢鎖在 GPU 的暫存器檔案(Register File)中,避免反覆進出共享記憶體(SRAM)或 HBM;
- Warp-level Reduction:用單次硬體級的線程束規約(Warp Reduction)取代原本分散在各分塊中的重複計算。
Agent 選擇主動「犧牲部分表層並行度」,從根源上斬斷了大量冗餘的重複計算。 最終結果震撼全場:該 Kernel 的執行效率在 v2 的基礎上直接暴增 1.71 倍! 成功將 ReplaySSM 帶來的算力開銷全部追回,轉化為實質的生產吞吐。
更關鍵的是,這項實戰經驗立刻被 Infra Agent 寫回了「優化骨架庫」,成為叢集中下一個新 Kernel 優化時的現成先驗知識。
五、「模型優化系統,系統運行模型」:遞歸自我改進(RSI)的真實形態與人類防線
在整篇技術報告中,最觸動業界神經的,莫過於智譜團隊寫在字裡行間的世界觀劇變。
1. 從「義務試用」到「逐步取代我們」
長期以來,大模型實驗室的工程師往往有一種微妙的心態:雖然對外宣傳 AI 無所不能,但在內部編寫底層系統、手撕 CUDA 算子時,主力依然是頂尖人類黑客。
智譜極其坦率地寫下了這種轉變:
- 在 GLM-4.7 之前:工程師在內部使用 GLM 寫代碼還帶著一種「因為是自己研發的產品,所以有義務捧場」的無奈;那時的模型根本應付不了複雜的系統級工程。
- 到了 GLM-5.3 時代:它已經成為團隊每位工程師雷打不動的每日結對主力,「而且正在穩步走向取代我們」。
這段話之所以引發矽谷震撼,是因為它代表了一條被跨越的臨界線:大模型的工程智商,已經足以擊穿系統軟體底層最晦澀、最缺乏文檔的邊緣地帶。
2. 遞歸自我改進(RSI)的現實形態
在電腦科學理論中,馮·諾依曼(John von Neumann)與 I.J. Good 很早就提出了「智慧爆炸」與「遞歸自我改進(RSI)」的假說——即一個智慧體能夠自主修改自己的代碼,創造出更聰明的自己,從而引發指數級的進化飛躍。
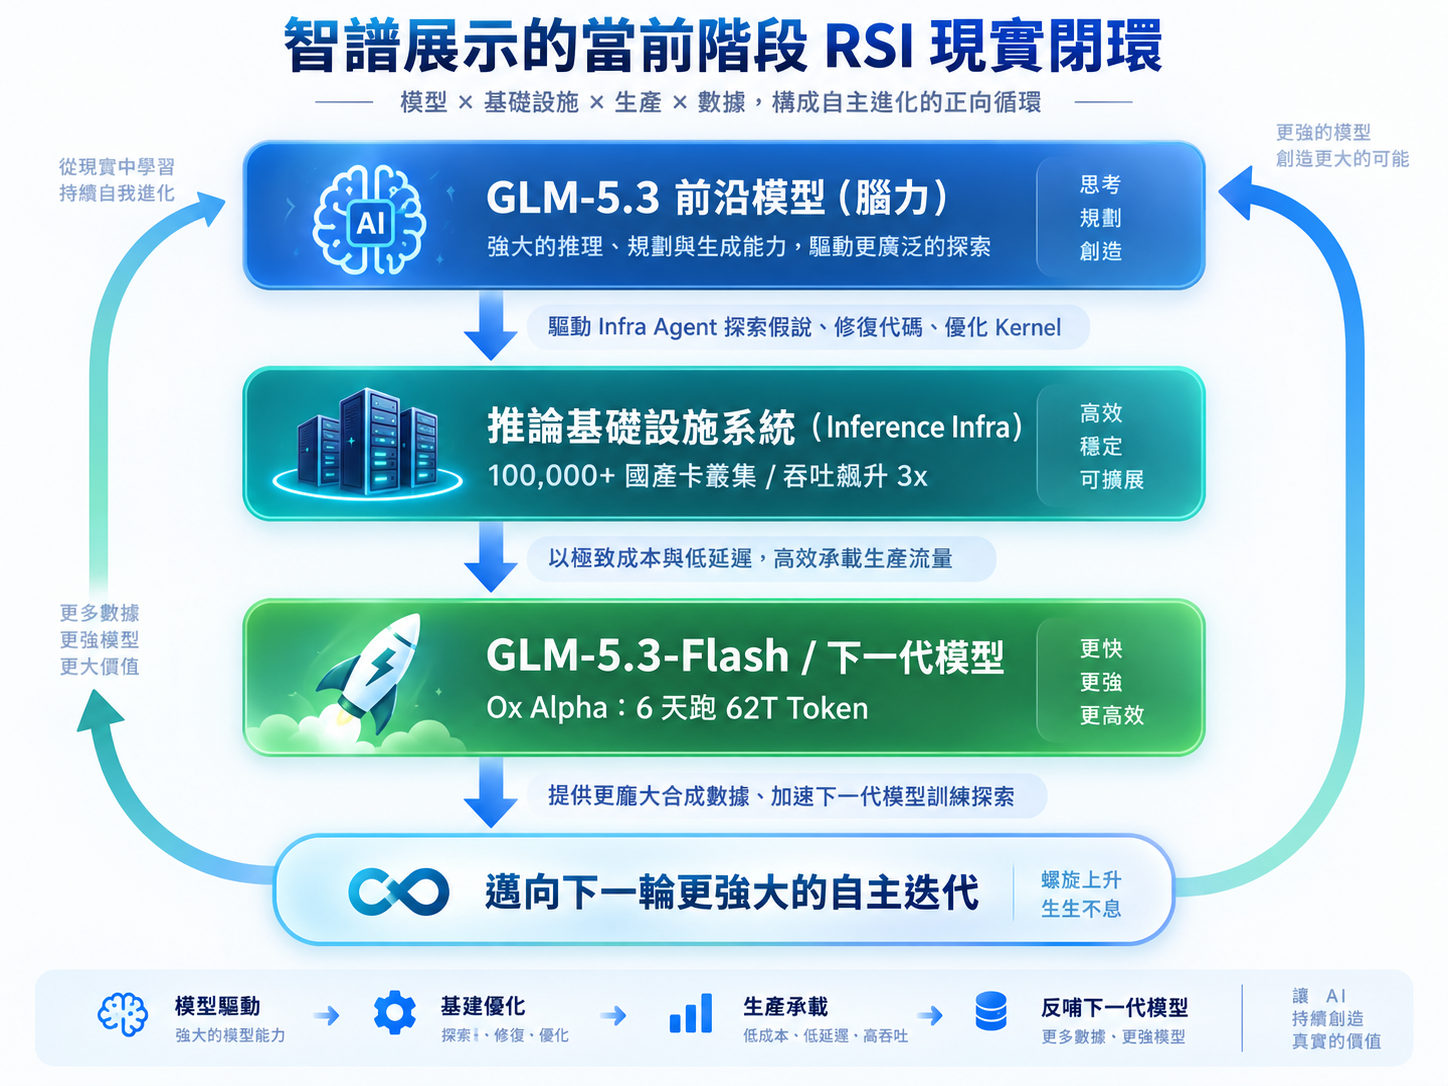
智譜展示的並非科幻電影中脫離人類控制的失控機器人,而是一個高度紮實的工程閉環: GLM-5.3 負責優化系統 ➔ 系統以 3 倍吞吐運行 GLM-5.3-Flash ➔ 更便宜的高性能推論回饋更多數據與實驗 ➔ 支撐下一代基礎模型的訓練。
正如智譜所總結的那句金句:「模型優化系統;系統運行模型(The model optimizes the system; the system runs the model)。」
3. 人類工程師的「最後防線」
這是否意味著人類系統工程師明天就要集體下崗?
智譜給予了極為冷靜的界定:我們距離完全全自動的 RSI 依然有一段路要走。 在當前的系統優化閉環中,人類工程師依然牢牢把守著不可替代的三大權力防線:
- 定義優化目標與系統邊界:決定「系統要優化 TTFT 還是整體吞吐?」「首字延遲的容忍極限是多少?」這些商業與架構目標依然由人類拍板;
- 搭建可直接使用的稠密反饋環境:設計微基準測試管線、封裝各層級的 Trace 工具,將真實世界物理硬體的狀態抽象為 Agent 能夠讀懂的信號;
- 高危生產變更審查:凡是牽涉到分散式全域架構變更、底層異步併發邏輯、以及可能導致整個叢集崩潰的重大 PR,必須經由人類資深架構師嚴格 Review。
然而,智譜在報告結尾留下的警示,足以讓所有人深思:
「我們相信人類應當在很長一段時間內繼續把守這道防線。
但那些數字——兩週時間、三倍吞吐量、十萬張晶片——都在清晰地告訴我們:
這道邊界上的推進速度,絕不會僅僅因為我們希望它放慢,就真的放慢腳步。」
六、全球大模型生態與工程範式的終極啟示
智譜這篇看似純技術的工程復盤,實際上對全球科技格局與軟體開發產業釋放了極其深遠的戰略信號:
1. 地緣算力封鎖下的「軟體超車」新路徑
長期以來,市場普遍擔憂在地緣科技管制的背景下,硬體晶片顯存與頻寬的物理差距將徹底鎖死非美 AI 陣營的發展空間。 然而智譜的十萬卡實踐證明了一條全新路徑:如果硬體短板無法立刻透過物理製程追平,那麼就透過「AI 自己編寫極限系統軟體」來彌補! 由大模型引導的重算架構(ReplaySSM)、混合快取量化、精確到指令級的 Kernel 算子重構與 GIL 釋放,硬生生在不成熟的國產生態中擠出了 3 倍效能,讓整體推論能效追平主流 NVIDIA 平台。這種「軟體與編譯器級別的自適應進化」,正在改寫全球算力競爭的底層邏輯。
2. 軟體工程「第三時代」的真正降臨
如果說第一時代是工程師逐行手寫代碼,第二時代是利用 Copilot 進行自動補全與函式生成;那麼智譜 Infra Agent 的落地則宣示了**「第三時代」的真正特徵——自主代理承接端到端工程循環。**
在未來的系統軟體開發中,人類工程師將不再需要浪費幾天時間去死磕 Profiler 抓執行緒鎖死,也不再需要手工計算暫存器與 Thread Block 的分塊幾何。未來的核心技能,將轉變為**「如何為 AI Agent 設計精準的局部反饋環境(Feedback Environments)」**。誰能把物理系統的行為更清晰、更低延遲地反饋給模型,誰就能以十倍速碾壓對手的迭代週期。
七、總結
回顧整場「Ox Alpha 破案記」與「十萬卡模型自造記」,我們看見了當代 AI 發展的一體兩面:
一方面,社群在 OpenRouter 上見證了開源與前沿模型在真實代碼世界的狂暴潛能;另一方面,機房底層正在發生一場無聲的工業革命——AI 開始為自己的存在修橋鋪路。
從 2026 年 8 月 Ox Alpha 匿蹤席捲全球 62 兆 Token,到 9 月智譜正式向全世界揭開這座由 AI 自己雕琢的算力堡壘,這項里程碑告訴我們:遞歸自我改進不再是哲學家的思辨,它已經沉澱為一行行被合入 upstream 的 PR 代碼。
當模型開始優化系統,當系統全速運行模型,軟體工程的規則已經徹底改變。未來的頂級工程師,不再是那個寫出最精妙 CUDA 算子的人,而是那個懂得如何駕馭 Agent、為智慧自展演化劃定正確軌道的人。