Anthropic 揭開前沿實驗室黑盒子!公布三大指標測量 AI 研發速度:Claude 已主導 26% 研發任務、3 萬名內部 Agent 與算力分配全公開深度解析
Anthropic 官方揭開前沿實驗室黑盒子!首創三大可驗證量測體系:Claude 已主導 26% 研發任務、3 萬名內部 Agent 月審十億次決策,且安全算力僅佔 6%。深度拆解背後工程架構與嵌入式外部評估機制。
先講結論:當「放慢 AI」遇上質疑,Anthropic 選擇直接掀開底牌
就在 2026 年 9 月中旬舊金山 Dreamforce 盛會上,Anthropic 執行長 Dario Amodei 與輝達(NVIDIA)執行長黃仁勳爆發了一場關乎人類文明速度的「世紀大論戰」——黃仁勳高呼「放手狂奔,失控才個別暫停」,痛批道德降速是虛假的二選一;而外界與華爾街最犀利的質疑始終只有一個:「如果前沿實驗室的內部研發是個無人能見的黑盒子,公眾憑什麼相信誰跑得太快?又該依據什麼來設定剎車步調?」
兩天之後,Anthropic Institute 於 9 月 18 日正式擲出震撼彈,發布題為〈Measurements for understanding the pace of AI development inside frontier labs〉(前沿實驗室內部 AI 研發步調量測體系)的里程碑研究。
這份由 Marina Favaro 與 Phillie Wright 主筆、政策研究總監 Jack Clark 指導的報告,徹底跳脫了過往「只看跑分(MMLU、SWE-bench 等能力評估)」的傳統視角,首次將手術刀對準前沿 AI 的「生產過程(Production Process)」。
在這份報告中,Anthropic 毫不保留地公布了其內部最高機密的研發體檢數據:
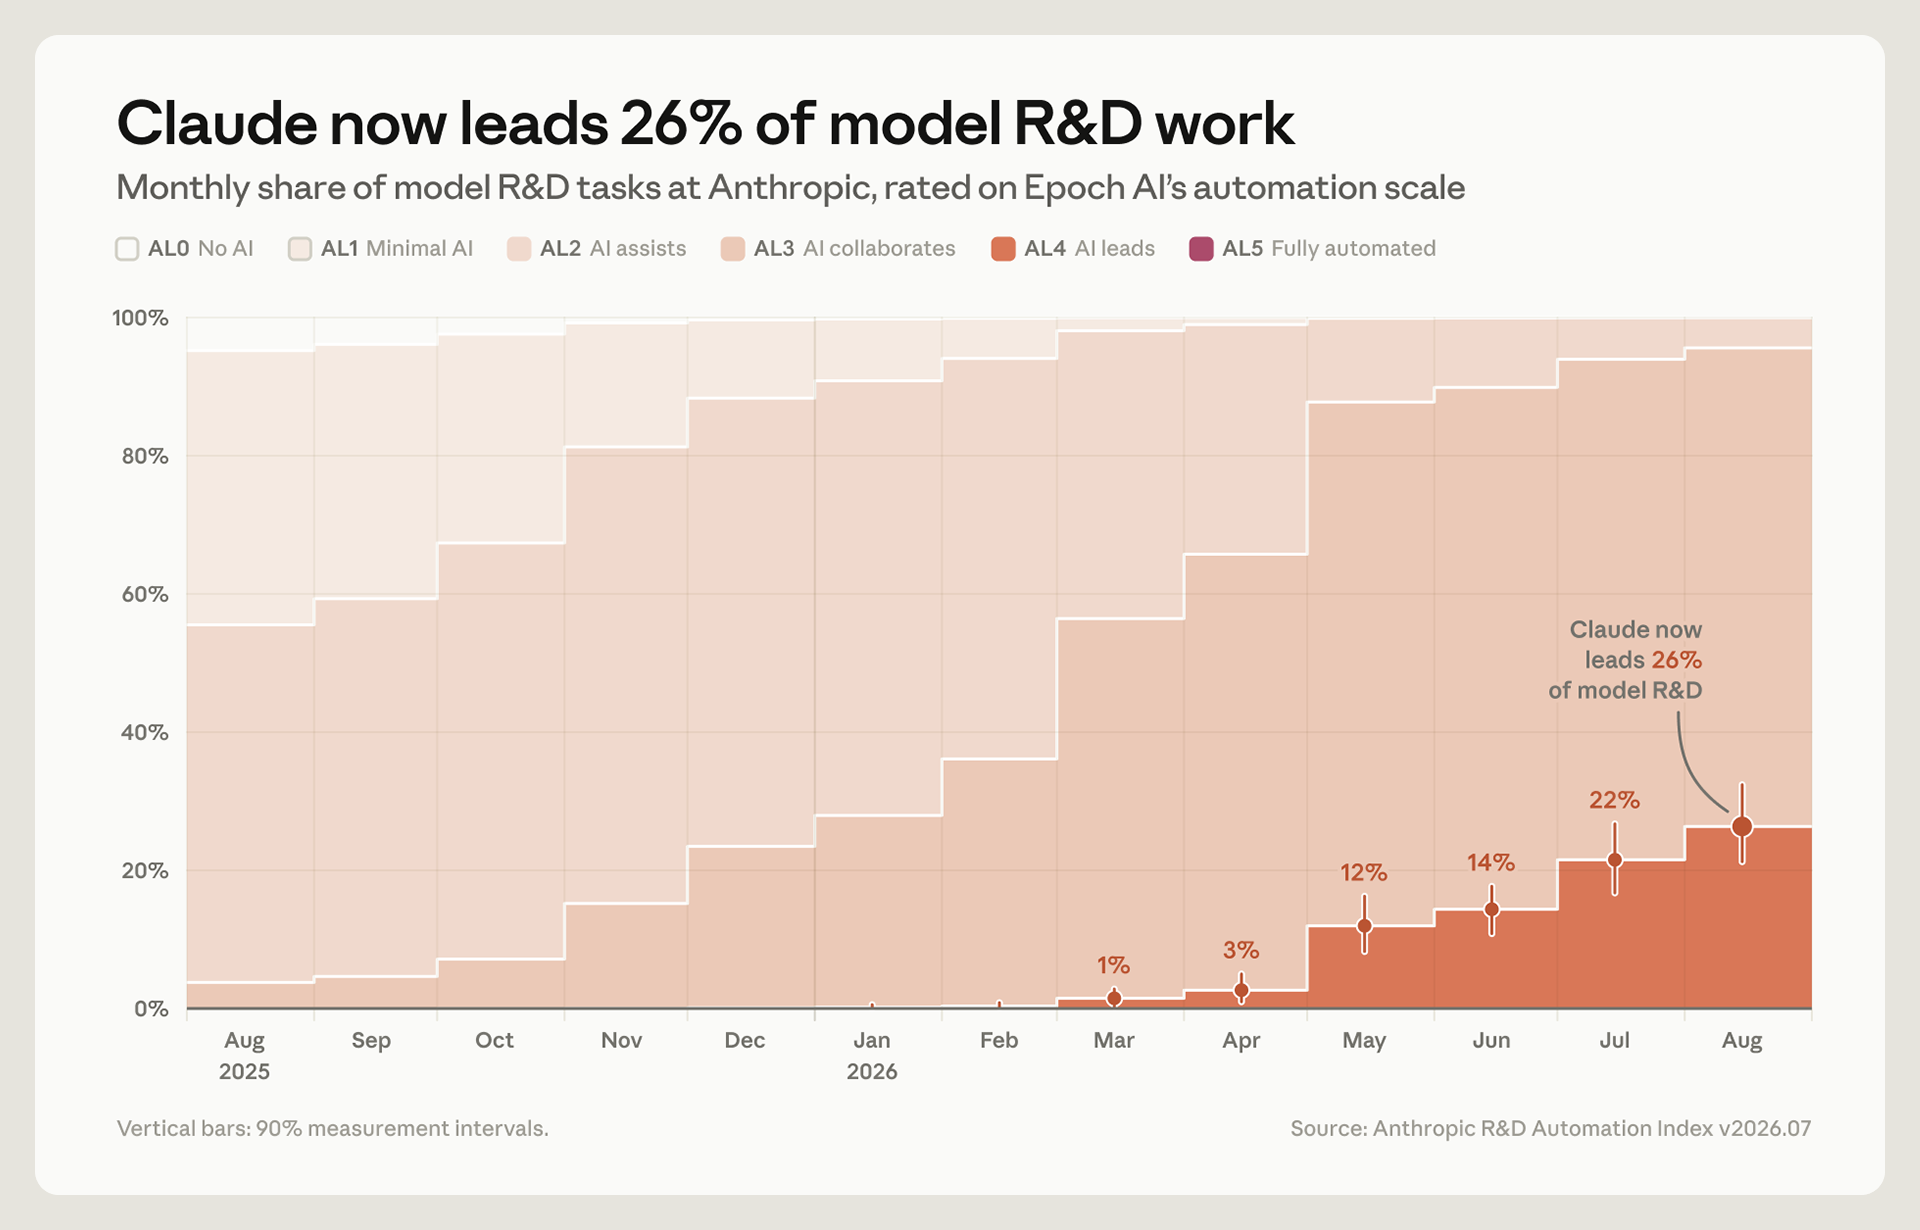
- AI 正在高速接管 AI 研發:截至 2026 年 8 月,Claude 已經在 Anthropic 內部「主導(Leads)」了 26% 的模型研發任務,相較於半年前(2026 年 2 月)的不到 1%,暴增超過 26 倍;若包含「人機深度協同(Collaborates)」,比例更已突破 90%!
- 三萬名並行 Agent 艦隊的監管實測:Anthropic 內部主要平台上,隨時有約 30,000 名 AI Agent 並行進行工程與科研工作;僅 8 月單月就分析了超過 10 億次決策。透過「線上即時攔截(阻斷率 0.002%)」與「離線事後稽核(每週標記 10 萬份對話紀錄)」的雙層防線,防範權重外洩與潛在對齊偏離。
- 殘酷的算力分配真相:在全公司近萬次運算任務中,直接投入「安全與對齊研發」的算力佔比僅有 6%(在純 AI 驅動研發中佔 12%),直指整個產業仍將絕大部分算力押注於「堆疊模型能力」的現實。
- 引入「嵌入式第三方評估員」:Anthropic 承諾將向獨立評估機構(如 METR)發放正式員工識別證與公司設備,賦予同等內部權限,讓外部獨立專家長期駐點查驗數據。
這不僅是一份公關透明度宣示,更是全球 AI 治理從「空泛口號」邁向「工程化可審計標準」的關鍵轉折點。
為什麼評測不能只看排行榜?從「能力評估」走向「生產過程監控」
過去幾年,公眾理解 AI 進展的唯一窗口是「能力基準測試(Capability Evaluations)」。每當新模型問世,各大實驗室便爭相發布 MMLU、GPQA、SWE-bench 或 Codeforces 的排名與得分。
但 Anthropic 在報告中指出,能力評估只能告訴你「模型現在能做什麼」,卻完全無法告訴你「下一代模型正在以多快的速度被孕育」。
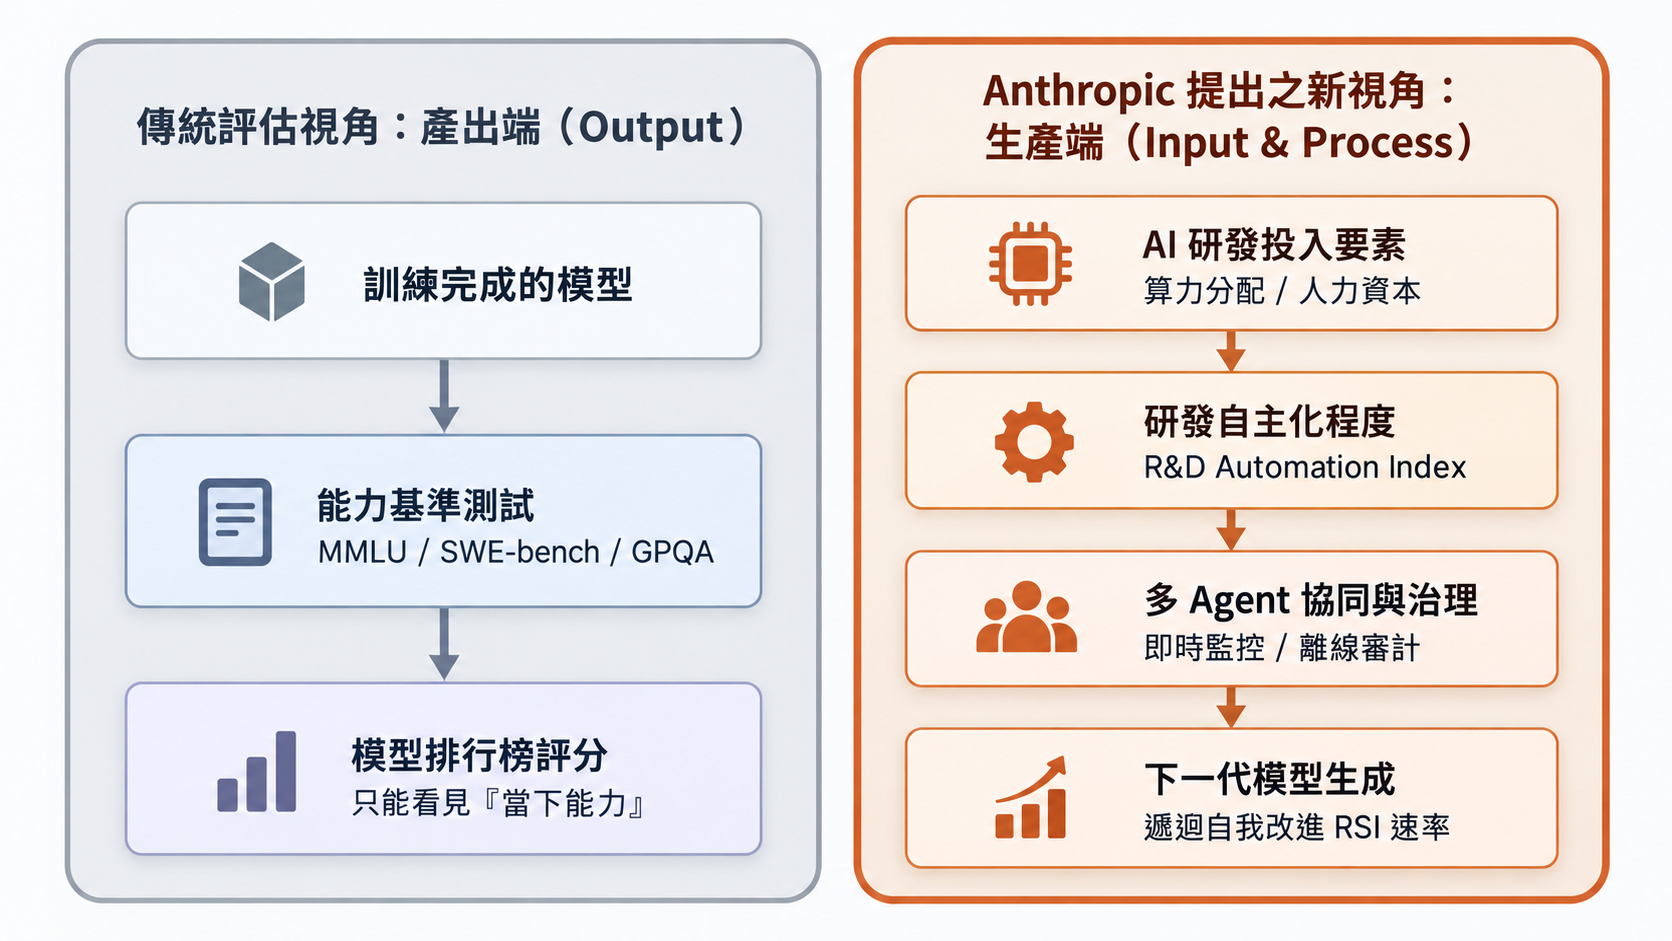
這種資訊不對稱在「遞迴自我改進(Recursive Self-Improvement, RSI)」初露端倪的今天變得極度危險:
- 如果 AI 只是被人類拿來寫程式,研發速度受限於人類工程師的生理極限與溝通成本;
- 但如果 AI 開始自主排查架構缺陷、優化強化學習策略、甚至撰寫新模型的訓練管線,能力躍升的曲線將呈現爆炸性的超指數增長。
因此,社會若要評估前沿風險,不能等到超級模型已經訓練完成、走出實驗室才被動應對,而必須在前沿實驗室的「工廠流水線」上安裝感測器。
指標一:AI 主導的 AI 研發(The R&D Automation Index)
1. 衡量標準:Epoch AI 的 AL0 至 AL5 標尺
為了科學評估 AI 在自身研發中究竟介入了多少,Anthropic 採用了知名研究機構 Epoch AI 所制定的「自動化等級(Automation Level, AL)」框架:
| 自動化等級(AL) | 定義名稱 | 具體運作模式 | 實務案例(以資料管線故障修復為例) |
|---|---|---|---|
| AL0 | 無 AI 介入(No AI) | 全程由人類工程師手動執行,不使用任何 AI 工具。 | 工程師手動查閱 Log、排查 Bug 並寫修復腳本。 |
| AL1 | 極少介入(Minimal) | AI 僅用於輔助輸入、簡單語法補全。 | 編輯器自動補全程式碼括號或語法。 |
| AL2 | AI 輔助(Assists) | AI 處理瑣碎零星片段,人類主導思維架構。 | 工程師請 AI 解釋某段報錯訊息的表面含義。 |
| AL3 | AI 協同(Collaborates) | AI 在人類密切指示下承擔大塊工作,遇到意外需人類即時排除。 | 人類提供報錯紀錄與假設,Claude 調查並撰寫修復程式碼;若發現新問題,Claude 暫停等待指示,修復後由人類逐行檢視測試。 |
| AL4 | AI 主導(Leads) | 人類僅下達高層次目標(High-level prompt),AI 端到端自主完成大部分探索、實作與驗證,人類僅做最終檢視。 | 工程師丟出「修復資料管線」警報,Claude 自主查 Log、定位損壞節點、編寫與測試修補、在沙盒重跑副本驗證,最後提交修復報告與 PR 給工程師按核准。 |
| AL5 | 完全自主(Autonomous) | AI 無需人類介入(No human in the loop),自主巡檢、決策、修復並直接部署上線。 | Claude 自主監控全天候叢集,在工程師不知情下自行發現缺陷、修正程式、通過測試並發布至正式生產環境。 |
2. 震撼數據:半年內從 1% 到 26% 的躍遷
Anthropic 揭露的 2026 年 8 月最新數據顯示出驚人的進展:
- AL5(完全自主):0%。目前在任何模型研發子領域中,Claude 均未被允許、也尚未達到完全無人介入的閉環自主。
- AL4(AI 主導):26%!在短短半年內(2026 年 2 月至 8 月),Claude 從人類「跟班」躍升為能自主領銜完成四分之一研發任務的「專案負責人」。
- AL3+(AI 協同或以上):超過 90%!這意味著在 Anthropic,純靠人類大腦、不用 AI 的純手工 AI 研發時代已經徹底終結。
[Anthropic 內部模型研發任務自動化等級分佈 (2026年8月)]
■ AL4 (AI 主導): 26%  (2026年2月僅 <1%)
■ AL3 (AI 協同): ~65%
■ AL0-AL2 (輔助或以下): <10%
■ AL5 (完全自主): 0%
3. 底層工程:如何繪製一張 15,000 項任務的「研發全景樹」?
許多人好奇:一間千人規模的前沿 AI 公司,每天進行的研發包羅萬象,如何能精準計算出「26%」這個數字?這背後是一套嚴謹的自下而上(Bottom-up)任務挖掘工程:
- 真實場景抽樣:在 2026 年 7 月期間,每週隨機抽樣 20% 參與模型研發循環(Model R&D Loop)的跨部門員工。
- 語意溯源採集:派出專門的 Claude 研究 Agent,合法合規地檢索受訪員工當週在 Slack、Git 提交紀錄、內部文件與實驗日誌中的軌跡,還原出約 15,000 項極具粒度的研發具體任務。
- 構建層級分類樹(Hierarchical Task Tree):將這上萬項任務自頂向下聚類,從頂層的「模型研發」,向下細分為「預訓練」、「強化學習(RL)」、「基礎設施」、「產品服務」,最終延伸出 542 個節點與 378 個具體葉節點(Leaves)(如:評測平台故障排查與修復、RL 沙盒網路出口政策配置、推論事故檢討等)。隨後,Anthropic 「凍結(Freeze)」了這張任務樹,作為日後持續比對的標準籃子。
- Agent 深入調研與獨立裁判(Judge Model):針對任務樹中的每個節點,由 Claude Agent 調查內部誰在做、使用何種工具、AI 貢獻比例,再由另一款獨立的 Claude Judge 模型對照 Epoch AI 標尺打分。
- 工時加權(Person-Time Weighting):為了避免瑣碎小任務扭曲統計,每個節點的權重直接與投入的人力工時(人週)掛鉤,研發核心項目的權重顯著高於邊緣任務。
驗證亮點:AI 裁判比人類彼此更客觀?
Anthropic 特別讓相關業務負責人進行盲測打分。結果令人震驚:Claude 裁判模型與人類主管的判定一致率為 59%,而兩位人類專家之間的彼此一致率僅有 35%! 同時,在「正負一個等級差」之內,模型與人類的判定吻合度高達 97%。這證明藉由客觀定義,LLM 完全足以勝任研發流程審計的標準化裁判。
指標二:AI 代理人的監管與干預(Oversight of AI Agents)
1. 萬級 Agent 叢集的真實日常:月審十億次決策
隨著工作從 AL3 邁向 AL4,工程師不再是把 Agent 當作自動補全工具,而是派遣 Agent 獨立執行可能長達數小時、甚至數天的自主任務,Agent 甚至會自主分解子任務並調用數十個 Subagents。
在 Anthropic 內部,隨時都有約 30,000 名 AI Agent 活躍在研發環境中。僅在 2026 年 8 月單月,監控系統就記錄並分析了超過 10 億次 Agent 行動決策!
在如此龐大的運作體量下,傳統的「人類即時盯著螢幕(Human-in-the-loop)」已完全不切實際;但若放任自由,即使只有 0.001% 的異常行為,在數十億次規模下也會累積成數千起資安與安全事故。
2. 雙層防禦體系:線上阻斷 vs. 離線審計
為此,Anthropic 實戰部署了「線上即時攔截」與「離線事後稽核」的雙層監控漏斗:
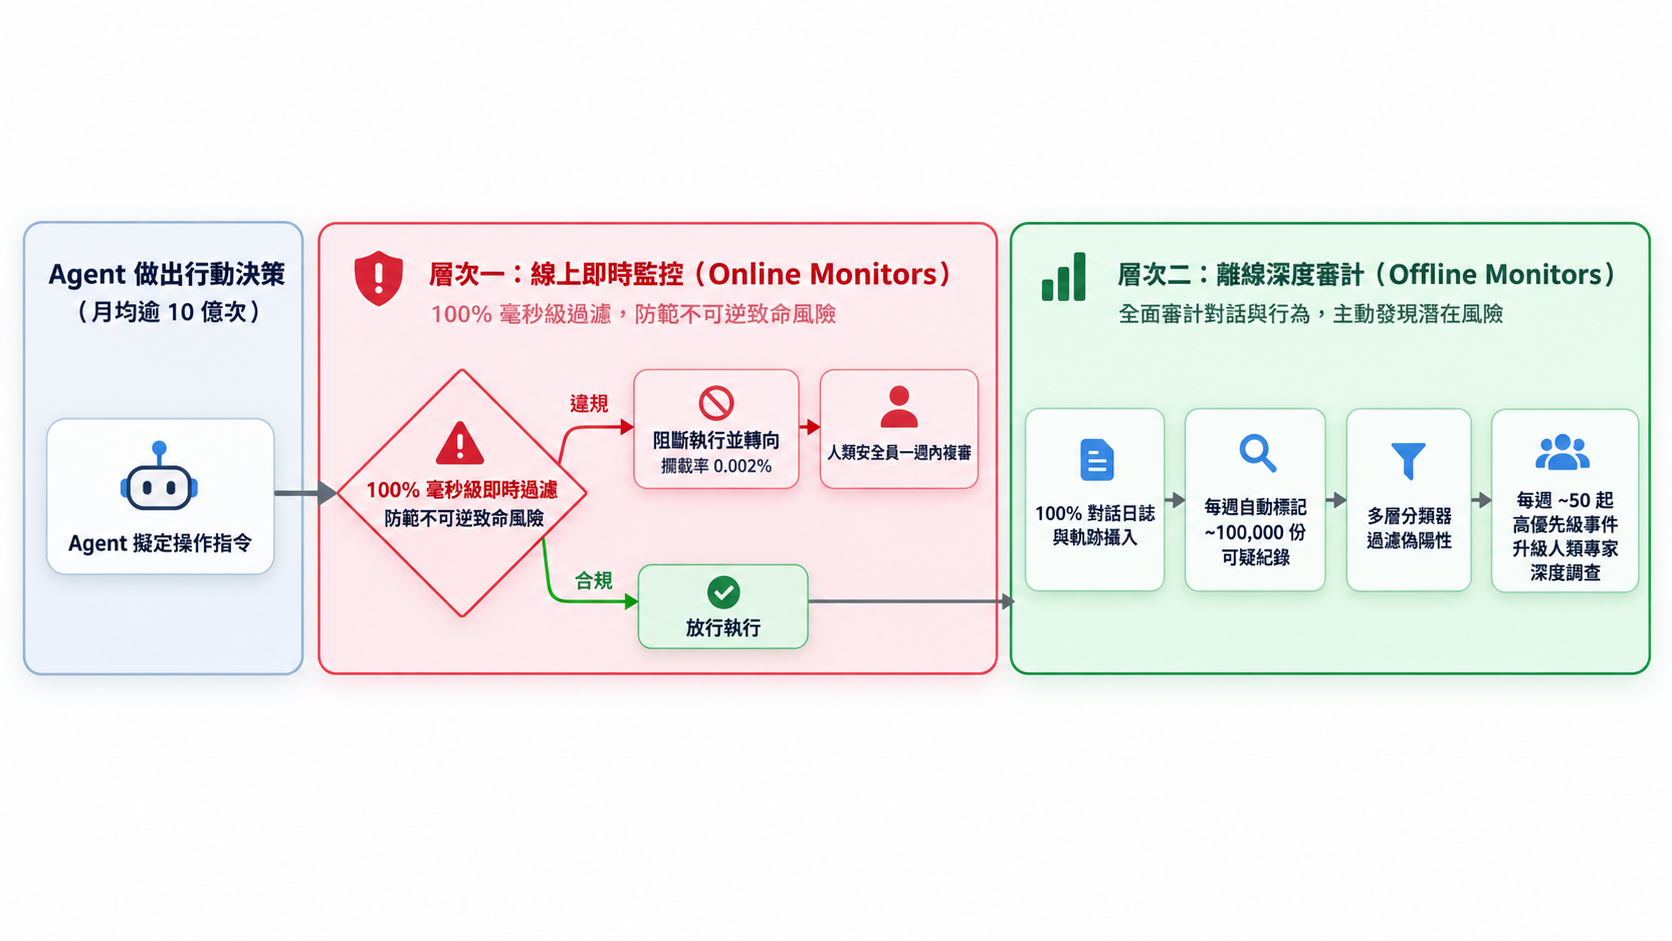
雙層監管機制對比表
| 評估維度 | 線上即時監控(Online Monitors) | 離線深度審計(Offline Monitors) |
|---|---|---|
| 核心防護目標 | 不可逆的急性危害(如:嘗試外洩模型權重、企圖突破網路沙盒隔離、未授權外聯)。 | 緩慢滋生的慢性危害(如:隱晦的對齊漂移、獎勵駭入 Reward Hacking、潛伏欺騙行為)。 |
| 監控覆蓋率(Coverage) | 100%:所有操作在實際落盤執行前,必須在數秒內通過線上分類器檢查。 | 100%:所有 Agent 的完整對話軌跡(Transcripts)全數攝入後台分析引擎。 |
| 審查延遲(Latency) | 機器審核延遲僅數秒;被攔截的事件在 1 週內由內部安全團隊完成人工複審。 | 每週攝入分析;經多道專門分類器過濾後,將約 50 起最高優先級個案提報人類調查。 |
| 攔截 / 升級率 | 0.002%(約每 47,000 次操作攔截 1 次)。在十億次決策中展現極高精準度。 | 每週自動初篩約 10 萬份紀錄(標記率約 0.1% - 0.2%),最終升級至人工深度調查約 50 起。 |
3. 鷹架工程啟示:多 Agent 系統如何不陷入「群體幻覺」?
在多 Agent 協同系統的設計架構上,Anthropic 提煉出了兩條對於全球開發者極具借鑑價值的工程原則:
- 獨立持久身分(Persistent Identity):
- 過去的誤區是讓所有 Agent 共用一個「Claude」大腦。Anthropic 堅持為每個內部 Agent 分配獨立的唯一身分 ID,所有日誌與產出產物永久綁定該身分。
- 破解「群體盲從(Correlated Failures)」:當 Agent A 收到 Agent B 的訊息時,它會將其視為「外部來源的主張(External Claim)」進行驗證與批判,而非當作「自己的思維」全盤接受。
- 身分與底層模型解耦,即使底層模型從 Sonnet 升級至 Opus,該 Agent 的權責紀錄與行為輪廓依舊延續。
- 公開透明通訊匯流排(Open Communication Bus):
- 嚴禁 Agent 之間建立端到端的私密通訊(No Private DMs)。
- 所有協同訊息均發布在全域可見的公共匯流排上,並強制作出原始碼或資料連結引用。這不僅徹底消滅了 Agent 互相傳話導致幻覺不斷放大的「傳話遊戲(Telephone Game)」,更讓監控引擎能完整還原 Agent 之間的因果推論鏈。
指標三:算力分配透明化(Compute Allocation)
1. 為什麼「算力」是國際協調與管制的唯一硬通貨?
軟體程式碼可以被混淆,內部政策可以被粉飾,但晶片(Accelerators)的實體消耗騙不了人。算力是目前 AI 研發中物理特徵最強、最具可審計性的「實體投入(Verifiable Input)」。
如果未來前沿大廠或聯合國要簽署類似「核不擴散條約」的 AI 步調協議,唯一的監管抓手就是各大實驗室如何分配其龐大的 GPU/TPU 算力池。
2. 快照揭密:安全算力佔比 6% 的殘酷與真實
Anthropic 檢視了 2026 年 7 月 13 日至 20 日單週內、全公司近 10,000 次運算作業(按算力消耗進行加權抽樣 14%),並利用嚴格的 Prompt 分類器對任務進行歸類:
- 安全算力佔比:
- 佔全公司 AI 研發總算力(AI R&D Compute)的 6%。
- 佔全公司 「AI 主導之研發」算力的 12%。
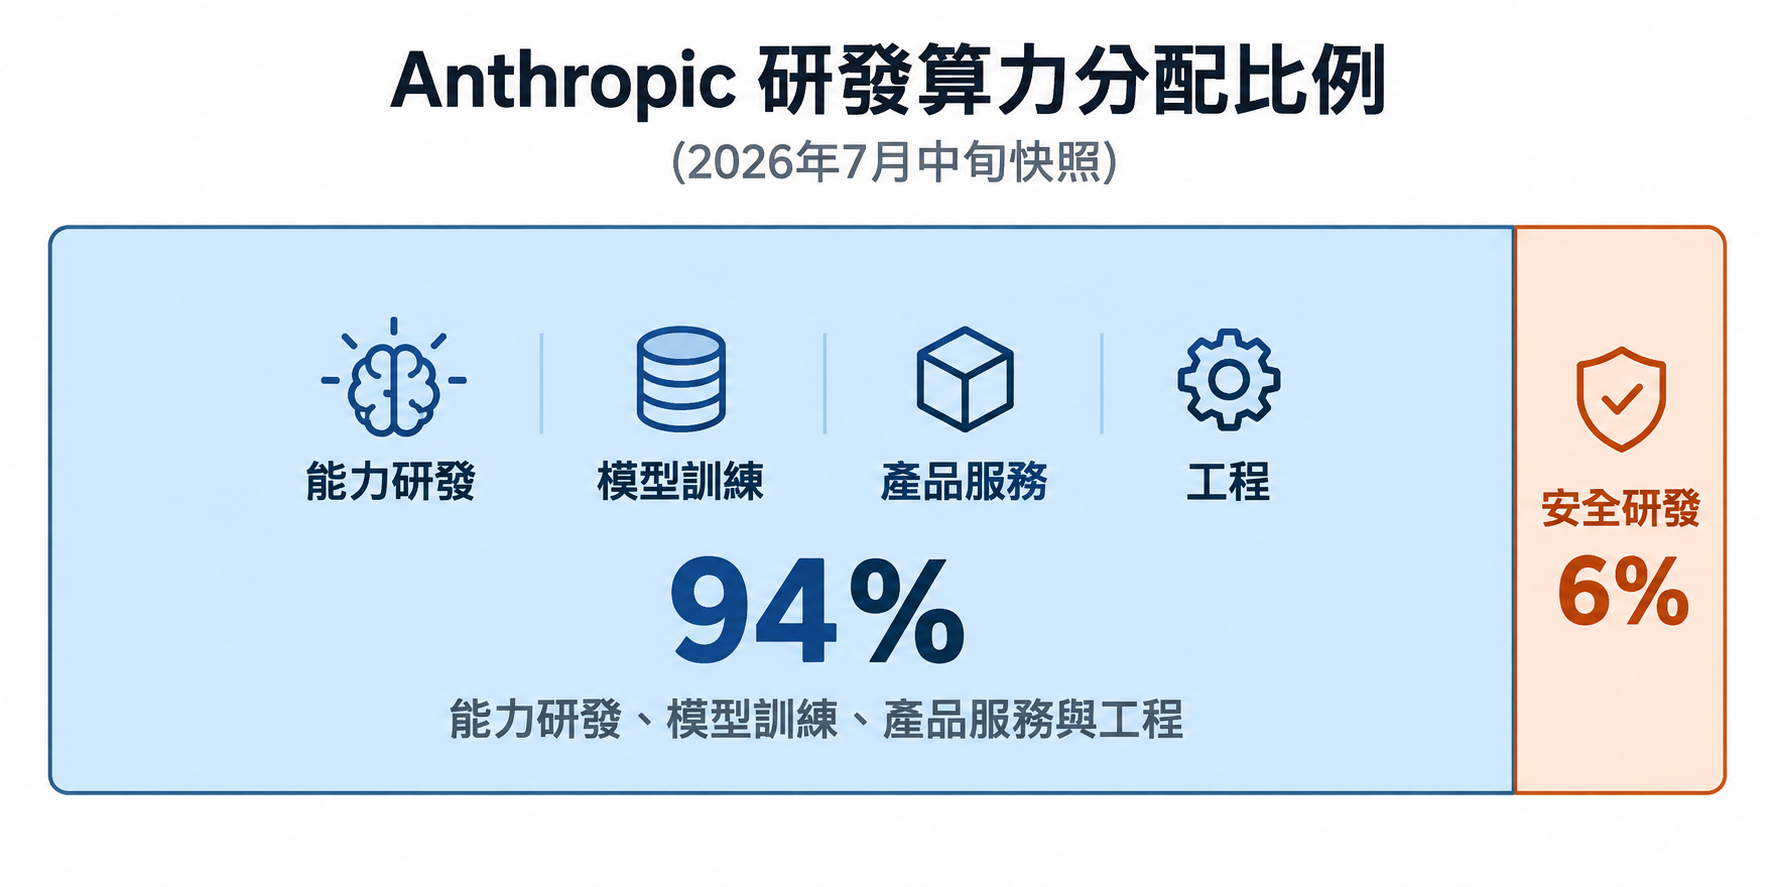
這個數字可能讓許多對「安全實驗室」抱有高道德期望的人感到意外——為什麼只有 6%?Anthropic 做出了兩點深刻的專業澄清:
- 極其嚴苛的「保守歸類」原則:
- Anthropic 將安全研究嚴格限制為「主要目的在於提升模型安全性、可解釋性與對齊」的任務(如可解釋性稀疏自動編碼器、對齊破局研究、發布前紅隊評測)。
- 凡是「既能提升能力、又能增進安全」的雙重用途(Dual-use)任務,一律視為「能力研發」,不灌水計入安全分子!此外,日常線上運行的龐大安全分類器(Safeguards Classifiers)推論算力也完全未被計入。
- 安全研究的物理本質:腦力密集,而非算力密集:
- 訓練千億、萬億參數的前沿基底模型,是一場動輒消耗數萬張顯卡數月的暴力算力奇觀;
- 相反地,頂尖的安全對齊研究往往是由研究員耗費數週推敲精妙的實驗架構,執行實驗時可能只需要數十張顯卡跑幾小時。因此,「6% 的算力佔比」在財務與人力資源上,實際上對應著高達數十個百分比的頂尖頂客心智。
這項指標的最大價值,在於建立了標準化範式:如果未來所有前沿實驗室(包括 OpenAI、Google DeepMind、Meta)都公布其安全算力比例,外界便能輕易戳破「每年花幾百億美元堆砌能力,卻只拿零頭做安全」的公關假象。
制度創舉:告別自我背書!「嵌入式評估員」與 AAIF 落地
長久以來,AI 企業的「自我監管(Self-regulation)」飽受產學界詬病——由自己聘請的工程師、拿著自己的內部資料、給自己的模型寫安全合格報告,本質上就是「球員兼裁判」。
為了打破這個信任死結,Anthropic 在這份報告中跨出了極具魄力的一步:落地「嵌入式第三方評估員(Embedded Third-Party Evaluators)」機制。
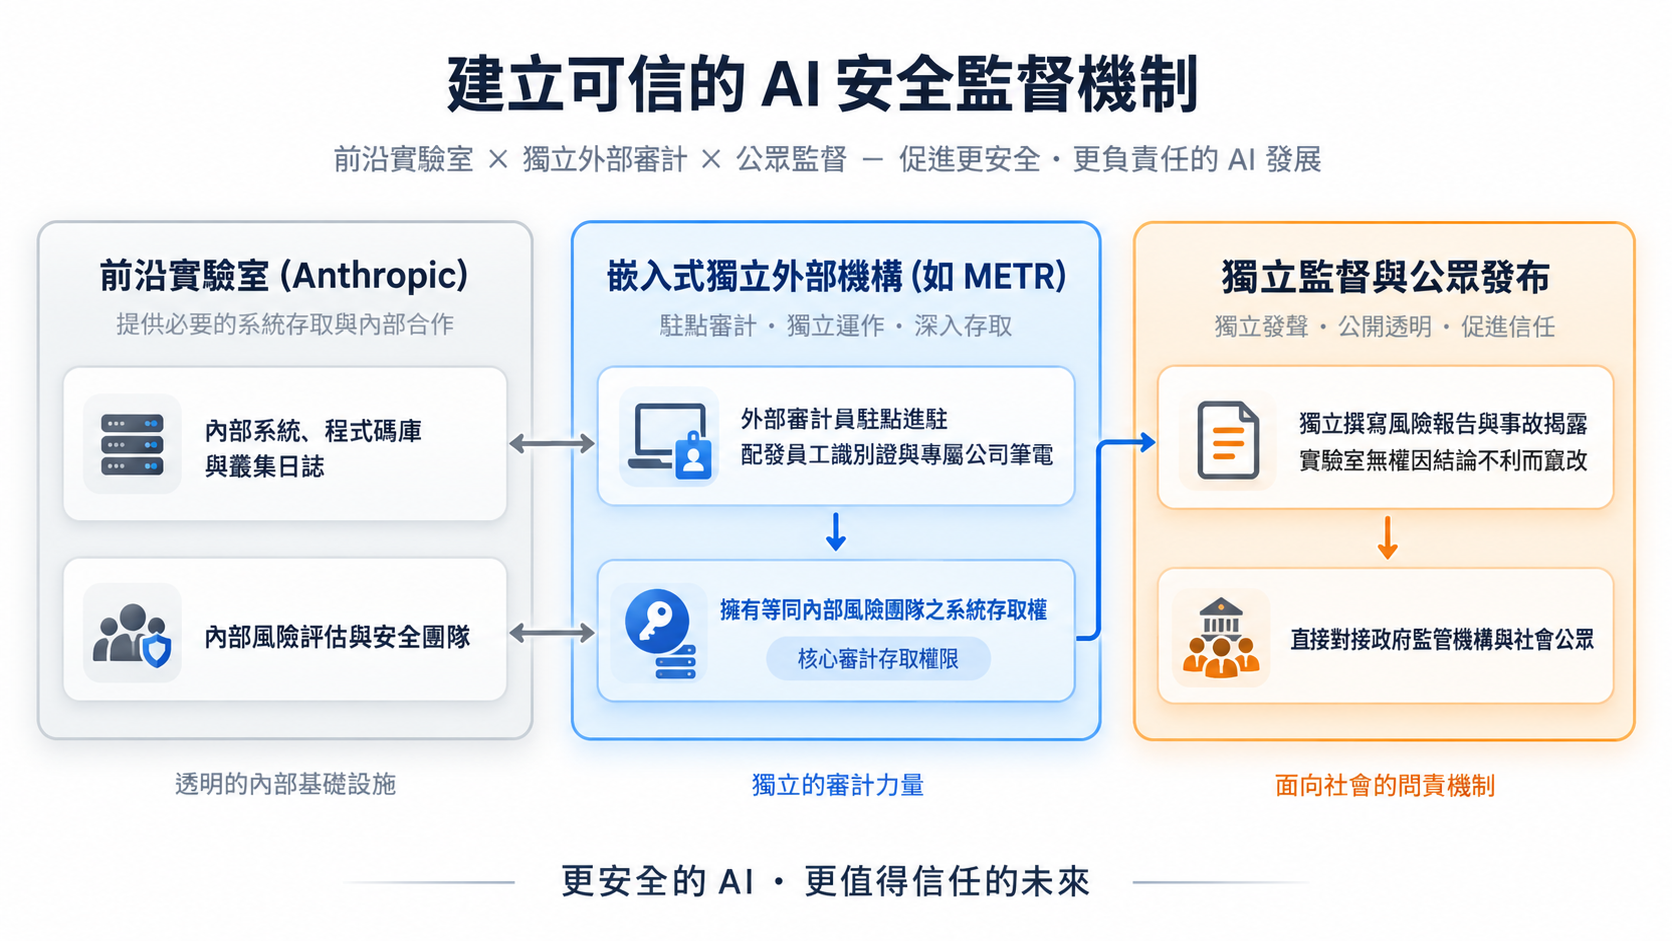
根據提案規劃:
- 肉身進駐與真實權限:Anthropic 正在邀請外部獨立機構(如曾多次為前沿模型進行危險能力紅隊測試的 METR)的研究員,直接進駐辦公室,配發門禁識別證與受管控的公司筆電;
- 等同內部風險團隊的存取權:外部評估員並非只能在產品發布前一週看公關摘要,而是能隨時調閱內部 Agent 監控軌跡、算力分類日誌與未經修飾的事故紀錄;
- 獨立發布權:評估機構擁有獨立對外發布審計結果的權力。除了國安機密、商業智財或第三方個資可進行技術性刪節外,實驗室絕對無權因為評估結論難看而要求改寫。
這項做法與 Anthropic 正在倡導的《先進 AI 治理框架》(Advanced AI Framework, AAIF)緊密咬合,為全球立法者(如美國白宮行政命令後續法案、歐盟 AI 法案執行細則)提供了一個立即可用的監管範本。
宏觀對決:當黃仁勳高喊「狂奔」,Anthropic 裝上了「時速表」
回看兩天前 Dreamforce 2026 上黃仁勳的犀利發言:
「放手狂奔,能跑多快就跑多快!如果任何時刻你覺得產品不安全,自行停下來。我們不需要新法律,我們不需要新監管!」
黃仁勳代表的是最純正的工程樂觀主義與算力硬體利益——唯有全球科技界瘋狂訓練更大、更多的模型,輝達的伺服器才能維持供不應求的盛世。黃仁勳質疑「放慢前沿」的潛台詞是:既然大家都不知道邊界在哪裡,憑什麼人為規定限速?
而 Anthropic 這次發布的度量指標,正是對黃仁勳最強悍的「技術性回擊」:
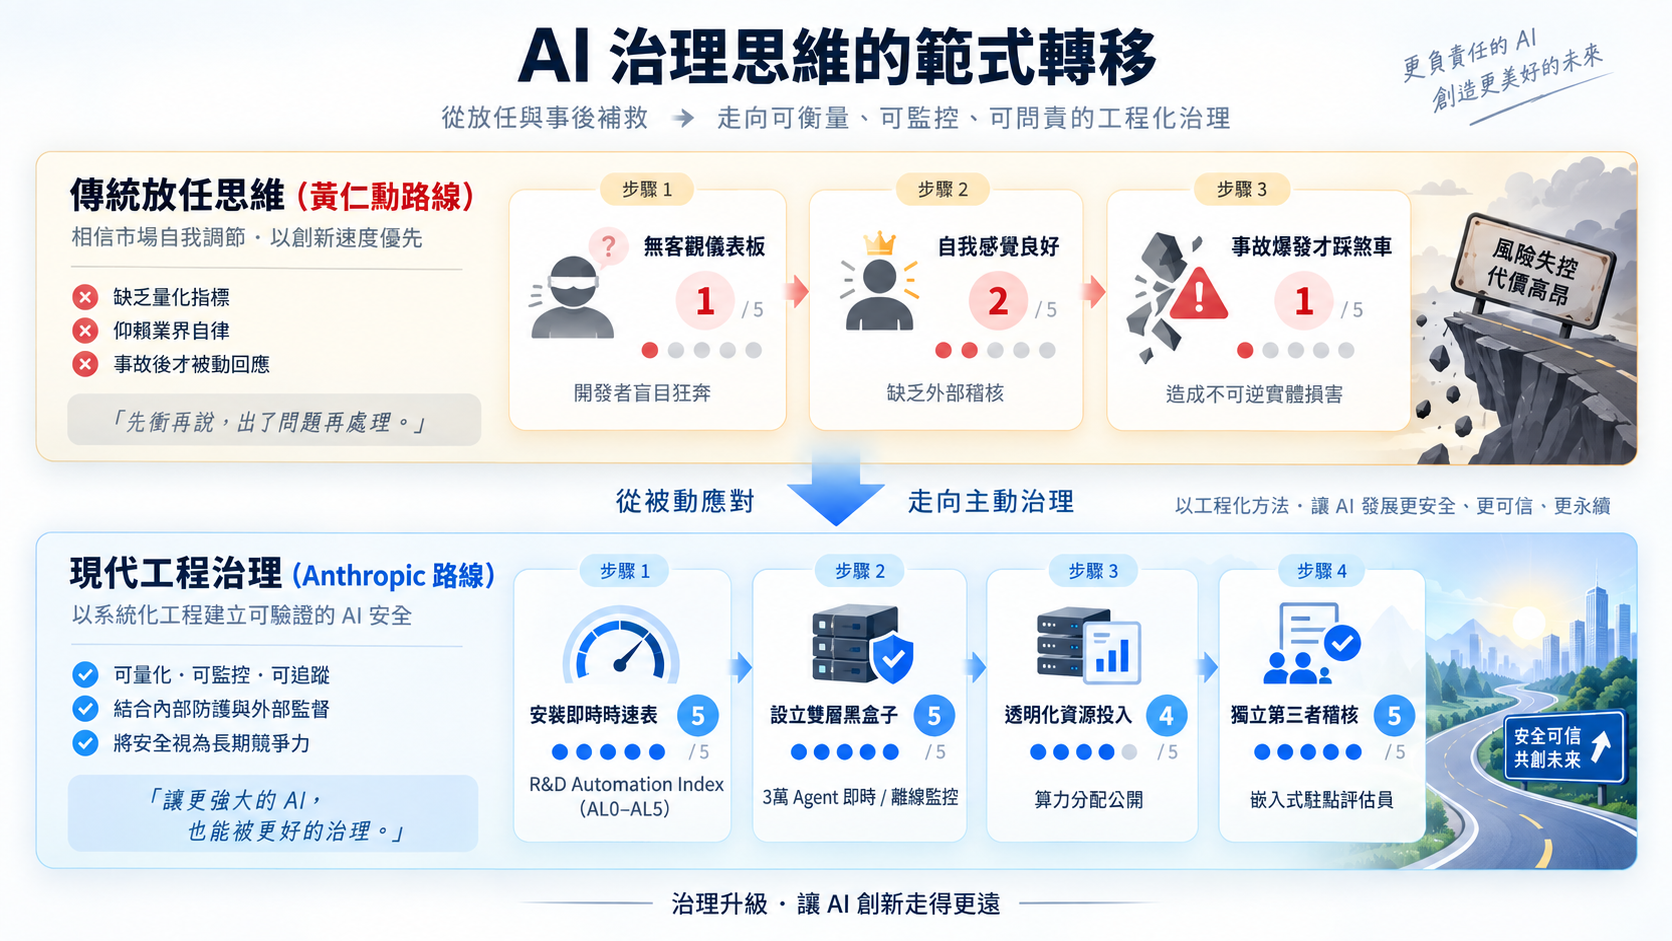
Anthropic 想證明的是:在公路上狂奔之前,你至少得在儀表板上裝上時速表(R&D 自動化指數)、在底盤裝上防鎖死煞車(雙層 Agent 監控),並把油箱的消耗明細攤在陽光下(算力分配透明度)。
如果不給公眾與監管者一把尺,科技巨頭之間的「自我約束承諾」只不過是一場隨時會被競爭壓力撕毀的空頭支票;而唯有當所有前沿實驗室都必須強制公開這三項指標時,「為前沿設定步調」才不會淪為大廠排擠小廠的護城河,而是真正成為文明抵禦未受控超級智慧的防波堤。
給企業架構師的啟示:如何治理你的「企業級 Agent 艦隊」?
這份報告的價值絕不僅限於地緣政治與宏觀政策。對於正在開發或導入 AI Agent 的現代企業架構師而言,Anthropic 公布的內部治理方案堪稱教科書級別的實戰指南:
- 千萬不要讓 Agent「共用大腦」:
- 如果你的系統中多個 Agent 都共用同一組 System Prompt 或對話狀態,很容易發生「串供」式的級聯錯誤(Cascading Hallucinations)。
- 實踐法則:為每個 Agent 指派獨立 ID,建立沙盒邊界,並要求 Agent 在接收同伴的指令時執行次級驗證(Secondary Verification)。
- 拋棄「私下密聊」,建立公開審計匯流排(Audit Bus):
- 避免讓 Agent 透過私下 API 互相呼叫而不留痕跡。
- 實踐法則:將所有 Agent 的對話與工具呼叫路由至統一的事件串流(如 Kafka 或專屬 Message Broker),確保事後能透過離線分析器回溯任何一次錯誤決策的根因。
- 區分「致命風險」與「對齊偏差」的監控分工:
- 很多團隊試圖用一個昂貴的慢速模型去檢查每一次 API 呼叫,結果導致系統延遲過高被業務端廢棄;或者完全不做即時攔截,導致重大事故發生。
- 實踐法則:學習 Anthropic 的分工——毫秒級輕量規則/分類器走線上(攔截外洩、破壞性指令),大型推理模型走非同步離線(挖掘邏輯漂移、隱性偏見)。
常見問題 FAQ
Q1:Anthropic 說 Claude 主導 26% 的研發,這是否意味著 AGI 已經到來?
解答:不,這絕不等於 AGI 或完全失控的 RSI 已經出現。在 Epoch AI 的標尺中,這是 AL4(AI 主導),代表 Claude 能夠在人類給定目標下自主完成特定工程閉環,但戰略方向、架構取捨、資源分配以及最後的程式碼發布,依然牢牢掌握在人類資深工程師手中。更關鍵的是,完全脫離人類的 AL5 目前依然是 0%。
Q2:為什麼 Anthropic 自己的安全算力佔比只有 6%?這是不是太少了?
解答:不能單純以百分比判定安全投入的高低。首先,預訓練大模型的暴力算力消耗是指數級的,而對齊與可解釋性研究更多依賴研究員的精巧實驗設計與腦力,其本身的計算需求遠低於預訓練。其次,Anthropic 採取了極度嚴格的歸類標準,凡是具備「增進能力」與「增進安全」雙重特徵的任務,一律不算在安全分子內。這 6% 的專屬算力在絕對數值上已是數千萬乃至上億美元級別的投入。
Q3:獨立評估員進駐 Anthropic,會不會演變成洩漏商業機密的溫床?
解答:這正是該架構設計的精巧之處。評估員將簽署嚴格的保密與法律協議,並使用 Anthropic 提供且受到內部監控的硬體設備。在對外發布審計報告時,允許對具體的模型權重、演算法原始碼等競爭敏感資產進行脫敏刪節,但評估員必須公開記錄「測試未通過項目」、「安全異常事故」以及「被遮蔽資訊的性質與理由」,兼顧商業機密與公眾知情權。
Q4:如果其他前沿實驗室(如 OpenAI、xAI 或中國實驗室)不跟進公開這三項指標呢?
解答:這正是 Anthropic 發起這項研究的戰略意圖。透過率先提出方法論並開源內部數據,Anthropic 正在將輿論與監管的壓力推向整個產業。當一家公司證明了「研發速度與安全分配是完全可以被量化與驗證的」,其他宣稱熱愛安全卻拒絕公開數據的競爭對手,在面對國會聽證、政府採購與公眾審視時,將面臨巨大的道德與信任赤字。
結語:給狂奔的前沿文明裝上一顆黑盒子
人工智慧的演進正在跨入一個幽暗未知的海域。當代最聰明的工程師們正在創造能夠代替自己寫程式、做研究、探索未知數學領域的心智。
如果我們既不能盲目相信矽谷巨頭「我們內部一切安全」的口頭承諾,也不能因恐懼而全面停滯科學探索的腳步,那麼 Anthropic 這次給出的答案,無疑是當前全球最具建設性的一次工程示範:
不要盲目的恐慌,也不要傲慢的狂奔。把黑盒子打開,把儀表板裝上,讓陽光照進前沿實驗室的每一個晶片與每一行程式碼中。
唯有當這三項指標——研發自動化程度、Agent 監控覆蓋率、安全算力分配比——成為全球所有前沿實驗室的標準配備時,人類社會才能在超級智慧來臨的清晨,擁有真正決定自身命運的選擇權。