AMD、Intel、Google 與 Meta 聯手成立 SGLang 推論聯盟!合組開源推論統一戰線,打破單一晶片軟體生態綁定
AMD、Intel、Google、Meta 等業界巨頭於 SGLang Summit 宣布成立 SGLang 聯盟,推動高效能大型語言模型推論引擎跨 GPU 與 TPU 硬體平台統一發展。

談到 SGLang,很多人以為晶片大廠要挑戰輝達在 AI 資料中心的霸主地位,只要做出規格參數更強的處理器晶片就夠了,但真正讓開發者離不開單一陣營的從來不是硬體本身,而是上層的軟體推論生態系。
2026 年 11 月中旬在業界矚目的 SGLang Summit 上,一場打破競爭門戶的跨界結盟正式登場:AMD、Intel 與 Google 攜手 Meta 以及多家產業領袖。
共同宣布成立「SGLang 聯盟」(SGLang Consortium)。
這項聯盟的目標非常明確,就是把目前全球最受歡迎的高效能開源大模型推論引擎之一 SGLang,推進成一個真正中立、跨硬體平台的統一標準。
讓開發者寫好一套 AI 推論服務後,能夠在各家不同的繪圖處理器(GPU)與 Google TPU 之間無痛切換運行。
有趣的是,在這個由多方共同參與的開源推論生態裡,既包含了想打破軟體護城河的挑戰者 AMD 與 Intel,也涵蓋了掌握龐大自研算力與模型生態的 Google 與 Meta,顯示整個產業對「推論軟體標準化」的急迫共識。
對台灣伺服器和雲端系統整合商以及正在自架開源模型的工程團隊來說,這代表未來選購 AI 推論伺服器時,終於有機會擺脫被單一晶片商軟體庫鎖死的困境。
接下來我們會拆解 SGLang 到底憑什麼成為巨頭欽點的推論底座、RadixAttention 等核心技術為何省錢又快、聯盟成立對硬體大戰的意義,以及企業導入跨硬體推論的觀察重點。
SGLang 是什麼?為什麼連 Google、AMD 與 Intel 都來站台
在理解這個新聯盟的戰略價值前,得先認識什麼是 這套開源引擎。
早期許多團隊部署開源模型時,只求能把模型載入記憶體吐出文字就好。但一旦進入高併發商業應用,單靠基礎框架根本扛不住流量。
這套開源引擎 最初由柏克萊與史丹佛背景的 LMSYS 團隊開發,主打的正是極致壓榨伺服器硬體極限的「高速結構化生成與推論引擎」。
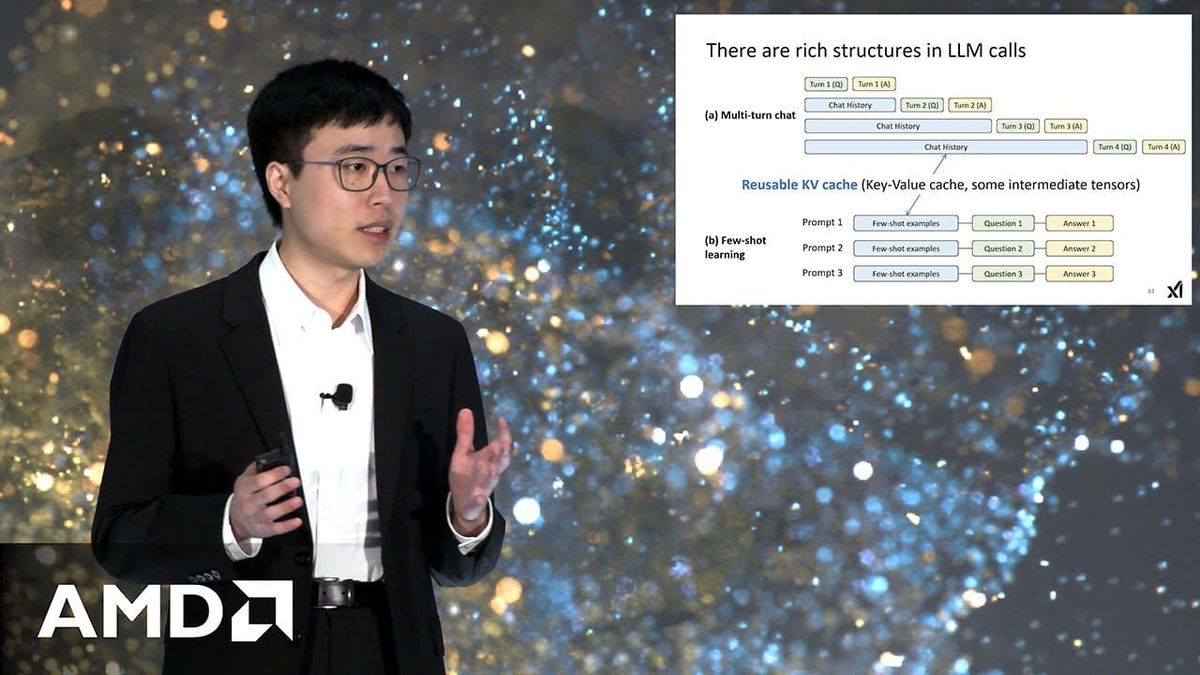
它之所以能在 2026 年迅速橫掃全球雲端與開源社群,核心技術殺手鐧就是名為「RadixAttention」的自動前綴快取共享機制。
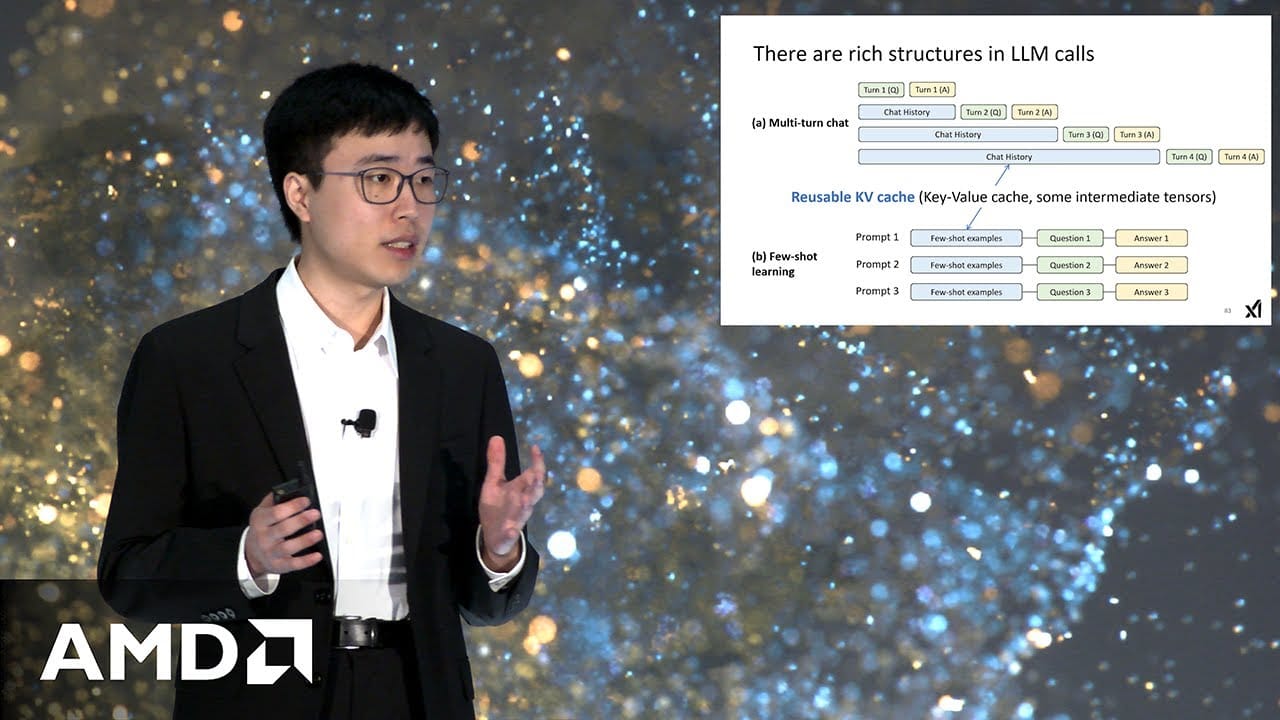
當成百上千個用戶同時呼叫 AI 代理時,不同請求之間常常有大量重複的系統提示詞、多輪對話歷史或共同的知識庫段落。
這套開源引擎 能把這些重複的鍵值快取(KV Cache)自動組織成樹狀結構共享複用,直接跳過大量重複計算,讓推論吞吐量比傳統做法暴增數倍。
而且面對 DeepSeek、Qwen、Llama 以及 Mistral 等各大主流開源模型與多模態視覺模型,這套開源引擎 往往能在模型發布第一天就提供高度最佳化的部署支援,這讓它成了無數 AI 基礎設施團隊的首選引擎。
延伸閱讀:AWS 推出 Amazon SageMaker AI 資料準備新功能與 KV Cache 感知路由!大幅降低大型語言模型首字延遲與推論成本
打破軟體綁定:三大巨頭合組開源推論統一戰線的盤算
過去幾年,AMD、Intel 與 Google 雖然各自在硬體端推出了性能強勁的資料中心加速器或 TPU。
但在真實企業客戶面前卻總是撞上一道隱形高牆:客戶的工程師習慣了既有的 CUDA 與特定推論函式庫,只要換一套硬體就得重寫一堆底層調校程式碼,切換成本實在太高。
這正是促成 這套開源引擎 聯盟成立的最核心戰略動機。
與其由每一家晶片商各自關起門來維護一套沒人想學的封閉推論框架,不如共同把資源與工程師人力集中起來,直接投入在開發者已經最愛用、且中立開源的 這套開源引擎 上。
當 這套開源引擎 的底層架構能原生且同等地支援 AMD 加速器、Intel 算力平台、Google TPU 以及既有主流 GPU 叢集時,就等於替整個 AI 推論層裝上了一套「萬用轉接頭」。
對 Google 與 Meta 這種自己擁有龐大異質算力機房的雲端超大規模業者而言,這個聯盟同樣帶來巨大好處:他們內部的模型服務團隊可以用同一套推論軟體管理跨廠牌的多元硬體,大幅降低維護成本並增加採購議價籌碼。
| 聯盟核心參與方 | 在聯盟中的角色與利益 | 希望解決的痛點 | 對開發者與企業客戶的影響 |
|---|---|---|---|
| AMD 與 Intel | 硬體挑戰者與算力供應商 | 打破單一競爭對手的軟體生態護城河 | 企業更容易把現有推論工作負載搬移至非單一陣營晶片 |
| 雲端巨頭與 TPU 自研晶片推手 | 讓開發者在 TPU 與多品牌 GPU 間無縫調度 | Google Cloud 客戶部署開源模型的選擇更彈性 | |
| Meta | 頂級開源模型主導者與算力買家 | 確保 Llama 等開源生態跨硬體高效運行 | 降低大型推論機房維運複雜度與成本 |
| SGLang 開源社群 | 聯盟技術底座與維護核心 | 獲得頂級晶片與雲端大廠工程資源注入 | 新模型上市首日支援更快、底層穩定度大幅提升 |
延伸閱讀:SC26 最新 TOP500 榜單揭曉:AMD 進駐 202 套系統,4,000 顆 MI355X 打造 Lux 第 14 名代表什麼?
對台灣 AI 伺服器供應鏈與軟體團隊的實際意義
把這場結盟放在台灣科技產業的視角來看,影響主要體現在「硬體採購多元化」與「推論機房標準化」兩個層面。
對台灣的電子代工大廠(如鴻海、廣達、緯穎與技嘉)而言,過去客戶在採購 AI 推論機櫃時往往只有單一選擇。
當 這套開源引擎 這類開源推論引擎在聯盟推進下變得跨平台成熟後,北美雲端客戶與企業資料中心採購搭載 AMD MI 系列加速器或多元架構伺服器的意願將會實質提高。
這有助於台廠平衡不同晶片平台的出貨比重,降低對單一上游供應商的依賴。
對台灣的軟體新創與企業 AI 研發團隊而言,這更是一項明確的技術選型指南。
如果你的公司打算在內部機房或混合雲環境裡自架開源大模型服務,選擇 這套開源引擎 這類獲得跨巨頭聯盟背書的標準化推論框架。
能確保未來幾年就算公司決定更換雲端業者或換購不同廠牌的 AI 晶片,上層的應用程式與提示詞架構完全不需要打掉重練。
跨硬體推論統一前,工程團隊還須看清的挑戰
儘管聯盟氣勢浩大,但要在真實生產環境實現「同一套 這套開源引擎 程式碼在所有硬體上跑出完全相同的極致效能」,短期內仍有不少硬骨頭要啃。
因為不同晶片的記憶體階層、互連通訊協定與低精度數值運算特性各有差異,許多極限效能的最佳化算子依然高度依賴各晶片原廠的底層編譯器團隊持續填坑。
這也是為什麼這個聯盟的成敗關鍵,在於 AMD、Intel 與 Google 接下來是否真的願意派出最頂尖的底層系統工程師,把專屬驅動與核心程式碼持續回流貢獻給開源主幹分支,而不只是發完新聞稿就各自散場。
為什麼企業自架模型最怕「單一硬體供應商鎖定」
在企業採購雲端或地端算力伺服器時,技術主管最害怕遇到「軟體與單一硬體完全綁死」的狀況。
因為一旦你把整套微服務與代理呼叫寫死在某家晶片商的專屬推論函式庫裡,未來就算競爭對手推出價格便宜四成、效能還更強的新晶片,你的團隊也會因為重寫與測試成本太高而不敢換。
這套開源引擎 推論聯盟的成立,正是替企業客戶提供一層中立的軟體抽象保護傘,讓算力採購重新回到比拚性價比與供貨穩定度的健康競爭。
台灣軟體團隊導入開源推論引擎的三個檢查點
如果你的研發團隊準備在內部機房部署開源模型,建議在測試 這套開源引擎 時先檢查三個實務項目。
第一是確認公司選用的模型架構與量化格式是否已獲得官方主幹分支支援。
第二是實測高併發長對話下的 RadixAttention 快取命中率與顯存佔用。第三則是評估多節點擴展時的監控與自動重啟機制是否完善。
開源推論標準化對全球 AI 軟體生態的長遠意義
回顧電腦發展史,無論是作業系統核心 Linux 還是容器編排系統 Kubernetes,當產業進入大規模普及期時,最終勝出的往往都是獲得多家巨頭共同支持的中立開源標準。
SGLang 推論聯盟的成立,正是在複製這條已經被歷史驗證成功的路徑:讓沒有任何一家硬體商能單獨把開發者鎖死在自己的私有圍牆裡。
一旦這套開源推論引擎在跨平台效能上追平甚至超越單一廠商的封閉方案,整個 AI 基礎設施的創新速度與採購透明度都會迎來大幅提升。
企業技術主管該如何規劃未來三年的推論架構彈性
對正在自建 AI 平台的中大型企業而言,現在在系統設計初期就應該把「推論引擎抽象層」納入架構原則。
只要應用程式端統一透過標準化的相容介面呼叫底層 SGLang 叢集,公司未來就能根據每季不同晶片商的報價與供貨狀況,隨時在多種加速卡之間靈活切換算力供應商。
開源推論聯盟後續值得追蹤的技術里程碑
接下來半年,開發者可以密切關注該聯盟是否如期釋出針對多品牌晶片的自動化效能基準測試報告。
因為只有當跨硬體的實際吞吐量與延遲表現被公開透明地驗證後,企業才會有足夠信心大舉採用多元硬體架構。
對台灣的雲端系統整合商與主機代管業者而言,這代表未來替客戶建置私有 AI 推論叢集時,將擁有更豐富的軟硬體混搭方案。
廠商不再需要被單一高價晶片綁住報價,而能依照客戶預算彈性配置最具性價比的跨平台算力組合。
對於希望降低對單一晶片商依賴的企業基礎設施團隊而言,持續追蹤開源推論引擎的跨平台基準測試進展,將是明年規劃機房擴容時最重要的技術功課之一。
常見問題 FAQ
SGLang 聯盟成立後,這個開源專案還會保持免費開源嗎?
會。
成立聯盟的初衷正是透過匯集多家科技巨頭的工程資源與資金,共同把 這套開源引擎 打造成中立、開放的跨硬體推論基礎設施標準,讓全球開發者都能繼續免費取用並參與貢獻。
SGLang 跟另一套常見的開源推論框架 vLLM 有什麼差別?
兩者都是目前業界最頂尖的高吞吐大模型推論引擎。
這套開源引擎 特別以其原生的 RadixAttention 樹狀前綴快取共享、高度結構化輸出控制(如嚴格 JSON 格式加速)以及針對多步驟代理工作流的優化著稱。
為什麼連競爭對手都要一起加入同一個軟體聯盟?
因為在 AI 推論市場裡,如果各家晶片商各自推銷不相容的軟體引擎,企業開發者只會因為怕麻煩而繼續留在原本的單一霸主陣營裡。
唯有大家一起把共同的開源底座做大做好,挑戰者才有機會真正搶到硬體市占。
台灣企業現在適合用 SGLang 架設內部 AI 服務嗎?
非常適合。
目前 這套開源引擎 已經在生產環境中經過大量高流量驗證,尤其適合有多輪對話、共享長系統提示詞、或需要穩定輸出結構化資料的企業級 AI 代理應用。
結語
AMD、Intel、Google 與 Meta 聯手成立 這套開源引擎 聯盟,標誌著 AI 基礎設施的競爭已經進入「軟體開源聯合陣線」的新篇章。
當硬體效能差距逐漸縮小、企業越來越在乎長期推論成本與供應鏈安全時,誰能讓開發者最無痛地跨硬體調度算力,誰就能打破現有的生態壟斷。
對正在建置企業 AI 推論架構的台灣技術團隊而言,保持「軟體層開放與可攜性」將是未來幾年最重要的一項技術保險。
押注獲得多方巨頭共同維護的開源標準,遠比把所有身家綁死在單一封閉系統來得聰明且安全。
如果你想持續追蹤開源推論引擎演進與 AMD、Intel 挑戰算力霸權的最新戰況,歡迎免費訂閱 AI 郵報,或點擊下方延伸閱讀查看最新的超級電腦榜單解析。