AutoCompact 讓程式代理學會整理上下文:為什麼提早摘要能提高解題率?
AutoCompact 研究訓練程式代理決定何時整理上下文、保留哪些工作狀態,以及摘要後如何繼續。本文解讀 SWE-bench 成績提升,區分百分點、上下文容量與實際產品能力。

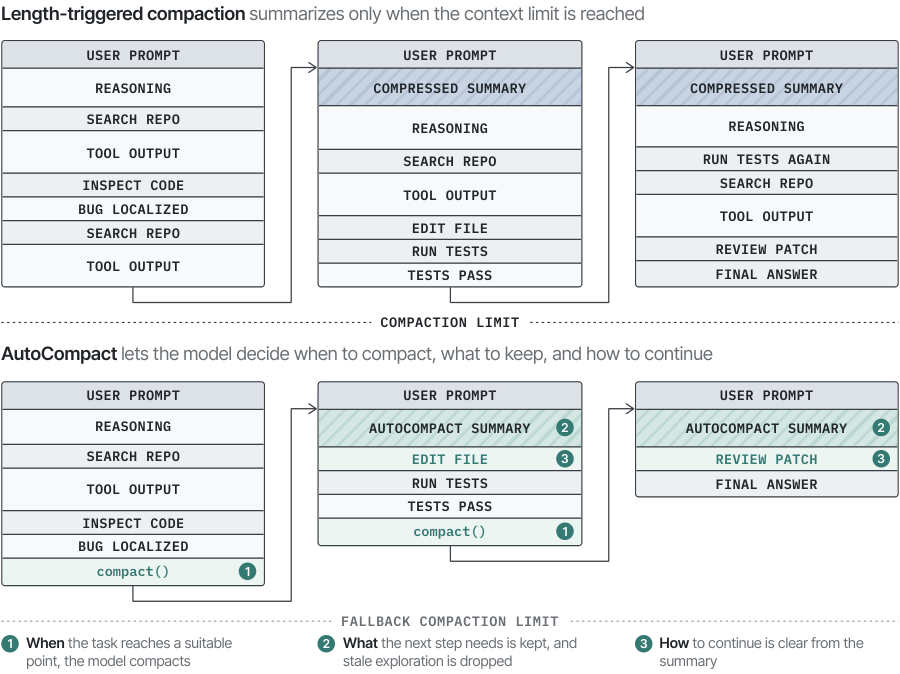
AutoCompact 是一項訓練程式代理管理上下文的研究。上下文是模型當次工作能參考的對話、程式片段與工具結果;整理上下文,就是把仍有用的資訊留下,移除已過期的探索細節。
論文於 2026 年 10 月 1 日公開,近期在 X 被分享。它提出的問題很實際:代理工作越久,資料越多,但下一步真正需要的,可能只是已確認原因、目前修改狀態與尚待完成的驗證。
為什麼上下文變大仍會出問題
程式代理通常會先搜尋、讀檔、提出假設,再修改與測試。過程裡會累積失敗嘗試、冗長輸出與已推翻的想法。如果全部留下,模型可能再次追逐舊線索。
單純在容量快滿時摘要,也可能碰上尚未釐清的階段,把仍需要的證據刪掉。AutoCompact 因此把問題拆成三件事:何時整理、保留什麼,以及整理後如何依據新狀態繼續。
這個拆分很重要。摘要寫得正確,但代理之後沒有使用它,仍可能重做已經完成的工作。
AutoCompact 如何取得訓練資料
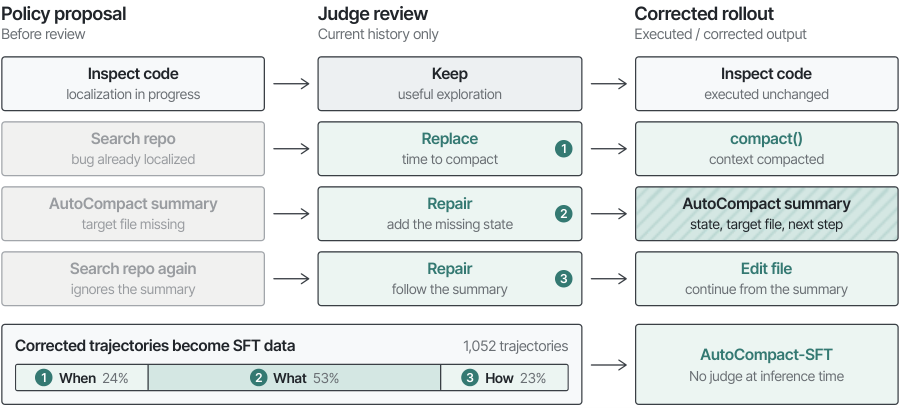
依原始論文,研究者先讓基礎代理執行程式任務,再由評判者檢查整理決策、摘要內容與後續行動。出現問題的輸出會先被修正,之後才在環境中執行。
這樣得到的軌跡,能示範一條比較完整的路徑:決定整理、產生適當狀態,並照著狀態完成下一步。研究接著進行監督式微調,再使用任務成功獎勵做強化學習。
監督式微調是讓模型學習示範資料;強化學習則依結果獎勵調整行為。這裡的目標包括程式任務與上下文管理,讓兩者一起被優化。
成績提升要怎麼讀
論文報告,相較基礎模型,AutoCompact 在 SWE-bench Verified 提升 9.2 個百分點,在 SWE-PolyBench Verified 提升 5.0 個百分點。百分點是成功率直接相減的差距,和相對增加百分比不同。
| 評估條件 | 論文主要觀察 |
|---|---|
| 256K 上下文,未發生容量溢出 | 整理策略仍帶來改善 |
| 16K 上下文,溢出時有備用整理 | 改善仍存在 |
| 不同推論預算 | 在已評估範圍內維持效果 |
K 在這裡代表約一千個 token,token 是模型處理資訊的單位。大容量條件下仍有改善,支持「整理不只為了避免塞滿」這個研究觀點。
這些結果來自論文的模型、任務與訓練方式。它們不能直接換算成任何現有程式代理升級後的成功率。
實務上可以先改善什麼
即使沒有使用 AutoCompact 的訓練方法,團隊仍可以改善工作摘要。摘要應記錄已確認的事實、改了哪些檔案、哪些測試完成,以及下一步要檢查什麼。
推測和事實最好分清楚,例如「懷疑快取有問題」和「停用快取後錯誤消失」提供的證據不同。保留這個差別,能減少代理把舊猜測當結論。
我的判斷是,這項研究把長任務的管理問題放到模型訓練中,是值得追蹤的方向。實務採用仍要看可取得的模型與程式,不能把論文成果直接當成已可安裝的外掛。
常見問題
上下文整理會讓模型永久記住專案嗎?
整理是更新目前工作狀態,永久保存仍需要文件或其他持久化系統。
上下文越大就不用整理嗎?
容量增加能容納更多資料,但過期資訊仍可能干擾下一步判斷。
9.2 的提升是所有任務通用嗎?
它是特定評測中的成功率差距,適用範圍應保留在論文設定內。
結語:好的摘要要能指引下一步
AutoCompact 把何時整理、保存什麼與如何續做放在一起考慮。對長時間程式任務,可靠的工作狀態能幫助代理把已完成的探索轉成實際進展。