Databricks AI Index 公開:企業模型用量、每次任務成本與預算分布怎麼讀?
Databricks AI Index 公開:企業模型用量、每次任務成本與預算分布怎麼讀? 整理官方公告、適用條件與實務判斷,區分產品宣稱與已公開證據。

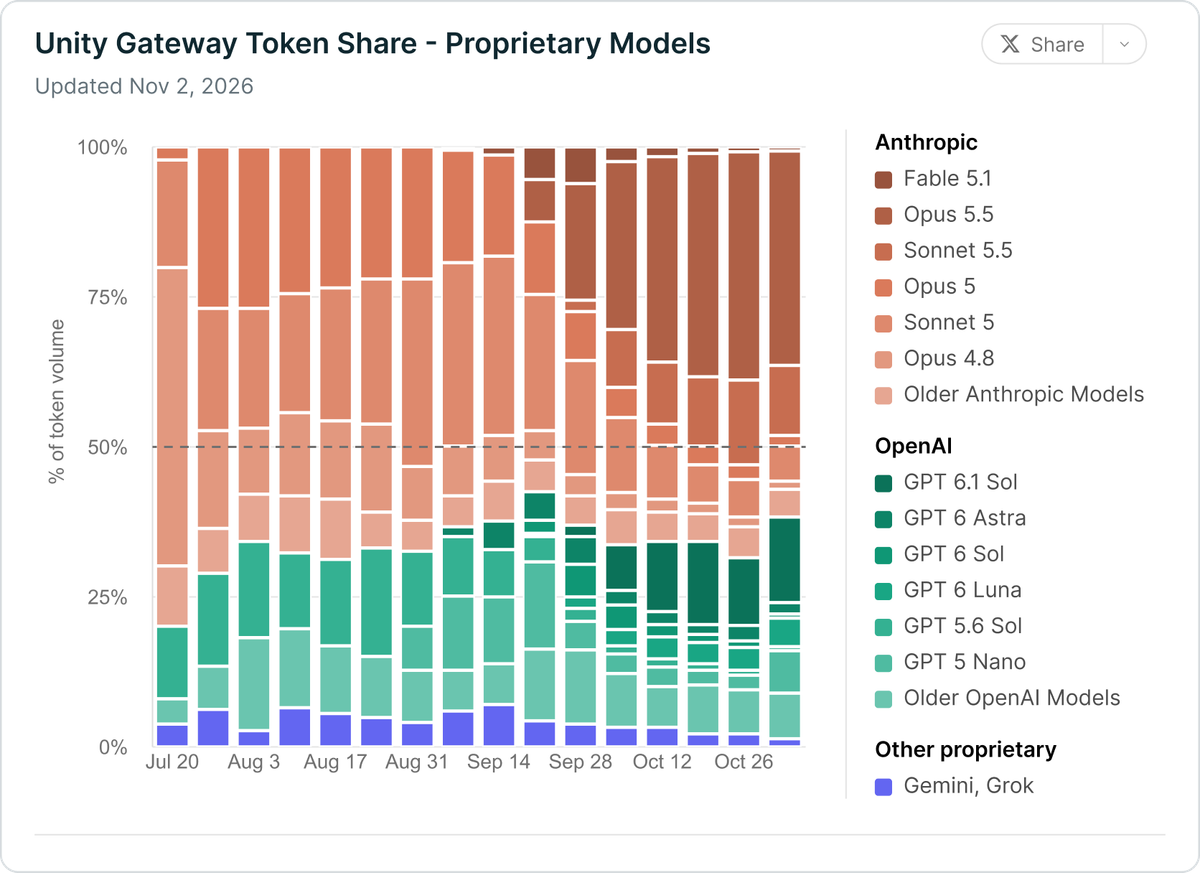
Databricks AI Index 回應的是企業選模時的成本難題。企業選 AI 模型時,單看排行榜與每百萬詞元價格,很難知道帳單最後會變多少,因為完成同一份工作需要的嘗試次數也不一樣。
Databricks 在 2026 年 11 月 16 日推出 AI Index,把 Unity Gateway 客戶的匿名彙總使用資料,與自家程式任務評測放在同一個公開資源。
這個索引能呈現樣本內的模型選擇與成本差異,但它觀察的是經由該平台的工作,不能直接換成全球 AI 市占。
更需要注意的是,使用量、按牌價估計的支出與程式任務成功率有不同分母,若把它們混在一起,原本要省錢的比較反而可能誤導採購。
對已有多模型帳單的企業,這是一份可以建立內部比較方法的參考。若只想找出一個永遠最好的模型,這份資料本身就不支持那種答案。
要把索引用在預算決策上,先拆開它的資料範圍,再看每次任務成本如何改變選擇。
Databricks AI Index 的樣本與日期涵蓋哪裡?
索引把企業用量與內部程式評測分成不同資料來源,各張圖的日期和分母必須分別讀。它能提供企業實際使用模型的線索,但看不到沒有經過該平台的全部工作。
依 官方發布文章,使用資料來自一萬家以上採用 Unity Gateway 的企業,經匿名彙總後呈現,包含數位原生企業與大型企業。
Unity Gateway 是集中連接與管理模型的入口,能觀察經過它的請求。因此樣本有實際企業使用價值,也有平台邊界,不能把其中某個模型占比直接稱為全球市場占有率。
使用資料與程式評測有不同用途
使用資料描述公司選了哪些模型、送出多少文字用量,以及按公開單價估計的支出。程式評測則使用 Databricks 私有程式碼的實際工作與隱藏測試,衡量模型和執行工具組合的成果。
隱藏測試是未提前交給模型的驗收條件,可以降低模型只記住公開題目的影響。但題目仍來自該公司的工作,不能直接保證其他企業的專案也有相同成功率。
官方評測使用測試結果驗收,而非單靠另一個模型打分。這有助於理解成功的定義,但程式修改是否涵蓋所有業務要求,仍要看題目與測試設計,不能把一個分數當成完整產品驗收。
為什麼不能寫成今天的即時排名?
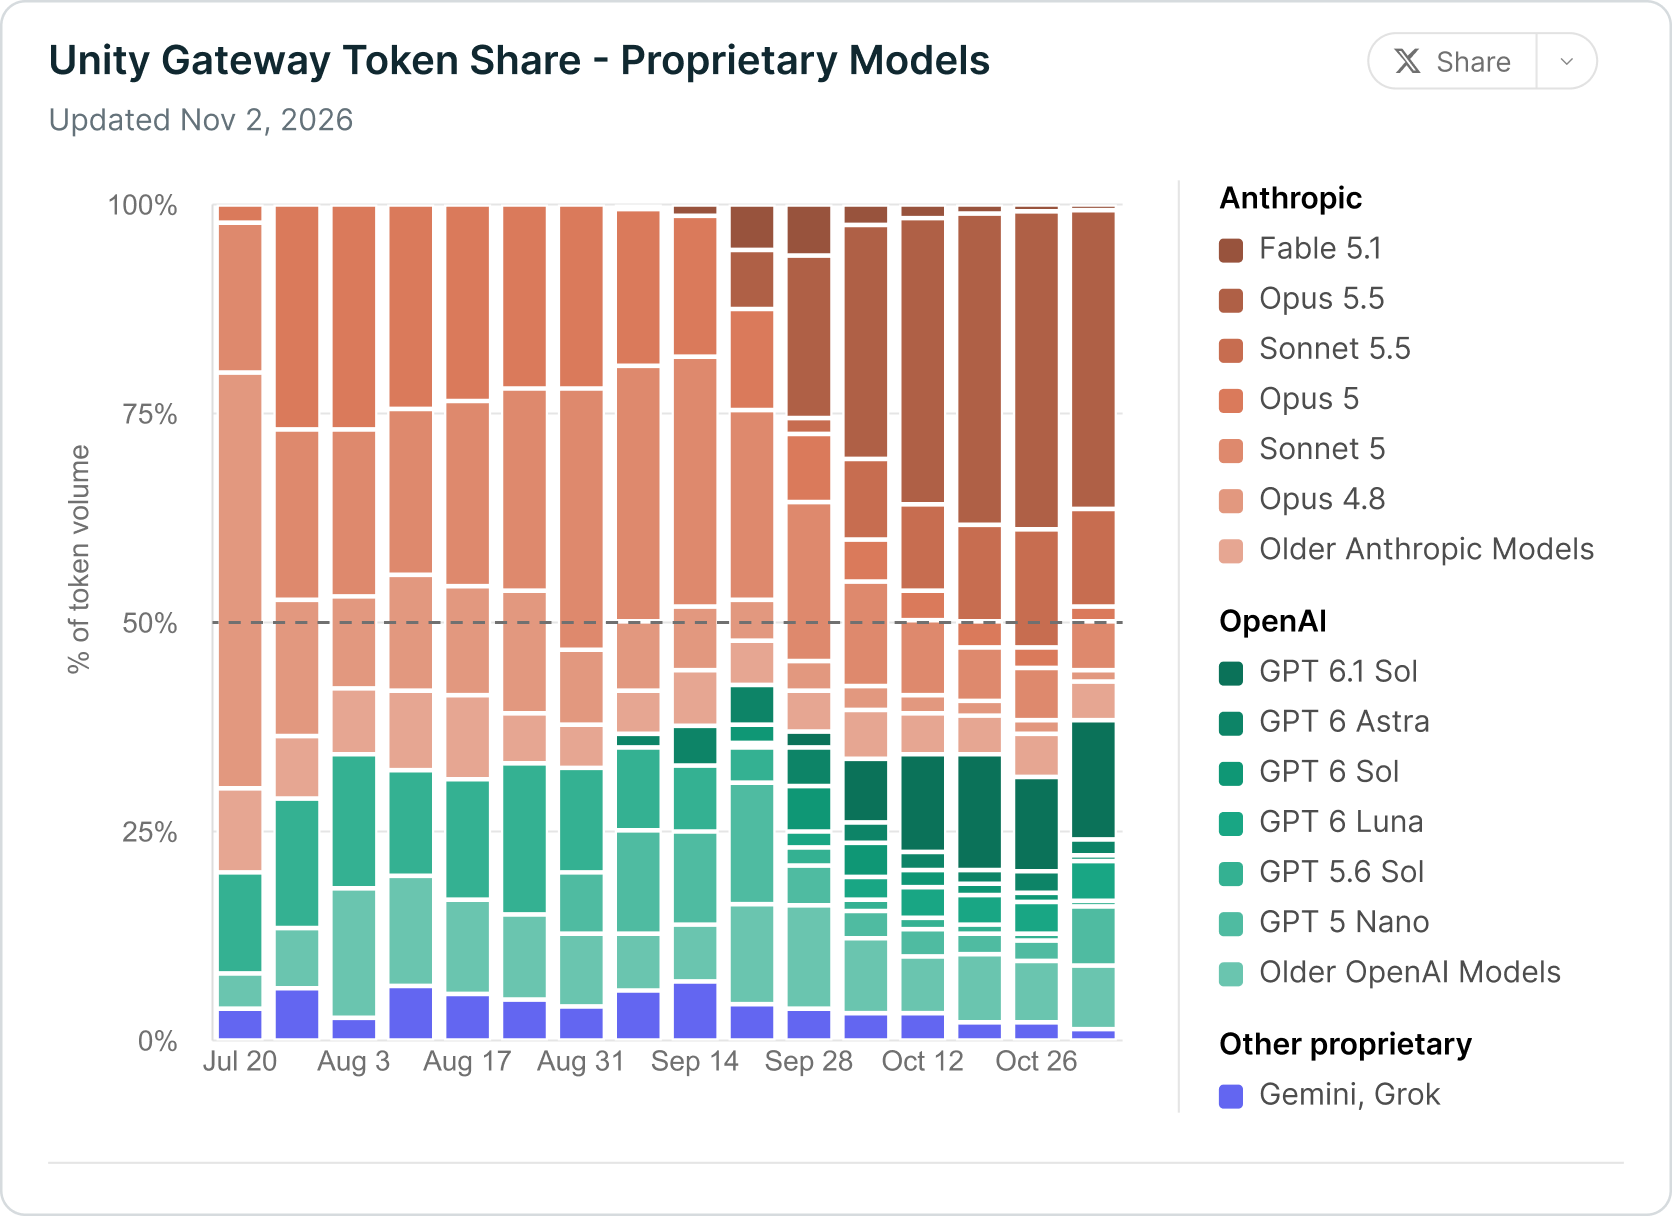
發布文章在資料說明中列出當前資料集為 2026 年 9 月 21 日至 11 月 7 日,但文中部分趨勢追溯到七月。互動索引的使用量、支出等圖表另標示 11 月 2 日更新。
因此不同圖與段落不能合併成同一天、同一期間的數字。讀者要引用哪一項,就應連同該圖的更新日期與分母保存,程式評測也要另外看自己的評測時間。
官方互動索引預計持續更新,日後頁面上的模型與圖表可能改變。對預算或採購文件而言,留下當時日期與條件,才能知道之後是市場變了,還是比較口徑不同。
先把樣本範圍弄清楚,才能理解多模型使用增加代表的是哪一種改變。
多供應商與開放權重的增加代表什麼?
官方資料顯示客戶更常混用供應商與開放權重模型,但用量比例仍受平台觀測範圍限制。這提供一個方向:企業可能依工作選擇模型,而非把所有任務永久綁在同一家。
不過「曾使用多家供應商」和「每項工作都同時比較多家」並不相同。互動圖的定義是對當週活躍公司,累計計算 2026 年 7 月 20 日以來曾用過的供應商。
累計口徑會影響解讀
一家公司曾經測過第二家模型,之後回到原本供應商,仍可能被算進累計使用多家的群體。因此這張圖更適合觀察接觸與多元化,不能直接推論同時付費或正式上線的模型數量。
官方也把部分模型家族合併為同一供應商,例如 Gemini 與 Gemma 算一起,GPT 與 GPT-OSS 也算一起。比較企業使用幾家時,這個分類方式會改變結果,不能自行按模型名稱重算。
開放權重則指可取得模型參數的一類產品,實際使用權仍受各模型授權影響。它和免費推論、完全開源或沒有維護成本並不相同,因此用量增加也不等於企業成本自然下降。
詞元占比與支出占比不能互換
詞元是模型處理文字的用量單位,輸入與輸出會影響計費,但一個詞元不等於固定中文字數。不同模型單價不同,因此同樣用量可能對應不同支出。
互動索引的支出占比,是按各供應商公開牌價估計,快取讀取也按對應費率計算。官方明確說這不是 Databricks 實際向客戶收取的費用,所以不能把圖表稱為已支付帳單的市場分布。
另外,索引中專有與開放權重的比較圖,註明只計入在 Databricks 上代管、經 Unity Gateway 使用的模型。其他供應商占比圖則包含外部流量,兩張圖不能直接相加。
模型種類增加之後,採購比較就需要從單價進一步看完成工作需要多少成本。
為什麼低詞元單價,未必有低任務成本?
每次任務成本還包括反覆推理與重試,因此便宜單價可能被更多操作抵銷。這也是官方把程式任務成功率與成本放在同一張比較圖的原因。
發布文章舉例,GPT-6 Luna 與 Claude Opus 5.5 在該次程式評測都達到 89.1% 任務成功率,但平均每次任務成本分別是 0.05 美元與 1.62 美元,約相差三十二倍。
這個例子支持的是特定題目與工具配置下,接近的評分可以有不同成本。它沒有證明兩個模型在每一種工作都等效,也不代表讀者可以把既有專案全部直接換掉。
為什麼要把執行工具一起比較?
模型只是代理的一部分,執行工具決定如何使用命令、讀檔、測試與管理對話。官方評測使用 Claude Code 與 Codex 等環境,因此比較對象是模型與執行配置的組合。
同一模型換了一套工具,可能使用不同次數的操作與推理。企業若只抄榜上的模型名稱,卻使用不同工具與資料,結果便不一定和官方評測相同。
官方文章也舉出低單價模型反覆操作的例子,說明較多輪次與長輸出會增加總成本。對實務團隊而言,應記錄從開始到驗收通過的全部用量,包含失敗後再跑的部分。
成功率更高,就一定值得增加成本嗎?
官方資料中的另一組比較,Fable 5.1 成功率為 96.0%、每次任務 7.47 美元,Muse Wonder 為 94.9%、1.53 美元。前者多 1.1 個百分點,成本卻接近五倍。
這不能直接決定哪個模型較好,因為多完成的那一小部分,可能正是某些團隊最重要的工作。採購問題應該是這些額外成功能省下多少人工,是否足以抵銷成本。
因此可以先用較輕模型處理已有清楚規則的工作,再把複雜或失敗案例交給較強模型比較。這是從成本與品質關係推導的安排,不代表官方已證明這種分流對每個企業最省。
成功率與成本必須一起看,也因此不能只把排行榜第一名設為所有人的預設。
使用者支出差距,怎麼轉成預算管理?
樣本中的支出集中在少數高用量者,管理方式應先了解工作需求再安排額度。官方發布文章列出每週中位數使用者支出為 2.49 美元,第九十九百分位為 699.74 美元,約相差二百八十一倍。
中位數是把使用者依支出排序後位在中間的人,第九十九百分位則接近高支出端。這些是分布位置,不能把高支出數字當成典型員工,更不能直接當成全公司平均。
高用量不一定代表浪費
一位全天用代理修改程式的工程師,和偶爾問幾個問題的行政同仁,完成的工作不同。若直接給相同上限,可能限制真正有產出的工作,同時仍無法看出哪些請求在重複失敗。
比較合理的起點是把用量對回任務。高支出者是否完成更多可驗收工作、是否因長文件而增加輸入,以及是否卡在同一錯誤反覆重試,會導向不同的改善方式。
索引的使用者支出圖只統計人類使用者,且按公開單價估計。因此企業若有大量自動服務帳號或背景代理,不能只拿這張圖當整體預算基準,還要把自己的非人類流量另行盤點。
預算應能支持例外,也能說明例外
團隊可以先按工作用途設計預算,再保留需要額外用量的申請方式。例如一次性的資料遷移驗證,可能比日常聊天昂貴,卻有明確結束時間與驗收成果。
反過來,如果一個背景任務每天重跑但沒有新資料或新成果,才值得檢查觸發條件與重試安排。只按員工名稱限制總額,容易看不到這類工作流程問題。
掌握支出分布後,企業才能用自己的任務決定模型與執行工具的組合。
企業如何把公開索引變成自己的比較基準?
挑選有代表性又能驗收的任務,連同模型、執行工具、重試與人工修正一起比較。公開索引提供起點,內部任務才決定哪些差異真的值得付費。
可以先選幾種常見工作,例如修正既有測試失敗、整理有標準答案的資料,或產出需要人工核對的文件。不同類型分開比較,才不會用擅長寫程式的成績決定所有文書工作。
固定條件,才知道改變來自哪裡
第一輪固定資料、工具與完成標準,只更換模型,再比較成功率、用量與人工接手時間。若同時換掉題目與執行方式,成本下降也很難說明是哪一個改動造成。
遇到失敗時要保存原因,例如找不到工具、讀錯資料或沒有通過測試。這些差異可能需要調整流程,而不是全部升級到最昂貴模型,否則預算增加也未必能解決問題。
還要保留一部分未用來調整提示的任務,確認規則能否用在新的案例。如果只反覆修到同一批題目通過,容易高估實際部署後的表現。
最後為每個採用決定留下日期與理由,說明目前選擇能達成的品質與成本。如果之後官方索引或自家結果改變,就能針對影響最大的工作重新測試,不必每次全面推翻既有配置。
把選模依據留成可更新的紀錄,才不會每次新模型推出都從宣傳重新開始。
Databricks AI Index 常見問題
Databricks AI Index 是全球 AI 市占排名嗎?
不是。企業用量來自使用 Unity Gateway 的客戶,程式評測來自 Databricks 的工作與測試,兩者都有特定觀測範圍。
支出圖表就是客戶實際付款的帳單嗎?
官方說明是按供應商公開牌價與用量估計,並非 Databricks 實收費用。內部採購還要核對自己的折扣、快取與服務條件。
每次任務較便宜的模型,可以直接全面替換嗎?
應先用自家任務與相同工具比較。官方評測的題目、成功定義與執行配置,未必等同讀者的正式工作。
用相同任務核對品質與成本,再調整採用範圍
Databricks AI Index 適合幫助企業建立比較方法,尤其是已經同時使用多家模型、需要解釋預算差異的團隊。它最有用的提醒,是把模型、工具、任務與費用放在同一個決策裡。
先挑一種代表工作,記錄驗收結果、全部用量與人工修正,再決定是否改模型或分流。把公開數據留在自己的樣本與日期裡,才能讓研究資源成為採購依據,而不是另一張沒有適用條件的排行榜。
延伸閱讀:GitHub 公開 Copilot 模型評測:成功率之外,每題成本與推理設定怎麼選?
延伸閱讀:Zapier AI Workflow Index:代理成本為何達 2.1 倍,空轉檢查怎麼算?