決策模型怎麼做 LLM 評測?Hamel Husain 教你調門檻、比成本、讀分數
Hamel Husain 與 Antaripa Saha 用 98 筆客服對話測試六個決策模型,說明做 LLM 評測時,為什麼不能直接用預設的 0.5 門檻。本文整理門檻調整、80% 最低要求、成本、延遲與校準的數字,並標出樣本小、資料私有與作者利益等限制。

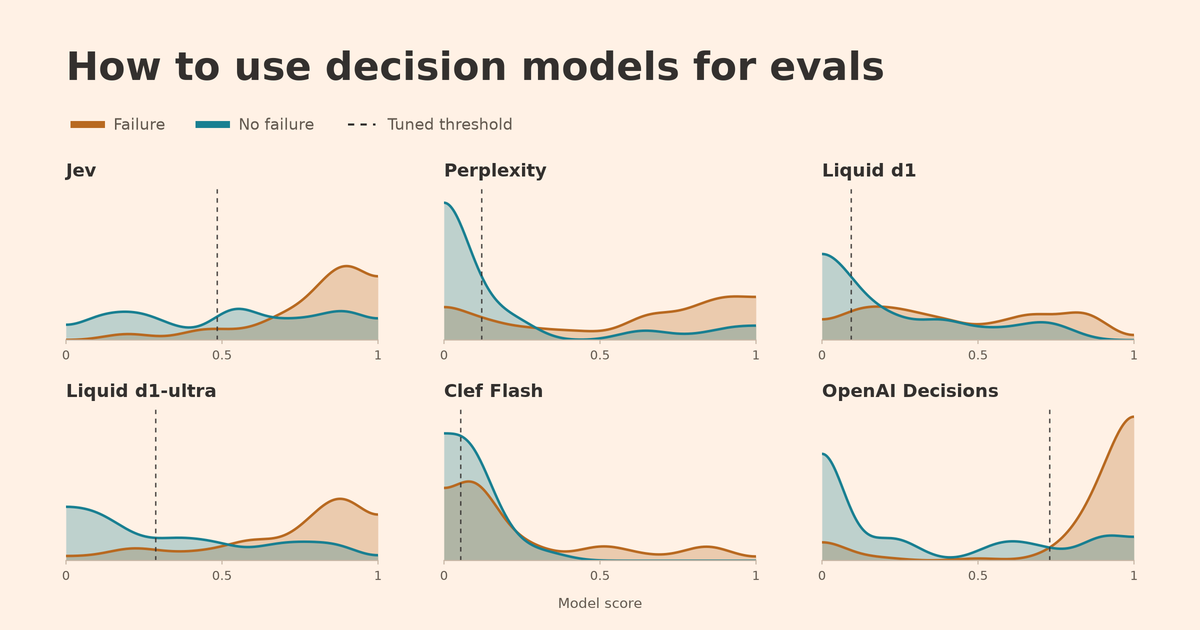
Hamel Husain 與 Antaripa Saha 在 2026 年 10 月 20 日發表新文章,教大家怎麼選決策模型、調整它的門檻,並讀懂它回傳的分數。
台灣時間 10 月 21 日凌晨,Hamel 在 X 上宣傳這篇文章,特別提醒不要以為預設的 0.5 就好用。這則貼文到 10 月 21 日晚間查詢時,有約 1,900 個讚、23 萬次瀏覽。
決策模型是一種小型模型,你給它一段內容加一個是非題,它直接回傳「是」的機率,不產生長篇回答。因為輸出短,所以便宜也快,很適合拿來當自動評測的篩選器。
過去做評測,常見做法是請大型語言模型當評審,寫一段提示詞,讓它判斷輸出合不合格。決策模型是這種做法的低成本替代方案。
但便宜不代表能直接上線。很多人拿到模型回傳的機率,就用 0.5 當分界,高於 0.5 算失敗,低於算通過。
文章用 98 筆真實紀錄展示,這個預設值對某些模型幾乎是災難。我從作者附的資料檔算出,Clef Flash 在 0.5 時,用全部 98 筆算的 F1 只有 0.35。F1 是綜合精準率與召回率的分數,越接近 1 越好。
調整門檻後,同一個模型在交叉驗證保留紀錄上的平均 F1 約 0.78。兩個數字的算法不同,所以只能看出大方向。
這些結果來自一個資料集、一種任務,作者自己也說,模型表現會隨任務與資料集大幅變動。另外,Hamel 開設付費的 AI 評測課程,文章頁面頂端就有招生橫幅,連到 Maven 上的課程,寫著 10 月 24 日前報名享 25% 折扣。
我的判斷是,已經有人工標好的失敗樣本、想把便宜分類器放進評測流程的團隊,這篇值得細讀。沒有標註資料、只想知道哪個模型最強的人,這些數字幫不上忙。
要看懂調門檻為什麼有用,得先看決策模型的分數怎麼變成通過或失敗。
決策模型怎麼拿來做評測?從機率分數到通過或失敗
每個決策模型都會對每一筆紀錄回傳一個 0 到 1 的分數,代表它認為這筆紀錄有失敗的機率。API 再用預設的門檻 0.50 把分數變成判決,分數大於或等於門檻就標成失敗。
這個轉換看似理所當然,其實是一個可以調整的設定。文章舉了一個例子,假設某個模型給所有失敗紀錄 0.40 分,給所有正常紀錄 0.10 分,那麼把門檻設在 0.30 就能完全分對,但預設的 0.50 一筆失敗都抓不到。
現實中分數會重疊。把門檻調低,能抓到更多失敗,但誤報也會增加,所以要在兩個指標之間取捨。
精準率是被標成失敗的紀錄裡,真的有失敗的比例。召回率則是所有真正失敗的紀錄裡,被抓到的比例。
兩者要怎麼取捨,要看你的後果。文章用了兩個比喻。刑事審判要求證據確鑿才定罪,重視精準率。癌症篩檢寧可多誤報也不想漏掉病人,重視召回率。
這次比較為了簡單,把兩者視為同樣重要,用 F1 當單一指標。F1 是精準率與召回率的調和平均,範圍從 0 到 1。
作者也建議用二元的通過與失敗來評測,而不是 1 到 5 分的評分,理由是標準比較明確,也比較容易和人工標註對齊。
如果你想了解決策模型本身,站內已有多篇介紹,包括 OpenAI 的版本與用它當評審的案例。
先看作者的實驗是怎麼設計的,才知道這些數字能推到多遠。
延伸閱讀:OpenAI Decisions API(應用程式介面)完整解析:用 Luna 做分類、路由與 Agent 下一步決策
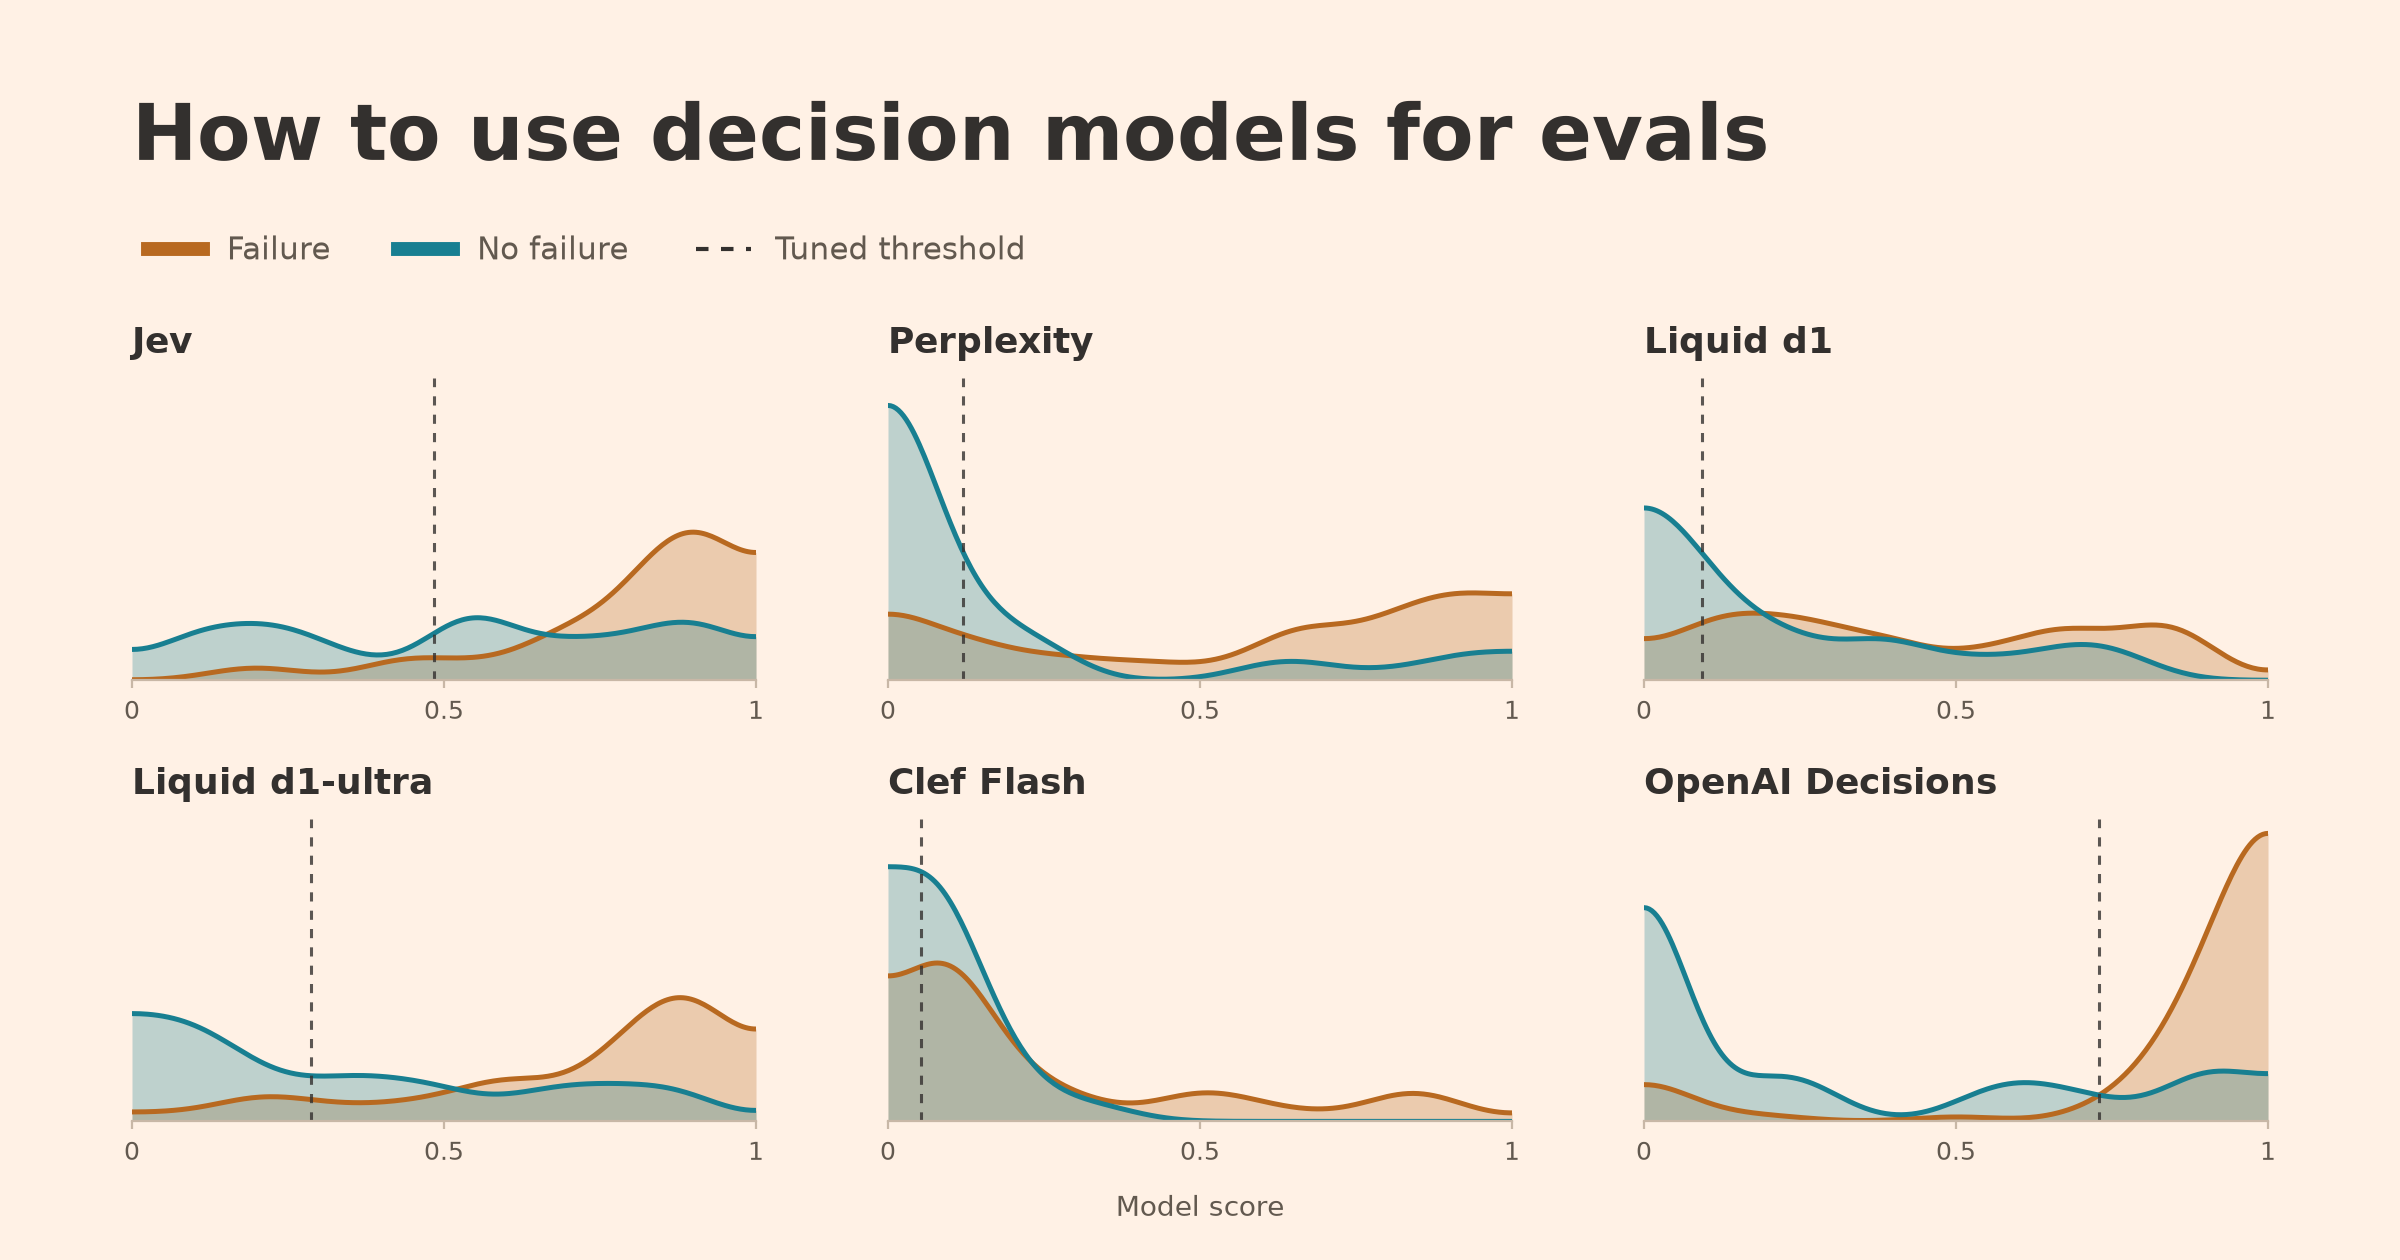
實驗設計:98 筆公寓客服對話與六個決策模型
實驗資料是一間公寓租賃客服代理的真實紀錄,原本有 100 筆,扣掉兩筆內部品質測試後剩 98 筆。紀錄包含對話、工具呼叫與工具輸出,任務是找出有錯誤的紀錄,例如訂房失敗,或該轉人工卻沒轉。
98 筆裡有 61 筆已知失敗,37 筆沒有標示失敗。這 61 筆中,39 筆來自原本的人工審查,另外 22 筆是 Braintrust 與 Arize 這兩個評測工具發現、再由作者人工確認。原始對話是私有的,沒有公開。
測試的模型共六個,版本如下。
| 模型 | 提供者 | 版本或說明 |
|---|---|---|
| Jev | TypeSafe | 1.13 |
| Perplexity Decider | Perplexity | 1.1 27B |
| Liquid d1 與 d1-ultra | Liquid | 兩種規格 |
| Clef Flash | Cloudflare | Flash 版 |
| OpenAI Decisions | OpenAI | 使用 GPT-6 Luna |
每個模型拿到相同的評估準則。Jev 因為介面不同,收到的是等價內容的結構化提示,其他模型拿到的是同一段文字提示。模型看到的紀錄都遮掉了人工標籤與審查筆記。
成本用實際的 token 用量乘以供應商價格計算。Liquid 的價格取自 10 月 17 日,d1 每百萬輸入 token 0.02 美元、d1-ultra 為 0.042 美元,作者把實驗當時記錄的 d1 成本依這個價格重算。
延遲因為受批次、併發與網路距離影響,作者沒有納入比較,只在註腳附上平均回應時間。
這個設計有一個明顯的限制:只有一個資料集、一種廣泛的「任何實質問題」任務。作者也說,把任務拆成一個失敗類型一個評審,模型之間的差距預期會縮小。
有了資料與限制,就能看門檻調整到底改變了什麼。
決策模型的門檻調整:同一個模型 F1 可以差一倍
作者用交叉驗證調門檻。交叉驗證是把資料切成幾份,輪流用一部分調參數、另一部分驗證,避免拿同一批資料既調又考。這裡用的是分層五等分,重複 20 次,共 100 個切分,門檻在訓練的紀錄上選,成績在保留的紀錄上量。
下表是我從作者公開的 chart-data.json 讀出的結果。預設欄是用 0.50 在全部 98 筆上的成績,調整後欄是交叉驗證保留紀錄的平均。兩欄的算法不同,所以只能看趨勢,不能逐位數比較。
| 模型 | 預設 0.50 的 F1 | 預設召回率 | 調整後 F1 | 調整後平均門檻 |
|---|---|---|---|---|
| Jev | 0.79 | 89% | 0.78 | 0.48 |
| Perplexity | 0.73 | 64% | 0.79 | 0.12 |
| Liquid d1 | 0.58 | 46% | 0.79 | 0.09 |
| Liquid d1-ultra | 0.80 | 80% | 0.79 | 0.40 |
| Clef Flash | 0.35 | 21% | 0.78 | 0.05 |
| OpenAI Decisions | 0.84 | 90% | 0.87 | 0.73 |
先看 Clef Flash,它在 0.50 只標出 13 筆,98 筆裡有 61 筆真的失敗,所以召回率只有 21%,調到約 0.05 才變成好用。Liquid d1 也是類似的情況。
若兩邊都用全部 98 筆算,Clef Flash 的 F1 從 0.35 升到最佳門檻約 0.055 的 0.80,差距更大。不過這是在同一批資料上挑門檻,會偏樂觀,所以上表才改用保留成績。
其次,最佳門檻的方向不一致。Perplexity、d1 與 Clef Flash 要往下調到 0.05 到 0.12 之間,OpenAI 卻是往上調到約 0.73。所以不能把某個模型的最佳門檻,直接搬給另一個模型。
最後,調整不一定變好。Jev 與 d1-ultra 的調整後 F1 反而略低於預設,我的解讀是預設剛好接近它們的最佳點,而交叉驗證的保留成績比較保守。作者自己也寫,候選模型從 F1 調整得到的好處,比 d1 與 Clef Flash 少。
交叉驗證的標準差在 0.005 到 0.018 之間,所以 0.02 以內的差距,我不會當成真正的差異。
如果你想自己做,作者在文中附了一段給程式代理的提示,要求它用已儲存的分數與標籤,做分層五等分交叉驗證,在訓練資料上選門檻,並回報保留資料的精準率、召回率與 F1,過程不再呼叫模型。
調出門檻以後,還要決定到底要多準才算夠。
延伸閱讀:JEV-as-a-Judge 是什麼?AI 評審省 277 倍,不確定時再交給 GPT-6
先設最低要求:80% 精準率與 80% 召回率
作者提醒,不要盲目最大化 F1。他的做法是先依用途設最低要求,例如把這個分類器放進自動告警,他會要求精準率與召回率都至少 80%,這樣誤報不會太多,也抓得到足夠的失敗。
依整份資料的精準率與召回率曲線,Perplexity、Liquid d1-ultra 與 OpenAI Decisions 三個模型可以同時達標,Jev、d1 與 Clef Flash 則不行。前三者就成為候選,只替它們限制門檻必須落在達標範圍。
可是這個限制並不穩。在 100 次訓練切分裡,Perplexity 有 36 次找不到同時達標的門檻,d1-ultra 有 29 次,只有 OpenAI 一次都沒有。找不到時,作者就退回用不受限的 F1 最佳門檻。
文章也寫明,最低要求只在選門檻時生效,不保證新資料也能達到。
我從 chart-data.json 讀到的保留成績,也印證了這一點。只有 OpenAI 的精準率與召回率同時超過 80%,分別約 0.87 與 0.86。Perplexity 與 d1-ultra 的召回率約 0.82,但精準率只有約 0.75 與 0.76。
這代表「達標」要看你怎麼量。如果你的需求是兩項都要 80%,便宜的候選模型在這份資料上不能保證做到,需要再用更窄的任務或更多資料驗證。
能不能達標之外,成本與延遲也會影響選擇。
成本與延遲:便宜的決策模型要換多少表現
成本以每 100 次評測的花費計。下表把成本、調整後 F1 與平均回應時間放在一起,回應時間是作者在另外的執行中量的,只能當參考。
| 模型 | 每 100 次評測成本 | 調整後 F1 | 平均回應時間 |
|---|---|---|---|
| Jev | 1.90 美分 | 0.78 | 4.33 秒 |
| Perplexity | 0.82 美分 | 0.79 | 7.85 秒 |
| Liquid d1 | 0.72 美分 | 0.79 | 7.38 秒 |
| Liquid d1-ultra | 1.52 美分 | 0.79 | 1.56 秒 |
| Clef Flash | 1.58 美分 | 0.78 | 2.09 秒 |
| OpenAI Decisions | 3.72 美分 | 0.87 | 2.77 秒 |
三個候選之間,Perplexity 最便宜,每 100 次 0.82 美分,F1 約 0.79。OpenAI 的 F1 約 0.87,但要 3.72 美分,大約是 4.5 倍的成本。
依作者的單價相乘,我換算一下,跑十萬次評測,OpenAI 約 37 美元,Perplexity 約 8 美元。這假設你的對話長度和這 98 筆差不多,因為成本是依實際用掉的 token 算的。
這個差距在小專案可以忽略,要天天跑大量評測才有感。
所以我的取向是,先看能不能達到最低要求,再看成本。如果便宜的模型連最低要求都達不到,省下來的幾美元就沒有意義。
延遲要特別小心。作者明說,這些平均時間來自各自獨立的執行,不能證明吞吐量或尾端延遲的高低。例如 d1-ultra 的平均 1.56 秒最快,但那是一次執行的平均,不代表在你的併發量下也是最快。
如果要把分數當成信心來用,還得多檢查一件事。
分數能當信心嗎?校準與 Platt scaling
如果你想把分數當成信心,例如 0.80 代表八成機率有失敗,就要檢查校準。校準的意思是,所有分數接近 0.80 的紀錄裡,大約要有八成真的失敗。
作者把每個模型的分數依高低分成五組,每組約 20 筆,畫出預測機率對上實際失敗率。點落在對角線上就是準,在線上方代表低估風險,在線下方代表高估。
結果差異很大。Clef Flash 有一組紀錄平均預測失敗機率約 8%,實際卻有 60% 失敗。Jev 與 d1-ultra 在這份資料上本來就校準得不錯,不太需要調整。
調整的方法是 Platt scaling,它用已標註的紀錄,先把分數換成對數勝算這種容易調整的刻度,再擬合一條 S 形曲線,把原始分數換成較準的機率。Perplexity、d1 與 Clef Flash 調整後都更接近對角線。
但它不是萬靈丹。OpenAI 的機率在這個版本的調整後略差。評分用的是 Brier 分數,它是機率誤差的平方平均,越低越好,OpenAI 從 0.159 變成 0.164,Jev 與 d1-ultra 則幾乎不變。
作者另做了一個探索性的重新擬合,直接在機率上做,OpenAI 的 Brier 分數降到 0.154,說明結果對擬合方式很敏感。
所以只做通過與失敗的判定,調門檻就夠了。要拿分數排序或分流,就得先檢查校準,並實際量過調整有沒有改善。
把這些結果收攏起來,就能整理出一份可以照著做的流程。
決策模型評測的檢查清單:適合誰、不適合誰
作者在結尾整理的流程,我改寫成可以直接照做的檢查清單。
- 先把評審提示寫好,再依用途設定最低精準率與召回率,達不到的模型直接剔除。
- 比較表現之前,先對每個模型調整門檻,並在沒用來調整的紀錄上量成績。
- 如果要把分數當信心,就檢查機率和實際結果對不對得上,校準後再量一次。
- 同時看表現、成本與延遲,而且用自己的資料,因為不同任務的差距會變。
- 這個流程會反覆,提示改了,就要重新調門檻、重新檢查校準。
適合的人是已經有一批人工標好的失敗樣本,而且評測量大到成本與速度有意義的團隊。作者建議,先用表現可接受的大模型,再試小模型能否持平。
不適合的人也很清楚。完全沒有標註資料的團隊,沒辦法調門檻也沒辦法驗證。我認為任務很窄的評測,直接寫規則可能更簡單。
這份流程能用到多大範圍,取決於這項研究本身有哪些限制。
這項研究的限制與利益關係
首先是樣本小。98 筆、61 筆失敗,只能當粗略的估計,文章自己也說,校準圖只是這個小樣本的摘要,無法決定未來一筆紀錄的確切失敗率。
其次是資料與標註。對話是私有的,沒有公開,所以外人無法重跑完整實驗,只能看作者公布的分數與標籤。22 筆失敗是由工具找出、作者人工確認,標註品質會影響門檻。
再來是任務太廣。作者刻意把任務設為「任何實質問題」,好讓模型差異明顯,但他也預期,換成單一失敗類型後,差距會縮小。
價格與版本也有時效。Liquid 價格取自 10 月 17 日,模型版本寫在文中,之後調價或更新,結果可能改變。
最後是利益關係。Hamel 經營付費的評測課程,這篇文章是他的個人部落格,頁面上有課程的招生橫幅。這不表示內容有誤,但讀者要知道這個脈絡。
我沒有重跑這個實驗,以上都是依作者公開的文章與資料整理,其中標明「我讀出」的數字,是我從他的 JSON 檔案整理的,口徑以原文為準。
決策模型評測常見問題
決策模型和 LLM 評審差在哪?
LLM 評審是用提示詞請大模型寫判斷,輸出較長、較貴。決策模型直接回傳是非題的機率,輸出短、成本低,但需要你自己決定門檻。兩者適合的工作不同,作者建議先用大模型確認可行,再試小模型。
預設的 0.5 門檻一定不好嗎?
不一定。在這份資料上,Jev 與 d1-ultra 的預設就接近最佳。但 Clef Flash 與 d1 在 0.5 時漏掉大半失敗,所以要先檢查,不能假設。
要多少標註資料才能調門檻?
文章沒有給最少筆數。它用 98 筆搭配五等分交叉驗證示範,並提醒小樣本只能當估計。實務上標註愈多,調出的門檻愈穩,但這是一般統計常識,不是作者的數字。
可以直接用文章的提示請程式代理幫我調嗎?
可以參考,但要保留已存的分數與標籤,固定資料切分,並要求代理不要重新呼叫模型。結果出來後,仍要自己檢查有沒有切分洩漏,也就是用來調整的紀錄混進了評分的紀錄。
先設最低要求再調門檻,是用決策模型評測的第一步
這篇文章最實用的提醒是,決策模型的分數要經過門檻與校準,才能變成可靠的評測結果。預設值只是起點,在你的資料上可能差很多。
建議先挑一個失敗類型,標一百筆左右的樣本(文章示範也用約這個規模),設好最低精準率與召回率,再用兩三個模型各調一次門檻。在這份資料上,最便宜的選項並沒有同時達到最低要求,可見要選的是能穩定達標的那一個。
想持續追蹤 AI 評測與決策模型的實用更新,可以免費訂閱 AI 郵報,並在採用前回到原文與資料檔核對數字。
資料來源
- Hamel Husain 與 Antaripa Saha:How To Use Decision Models for Evals:https://hamel.dev/blog/posts/decision-model-evals/
- 文章附的圖表資料 chart-data.json:https://hamel.dev/blog/posts/decision-model-evals/charts/chart-data.json
- 門檻選擇稽核資料 threshold-selection-audit.json:https://hamel.dev/blog/posts/decision-model-evals/charts/threshold-selection-audit.json
- 校準資料 calibration-reliability-data.json:https://hamel.dev/blog/posts/decision-model-evals/charts/calibration-reliability-data.json
- Liquid AI 定價頁:https://www.liquid.ai/pricing
- OpenAI Decisions 指南:https://developers.openai.com/api/docs/guides/decisions
- X 貼文(Hamel Husain,經 fxtwitter 鏡像讀取):https://x.com/HamelHusain/status/2112588257104216294