醫師在 X 主張 AI 可取代診斷開藥:觸診、同理與法律責任,卡在哪一關?
一位精神科醫師在 X 主張 AI 已能取代醫師診斷與開藥,只差法律責任未釐清,外科醫師則以觸診反駁。本文對照同理心研究、民眾使用實驗與猶他州 AI 續藥試點,分開整理事實與推論。

一位醫師在 X 上寫下:AI 能不能取代醫師診斷、開藥與追蹤用藥?他的答案是「絕對可以」。
發文者 Bhooshan Shukla 在簡介中自稱兒童與青少年精神科醫師,貼文 10 月 9 日發出。
他認為 AI 遲遲沒有接手,主因是法律責任還沒釐清,而不是能力不足。
另一位在簡介自稱外科醫師的 Amit Thadhani 隨即反駁:AI 沒辦法做身體檢查,連家醫科都還取代不了。
兩人的意見都屬個人看法。要判斷哪一邊站得住,得把能力、互動與責任三件事分開看。
我的判斷是,法律責任確實影響 AI 能否上線,但現有研究也顯示真人使用有落差,能力問題還不能直接跳過。
本文整理公開研究與政策試點,不提供任何醫療建議,身體不適請諮詢合格醫療人員。
支持方:能力夠了,卡的是誰負責
Shukla 的論點分三步。第一,AI 已能判讀檢查、診斷與開藥。第二,它比真人醫師更好也更安全。
第三步才是重點。他指出醫療出錯時由醫師負責,而 AI 的責任歸屬目前並不清楚,大企業也傾向避開這類風險。
所以他說,現在要求「人類在迴路中」,也就是保留真人把關,很多時候是為了有人承擔責任。
他在後續貼文預測,五年內臨床試驗會證明 AI 出錯率遠低於醫師,業者再遊說把疏失賠償改成固定金額。
這是個人推測,貼文沒有附上資料佐證。
支持方常引用的另一項證據,是 AI 的回答聽起來比醫師更有同理心。
同理心研究,能證明 AI 比醫師好嗎?
2023 年《JAMA Internal Medicine》一項研究,從 Reddit 健康問答版抽出 195 個問題,比較醫師與 ChatGPT 的回覆。
醫療專業人員匿名評分後,78.6% 的評估偏好聊天機器人,被評為有同理心的比例是 45.1% 對 4.6%。
不過研究者也指出,醫師回覆平均只有 52 個英文字,聊天機器人約 211 個,篇幅差距很大。
作者的結論是值得在臨床情境進一步研究,例如讓 AI 先擬稿、再由醫師修改。
而另一項更晚的研究顯示,模型本身答得好,不代表民眾用起來也會好。
反方:觸診與互動,測驗分數看不到
Thadhani 的反駁集中在身體檢查。他認為只靠病史與報告,可能把判斷帶往錯誤方向。
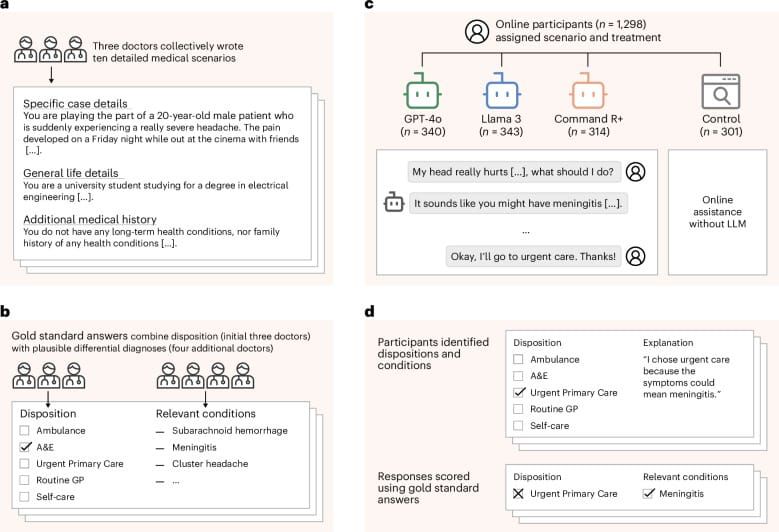
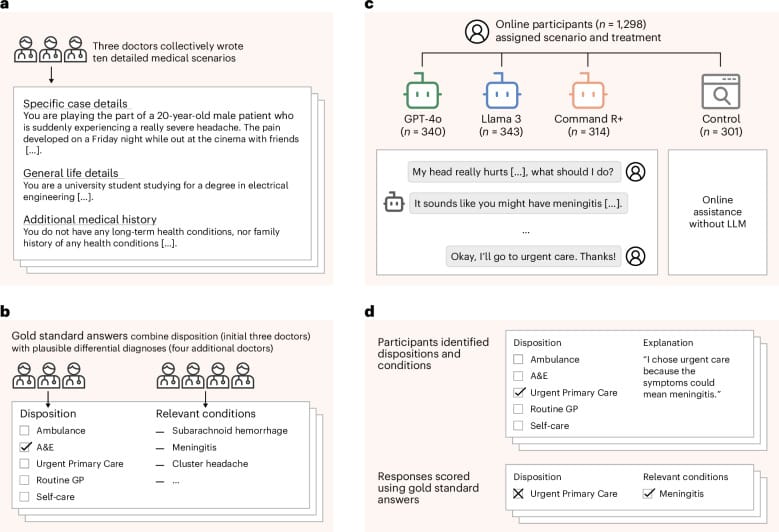
2026 年 2 月刊登於《Nature Medicine》的牛津研究,讓 1,298 名英國民眾面對十個醫療情境。
模型單獨作答時,九成以上能找出相關病症。但民眾實際和同樣的模型對話後,找出相關病症的比例低於 34.5%,表現沒有比可自行選擇查資料方式的對照組好。
實驗中,每位參與者拿到的是模擬情境,並非實際病患看診。這能比較相同任務下的互動差距,但不能直接算出醫院裡的誤診率。
研究者檢查對話後,發現有人沒有把完整症狀告訴模型,也有人沒採納模型提出的相關病症。即使答案曾經出現,使用者也不一定能辨識並做出正確決定。
研究團隊認為,問題出在人與模型的互動。他們建議醫療 AI 對大眾開放前,先做系統性的真人使用測試。
能力與互動之外,最後一道關卡就是 Shukla 所說的責任。
猶他州試點:法律責任怎麼落地
美國猶他州透過「監理沙盒」核准新創 Doctronic 用 AI 續開既有處方。監理沙盒指在限定範圍內暫時放寬法規的試驗機制,並非讓所有 AI 都能行醫。
州政府的試點文件限定,AI 只能處理持照醫療人員原本開立的藥,不能開新處方、調整劑量或更改治療計畫。病人也必須先完成身分與原處方核驗。
試點限定核准清單內的既有藥物,管制或成癮性藥物不在允許範圍。清單是一道界線,不能把續藥試點解讀成一般診斷與開藥都獲准。
州政府更新規則後,每個藥物群組須先累積 250 筆續藥,才有資格申請進入第二階段。第一階段要在交給藥師前由醫師審查,轉階段也仍需主管機關核准。
責任制度也沒有只剩一張保單。州政府說明,每筆續藥都有持照醫師掛名,無論是親自批准,或依核准的 AI 流程簽發,仍是醫療人員開出的處方。
業者須維持涵蓋 AI 風險的醫療疏失保險,藥師遇到疑問也能直接找公司的醫師處理。AI 可以協助作決定,卻沒有因此切斷真人負責的鏈條。
州政府並在官網提供醫療執照委員會要求暫停的信件與回覆,爭議仍在持續。這個試點測的是狹窄範圍的行政與醫療流程,尚不能證明 AI 足以全面取代醫師。
常見問題
AI 已經可以自己開藥了嗎?
在猶他州試點中,AI 只能續開醫師原本開立的部分慢性病藥物,並有醫師審查與排除清單,不能開立新診斷的處方。
同理心研究代表 AI 比醫師更有溫度嗎?
那項研究比較的是論壇上的文字回覆,醫師回覆明顯較短,不能直接推論到面對面看診。
民眾可以用聊天機器人代替就醫嗎?
《Nature Medicine》研究顯示民眾使用模型的判斷並未優於對照組。身體不適仍應諮詢合格醫療人員。
結語
AI 在測驗中的表現,已經足以讓醫師公開辯論取代的可能。要讓這項取代主張成立,仍需證明真人使用的安全性,並建立能處理錯誤的責任制度。
延伸閱讀:Google AMIE 研究刊登《Lancet》:AI 先問診,90%診斷數字該怎麼讀?
延伸閱讀:美國猶他州讓 AI 續開精神科藥物:19 美元、無需醫師,全美首例實驗引發爭議