Judith Dada 畫出 AI 能力地圖:為何判斷推理已超越人類,記憶仍落後?
投資人 Judith Dada 在 X 發布前沿 AI 能力雷達圖,認為數學與推理已超越熟練人類,長期記憶與即時學習仍落後。本文整理 12 項能力與成本圖,以及方法限制與網友質疑。

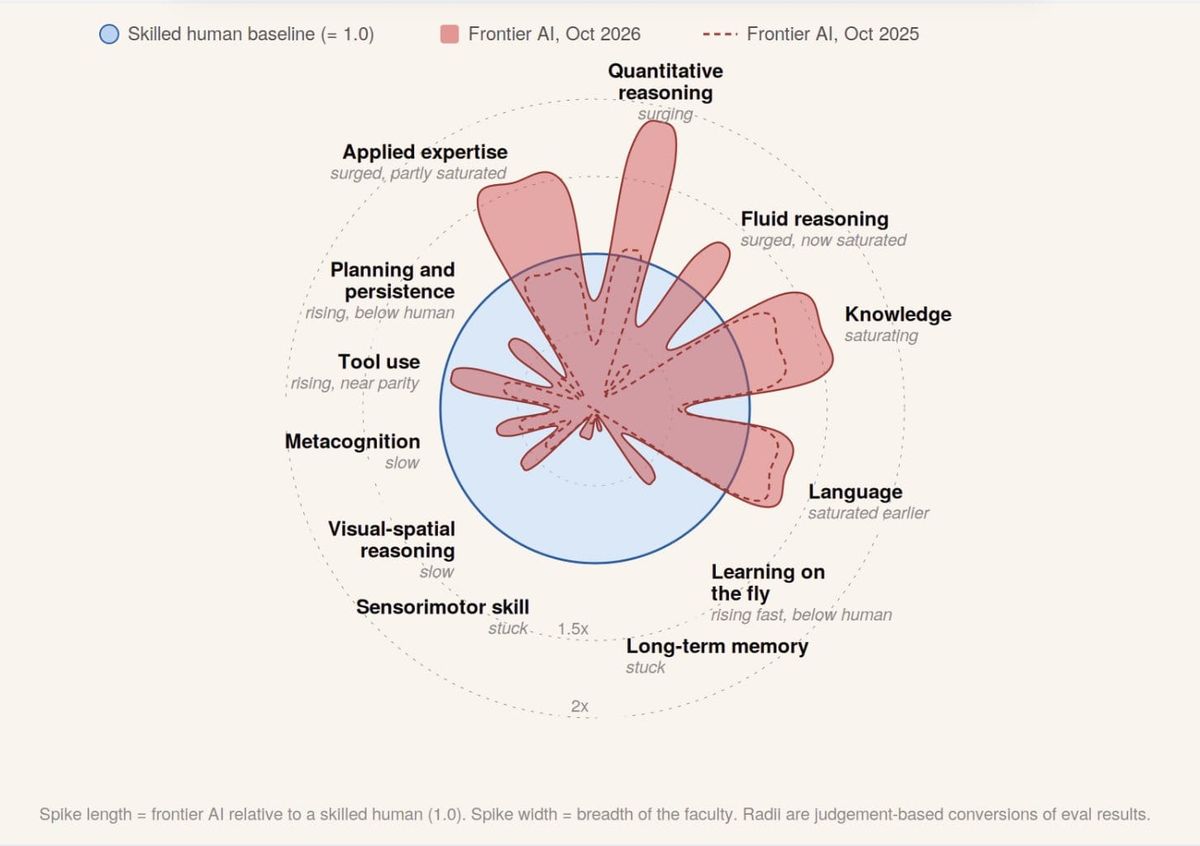
AI 現在到底有多強?一張像珊瑚的雷達圖,最近在 X 上累積超過 27 萬次瀏覽。
作者 Judith Dada 在個人簡介中寫自己是 Langdock 共同執行長,也是創投 visionaries.vc 的資深合夥人。
她比較 2025 年 10 月與 2026 年 10 月的前沿 AI,結論是 AI 變得更「尖」,而不是更「圓」。
意思是強項越來越強,弱項卻沒有跟著補上。她用一句話總結:AI 是超人等級的專家,卻不太會管理自己。
我認為這張圖適合當成理解 AI 強弱的入門地圖,前提是先知道它的數字來自作者判斷,不是正式測驗分數。
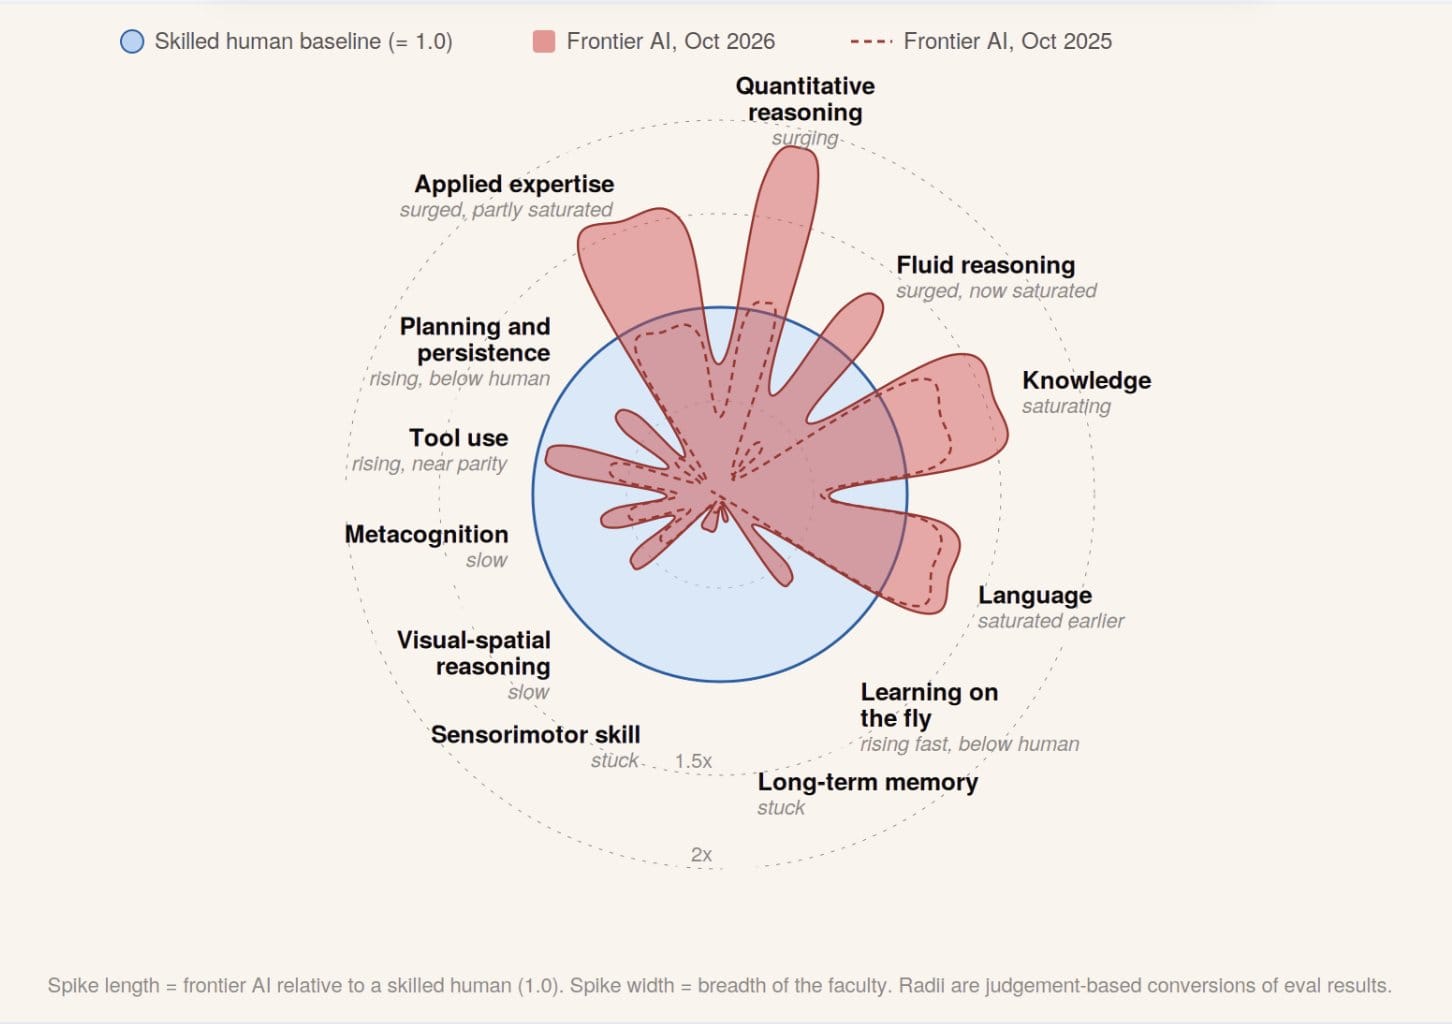
這張雷達圖量的是什麼?
圖中藍色圓圈代表熟練人類的基準,設為 1。紅色尖角往外伸越長,代表前沿 AI 在該項能力超越人類越多。
尖角的寬度代表這項能力涵蓋的範圍。虛線則是一年前的位置,用來看進步幅度。
圖下的小字寫明,半徑是「依評測結果所做的判斷式換算」。也就是說,作者參考了各種測驗,再自行換算成圖上的長度。
在這兩則貼文中,她沒有附上完整評測清單與換算方式。所以這張圖適合看方向,不適合拿來比精確倍數。
圖把不同任務放在同一個人類基準周圍,能幫讀者注意落差,但並未交代每個尖角對應哪款模型或哪種工作。把尖角面積加起來,也得不到可取代多少人的結論。圖的用途是拆開各項能力,看清強項之外還缺什麼。
強項與弱項:12 項能力一次看
Dada 在圖上標了 12 項能力,以及各自過去一年的變化。流體推理是遇到陌生問題時找出規律,後設認知是知道自己哪裡不懂、何時應該檢查,即時學習則是邊工作邊學會新東西。
下表依她的標註整理,相對人類的位置同樣屬於作者對評測的解讀:
| 能力 | 圖上標註 | 相對熟練人類 |
|---|---|---|
| 量化推理 | 快速上升 | 超越 |
| 應用專業知識 | 大幅上升,部分飽和 | 超越 |
| 流體推理 | 大幅上升,已飽和 | 超越 |
| 知識 | 接近飽和 | 超越 |
| 語言 | 較早就飽和 | 超越 |
| 工具使用 | 上升,接近人類 | 接近 |
| 規劃與堅持 | 上升 | 低於 |
| 即時學習 | 快速上升 | 低於 |
| 後設認知 | 緩慢 | 低於 |
| 視覺空間推理 | 緩慢 | 低於 |
| 感覺運動技能 | 停滯 | 低於 |
| 長期記憶 | 停滯 | 低於 |
從表中可以看到,落後的多半是「長時間獨立做事」需要的能力,例如記住前情、自我檢查與持續規劃。
Dada 認為這些缺口不是預算問題。她寫道,人類等級的記憶、自我監控與長期規劃,目前花再多錢也買不到。
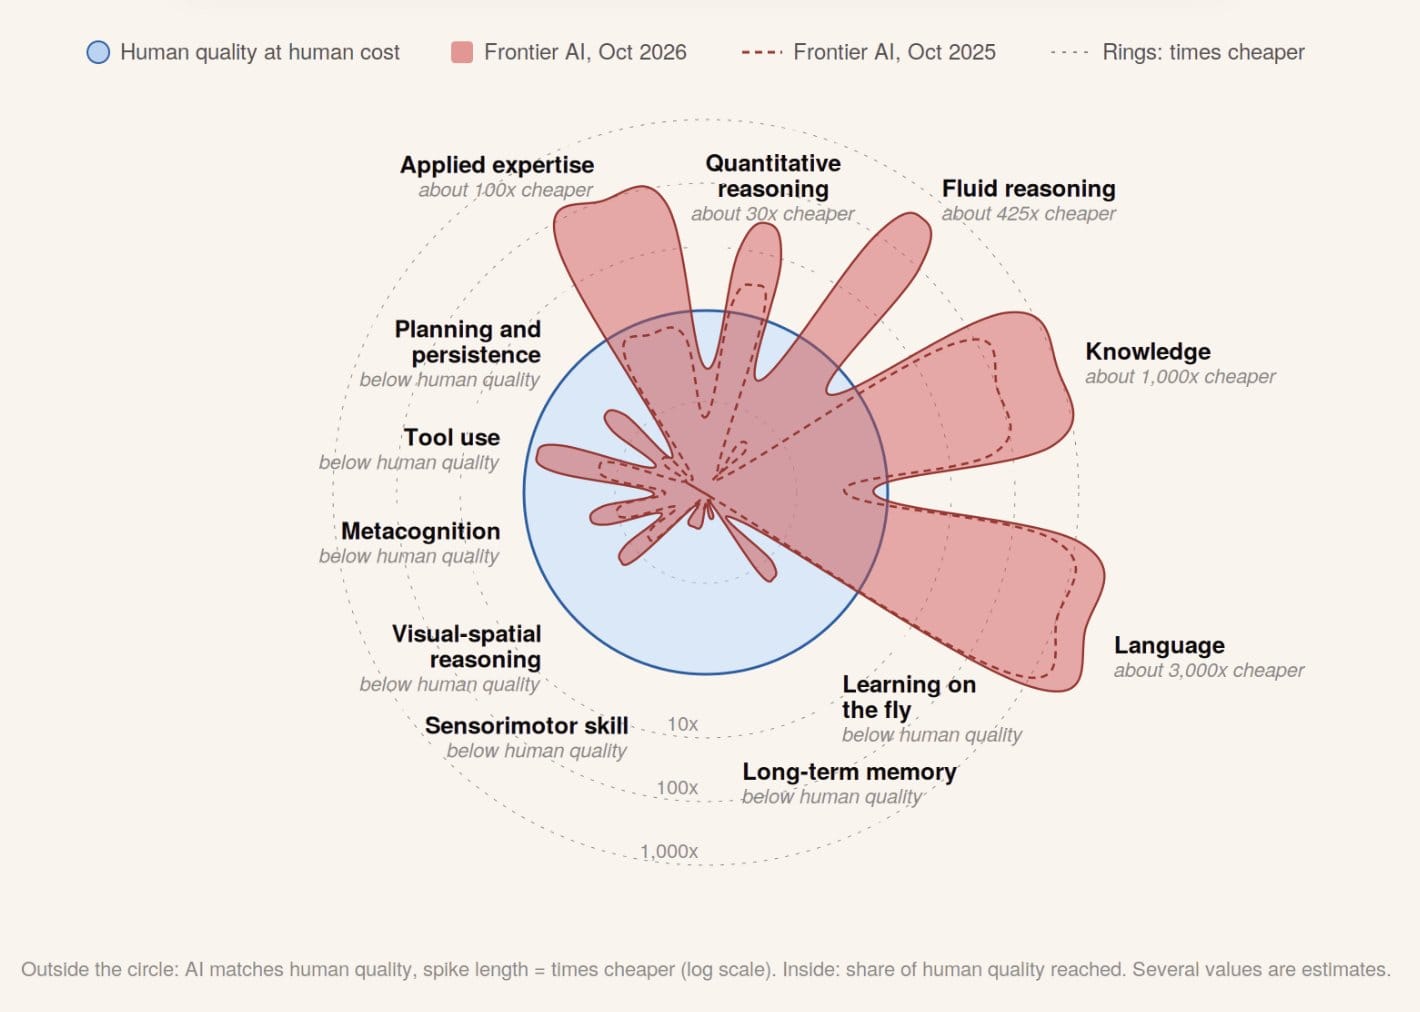
能力之外,她還畫了第二張圖,比較的是價格。
成本圖:一旦超越人類,價格就快速下滑
第二張圖把「達到人類品質」後的成本差距畫成倍數。依她的估計,語言約比人類便宜 3,000 倍,知識約 1,000 倍。
流體推理約便宜 425 倍,應用專業知識約 100 倍,量化推理約 30 倍。其餘 7 項則標示為尚未達到人類品質。
她的觀察是幾乎沒有中間地帶。能力一跨過人類水準,成本常常很快降到人類的百分之一以下。
即使能力不再進步,價格仍會繼續下降。她舉的例子是語言與知識看起來已經飽和,價格卻還在掉。
圖下同樣註明,部分數值是估計。這些倍數適合用來理解趨勢,不能當成採購報價。
網友質疑與經濟學家的解讀
這張圖也引來不少反駁。有人認為新模型在視覺空間推理進步很大,圖上低估了。Dada 回覆歡迎提供基準測試,並表示會更新。
也有人批評尖角之間的凹陷畫得太深,讓 AI 看起來比實際更參差。她承認這是合理批評,並另外貼出修正版的扇形圖。
經濟學家 Robin Hanson 則引用這張圖表示,如果趨勢延續,AI 會自動化部分、而非全部人類工作,經濟仍會留在我們熟悉的樣貌。
「參差前沿」這個說法,最早來自 2023 年哈佛商學院等學者與 BCG 合作的實驗。
實驗中 758 名顧問使用 GPT-4 後,在 AI 能力範圍內的任務多完成 12.2%,範圍外任務答對的機率則比未使用 AI 的組別低 19%,這是相對差異,並非直接少 19 個百分點。
實驗說明的是特定顧問任務與 GPT-4 的搭配,不能替 Dada 的 2026 年能力倍數背書。但它提供了一個讀圖的方向:同樣的工具,在不同任務上可能幫忙,也可能讓答案變差。
三年後,Dada 的圖把同一個概念從單一任務放大到整體能力。要用在工作上,仍得回到自己要完成的任務,檢查是否有相應證據。
常見問題
這張圖的數字可以直接引用嗎?
不建議當精確數據。作者註明半徑是依評測結果做的判斷式換算,部分數值是估計,也未公開完整方法。
AI 推理超越人類,代表可以取代專家嗎?
依這張圖的判斷,長期記憶、規劃與後設認知仍低於人類,長時間獨立工作仍需要人設定目標與檢查結果。
為什麼記憶和即時學習特別難?
Dada 認為這不是花錢就能解決的缺口。她沒有說明原因或提出時程。回覆區有人主張需要新的模型架構,這屬於網友意見。
結語
這張圖最有用的地方,是提醒我們別用「AI 有多聰明」一個數字來看事情。挑選 AI 工具時,先問任務需要的是推理與知識,還是記憶與長期規劃,會比看總分更準。
延伸閱讀:AI 十年內替代 5% 任務?Acemoglu 觀點再掀討論,別把任務比例當失業率
延伸閱讀:OpenAI 與 Ironclad 測試 AI 操作企業軟體:11 項任務仍需人工把關