LMGame 偵探遊戲實驗:大模型當福爾摩斯、小代理群蒐證,96/100 能說明什麼?
LMGame 團隊用自製福爾摩斯遊戲測試 AI 分工,大模型帶 12 個小代理破案 96/100,每案 0.58 美元。本文說明遊戲怎麼設計、比較了誰,以及這個數字能代表與不能代表什麼。

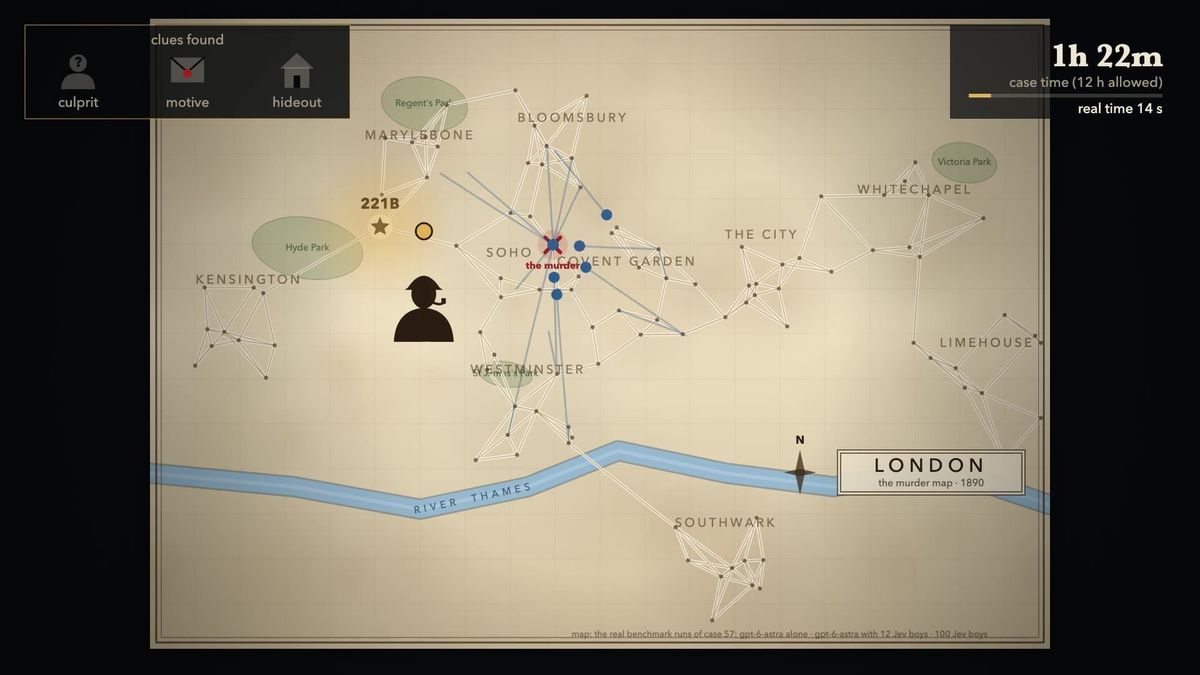
一個大模型單打獨鬥,和一群便宜的小代理一起辦案,哪一種比較會抓兇手?
LMGame 團隊 10 月 11 日在 Reddit 與部落格公布實驗,用一款自製的福爾摩斯偵探遊戲測試這個問題。
其中一組讓大模型當福爾摩斯坐鎮指揮,12 個小代理在城裡跑腿蒐證。它在 100 個案件中破了 96 件,每案成本約 0.58 美元。
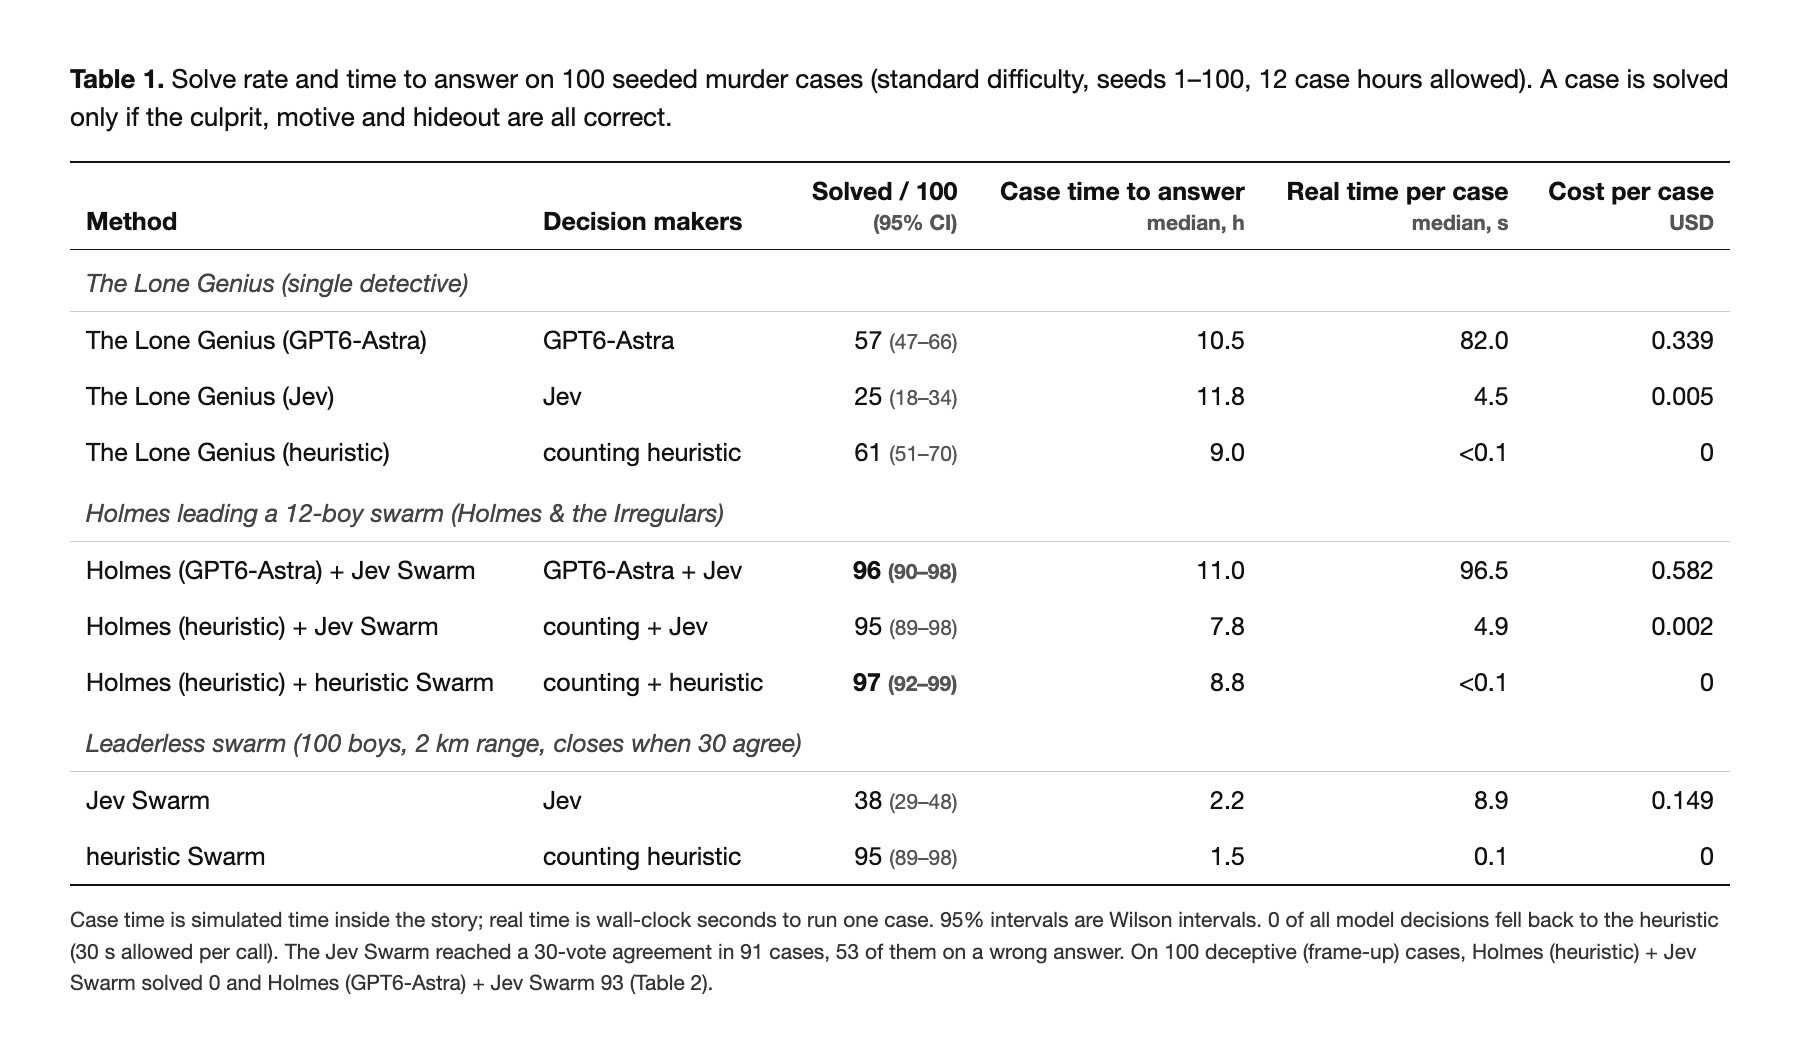
單靠大模型只破 57 件,沒有領導者的小代理群則破了 38 件。
我認為這個實驗的價值在於拆開「蒐證」與「判斷」,它說明的是分工的設計方式,還不能當成 AI 偵探能力的通用排名。
這款偵探遊戲怎麼設計?
遊戲名為 The Irregulars,取材自柯南.道爾的《血字的研究》與《四簽名》。每個案件由程式隨機生成一座維多利亞時代的倫敦。
城裡有 100 個地址與 10 名嫌犯,每個地址藏著一條線索,可能是證人、腳印、無關的干擾,或是謊言。
偵探必須在故事中的 12 小時內,同時說對兇手、動機與藏身處,才算破案。故事時鐘與電腦執行秒數不同,表格分開列出,不能把 12 小時當成真人等待時間。
扮演福爾摩斯的是 GPT6-Astra。跑腿的小代理用的是 Jev,這是 TypeSafe 的決策模型,專門回答選擇題、是非機率與評分這類固定格式的問題。
主角組合是福爾摩斯留在貝克街規劃,12 個 Jev 代理徒步查訪後回報。
對照組之一是大模型自己搭馬車挨家拜訪,最多 20 次。另一組是 100 個 Jev 代理沒有領導者,彼此分享線索,30 個代理投出相同答案就結案。
結果:模型分工勝過單打獨鬥,純規則得分更高
在 100 個標準案件中,大模型帶小代理群破了 96 件。單獨大模型破 57 件,每案約 0.34 美元。
無領導者的 Jev 小代理群每案實際執行時間的中位數約 9 秒,成本約 0.15 美元。但它在 91 個案件達成共識,其中 53 件選錯答案。
團隊的解釋是,少數代理讀錯線索後,鄰近代理跟著投票,錯誤在被檢查前就擴散了。
單獨的大模型推理能力不差,問題是跑不完城市。給它兩倍時間與拜訪次數後能破 91 件,但會超過 12 小時期限。
規則基準的表現同樣關鍵。只會數線索的程式當福爾摩斯,搭配 Jev 代理也能破 95 件,成本幾乎是零。
若連跑腿的代理也改用規則,標準案件能破 97 件,還高於大模型帶 Jev 的 96 件。表中的「最強組合」因此取決於拿哪些方法比較,不能只看模型組。
原因在遊戲設計:標準案件中,每條真相出現在兩個地址,每個謊言只出現在一個,所以數票數就能找到答案。
這也讓成本差異更有意義。大模型帶 Jev 每案 0.58 美元,規則帶 Jev 約 0.002 美元,純規則為零。這些是表列的模型呼叫費,不代表執行電腦與開發程式完全不用錢。
為了測出真正需要判斷的情境,團隊另外設計了「栽贓案件」。
栽贓案件:證人說謊時,才看出大模型的用處
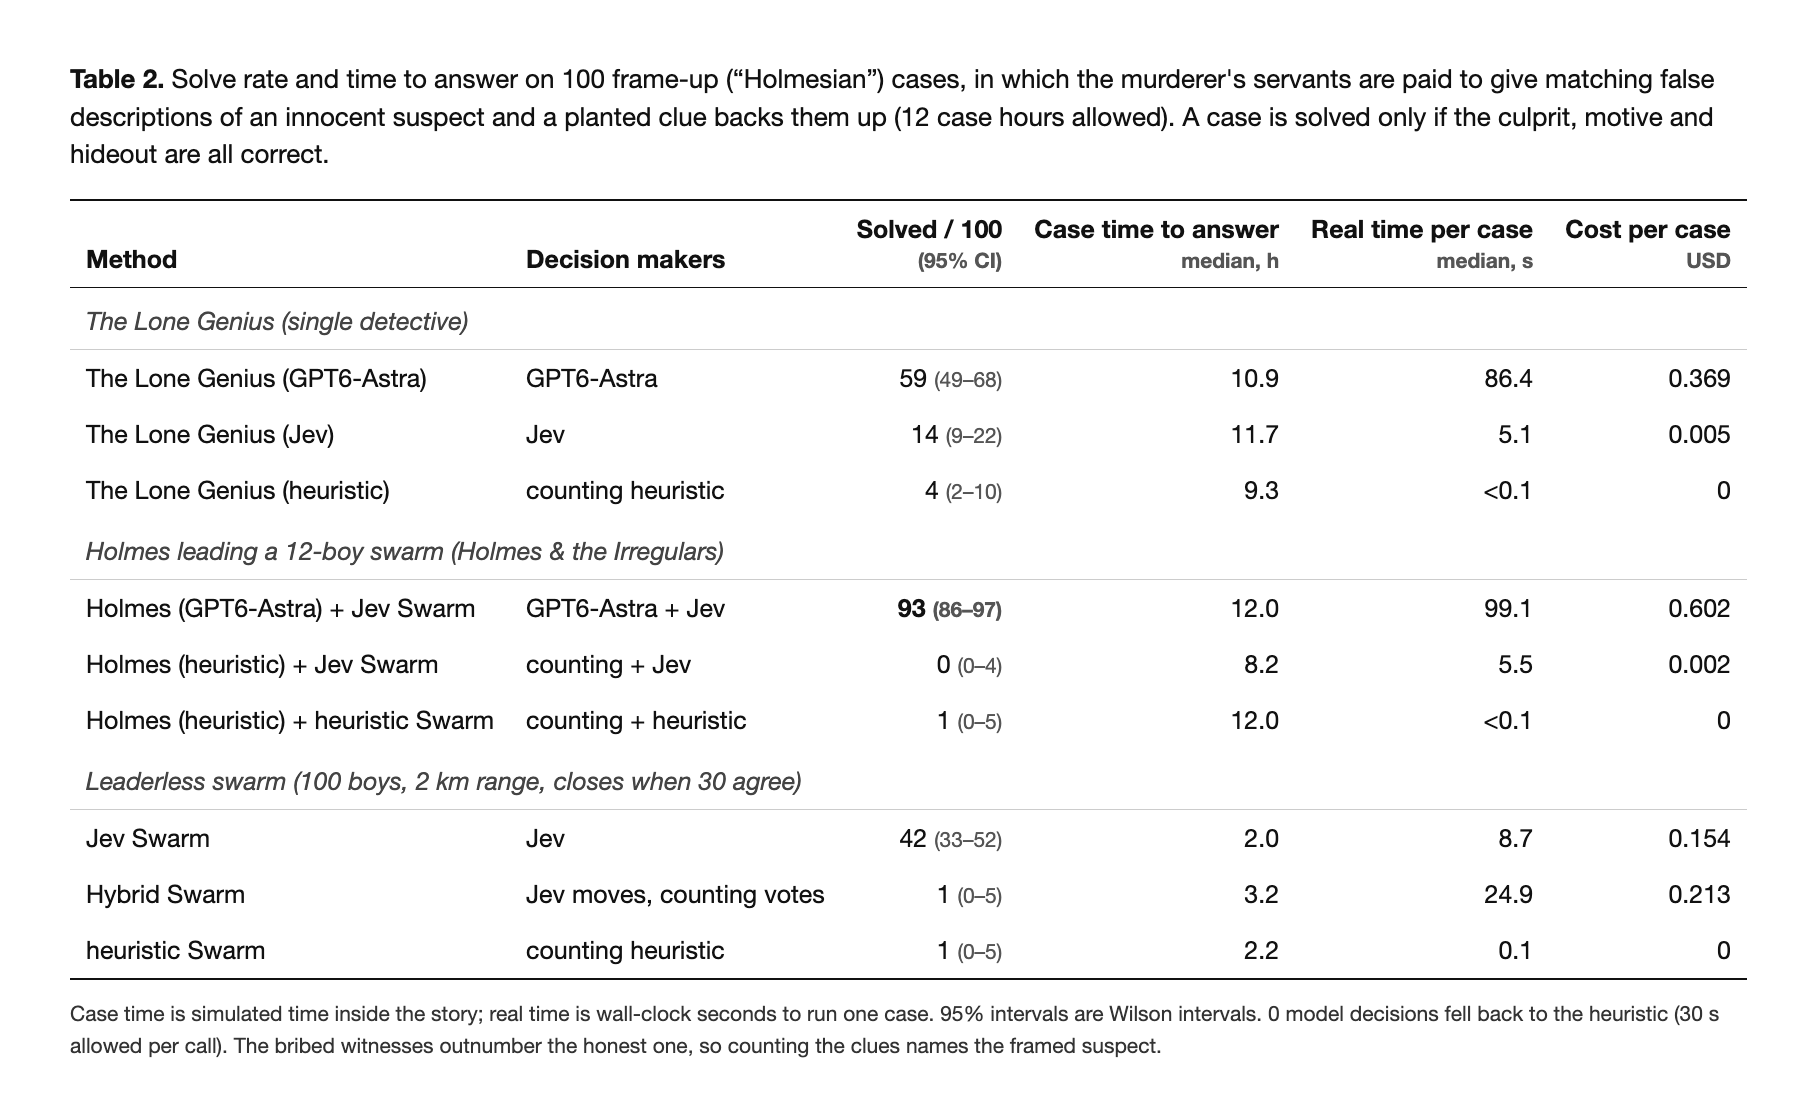
栽贓案件裡,兇手收買僕人描述一名無辜嫌犯,還放了假證物。謊言出現的次數比真相多,只有兩名誠實證人看見收買過程。
這時只會數票的規則版福爾摩斯一件都破不了,因為它會跟著說謊的多數走。
大模型帶小代理群仍破了 93 件,每案約 0.60 美元。團隊說,大模型會追問證詞來自誰、對方有什麼理由。
這組對照支撐了團隊的結論:證據誠實時,簡單規則就夠,證據互相矛盾時,才需要強的推理者坐在中心。
這個基準不能代表什麼?
首先,這是團隊自建的遊戲,並非經過同儕審查的論文。案件由程式保證可解,和真實調查的雜亂程度差很多。
其次,模型選擇以 GPT6-Astra 與 Jev 為主,沒有跨多款大模型與小模型重做對照。結果比較能說明這類任務的結構,不能推論其他模型也有同樣表現。
團隊的技術文件也列出限制,包括說謊者的行為模式很簡單,以及 Jev 在同一案件重跑時答案會變動。
大模型的成本是依公開牌價估算,換供應商或改變快取設定,金額都會不同。
對想設計代理流程的人,這裡還有一個可重跑的問題:把模型換成規則後,哪一種案件才開始失敗?先找到這條界線,才能判斷推理模型的額外成本是否有用。
常見問題
Jev 是什麼?
Jev 是 TypeSafe 推出的決策模型,回答的是固定格式的判斷題,例如從選項中挑一個或給出是非機率,適合大量、快速的小決定。
96/100 代表 AI 能辦真實刑案嗎?
不能。這是程式生成、保證可解的遊戲案件,線索數量與說謊方式都經過設計,和真實調查差距很大。
想自己重跑實驗可以嗎?
程式碼已公開在 GitHub,規則型玩家不需要 API 金鑰,也就是呼叫模型服務的授權碼,就能執行。使用 Jev 與大模型則要自備金鑰並負擔費用。
結語
這個實驗最實用的啟示,是先判斷任務的難點在蒐證還是判斷。證據乾淨時用便宜規則就好,證據會說謊時,再把大模型放在最後拍板的位置。
延伸閱讀:Jev 模型是什麼?新手完整教學:3 種判斷類型、程式實作、適合場景與限制
延伸閱讀:100 個 Gemini 代理合作解題,為何出現作弊與檢舉?讀懂代理群體實驗