EAGLE-4 是什麼?貼文稱 Qwen3.8-27B 達 961.6 tokens/s 的條件與授權
EAGLE-4 是 EAGLE 團隊在 2026 年 10 月 20 日公開的推測解碼新版,貼文稱 Qwen3.8-27B 達 961.6 tokens/s。本文對照論文、倉庫數字與授權條款,說明這個速度的測試條件與導入前限制。

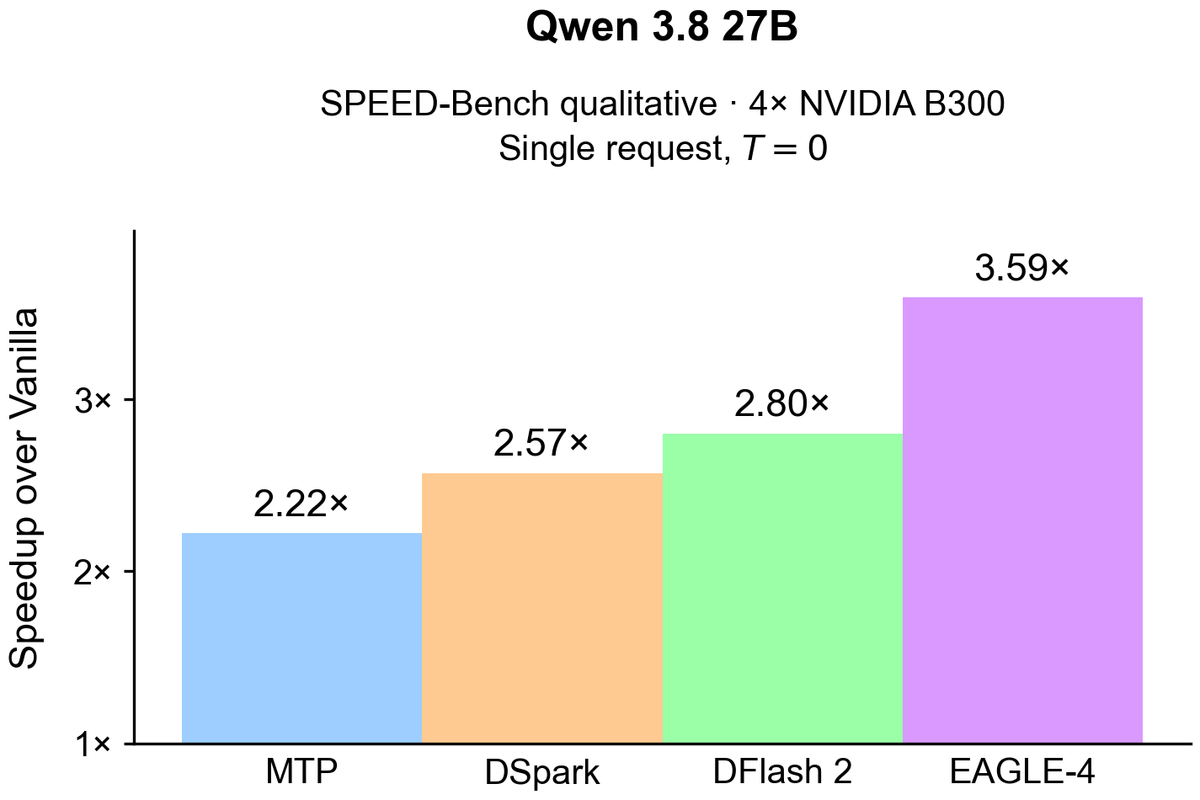
同一個 270 億參數的模型,用上 EAGLE-4 這種「先猜、再驗證」的方式,單一請求每秒能吐出的詞元數,可以從 240 個變成 860 個。這是論文表 2 的數字,由作者在 4 張 NVIDIA B300 顯示卡上自己測得。
推測解碼是用一個小模型先猜接下來幾個詞,再讓大模型一次檢查,猜對的就直接收下。因為檢查可以平行做,所以大模型少跑了很多步,而且輸出內容理論上與原本一樣。
EAGLE 官方 X 帳號在 10 月 20 日 21:42 UTC 發文,換算成台灣時間是 10 月 21 日清晨 5:42。我查詢時貼文有 1,078 個讚、約 78.8 萬次瀏覽。
貼文寫的是 Qwen3.8-27B 達到每秒 961.6 個詞元,也就是 tokens/s,詞元是模型處理文字的最小單位。
但我在論文全文、公開倉庫的文件檔與模型卡裡搜尋,找不到 961.6 這個數字,所以它目前只能標成貼文宣稱。論文在同一模型與同一組硬體上寫的是 863.8,貼文高出約 11%,這是我自己相除的結果。差距可能來自引擎與工作負載,貼文沒有附表可以對。
另一個容易漏看的重點是授權。這套軟體的程式與權重用的是自訂的原始碼公開授權,並非常見的開源授權。使用者與關係企業任一連續 12 個月的總營收超過 2,000 萬美元,或做的是會與它競爭的產品,商業使用就要另簽合約。
我的判斷是,自己有 GPU 叢集、正在比較推論加速方案的團隊,值得讀論文並在自己的模型上量測。想直接拿它做商業推論服務,或手上只有消費級顯示卡的讀者,則要先看清楚授權與官方實際驗證過的硬體。
要看懂這些數字,得先知道它到底在加速哪一段。
EAGLE-4 是什麼?先看推測解碼為什麼能變快
大型語言模型一次只產生一個詞,每個詞都要把整個模型跑一遍,所以單一請求時 GPU 大半時間在搬資料,而非運算。推測解碼的想法,是利用這些閒置的運算能力,一次驗證多個猜測。
負責猜的小模型叫草稿模型。EAGLE 系列的草稿模型只有一層 Transformer,會參考大模型的內部特徵來猜詞,所以猜得準,自己也跑得快。
EAGLE-1 在 2024 年 1 月發表,EAGLE-2 在 2024 年 6 月,EAGLE-3 在 2025 年 3 月,這是 EAGLE 官方網站列出的時間。
EAGLE-1 到 3 的原始倉庫是 SafeAILab/EAGLE,它的待辦清單最後一項就是 EAGLE-4。
EAGLE-4 的草稿層改用滑動視窗注意力,只看最近一段內容,所以處理長文件時花費比較少。草稿的輸出層也換成低秩候選頭,先用小矩陣篩出候選詞,再對少數候選精算分數。
決定猜多少的是 EAGLE-Harness。它會在暖機時量測當前硬體跑草稿與驗證各要多久,再決定這一輪要猜幾個詞、猜幾條分支,論文把這個設計叫做硬體感知的草稿樹。
論文說低秩候選頭讓草稿的前向運算延遲少了四成以上。圖 2 的數字是,原本一次草稿前向要 574 微秒,其中詞表輸出層佔 65.4%,用秩 512 的候選頭降到 326 微秒,秩 128 則是 255 微秒。
草稿模型本身也很小。論文表 1 列出每個草稿位置的層參數,新版是 0.44B,DFlash 2 是 1.66B,DSpark 是 1.65B,所以每猜一個詞的運算量,論文估計約少 3.8 倍。模型內建的 MTP 只有 0.37B,比它更小。
官方身分的部分,我做了交叉確認。論文署名是 EAGLE-4 Team 與 Eagle AI,聯絡信箱網域是 eagle.ai。
GitHub 倉庫 eagle-hq/EAGLE-4 的 README 連到 X 帳號 EagleCorp 與官網 eagle.ai,貼文也連回這個倉庫,所以三方互相指向。
我沒有在公開頁面看到 EAGLE-4 團隊與 SafeAILab 原作者名單完全重疊的說明,所以文中只稱「EAGLE 團隊」,不再往人員關係推論。
元件講完,接著要核對最受矚目的 961.6 這個數字。
EAGLE-4 的 961.6 tokens/s 怎麼來?貼文、論文與倉庫的數字對照
貼文的條件寫得很具體:Qwen3.8-27B、TokenSpeed 引擎、BF16 精度、4 張 NVIDIA B300、張量平行度 4、單一請求、溫度 0。這些條件都合理,但我搜尋論文全文、倉庫文件與模型卡,找不到 961.6 對應的表格。
以下我把同一模型、同一組硬體的官方數字放在一起。這些數字來自不同的評測與引擎,不能直接相減。
| 來源 | 條件 | 每秒詞數 |
|---|---|---|
| X 貼文宣稱 | TokenSpeed、BF16、4×B300、單請求、溫度 0 | 961.6 |
| 論文表 2 | SPEED-Bench 質性子集、同引擎、MegaKernel 關閉、單請求、溫度 0 | 863.8 |
| 論文圖 3 | HumanEval、開啟思考、輸出上限 4,096 詞、單請求 | 929 |
| 論文表 7 | TokenSpeed 團隊測長上下文、單請求,上下文 32K、128K、250K | 759、822、761 |
| 倉庫支援矩陣 | vLLM、4×B300、單請求、溫度 0 | 722.8 |
這張表顯示,官方文件裡同一個模型的單請求速度,在不同資料集與引擎下落在 720 到 930 之間,961.6 略高於這個範圍。所以它不是不可能,只是需要附上測試表,才能和別的數字比較。
但貼文提到的 TokenSpeed 引擎,在公開倉庫裡被標成實驗性質。README 寫得很清楚,沒有宣稱任何 TokenSpeed 吞吐量,倉庫文件也說四卡單請求的最佳化還沒完成。
支援矩陣裡唯一的 TokenSpeed 速度,是安裝檢查:B300 四卡、20 個提示,服務模式每秒 786.33 個詞元。官方註明這是請求延遲總和算出來的速率,不是吞吐量基準,所以不能拿來驗證 961.6。論文表 2 另外註明 MegaKernel 關閉,貼文沒有提到這項設定,所以兩者的設定是否相同,無從確認。
所以我對 961.6 的處理是,保留為貼文宣稱,正文數字以論文與倉庫為準。若把它拿來和論文的 863.8 相比,高出約 11%,這個比例是我自己相除的結果。貼文沒有交代資料集,論文表 2 也沒有寫引擎名稱,條件可能不同,只能當粗略參考。
另外,論文的「3.59 倍」是 863.8 除以原生解碼的 240.5。貼文沒有附原生解碼的對照值,所以不能把 961.6 直接換算成倍數。
延伸閱讀:RTX 3090 跑 Qwen3.8-27B 達 381 tok/s?HyperQwen 的 4.6 倍適用條件
數字釐清後,才有辦法公平地看它和其他方法的比較。
它和 DFlash 2、DSpark 比,贏在哪個條件?
論文的主要比較對象是 DFlash 2、DSpark 與模型內建的多詞預測頭,也就是 MTP。DFlash 與 DSpark 的草稿區塊長度要事先固定,DSpark 能依信心縮短送去驗證的長度,但已經花掉的草稿運算收不回來。
EAGLE 則是一個詞接一個詞地猜,每一步之前都能決定要不要停。
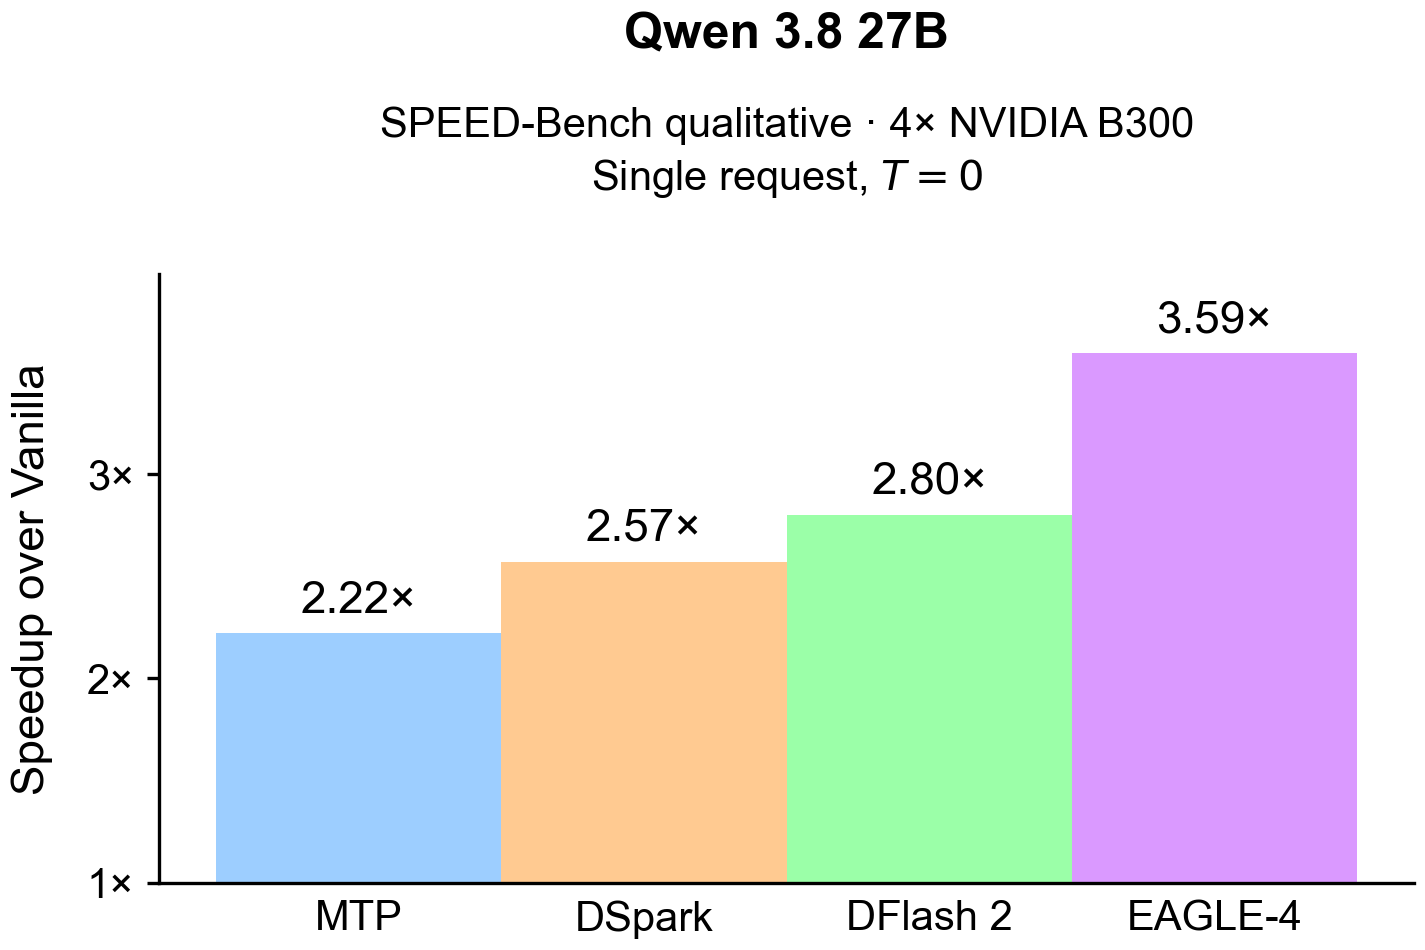
論文表 2 用 Qwen3.8-27B、4 張 B300,把單請求與 512 個並行請求的速度並排。溫度 0 的結果如下。
| 方法 | 單請求每秒詞數 | 相對原生 | 512 並行每秒詞數 | 相對原生 |
|---|---|---|---|---|
| EAGLE-4 | 863.8 | 3.59 倍 | 28,340 | 1.34 倍 |
| DFlash 2 | 672.6 | 2.80 倍 | 16,641 | 0.78 倍 |
| DSpark | 618.6 | 2.57 倍 | 14,229 | 0.67 倍 |
| MTP | 534.5 | 2.22 倍 | 21,518 | 1.01 倍 |
| 原生解碼 | 240.5 | 1.00 倍 | 21,203 | 1.00 倍 |
單請求時,它比 DFlash 2 快 1.28 倍,比 DSpark 快 1.40 倍。到 512 並行時,DFlash 2 與 DSpark 反而比原生解碼慢,EAGLE 仍高出原生 34%。
論文的解釋是批次大小。請求多的時候,GPU 的運算已經被塞滿,猜太多詞等於白做工。固定長度的方法無法縮短猜測,所以拖累整體速度,EAGLE 則會依量測到的成本縮短草稿。
溫度 1 的結果差距小很多。EAGLE-4 單請求是 608.6,DFlash 2 是 560.3,只高出約 9%,512 並行時只比原生高 3%。所以最漂亮的倍數集中在溫度 0 這種確定性輸出的設定。
這個比較有一個口徑要看清楚。論文說明,圖 3 裡 DFlash 2、DSpark 與原生解碼用的是 trtllm 後端,比較的是各自完整的服務設定,包含注意力後端與排程。所以結果反映的是整套組合,而非草稿模型單獨的差異。
與 DFlash 2、DSpark 的比較由論文作者自己跑,用的是兩者的公開檢查點,所以這些倍數目前屬於作者宣稱,沒有第三方重現可以對照。
其他硬體的數字也在論文裡。AMD MI350X 單卡、單請求從 75.27 提高到 262.89,是 3.49 倍,並行 32 時降為 1.70 倍。
論文寫這組由 AMD 團隊評測,表 7 的長上下文則由 TokenSpeed 團隊測量,都不是論文作者自己跑的。
Nemotron-3.5 模型在 512 並行時,從原生的 19,823 提高到 33,480,是 1.69 倍。
最特別的是小設備。以 4 位元量化的 Gemma-4-E2B-it 在 AWS c5.xlarge 雲端 CPU 上,四個資料集平均 2.71 倍,EAGLE-3 是 1.25 到 1.65 倍。
在 Motorola Razr 70 Ultra 手機上,HumanEval 從 22.8 提高到 82.6,是 3.62 倍。
手機的數字是在機身降頻之前量的。論文寫到,機身溫度在連續生成約 30 到 45 秒後會接近 42 度,單次長文生成會在降頻前完成,所以持續使用時的表現可能比較低。
論文的數字之外,公開版本實際驗證了多少,又是另一回事。
公開倉庫驗證到哪裡?0.1.0 版支援矩陣怎麼讀
倉庫的 README 與支援矩陣比論文保守。它在 2026 年 10 月 20 日 UTC 建立,初版是 eagle-harness 0.1.0。
它透過外掛方式接進 SGLang、vLLM 與實驗性的 TokenSpeed,三者都需要官方打過補丁的版本,因為一般安裝的引擎沒有必要的掛鉤。
支援矩陣的測試條件寫得很細,每個倍數都是加速後的吞吐量除以同一引擎、同一設定的無推測對照。以下是我挑出的幾列。
| 引擎與硬體 | 並行數 | 無推測每秒詞數 | EAGLE-4 每秒詞數 | 倍數 |
|---|---|---|---|---|
| SGLang,1 張 B300 | 1 | 103.1 | 343.1 | 3.33 倍 |
| SGLang,8 張 B300 | 1 | 241.7 | 828.6 | 3.43 倍 |
| vLLM,4 張 B300 | 1 | 241.6 | 722.8 | 2.99 倍 |
| SGLang,4 張 B300 | 8 | 1,479.4 | 2,820.6 | 1.91 倍 |
| SGLang,4 張 B300 | 64 | 3,925.3 | 5,281.3 | 1.35 倍 |
| SGLang,1 張 MI355X | 8 | 552.7 | 1,145.9 | 2.07 倍 |
倍數隨並行請求增加而下降,SGLang 四卡從並行 8 的 1.91 倍,降到並行 64 的 1.35 倍,和論文趨勢一致。
公開版在 AMD 並行 8 時是 2.07 倍,論文用 MI350X 與另一批 117 輪的資料,結果是 2.54 倍。相近的 AMD 硬體、不同評測批次,倍數就差了約 0.5,所以任何單一倍數都該帶著條件一起看。
矩陣也坦白列出沒做完的部分。已知限制頁寫著,SGLang 四卡單請求最佳化與 32K 上下文最佳化仍未完成,八卡並行 8 有間歇性停頓,Nemotron 在 SGLang 上的比對有未解決的首個分歧。
正確性檢查也值得讀。官方設了一道「貪婪輸出一致」的關卡,結果分成完全一致、近似平手、fp32 容差內等幾類,並明說這不等於與原生輸出逐位元相同。
所以「輸出和原本一樣」要讀成「分佈在驗證下被保留」,實際輸出在數值精度的邊緣可能和原生有些微差異。需要逐字可重現結果的場合,要自己用目標模型重新比對。
另外,矩陣只涵蓋 Qwen3.8-27B 這一組模型與草稿,其他模型要按新模型導入指南自己訓練草稿,成本不在官方數字內。
接著是授權,它決定這套東西能不能放進你的產品。
EAGLE-4 授權與導入前檢查:什麼情況需要商業合約
官方 README 自己寫明,它是「原始碼公開軟體,並非 OSI 認可的開源軟體」,適用 Eagle 4 Source-Available License,並附帶商標政策。程式、權重與文件都算在授權涵蓋的範圍。
授權的核心分成三層。研究、評估、教學、個人與內部非商業實驗可以直接用。商業用途則在兩個條件下允許,使用者與關係企業合計的總營收,在任一連續 12 個月都沒超過 2,000 萬美元,而且做的不是「競爭產品」。
商業用途的定義很廣,付費產品、客戶面對的正式環境、軟體即服務、API 與託管都算。營收門檻算的是所有來源的總營收,不只是 AI 產品的收入。超過門檻就必須先簽另一份協議,條文沒有寬限期,而且一旦觸發,之後營收下降也不會恢復。
競爭產品的定義更值得注意。條文說的是主要功能實質取代 Eagle 4,或把 Eagle 4 的重要技術放進會與它競爭的模型、推論、訓練、加速或服務框架。這類產品不論營收多少,都要另簽商業授權。
條文同時排除只是與它互通、互相呼叫、互補,或單純使用它產出結果的產品。
所以內部評估和非商業實驗可以直接做。拿它加速自家對客戶提供的服務,已經算商業用途,營收在門檻內又不是競爭產品時才適用這份授權。
若是打算把它包進通用推論平台再賣給別人,就落在競爭產品的風險區。這是我對條文的解讀,不是法律意見,實際判斷要請法務確認。
被加速的目標模型另有授權。倉庫寫明模型權重由原擁有者授權,所以 Qwen3.8-27B 本身的條款要另外遵守。草稿模型在 Hugging Face 的授權標示是 other,指向倉庫的 LICENSE。
條文還有幾個細節。倉庫內的檔案只有在著作權人明確標示 Apache-2.0 時,才適用 Apache 2.0,第三方衍生檔案則保留原專案的授權聲明。
使用者要署名、保存三年的營收與使用紀錄,授權方有合理懷疑時,每 12 個月最多可以派獨立稽核員查一次。
安裝與執行也有幾個安全習慣。官方安裝流程要求先複製倉庫,再用 shell 載入 docs/release.env,這個檔案只設定環境變數,但載入前仍建議先讀過內容。
服務啟動範例使用 --trust-remote-code,這會執行模型倉庫附帶的程式碼。官方快速上手文件也提醒,只有審閱過的模型程式碼才開啟這個選項。
Docker 範例把連接埠綁在 127.0.0.1,只對本機開放,改成對外開放前要先加上驗證。
此外,安裝需要打過補丁的引擎安裝包。官方發布在 GitHub Pages 索引與 GHCR 映像,倉庫文件也說明,發布與映像資格是獨立的檢查關卡,所以建議固定版本號,並先在測試環境確認。
延伸閱讀:Qwen3.8-27B 開放權重:27B 多模態模型、百萬 Token 與兩種版本差異一次看
適合誰、不適合誰
適合自己維運 GPU 叢集,並且已經用 SGLang 或 vLLM 服務 Qwen3.8-27B 的團隊。這類團隊可以直接依官方矩陣的條件重現,看看單請求延遲能下降多少。
也適合研究推論加速的人。論文、程式與草稿權重都能取得,可以拿來和 DFlash 2 或 MTP 做對照實驗。
不適合只有消費級顯示卡、想要即插即用的使用者。官方驗證的硬體是 B300 與 MI355X,其他 GPU 只做到編譯檢查,倉庫明說在其他架構上編譯成功不代表服務正確或夠快。
也不適合要把它包成對外推論服務的新創。授權條文的競爭產品條款,需要先和 Eagle AI 談清楚。
導入的限制與風險
證據層級要先認清。論文標示為預印本,倉庫文件說原始啟動紀錄與請求軌跡由維護者保存,沒有隨原始碼提供,所以第三方目前無法逐筆核對,倍數屬於作者自己的測試結果。
適用範圍也很窄。官方只有 Qwen3.8-27B 這一組有完整驗證,倉庫只支援文字請求,SGLang 會拒絕圖片,沒有管線平行,多節點部署也未驗證。
倍數和場景高度相關。單請求最漂亮,並行愈高愈接近 1,溫度 1 的採樣輸出收益也小很多,所以對外網站這類請求量大又要採樣的服務,實際收益可能遠低於標題倍數。
維運成本也要算進去。草稿模型每換一個目標模型就要重新訓練,成本表要在換模型、平行度或引擎後重新量測,官方的校準指南也提醒,成本表的索引鍵並不涵蓋所有設定。
至於貼文的 961.6,因為找不到對應的表格,我建議在引用這個數字之前,先向官方確認引擎版本、資料集與量測方式,或自己在相同條件下重跑。
EAGLE-4 常見問題
推測解碼會改變模型的輸出嗎?
設計目標是保留目標模型的輸出分佈。官方的貪婪檢查把結果分成完全一致與近似平手等類別,並說明不等於逐位元相同,所以需要可重現輸出的場合要自己驗證。
EAGLE-4 可以免費商用嗎?
要看情況。使用者與關係企業任一連續 12 個月的總營收都沒超過 2,000 萬美元、且不做競爭產品時,授權允許商業用途,但仍要署名並保存紀錄。超過門檻或做競爭產品就需要另簽合約,實際判斷請交給法務。
我能在 RTX 3090 上用它嗎?
官方驗證的硬體是 NVIDIA B300 與 AMD MI355X,文件說 NVIDIA sm_80 以上與 AMD CDNA2 到 CDNA4 可以編譯,但其他 GPU 的正確性與速度沒有保證。RTX 3090 的相關測試請看站內 HyperQwen 那篇。
961.6 tokens/s 是誰測的?
貼文來自 EAGLE 官方帳號,寫明 TokenSpeed、BF16、4 張 B300、單請求、溫度 0。我在論文與倉庫找不到這個數字的表格,所以只能當作官方帳號的宣稱。
先看條件再看倍數,再決定要不要試 EAGLE-4
論文數字很亮眼,單請求 3.59 倍、AMD 3.49 倍、手機 3.62 倍,高並行時也沒有像固定區塊的對手那樣掉到原生以下。這些結果指向一個可以追蹤的技術方向。
但貼文的 961.6 缺少對應來源,公開倉庫的數字比論文低,授權也有營收門檻與競爭產品條款。實際導入前,先用自己的模型、硬體與請求量,重跑官方矩陣中最接近的那一列。
想持續追蹤推論加速與開源模型的新動態,可以免費訂閱 AI 郵報,也可以回到官方倉庫查看支援矩陣是否更新。