RTX 3090 跑 Qwen3.8-27B 達 381 tok/s?HyperQwen 的 4.6 倍適用條件
RTX 3090 跑 Qwen3.8-27B 從 82 提到 381 tok/s,X 與 Wccftech 稱快 4.6 倍。本文依 HyperQwen 官方倉庫拆解推測解碼、提示詞查找、各模式速度與量化代價,說明 381 只出現在複製提示詞的工作,日常聊天約 127 到 133。

一張 24GB 顯示記憶體的 RTX 3090,現在能不能把 270 億參數的 Qwen3.8-27B 跑到每秒 381 個 token?
X 與科技媒體 Wccftech 在 2026 年 10 月 18 日前後都出現了這個說法,起點是 82,終點是 381,倍數是 4.6。
token 是模型處理文字的單位,tok/s 就是每秒產生幾個 token,數字愈高,回答跳出來愈快。X 上有一則熱傳貼文發在台灣時間 10 月 19 日凌晨,查詢時有 1,325 個讚、約 8.5 萬次瀏覽。
這些報導轉述的是 r/LocalLLaMA 上一位用戶的貼文。從 381、25,000 token 與逐步加速的路徑判斷,背後的專案應該是開源的 HyperQwen。
我查了它的 GitHub 倉庫,發現 381 有一個很明確的前提:模型回答時要大段複製提示詞裡已有的內容。
換成一般聊天,倉庫自己的數字是 127 到 133 tok/s,仍然比未加速的 vLLM 快 3 倍左右,但離 4.6 倍有一段距離。
vLLM 是常見的開源模型推論引擎,這個專案就是在它上面加修補。倉庫自己就把 381 標成「引用提示詞時」的數字,所以這條新聞要問的是 381 在什麼條件下成立,你的工作符不符合。
我的判斷是,常用本機模型改程式、做文件引用的人值得試,只想聊天、又不想碰 Docker 與 vLLM 的人,現階段不必特地跟進。
要看懂這個差距,得先從 82 怎麼變成 381 開始。
RTX 3090 跑出 381 tok/s:4.6 倍怎麼算出來
Wccftech 轉述的路徑有四站。起點是 82 tok/s,調整模型內建的多詞元預測後約 114。
加上草稿模型與提示詞查找後約 138,最後改成一次驗證 16 個 token,在複製 25,000 token 文件的工作上到 381 到 382。
Wccftech 同時註明它沒有獨立驗證這些資訊,而且我無法開啟 Reddit 原文,所以 82 與 138 這兩個數字,我只能當成轉述。381 除以 82 約為 4.65,這就是「4.6 倍」的來源。
HyperQwen 倉庫的說法更完整,也更保守。它寫的是在 RTX 3090、250 瓦的條件下,單人使用模式有 127 tok/s。
同時 64 個請求的批次模式合計約 1,035 tok/s,而回答在引用自己的提示詞時,是 381 tok/s。
倉庫把這些情境拆成五種設定,下表是它的對照,數字都來自官方 README。
| 設定 | 適合情境 | 官方速度 | 代價 |
|---|---|---|---|
| A 批次 | API 後端,8 個以上請求同時進來 | 64 併發合計約 1,035 tok/s | 單人速度只有 46 tok/s |
| B 單人預設 | 一到幾個人聊天,提示詞短於 64k | 127 tok/s,上下文 64k | 無 |
| C 複製提示詞 | 改程式、引用文件、改寫、翻譯 | 引用時 381 tok/s | 請求位置 4 個、上下文 56k |
| D 長上下文 | 提示詞最長 150k | 約 95 到 100 tok/s | 改用 MTP 推測 |
| E 超長上下文 | 200k 以上 | 混合工作 67、引用時 164 tok/s | 上下文可到 24 萬 |
表裡 B 與 C 的差別最關鍵。B 是官方的安全預設,C 要在設定檔加上 DFLASH_TOKENS=15,官方明說只有輸出真的重複輸入時才划算。這個差別來自推測解碼用了哪一種猜法。
推測解碼為什麼能提速?MTP、DFlash2 與提示詞查找
這些速度來自同一個技巧,叫推測解碼。模型原本每一步只產生一個 token,推測解碼則讓一個輕量的草稿先猜好幾個,再由主模型一次驗證,猜對的就直接收下,所以一步能前進好幾格。
HyperQwen 疊了三種猜法。最基本的是 Qwen3.8-27B 本身訓練出的多詞元預測,簡稱 MTP,也就是模型自帶的預測頭。在它之上,DFlash2 是專門的草稿模型,一次猜 7 個 token。
381 的關鍵是第三種,提示詞查找。當模型正在複製文件裡的段落時,那些字已經躺在提示詞裡,系統就去找「剛寫出來的字在提示詞哪裡出現過」,直接把後面接的字當草稿。
草稿來源是現成文字,不用額外運算,所以驗證區塊可以拉長到 16 個 token。官方資料顯示,複製文件時平均每步接受 14.97 個 token,所以速度從 260 跳到 381。
這個查找什麼時候有用,倉庫用 25,000 token 的上下文量過六種工作,單位是 tok/s。
| 工作類型 | 不用查找 | 預設設定 | DFLASH_TOKENS=15 |
|---|---|---|---|
| 逐字重現文件前 60 行 | 159 | 260 | 381 |
| 縮短內容並保留指令 | 90 | 107 | 113 |
| 引用並說明 | 101 | 107 | 110 |
| 重現所有指令 | 153 | 173 | 166 |
| 自由摘要與問答 | 72 | 69 | 71 |
| 8 個短聊天提示 | 126 | 131 | 133 |
這張表的重點在差距。逐字重現時,DFLASH_TOKENS=15 比預設設定快 47%,其他工作只多幾個百分點,「重現所有指令」甚至從 173 降到 166。
所以 381 tok/s 是作者在這項複製任務中公布的結果,不能當成所有任務的平均速度,實際表現仍取決於輸出重複輸入的程度。
延伸閱讀:Qwen3.8-27B 開放權重:27B 多模態模型、百萬 Token 與兩種版本差異一次看
4.6 倍的比較口徑:基準線不同,倍數就不同
4.6 倍的分母是轉述來的 82,而且同樣叫 tok/s,其實有四種量法,讀報導時很容易混在一起。單人解碼只算模型寫字的速度,端到端把等待與讀取提示的時間也算進去,預填是模型讀進提示的速度,批次合計則是很多請求加總的結果。
HyperQwen 的 1,035 tok/s 就是批次合計,同時有 64 個請求,平均每個人只分到約 16 tok/s。所以 381 與 1,035 都不能直接拿來比,一個是單人複製文件的解碼,一個是整台服務的總產量。
分母不同,倍數就不同。倉庫自己的逐步對照表裡,不用任何推測的單人解碼是 46 tok/s,出貨狀態的 MTP-2 約 66 到 79,X 上說的 82 tok/s 起點,我在倉庫文件裡找不到對應的數字。
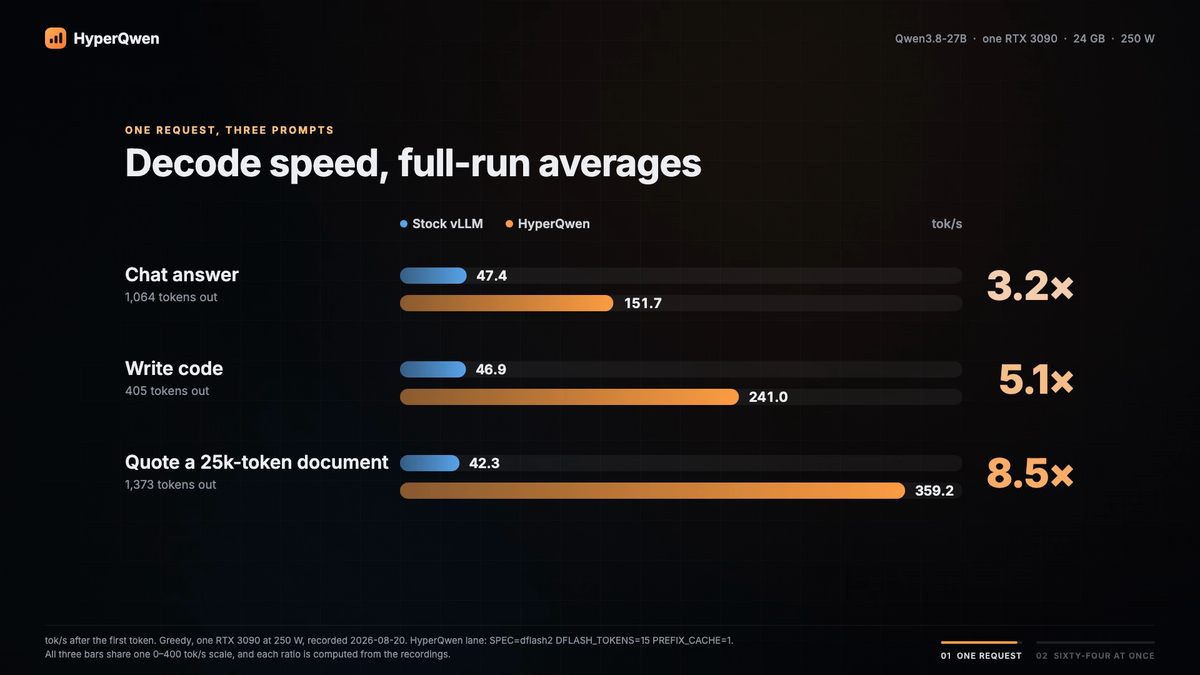
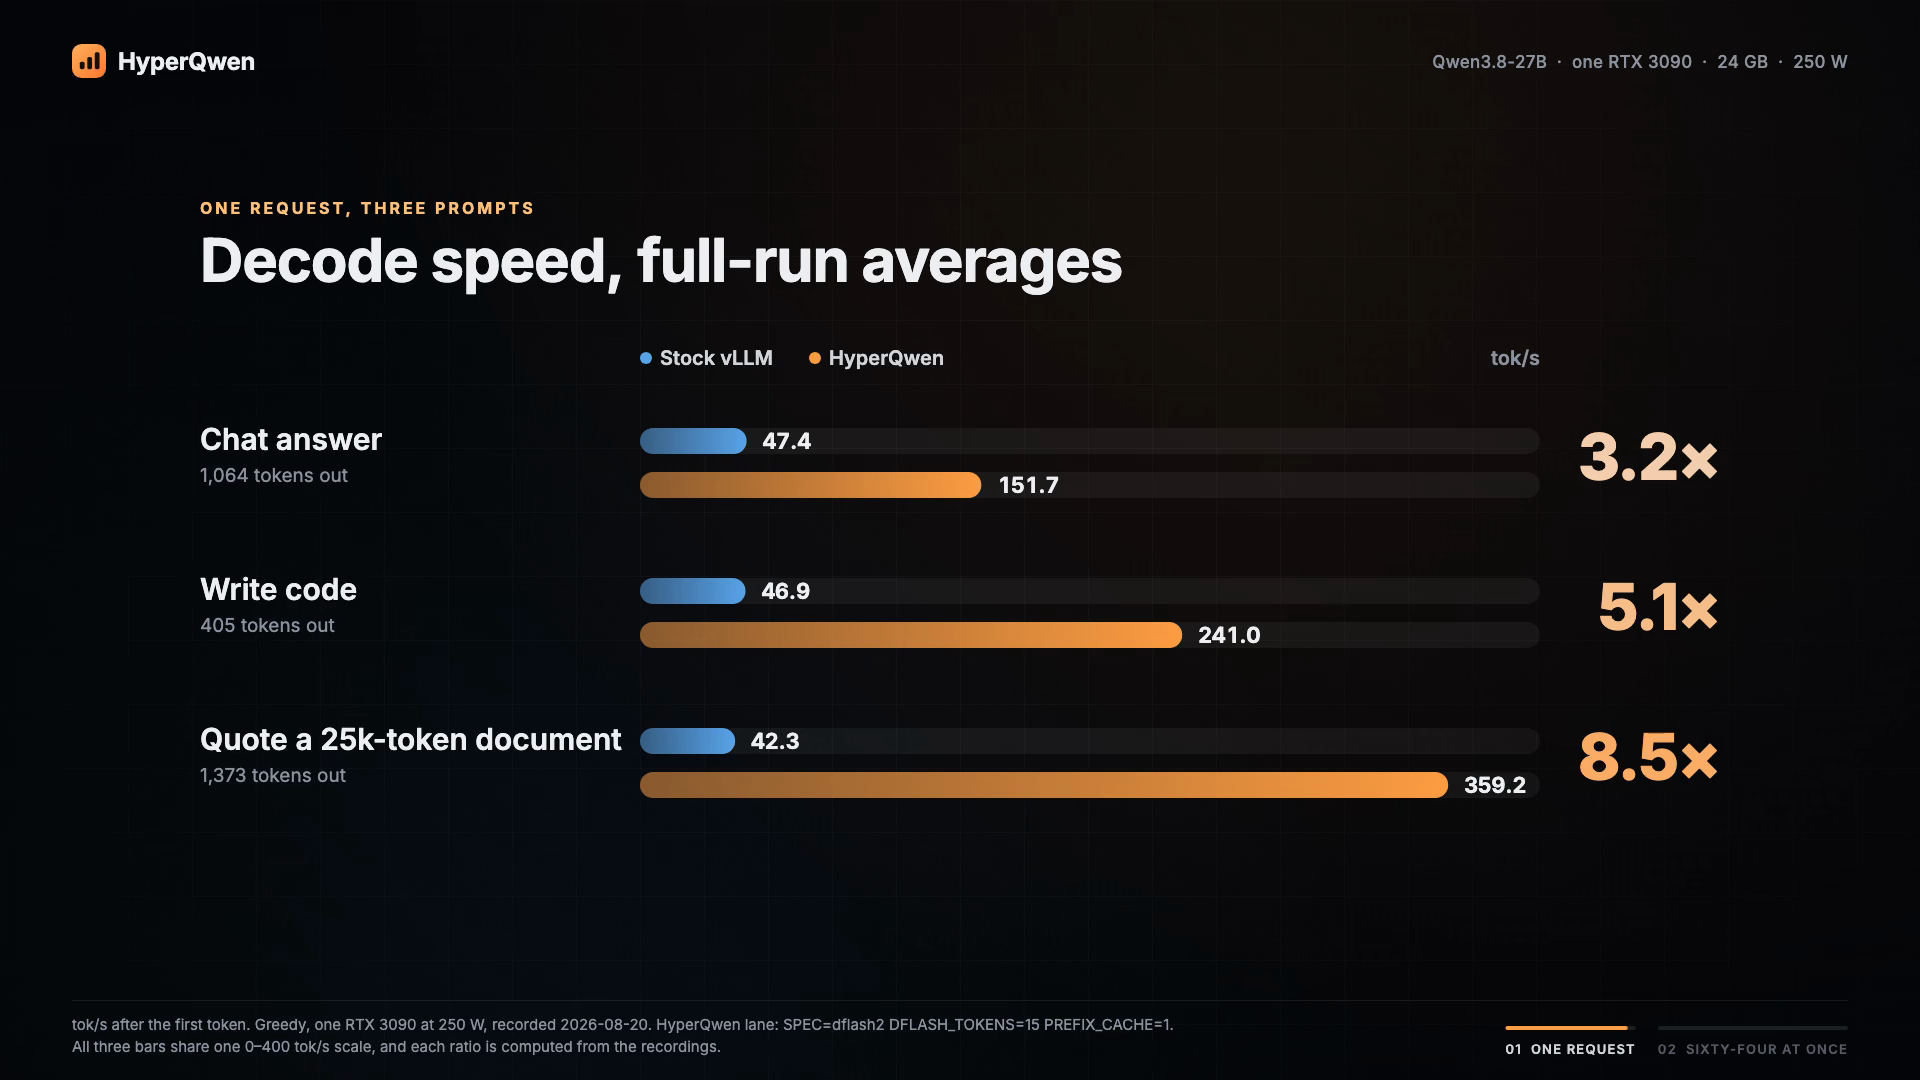
官方示範影片,也就是倉庫 bench/demo 的資料,又換了一個口徑:2026 年 8 月 20 日錄製、同一張 RTX 3090 以 250 瓦運作,對照的是未修補的標準 vLLM 0.27.1。取樣用貪婪取樣,也就是每一步都選機率最高的字,讓結果可重現。
聊天回答是 47.4 對 151.7 tok/s,快 3.2 倍。寫程式是 46.9 對 241.0,快 5.1 倍,引用 25,000 token 文件是 42.3 對 359.2,快 8.5 倍。
同一個專案,換一個基準線,倍數就從 3.2 倍到 8.5 倍都有,所以看到「快 N 倍」時,要先問分母是誰。
第三方的結果則更保守。開發者 Hsiu-Chi Tsai 在 2026 年 8 月 29 日發表的測試,用 llama.cpp 與 4 位元量化的 Qwen3.8-27B,在另一張 RTX 3090(功耗 420 瓦)上的基準是 41.55 tok/s。
他測到 MTP 設定為 2 時是 66.39 tok/s,快 59.8%,DFlash2 一次猜 7 個 token 時是 50.95,只快 22.6%,而且在散文、聊天與中文提示上反而變慢,中文類別慢了 28.7%。
這個測試用的是另一套引擎、量化格式與 8,192 的上下文,不能和 HyperQwen 直接相減。但它提醒我們,推測解碼的效果可能隨工作類型改變。作者自己也說,分類差異只來自他挑的 25 個提示,不是確立的類別效應,所以中文使用者最好用自己的提示詞重測。
其他顯卡的重現結果
HyperQwen 倉庫也收錄了其他人用自己的硬體跑出的單人解碼結果,條件各不相同,下表只能看大方向。
| 硬體 | 功耗 | 單人解碼 tok/s | 備註 |
|---|---|---|---|
| RTX 3090,倉庫對照基準 | 250 W | 133 | 倉庫列的參考值 |
| RTX 4090 | 450 W | 135.5 | 沒開推測的對照是 60.3 |
| 兩張 RTX 3090,NVLink | 250 W | 182.8 | 雙卡平行 |
| RTX 5090 | 400 W | 212.8 | 設定 E,400 W 是該卡下限 |
| RTX L40S 48GB | 350 W | 150.4 | 設定 B |
| 兩張 RTX 3060 12GB | 170 W 預設 | 59.1 | 設定 D |
RTX 4090 只比 3090 快 1.9%,而記憶體頻寬約多 8%,這張 4090 還是在 450 瓦下跑的。倉庫的解釋是,單人解碼受記憶體頻寬限制,多出來的運算力沒有用武之地,所以為了單人速度升級顯卡,效益不如預期。
這個 4090 回報同時量到沒開推測的對照是 60.3,DFlash2 約貢獻 2.31 倍,方向與 3090 一致,也說明加速主要來自軟體,同時代表這套軟體的取捨會跟著你走。
速度的代價:量化、位置與電源
HyperQwen 的速度不是免費的,代價分成三類:模型為了塞進顯卡而做的量化、為了提速而犧牲的同時請求位置,以及電源與等待時間。
27B 模型為什麼塞得進 24GB
Qwen3.8-27B 是 270 億參數的多模態模型,依官方模型卡,原生上下文是 262,144 個 token,授權為 Apache-2.0。
它的 64 層裡,每 4 層有 3 層是 Gated DeltaNet,1 層是一般的完整注意力,所以只有 16 層需要隨長度成長的 KV 快取。KV 快取是模型為了不重算前文而保存的中間結果。
其餘 48 層為每個請求保留固定大小的狀態,所以長上下文比較便宜。不過這份狀態在 Qwen 設定裡預設用 32 位元浮點數,每個請求約 150MB。
倉庫發現,同時 64 個請求時只有 37 個真的在跑,所以卡住併發上限的是這份狀態。
HyperQwen 把狀態改成 16 位元,用量與讀寫量各減半,64 個請求就能全部運作,官方量到的困惑度沒有改變,困惑度是衡量模型預測文字有多準的指標,愈低愈好。權重則使用 4 位元量化,連兩個各約 2.5GB 的詞嵌入矩陣也重新量化,合計省下 2.6GB 顯示記憶體。
品質掉多少
官方自己用 IFBench 測了指令遵循,嚴格模式的提示詞層級是 78.3,Qwen 模型卡寫未量化模型是 79.5,差約一個百分點。它另外測了 GSM8K 數學題,200 題貪婪取樣是 96.5%。
推測解碼本身,官方說是「依構造精確」,因為每個猜測都會被主模型驗證,理論上不會改變輸出。作者的檢查是 9 個長提示裡有 7 個與關閉查找時逐字相同,另 2 個在機率幾乎並列的地方出現分歧。
前面提到的 llama.cpp 獨立測試也發現輸出會與逐字貪婪解碼分歧,所以不同引擎的行為不一定一樣。
位置、電源與等待時間
模式 C 還要付出位置的代價。它只留 4 個同時請求的位置,上下文從 64k 縮到 56k,所以不適合多人共用。
電源上限也會直接改變數字。倉庫記錄過一項持續負載測試,每個功耗跑 14 分鐘,200 瓦只有 57.5 tok/s,250 瓦是 85.6,280 瓦是 86.7。
280 瓦的卡在兩分鐘內升到 90 度後就會降速,所以官方所有數字都固定在 250 瓦。
最後還有讀取時間。倉庫的示範資料顯示,25,160 token 的提示在出第一個字之前要等約 23 秒,這段等待不在 381 tok/s 之內。
不過官方也說,開啟前綴快取後,也就是保留相同開頭的計算結果,同一份 24k 文件的後續提問,等待可從約 23 秒縮到約 1 秒,所以「載入一份文件、連問多題」是這個專案最能發揮的用法。
誰適合用 HyperQwen?怎麼從小任務開始
適合的人有三種:一個人在本機用 Claude Code 類工具改程式的開發者、做文件問答而且答案常常要引用原文的團隊,以及手上已經有 RTX 3090 或 4090、想榨出現有硬體的玩家。
不適合的人也很明確。多人同時使用、沒有 24GB 等級顯卡又不想組多卡、只想要一鍵安裝的人,現階段會花很多時間在 Docker、驅動與 vLLM 版本上。
起步方式很簡單。倉庫的快速開始是複製專案,把 .env.example 複製成 .env,再執行 docker compose --profile single up -d。
第一次啟動會下載約 9.5GB 映像,並重新量化約 20GB 的模型,所以要預留硬碟空間與時間。
啟動後服務預設只綁在本機 127.0.0.1。要讓別台電腦連線,必須先設定 API 金鑰再改綁定位址,這是官方文件的明確提醒,不能省略。
設定的選法可以用工作內容判斷。README 把改程式、引用文件、改寫與翻譯列為設定 C 的適用情境,因為這些工作的輸出常常是把提示裡的內容整段貼回去。
如果經常把整個專案或長報告丟進去,提示超過 100k,就要改用設定 D 或 E,速度會降到約 95 到 100 與 67,換來的是能處理更長的提示。
建議的第一個測試任務是挑五個你平常會問的提示,用設定 B 與設定 C 各跑一次,記錄 tok/s 與回答是否一致。只要你的任務是改寫、翻譯、引用或程式修改,C 才值得長期開著。
延伸閱讀:Wafer 分享 CUDA 效能指南:AI 變慢時,先找出 GPU 在等什麼
限制與風險:這不是 Qwen 官方方案
HyperQwen 是社群專案,不是 Qwen 團隊的產品。它是一組針對固定版本 vLLM 0.31.0 的修補檔,加上模型重新量化流程,授權是 Apache-2.0,和 Qwen3.8-27B 的授權相同。
倉庫也承認最完整的測試只在一張 RTX 3090 上,並說明那張卡與訓練工作共用。換成其他卡時,README 列出 sm80 架構(A100 一類)有尚未解決的推測故障回報,也有兩張 3090 合計吞吐量比一張還低的案例。
另外 Reddit 原文我無法開啟,所以 82 與 138 這兩個數字只來自轉述,貼文與 HyperQwen 的對應也只是依數字推斷,沒有一手確認。使用時應以倉庫 README 的設定與官方基準腳本為準,自己跑一遍。
倉庫更新很快,名稱也已從 qwen38-27b-rtx3090 改為 HyperQwen,舊網址會自動轉址。我查詢時它在 2026 年 10 月 19 日仍有提交,本文的數字可能在你讀到時已經改變。
RTX 3090 與 Qwen3.8-27B 常見問題
RTX 3090 跑 Qwen3.8-27B 日常能到多快?
依 HyperQwen 官方 README,單人模式在 250 瓦下是 127 tok/s,8 個聊天提示的實測落在 131 到 133 tok/s。這是倉庫作者的測試,與你的驅動、功耗設定和提示詞都有關。
381 tok/s 適用所有工作嗎?
不適用。381 是在 25,000 token 上下文、模型逐字重現文件前 60 行時量到的。一般摘要與問答只有 70 左右,聊天約 133。
貼文裡的專案與 HyperQwen 是同一個嗎?
我無法開啟 Reddit 原文,所以不能直接確認。數字、25,000 token 的測試情境與逐步加速的路徑都與 HyperQwen 倉庫一致,倉庫簡介也寫著「引用提示詞時 381」,因此合理推斷是同一個專案。
一定要用這個專案才能加速嗎?
不一定。Qwen 官方模型卡推薦用 SGLang 或 vLLM 部署,llama.cpp 也能用 MTP,獨立測試顯示可快約 60%。HyperQwen 做的事是把量化、草稿詞表和 vLLM 修補整合在一起。
速度變快,答案會變差嗎?
官方說推測解碼依構造不會改變輸出,但 4 位元量化會讓品質略降,官方量到 IFBench 約差一個百分點。另一方面,llama.cpp 的獨立測試發現,開啟推測解碼後輸出與逐字貪婪解碼常有分歧。如果任務對精確度很敏感,應該自己比較開關前後的結果。
結語:先確認你的工作有多少是在複製
381 tok/s 是作者公布的特定任務測量,條件是輸出大量重複輸入。把這個條件說清楚後,4.6 倍就從「顯卡變快」變成「某類工作變快」。
對手上有 RTX 3090 的人,這個專案值得半天時間試試:先用設定 B,再針對改程式與文件引用開設定 C,用自己的提示詞比較。想長期追蹤本機模型加速與推論工具的更新,可免費訂閱 AI 郵報。
資料來源
- HyperQwen 官方 GitHub 倉庫與 README:https://github.com/syv-ai/qwen38-27b-rtx3090
- HyperQwen 最佳化說明 docs/optimizations.md:https://github.com/syv-ai/qwen38-27b-rtx3090/blob/main/docs/optimizations.md
- HyperQwen 品質與基準文件:https://github.com/syv-ai/qwen38-27b-rtx3090/blob/main/docs/quality.md
- HyperQwen 其他硬體重現報告:https://github.com/syv-ai/qwen38-27b-rtx3090/blob/main/docs/reproductions/README.md
- HyperQwen 示範影片資料 bench/demo/data.js:https://github.com/syv-ai/HyperQwen/blob/main/bench/demo/data.js
- Qwen3.8-27B 官方模型卡:https://huggingface.co/Qwen/Qwen3.8-27B
- Wccftech 報導(轉述 r/LocalLLaMA 貼文):https://wccftech.com/rtx-3090-4-6x-token-generation-27b-llm-inference-optimizations
- 獨立測試 llama.cpp 在 RTX 3090 的 MTP 與 DFlash2:https://hackmd.io/@thc1006/qwen3-8-27b-speculative-decoding-rtx-3090
- X 貼文(熱度線索):https://x.com/superalesha/status/2111885825218838905