Cloudflare Clairic 是什麼?System One 抽取模型用法、價格與限制
Clairic 是 Cloudflare Workers AI 上的 System One 抽取模型,可從信件、收據與文字資料抽取、計算、估計並預測數值。本文依官方部落格與文件,說明用法、每百萬輸入詞元 0.10 美元的價格、示範數字與導入限制。

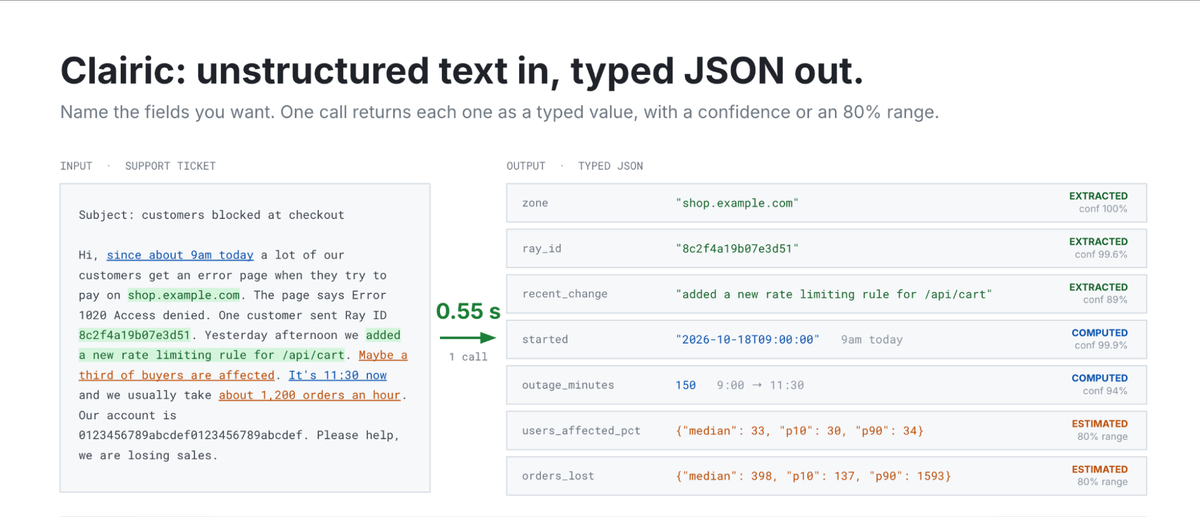
Clairic 是 Cloudflare 在 2026 年 10 月 19 日發表的新模型,官方稱它是第一個 System One 抽取模型。它做的事很具體:你給它一封客服信或一張收據,說明要哪些欄位,它一次回傳每個欄位的值。
和聊天模型不同,Clairic 不會一個字一個字寫答案。官方說它只做一次前向運算,不產生輸出詞元,每個欄位還附上信心分數,或一個 80% 範圍,讓程式判斷哪些結果要交給人看。
部落格作者之一 Michelle Chen 在 X 上貼出發表連結,稱它是「全新的模型範式」。這則貼文在台灣時間 10 月 20 日凌晨出現,不過貼文是作者的說法,熱度也只是線索,產品能做到什麼,要看官方部落格與文件。
要理解它為什麼被叫做 System One,得先看這個詞的來歷。
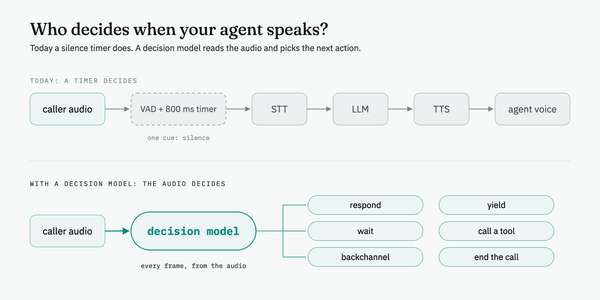
System One 這個詞借自心理學的快思概念,官方的定義是快而精準的模型,對比需要慢慢推理的 System Two。TypeSafe 的 Jev 先用這個詞形容判斷型模型,Cloudflare 10 月 1 日的 Clef 也是同類。
Clairic 補的是另一半。決策模型從固定選項裡選一個,Clairic 則把雜亂的輸入變成有型別的數值,所以兩者可以接成流水線:先抽事實,再做決定,最後才讓語言模型寫回信。
這條流水線在官方示範中,端到端延遲從 61.7 秒降到 19.3 秒,每百萬件的成本從 11,740 美元降到 6,032 美元。但官方沒有說明跑了幾筆樣本,也沒有列各模型的單價,所以只能當作方向,不能當作你的預期。
我的判斷是,Clairic 適合每天要處理大量信件、表單與收據,而且能用程式驗證結果的團隊。金額、醫療或法務這類錯誤代價高、又沒有人工覆核的流程,目前不適合直接交給它。
要判斷適不適合,得先弄清楚它和一般語言模型到底差在哪裡。
Clairic 是什麼?System One 抽取模型和聊天模型差在哪
Clairic 是 Cloudflare Workers AI 團隊訓練的預覽版模型,用來從輸入中抽取、計算、估計與預測數值。
官方文件把這四件事分得很清楚。抽取是輸入裡明明白白寫著的值,例如發票上的總金額。計算是從輸入的事實推出來,例如用到期日與你給的今天日期,算出逾期幾天。
估計是輸入沒有直接寫,需要預測的值,答案會是一個分佈而不是單一數字。預測則是推算一段時間內接下來的一串數值,例如明天的機場安檢人數。
它的運作方式和聊天模型不同。官方說,Clairic 在一次前向運算中處理輸入詞元,不產生輸出詞元,所以只對輸入收費,回應通常在一秒內。
「所有欄位一次算完」也改變了成本結構。聊天模型的答案愈長,花的時間和費用愈多,Clairic 沒有輸出詞元,官方稱要三十個欄位和要三個欄位的成本差不多。但欄位定義本身也算輸入詞元,所以仍要用回應裡的 usage 對帳。
它和 Cloudflare 的 Clef 是互補的。官方文件說,決策模型從預先定好的選項中選擇,生成式模型產生開放內容,抽取模型則回傳你定義過型別的值。Clef 的權重以 Apache 2.0 授權釋出,Clairic 目前沒有。
Clairic 還在預覽階段,官方稱目前是早期檢查點,並表示打算「很快」以開放權重釋出,但沒有給日期。這意味著現在能用的版本,之後可能會被更新或取代。
了解定位之後,下一步是看實際怎麼呼叫它。
延伸閱讀:Jev 模型是什麼?新手完整教學:3 種判斷類型、程式實作、適合場景與限制
Clairic 怎麼用?欄位定義、型別與輸出格式
Clairic 透過 Workers AI 呼叫,模型代號是 @cf/cloudflare/clairic,可以在 Worker 裡用 env.AI.run 呼叫,也可以走 REST API。
請求的核心是兩樣東西:state 放要閱讀的文字,fields 放你想要的欄位與型別。如果沒有文字,也可以改送圖片。圖片最多 4 張,格式限 PNG、JPEG 或 WebP,每張不超過 4 MiB,而且不接受遠端網址,要直接嵌入請求。
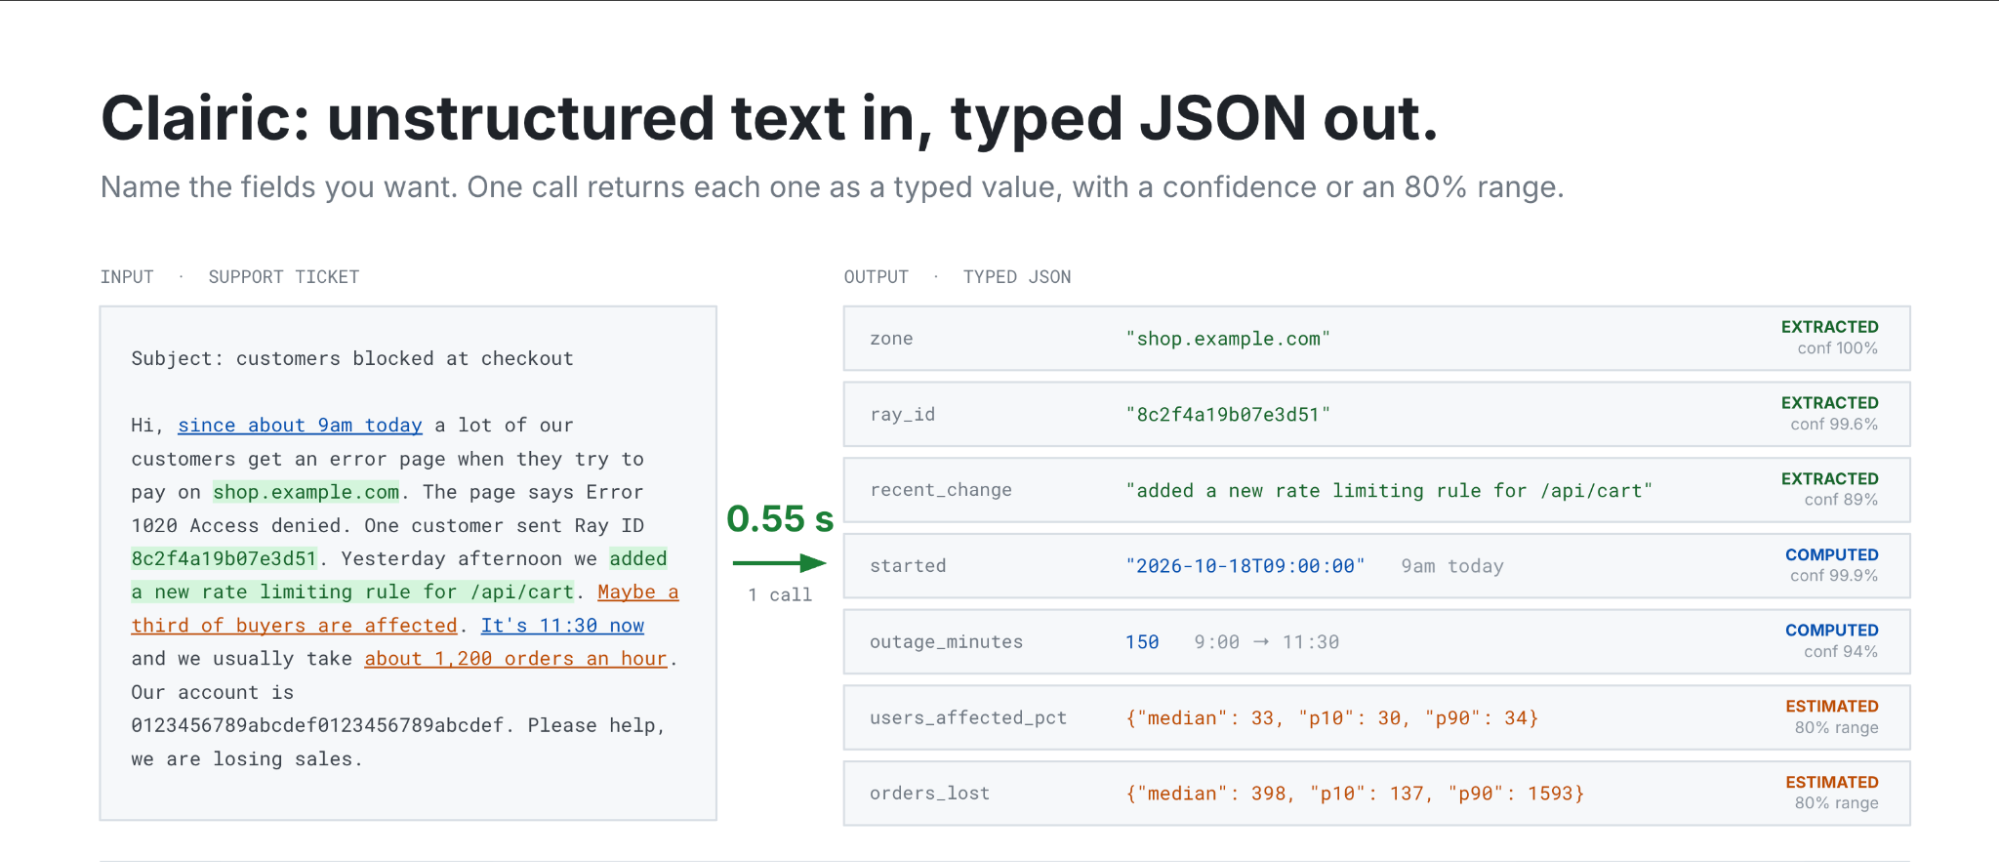
官方文件的範例用了五種欄位型別。text 回傳輸入中的一段原文並附字元位置,date 回傳由輸入推出的日期,number 可指定小數位與單位,list 回傳一串項目,estimate 則可設定最小、最大與間隔。
官方部落格另外還列出 duration(時間長度)、datetime 與 forecast(預測一串未來數值)。
另外還有 reference_date 可以填一個基準日期,讓沒寫年份的日期有依據。官方文件的範例用了發票,抓出發票號碼、到期日、總額、聯絡人與付款天數。以下是依文件欄位語法整理的簡化示意,實際寫法以官方文件為準。
{
  "model": "clairic",
  "state": "Invoice INV-2041. Total due: $1,080. Net 30 from Oct 2, 2026.",
  "fields": {
    "total": {"type": "number", "decimals": 2, "unit": "USD"},
    "due_date": {"type": "date"}
  }
}
回應會依欄位名稱回傳 answers。每個欄位都有 value,如果輸入沒有足夠資訊就會是 null。
text、date 與 number 另外附 p_null,也就是輸入其實沒提到這個值的機率,還有 confidence,表示模型對答案有多確定。
estimate 欄位則回傳 median、mean 以及 p10 與 p90。官方說明 p10 到 p90 是涵蓋中間 80% 預測分佈的區間,但實際值仍可能落在區間外。回應最後的 usage 會列出內文、圖片與欄位定義各用了多少詞元。
官方部落格的收據範例可以看出這些分數的用法。模型從收據照片抽出訂單編號 77245,信心 0.776,小計 15.98,信心接近 1,折扣則回傳 null。
一個訂單編號只有 0.776 的信心,就是系統在告訴你這筆值得人工看一眼。這是 Clairic 設計的核心:與其假裝每個答案都對,不如讓你知道哪個答案比較不可靠。
接下來看官方用了哪些示範,來說明這些分數在實際工作中表現如何。
Clairic 的官方示範數字怎麼讀?估計、預測與客服流程
官方部落格有三組示範,分別對應估計、預測與串接成流程,每一組都是 Cloudflare 自己選的題目。
估計的示範是房屋成交價,輸入是五筆相近物件的成交價與一間待估的房子。模型給出中位數 415,000,p10 為 370,000,p90 為 470,000,代表模型認為有八成機率落在這個範圍。
它是帶著不確定性的猜測,不是查到的答案,而且官方沒有公布這間房子的實際成交價,所以區間準不準無從驗證。
預測的示範用美國機場安檢人數。官方設定是每天早上,根據到前一天為止的真實人數,請 Clairic 預測隔天人數,連續做 21 天,模型看到的歷史是最近 90 天。
其中一天預測中位數是 2,419,283,實際是 2,419,474。21 天平均誤差是 3.3%,實際值落在 80% 區間內的有 17 天。
80% 區間理論上會涵蓋約八成的實際值,21 天乘上 80% 約等於 16.8 天,17 天幾乎剛好,官方也據此說區間的表現符合預期。
不過樣本只有 21 天,而且沒落在區間內的 4 天,有 3 天落在哥倫布日連假週末,官方說明模型不會考慮序列裡看不到的假日。官方也承認預測功能很基本,不該取代專門的時間序列模型。
第三組是客服理賠流程,由 Clairic 抽取事實,Clef 決定處理方式,GLM-5.3 負責寫回信。官方比較兩種做法:全部交給 GLM-5.3,與三個模型串接。
這個流程的難點是維修費用。客戶的信裡沒有寫價格,所以它只能被估計。官方把這個欄位設成 10 到 5,000 美元之間的估計值,用對數刻度、間隔 1 美元,Clairic 回傳中位數與 80% 區間。
Clef 不讀原信,只讀一份含維修估計與政策的摘要。政策是送達 30 天內可退款,若維修費低於購買價的 60% 且不影響使用,就優先免費維修,所以估計值的高低會直接影響賠償方式。
串接版端到端 19.3 秒,全部交給 GLM-5.3 要 61.7 秒,官方稱省下 69% 時間,成本則是每百萬件 6,032 美元對 11,740 美元,省 49%。
拆開看,抽取步驟 Clairic 只要 0.46 秒,GLM-5.3 要 16.1 秒。決策步驟 Clef 約 0.22 秒,GLM-5.3 要 21.9 秒。串接版剩下的時間,幾乎都花在最後的回信,約 18.6 秒。
官方還提到一個穩定性的差異。GLM-5.3 在事實與決策上每次都答對,維修費的估計卻不穩定,三次分別是 250、250 與 220 美元,區間也不一樣,Clairic 的估計則每次相同。
官方另外說,Gemma 4 與 Qwen 在全 LLM 版本任務中失敗,原因是它們算不出維修費這類輸入裡沒有直接寫的值。官方一張圖也顯示,當 LLM 發現信裡沒有維修費就回傳 null,流程會在抽取步驟停下,後面的決策就無法進行。
這組比較有三個缺口。官方列出了每筆理賠的詞元數,串接版輸入 701、輸出 1,329,全 LLM 版輸入 390、輸出 2,544。
但官方沒有說明理賠樣本數與各模型單價,成功跑完的對照組也只有 GLM-5.3 一個模型。所以它最適合當成「值得測試」的理由,而不是效益保證。
示範之外,導入前還得算帳與確認使用條件。
Clairic 價格與限制:輸入詞元計費、上下文與預覽狀態
Clairic 的官方價格是每百萬輸入詞元 0.10 美元,頁面沒有列出輸出詞元價格,因為它不產生輸出詞元。
詞元是模型讀取內容的計費單位。照這個價格估算,一封約 1,000 詞元的信,只做欄位抽取,輸入成本約 0.0001 美元,也就是約萬分之一美元。實際花費還要加上欄位定義,所以用回應的 usage 對帳最準。
文件列出的限制有幾項。上下文視窗是 65,536 詞元,至少要有一個欄位,欄位多到一次放不下時,會拆成多個平行處理的段落,每段以 8,192 詞元為單位。
Clairic 模型頁沒有列出速率限制,所以想大量使用前,要自己測在你的帳號下能跑多快。條款部分,官方寫明模型依「現狀」提供,不附保證,Cloudflare 可以停止提供,而且不退款。
這些條款在預覽階段很常見,但對要放進正式流程的團隊是實際風險。建議把 Clairic 的呼叫包成獨立的一層,萬一模型更新或下架,可以換成別的服務或改回人工處理。
價格與限制看起來可接受之後,要判斷的是自己的工作適不適合。
適合誰、不適合誰:導入 Clairic 前的檢查清單
Clairic 適合把雜亂文字變成固定欄位的工作,而且結果可以由後面的程式或人檢查。
適合先試的情境包括客服信件裡的訂單編號與金額、收據與發票的欄位,以及需要估計區間的數字。官方示範涵蓋的正是客服信件、收據與發票,工單或營運報告這類文件,官方沒有示範,要用自己的樣本確認。
不適合的情況同樣明確。多步驟計算還不穩定,官方建議讓程式碼做數學,不要讓模型連續推算。需要完整預測模型的場合,也不該拿 Clairic 取代專用的時間序列工具。
錯誤代價高的決定更要小心,官方文件說得很直接:在重大或不可逆的動作之前,要用其他證據交叉檢查,或要求人工覆核。像付款、理賠核定或醫療判斷,都屬於這一類。
建議先用 100 筆真實資料做驗證。每個欄位先準備正確答案,看抽取的正確率,再看信心分數是否真的有鑑別力:信心高的是否真的比較準,信心低的是否真的比較常錯。
接著設定人工覆核的門檻。例如信心低於某個值、或 p_null 偏高時,就交給人處理。估計欄位則要檢查 80% 區間是否真的涵蓋約八成的實際值,官方也提醒區間在陌生資料上可能偏窄。
驗證完成後,還要留意幾項官方公開的限制。
Clairic 的限制與風險:預覽版、單一來源與格式不等於正確
最需要記住的一句話是,有型別的輸出不等於正確的輸出。
官方文件明說,欄位格式正確不保證答案正確,信心分數與區間也不是保證,涵蓋率可能因資料不同而變化。部落格也寫到,答案是格式完整但不一定正確。
官方列出的弱點有幾項。多步驟算術在較長的鏈條上還不可靠,估計需要輸入裡有足夠證據,區間在不熟悉的資料上可能偏窄,預測功能只是基本款,連假前後會失準。
官方概念頁還有一個容易忽略的提醒:估計與預測欄位即使輸入幾乎沒有資訊,也會回傳一個預測,不像單一數值欄位會回 null。所以拿到估計值,不代表輸入足以支持它。
其次是證據只有一個來源。部落格稱 Clairic 的準確度、延遲與成本都明顯優於傳統語言模型,但文中只有上述示範,沒有附準確率評測表,也沒有獨立團隊的評測或可重現的公開資料集。
第三是預覽版本身的風險。官方稱它是早期檢查點,預期會再改善,這代表輸出可能隨版本變動。如果你的流程需要同樣輸入永遠得到同樣結果,上線前要鎖定版本並留下測試集,每次更新都重跑。
最後是使用範圍。目前沒有開放權重,所以無法放到自己的機器上跑,資料必須送到 Cloudflare 的 Workers AI。涉及個資或機密文件的團隊,要另外確認資料處理條款,這部分不在本文查證範圍內。
延伸閱讀:AI Agent 為什麼需要決策層?用 Jev、Laya 看懂模型路由、工具選擇與風險控管
Clairic 常見問題
Clairic 和 Clef 有什麼不同?
Clef 是決策模型,從你給的固定選項中選一個並回傳每個選項的機率。Clairic 是抽取模型,回傳你定義型別的值,例如金額、日期或估計範圍,兩者可以串在同一條流程裡。
Clairic 是開放權重模型嗎?
目前不是。官方說打算很快以開放權重釋出,但沒有給日期。現在只能在 Workers AI 上以預覽版呼叫,Cloudflare 也保留停止提供的權利。
Clairic 可以取代 OCR 或大型語言模型嗎?
官方沒有拿它和 OCR 工具比較,所以不能這樣說。它支援圖片輸入,也能抽出收據照片裡的欄位,但是否適合你的文件,需要用自己的樣本測試。語言模型仍負責寫回信這類開放內容。
Clairic 怎麼收費?
依官方模型頁,每百萬輸入詞元 0.10 美元,沒有列出輸出詞元價格。欄位定義也會佔用輸入詞元,實際用量請看回應裡的 usage。
結語:先挑一種欄位固定的工作,用 100 筆資料驗證 Clairic
Clairic 最確定的是設計:它從文字取得有型別的數值,每個答案都帶著信心或區間,價格是每百萬輸入詞元 0.10 美元。官方稱它又快又便宜,但這部分目前只有官方示範支持,最不確定的是它在你的資料上有多準。
如果你有一批欄位固定的信件、收據或工單,可以先用 Workers AI 試跑 100 筆,對照正確答案,再決定信心門檻與人工覆核的比例。
想持續追蹤 Cloudflare、決策模型與 AI 代理工具的官方更新,可以免費訂閱 AI 郵報,後續更新會以官方文件為準。
資料來源
- Cloudflare 官方部落格,Introducing Clairic:https://blog.cloudflare.com/clairic-extraction-model/
- Cloudflare 官方文件,Clairic 模型頁:https://developers.cloudflare.com/workers-ai/models/clairic/
- Cloudflare 官方文件,Extraction models 概念:https://developers.cloudflare.com/workers-ai/concepts/extraction-models/
- Cloudflare 官方部落格,Introducing Clef:https://blog.cloudflare.com/clef-decision-models/
- X 熱度線索,作者 Michelle Chen 貼文:https://x.com/michellechen/status/2112241006104244584