DiscoveryRSI 是什麼?6.3% 假說命中率怎麼讀,AI 科學發現的方法與限制
DiscoveryRSI 讓 27B 模型學著提出可檢驗的研究假說,論文稱後續文獻對應率為 6.3%,GPT-6 為 2.5%。本文依 arXiv 論文與 GitHub 說明評測口徑、DFM-Bench、專家審查與限制,釐清 6.3% 不是準確率。

DiscoveryRSI 的論文在 2026 年 10 月 16 日上傳 arXiv。
原作者 Ling Yang 在台灣時間 10 月 19 日上午的 X 貼文寫道:DiscoveryRSI-27B 提出的假說有 6.3% 與後來發表的研究相符,GPT-6 是 2.5%,Claude Opus 5 是 2.3%。
這組數字很容易被讀錯。百分比看起來像準確率,有人會以為模型提出的假說有 6.3% 是對的,也有人看到 6.3 對 2.5,直接聯想成領先兩倍多。
實際上,論文衡量的是「假說版本中,有多少比例在模型截止日期之後的論文裡,找得到可對應的實驗設計、對照組、量測方式或待補的證據缺口」。所以它衡量的是和文獻的連結,不是假說為真的機率。
這項研究值得讀,是因為它想回答一個更難的問題:AI 研究助理提出的假說,怎麼判斷有沒有價值。論文先定義什麼是有價值且可檢驗的假說,再讓開放的 27B 模型靠自己的研究過程資料,一輪一輪學著做得更好。
我的判斷是,它適合做科學代理、研究流程或評測方法的人細讀,因為程式碼、模型與評測框架都已公開。不適合把 6.3% 當成「AI 已能做科學發現」的證據,也不適合把輸出直接用在醫療決策。
這個判斷建立在方法上,所以得先弄清楚 DiscoveryRSI 這個名字背後的做法。
DiscoveryRSI 是什麼?一套讓模型學習提出可檢驗假說的框架
DiscoveryRSI 是 Gen-Verse 在 GitHub 公開的研究框架,由多代理研究流程、27B 開放模型與評測基準三部分組成。
名稱裡的 RSI 是遞迴自我改進的縮寫,意思是系統把上一輪的研究經驗,拿來改進下一輪的做法。DiscoveryRSI 把這個概念放在科學假說上,焦點在生命科學。
論文先給了一個操作型定義。一個研究假說包含四個部分:有證據支持的主張、可行的調查計畫、事先講好如何解讀結果的判斷標準,以及其他可能的解釋。
在這個定義下,假說是否「有價值」,看的是解開它能不能實質增加理解,或改變研究決策。是否「可檢驗」,則看計畫在限制條件下做不做得到,結果能否支持、削弱或界定主張。論文強調,這評估的是研究機會,不是主張本身為真。
公開資源相當齊全。論文在 arXiv 編號 2610.23839,GitHub 倉庫是 Gen-Verse 的 DiscoveryRSI。
Hugging Face 上有 DiscoveryRSI-27B 模型與假說任務範例資料集,另有名為 DFM-Bench 的評測基準。
倉庫的專案程式碼採 Apache-2.0 授權,模型卡也標示 Apache-2.0,基底模型為 Qwen3.8-27B,釋出的是第二輪、第 150 步的檢查點。
這些資源定位在研究用途,所以 README 明說它不是醫療器材,也不內含病患資料、英國生物銀行資料、私人紀錄或實驗室設備,使用者要自備有權使用的資料。
資源公開之後,更值得追問的是它怎麼運作,因為只有理解流程,才看得出 6.3% 是從哪裡來的。
DiscoveryRSI 怎麼運作?假說樹、Harbor 任務與三種遞迴學習
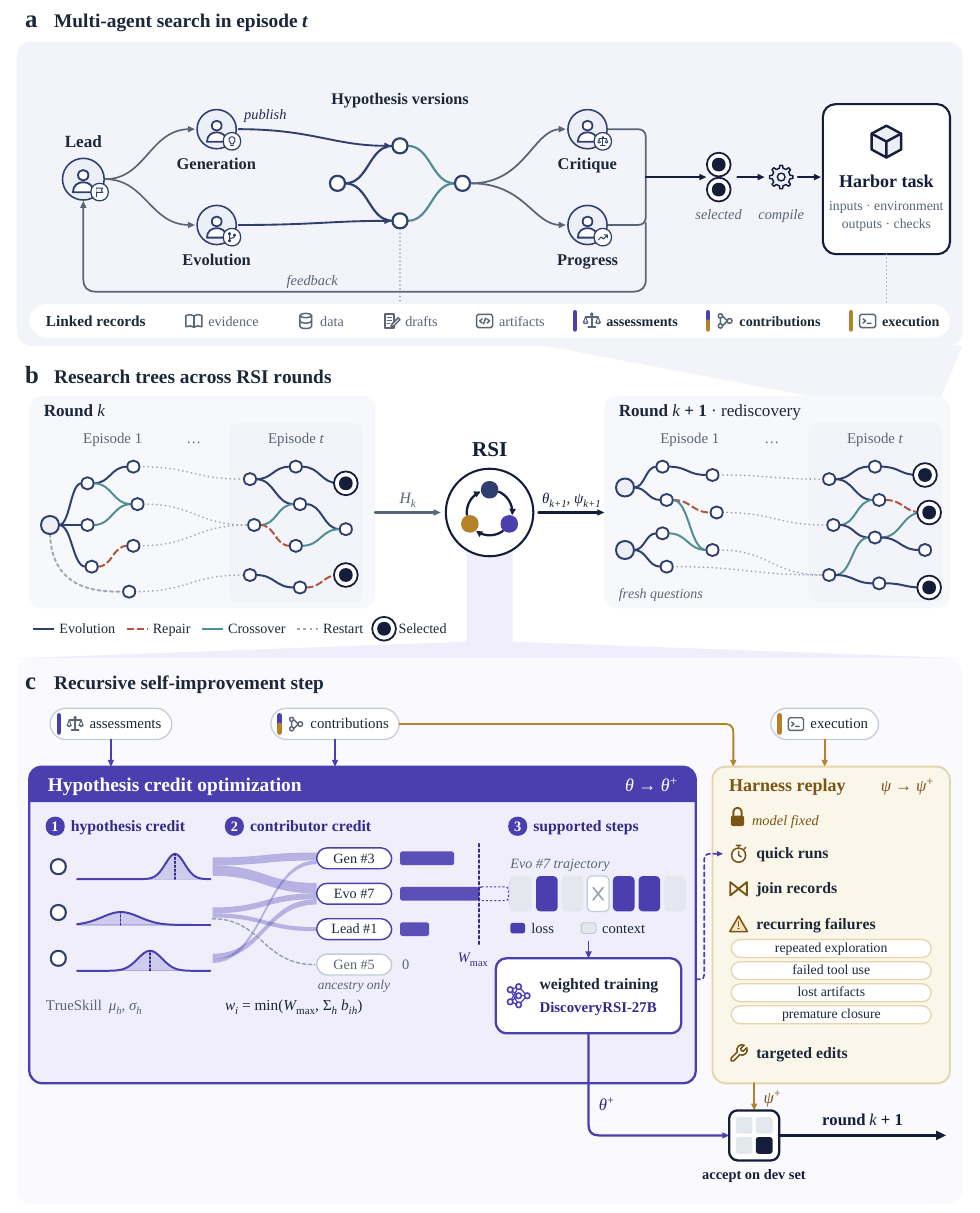
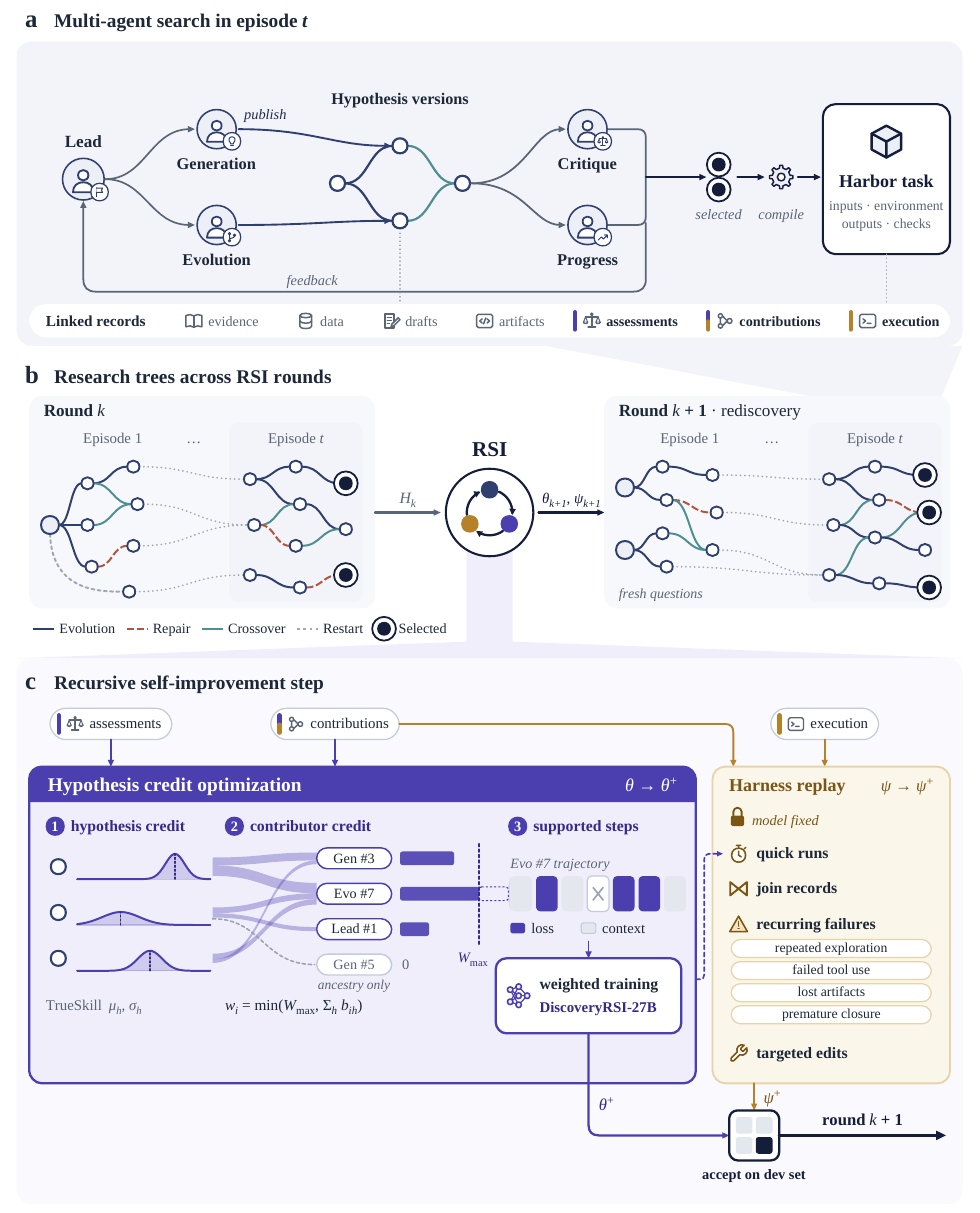
DiscoveryRSI 的核心是讓多個代理一起長出假說樹,再把好的研究計畫編成可執行的任務,從結果中學習。
每一輪研究由幾個角色分工,所以假說不是由單一模型一次寫完。主導者負責選方向與操作,生成與演化角色提出新假說或修改舊假說,批評角色以盲評比較優劣,進度角色判斷修改是否真有實質進展。
假說會形成一棵有版本與親代關係的樹,因此每次修改都能追溯到來源。操作包含演化、修復、交叉組合與科學式重啟,其中重啟是放棄舊方向、從新的問題重新出發。
被選中的調查計畫,會被編譯成 Harbor 任務。每個任務有輸入、執行環境、必要輸出與驗證檢查,拿不到的資料或需要實體實驗的部分,則被明確記成相依條件,所以系統不會假裝已經完成。
學習靠假說信用最佳化、流程回放與重新探索接力完成。
假說信用最佳化負責打分與分配功勞。它用類似棋賽排名的配對比較替假說打分,再把功勞分給實際貢獻的步驟,因此貢獻大的步驟,會在模型的監督式學習中得到較高的權重。
流程回放則在模型權重固定不動時進行。系統回頭檢查常見的失敗,例如重複探索、工具用錯、遺失成果與過早結束,然後提出流程修改,但必須在對照評估中表現較好才會被採用。
重新探索負責把成果送進下一輪。已被接受的模型與流程更新,會拿去處理新的研究問題,所以每一輪都會產生新的經驗,再進入下一輪學習。
訓練規模在論文中有交代。系統收集了 15,792 條研究軌跡,篩出 2,397 條用於訓練,全參數微調、上下文 256K,只訓練一個週期,其中直接被監督的詞元約占 2.12%,因此大部分內容只是提供上下文。
有了方法,下一個問題是怎麼證明它變好了,這就要看 DFM-Bench 的自動評分。
延伸閱讀:讓 AI 在歷史中「做夢」實現自我進化!Google DeepMind 發表 Dream-RSI:告別微調權重,探索算力成本暴降 162 倍,揭開遞歸自我改進(RSI)新範式
DiscoveryRSI 的 DFM-Bench 評分:從 4.86 進步到 5.39,換掉了什麼
自動評分顯示 DiscoveryRSI 讓假說更容易被檢驗,但重要性與新穎性反而下降。
DFM-Bench 把研究分成五層來評:單一假說、修改的價值、發展路徑、整次研究,以及科學貢獻。單一假說用八個面向打分,包括重要性、新穎性、依據、可否證、資料可解答性、可行性、替代解釋與可行動性。
論文在生命科學四個領域測試,涵蓋臨床與族群健康、治療標靶優先順序、疾病機制與族群多體學,共 241 個研究問題。評分者是 GPT-5.6 Sol,也就是只有一個評審模型。
論文附錄說明,評分由同一模型家族扮演三種審查角色完成,測的是彼此相關的 AI 觀點,不是三位獨立專家。
平均假說品質從基礎模型的 4.86,在第一輪升到 5.18,第二輪升到 5.39。附錄說明分數是 1 到 10 分的加權平均,八個面向的權重固定,論文稱這是內部慣例,不是經實證的最佳權重。
所以這個數字更適合比較同一套評分下的前後變化,不適合當成研究好壞的絕對分數。
| 面向 | 基礎模型 | 第二輪後 |
|---|---|---|
| 可否證 | 4.00 | 6.20 |
| 資料可解答性 | 3.73 | 4.99 |
| 替代解釋 | 4.44 | 5.98 |
| 可行性 | 4.79 | 5.87 |
| 重要性 | 6.48 | 6.04 |
| 新穎性 | 4.87 | 4.58 |
表格說明了這次進步的性質。模型學會把假說寫成可否證、資料拿得到、考慮替代解釋的樣子,但重要性與新穎性分數下降,所以它更像是在把想法變成可執行的研究計畫,而不是產生更驚人的點子。
行為也跟著改變。修復與演化的比例從 77.5% 升到 91.7%,科學式重啟從 21.7% 降到 5.0%,這代表模型更常修補既有假說,較少推翻重來。
但自動評分只能說明在這套標準下的進步,是否符合專家的看法,要看人工審查。
DiscoveryRSI 的 6.3% 假說命中率怎麼讀?與後續論文對應不等於準確率
6.3% 是模型提出的假說版本中,有後續論文可對應的比例,但它描述的是文獻連結,不是正確率。
論文建立了一個共同的參考文獻庫,包含 16,440 篇已解決的論文,來自 420 次引文追蹤,因為每個模型的知識截止日期不同,所以依各群組的截止日期過濾,只保留截止日期之後的論文。
判斷標準是,截止日期之後的論文是否提供了和假說有關的實驗設計、對照組、量測方式,或可檢驗的證據缺口。流程分兩步,先要求候選文獻與假說至少共用三個非停用詞,再由 GPT-6 Luna 做語意判斷,命中率就是獲得肯定判斷的假說版本比例。
論文自己說明,這些標籤是彼此相關的自動判斷,不是獨立的專家審查。沒有被標成肯定的假說,也可能只是檢索沒涵蓋到。
| 模型 | 假說版本數 | 命中數 | 命中率 |
|---|---|---|---|
| DiscoveryRSI-27B | 1,176 | 74 | 6.3% |
| DeepSeek | 257 | 14 | 5.4% |
| GLM | 36 | 1 | 2.8% |
| GPT-6 | 2,341 | 59 | 2.5% |
| Claude Opus 5 | 131 | 3 | 2.3% |
這張表顯示,X 貼文只挑了 GPT-6 與 Claude Opus 5 來比。論文本文與倉庫的圖還有 DeepSeek 與 GLM,其中 DeepSeek 是 5.4%。
DiscoveryRSI 對它只多 0.9 個百分點,這個差距和「領先兩倍多」的印象很不一樣。
樣本數的差異也很大,所以單看百分比容易失真。GLM 只有 36 個版本,命中 1 個,Claude Opus 5 有 131 個版本,GPT-6 則有 2,341 個。
論文只呈現描述性的百分比,沒有做顯著性檢定,同一研究家族的版本與共用的判斷也彼此相依。
截止日期也不一致。論文附錄列出 Qwen 為 2025 年 4 月(暫定的家族代理),Claude Opus 5 為 2026 年 5 月,GLM-5.3 為 2026 年 8 月,DeepSeek V4.1 為 2026 年 9 月。
DiscoveryRSI-27B 以 Qwen 為基底,附錄沒有另列它的日期。
論文強調,這些日期只為了讓比較可重現,不代表模型內部的知識截止日。但各組能對應的文獻期間因此長短不一,期間愈長,一般愈有機會找到對應,這是本文的推論,論文沒有量化影響。
領域差異也很大。DiscoveryRSI 在治療標靶優先排序是 16.9%(30 比 178),人口多體學 7.4%,疾病機制 6.8%,臨床與族群健康只有 2.3%(13 比 557)。
所以 74 個命中裡有 30 個來自單一領域,6.3% 的平均值不能代表每個領域。
Claude 的數字還有一個技術因素。論文說,它的 131 個提案只有 15 個通過檢索門檻,約 11.5%,DiscoveryRSI 則是 355 個、約 30.2%。
Claude 提案的中位長度是 41,134 字元,檢索只讀前 6,000 字元,作者認為提案開頭的修改紀錄可能擠掉科學內容。
論文改用提案標題檢索,Claude 通過的數量從 15 增加到 95,但這只證明結果對寫法敏感,並沒有增加肯定判斷。
更關鍵的是,進入語意判斷之後,兩者的肯定比例很接近,Claude 是 20.0%(3 比 15,樣本很小),DiscoveryRSI 是 20.8%。換句話說,6.3% 對 2.3% 的落差,主要來自有多少提案進得了檢索,而不是進入判斷後的表現。
論文也承認,要用結構化的科學表述,對所有組別重新判斷,才能知道這對最終比較有多大影響。
因此 6.3% 更適合這樣讀:在這套檢索與判斷流程下,DiscoveryRSI-27B 的假說比較常被後續文獻接上,其餘約九成三沒有找到對應,並不代表它們是錯的,只是沒有被這套流程找到。
另外,論文自己也寫到,這衡量的是文獻連結,不是研究者是否採納,而且也還沒有用實驗驗證這些假說。
命中率是自動流程的結果,專家怎麼評價,則是另一組證據。
專家審查與開放資源:誰評分,能取得什麼
專家審查的結果好壞參半,論文自己也稱它是初步結果。
審查者有 27 位,包含醫師、醫學系學生與生物科學博士生,由三位資深督導帶領,共看 292 份提案,來自六組資料集。順序隨機,來源與 AI 評分都被隱藏,並要求忽略修改歷史,所以審查結果比較不受品牌或 AI 分數影響。
審查者先給整體研究價值的五分制判斷,再依六項錨定標準各給四分制評價。DiscoveryRSI-27B 在重要性得 3.10,GPT-6 Luna 得 2.94,在「主張合理且受證據限制」得 3.37 對 3.16。
但另外四項沒有領先。「相對已知研究的進展」兩者同為 2.31,GPT-6 Luna 在資料適配度、替代解釋與結果資訊量三項分數較高。論文自己也說,修改成效較好,與單篇提案仍有弱點是並存的。
論文也看了每次修改的成效。依人類評分,DiscoveryRSI-27B 的修改有 41% 變好、47% 沒變、12% 變差,平均每次修改變化 +0.07。
GPT-5.6 Sol 是 31%、37%、32%,平均 +0.03,GPT-6 Luna 是 25%、44%、31%,平均 -0.01。
自動評分裡重要性下降,專家卻給它高於 GPT-6 Luna 的重要性,這並不矛盾,因為前者比的是同一模型的前後兩輪,後者比的是兩個不同模型,兩者不能互相佐證。
審查者人數與提案數有限,所以只能說,DiscoveryRSI-27B 的修改較少讓提案變差,但單篇提案的品質,並沒有全面勝過 GPT-6 Luna。
想自己看細節的人,資源都已公開,所以可以直接下載來檢查。GitHub 倉庫提供代理核心、模型適配器、角色提示、工具登錄、回放儲存與領域適配器。
安裝後可用 demo 指令跑兩輪示範,也能用 vLLM 把 27B 模型啟動成相容 OpenAI 介面的服務。
倉庫也支援 Codex、Claude Code 等其他模型端點。README 還說,在配對實驗中,它選出的獨特假說比基礎模型多 16.7%,編譯成的 Harbor 任務多 50%,這是倉庫的說法,論文中的主要評測則是前面的數字。
線上還有一個由 PhAI Labs 運作的展示場,可以看不同模型的候選假說與假說樹生長過程,原作者在 X 的影片也是這個展示。
了解可以取得什麼之後,要判斷的是誰該花時間使用。
延伸閱讀:Project Quine 把 AI 接進生物研究:提出假說之後,實驗證據才是關鍵
適合誰、不適合誰:導入 DiscoveryRSI 前的檢查清單
DiscoveryRSI 適合研究 AI 科學代理、評測方法,或想把自己領域的研究流程做成可回放系統的團隊。
它的價值在可拆解,所以你可以只借用假說的結構化定義、八個評分面向,或流程回放的做法,不必採用整套框架,因為這些設計對任何要讓代理提出研究計畫的產品都有參考意義。
不適合的情況很清楚。想拿它直接產生藥物或臨床結論的人不適合,因為模型卡明說它不是醫療器材,不該用於臨床決策。沒有領域專家審查的團隊也不適合,因為輸出可能看起來很專業,內容卻缺乏依據。
導入前先確認自己的資料能不能合法使用,因為倉庫不附任何受限資料。接著要估算硬體,Hugging Face 頁面的中繼資料顯示約 28B 個 BF16 參數,依參數量粗估,光放權重就需要約 56 GB 的記憶體,實際需求請看官方部署說明。
最後找一個領域專家,用自己的研究問題讓模型提出假說,請專家依論文的四個要素檢查:主張有沒有依據、計畫做不做得到、判斷標準是否事先講明、替代解釋有沒有被考慮。
專家的看法比任何分數更重要,因為論文的自動評分只有一個評審模型,而且評分高不等於研究好。
通過這些檢查之後,也要清楚知道這項研究目前還有哪些限制。
DiscoveryRSI 的限制與風險:沒有實驗驗證,評分也只有一個評審
最大的限制是,這些假說還沒有用實驗驗證,所有證據都在文獻對應與專家打分的層次。
論文承認的限制有幾項。自動分數依賴單一評審模型,人類審查只是初步,文獻對應也是自動判斷。跨模型的比較在群組大小、領域、截止日期與檢索涵蓋上並不一致,Claude 的數字對檢索格式也敏感。
論文還說,廣度探索與預算效率變化不大,重要性與新穎性分數下降,個別提案仍有缺點。這些都是作者自己列出的弱點,但也代表論文的結論相對保守。
README 與模型卡另外提醒,系統可能提出看似合理卻沒有依據的主張、漏掉相關證據、誤讀資料來源,或提出做不到的實驗,輸出需要專家審查與獨立驗證。
另一個風險是名稱帶來的聯想。RSI 常被連到「AI 自己變得更強」的討論,但這項研究的遞迴只在特定研究流程與模型微調內發生,不代表模型在所有能力上持續自我提升。
最後是使用層面的風險。自行部署時,你要負責資料授權、隱私與審查流程,因為它不會替你判斷哪些假說值得投入實驗經費。
DiscoveryRSI 常見問題
DiscoveryRSI 的 6.3% 是準確率嗎?
不是。它是模型提出的假說版本中,在截止日期之後的論文裡找得到對應實驗設計、對照、量測或證據缺口的比例。這個比例說明文獻連結,不代表假說已被證實。
DiscoveryRSI-27B 可以自己下載使用嗎?
可以。模型在 Hugging Face 以 Apache-2.0 公開,基底是 Qwen3.8-27B,倉庫提供用 vLLM 啟動的方式。模型為 BF16 權重,需要足夠的記憶體,且必須自備合法的資料。
DiscoveryRSI 的 RSI 是什麼意思?
RSI 是遞迴自我改進,指系統把上一輪研究的經驗用來改進下一輪。在這個專案裡,它指的是模型訓練與研究流程的逐輪改進,範圍限於論文描述的假說研究。
DiscoveryRSI 可以用在醫療決策嗎?
不行。模型卡說明它不是醫療器材,不應用於臨床、診斷或治療決策,README 也要求有合格專業人員監督,輸出需要專家審查與獨立驗證。
結語:把 DiscoveryRSI 當成研究方法來讀,不要當成發現的證明
DiscoveryRSI 最確定的貢獻,是把「什麼是好假說」寫成可評分的定義,並公開程式碼、模型與評測基準。最不確定的是這些假說在實驗室裡能走多遠,因為目前還沒有實驗驗證。
如果你在做科學代理,可以先借用它的假說定義與八項評分面向,檢查自己系統的輸出。如果你只是想了解 AI 與科學發現的進展,記得 6.3% 是文獻連結的比例,不是成功率。
想持續追蹤 AI 研究與科學代理的原始論文解析,可以免費訂閱 AI 郵報,後續更新會以論文與官方資料為準。
資料來源
- arXiv 論文,DiscoveryRSI: Recursively Learning to Discover Valuable Hypotheses:https://arxiv.org/abs/2610.23839
- arXiv 論文網頁版:https://arxiv.org/html/2610.23839v1
- GitHub,Gen-Verse/DiscoveryRSI:https://github.com/Gen-Verse/DiscoveryRSI
- GitHub,DFM-Bench:https://github.com/Gen-Verse/DFM-Bench
- Hugging Face,DiscoveryRSI-27B 模型卡:https://huggingface.co/Gen-Verse/DiscoveryRSI-27B
- X 熱度線索,原作者 Ling Yang 貼文:https://x.com/LingYang_PU/status/2111997117774594312