語音 AI 代理只看逐字稿夠嗎?Tazo 的音訊決策層主張與論文證據怎麼讀
語音 AI 代理多半先把通話轉成逐字稿再決策,Tazo Labs 的 Naman Jain 主張這會丟掉語調與停頓。本文核對原長文引用的論文,說明 74.8% 與 39% 兩個數字的條件,以及音訊決策模型目前能驗證與不能驗證的部分。

多數語音 AI 代理接電話時,用來做決定的不是聲音,而是一份逐字稿,這是 Tazo Labs 的 Naman Jain 提出的看法。
台灣時間 2026 年 10 月 19 日晚間,他在 X 發表長文〈Voice agents aren't listening. They're reading.〉,主張語音 AI 最大的缺口,就是代理根據逐字稿而不是音訊做決策。
這個說法很容易引起共鳴。多數人都遇過客服機器人在你停頓時插話,或你已經說完,它卻等了很久才回。長文也引用多篇論文,稱加入音訊能大幅降低錯誤。這則貼文查詢時約有 52.6 萬次瀏覽,但瀏覽數只是熱度,不是證據。
但作者在文末寫明,自己正在 Tazo Labs 打造這一層模型。也就是說,長文的結論同時是產品的行銷主張,而 Tazo 的官方部落格目前沒有公布效能數字,所以最能核對的,是長文引用的論文。
核對的結果是,74.8% 與 39% 這兩個最醒目的數字都真的存在,但條件比長文呈現的窄。前者來自單一專有電話資料集上的端點偵測實驗,後者的任務是判斷一句話是不是對助理說的,兩者都不是「音訊模型勝過逐字稿」的一般證明。
我的判斷是,正在做或採購語音代理的人,可以把這篇長文當成「該量哪些問題」的清單。但不適合把它當成必須換成音訊決策模型的理由,因為這類模型目前沒有公開的獨立評測,也沒有公開價格。
要看出這些數字能支持什麼,得先從語音代理現在怎麼運作開始。
語音 AI 代理怎麼做決定?先看串接式流水線與靜默計時器
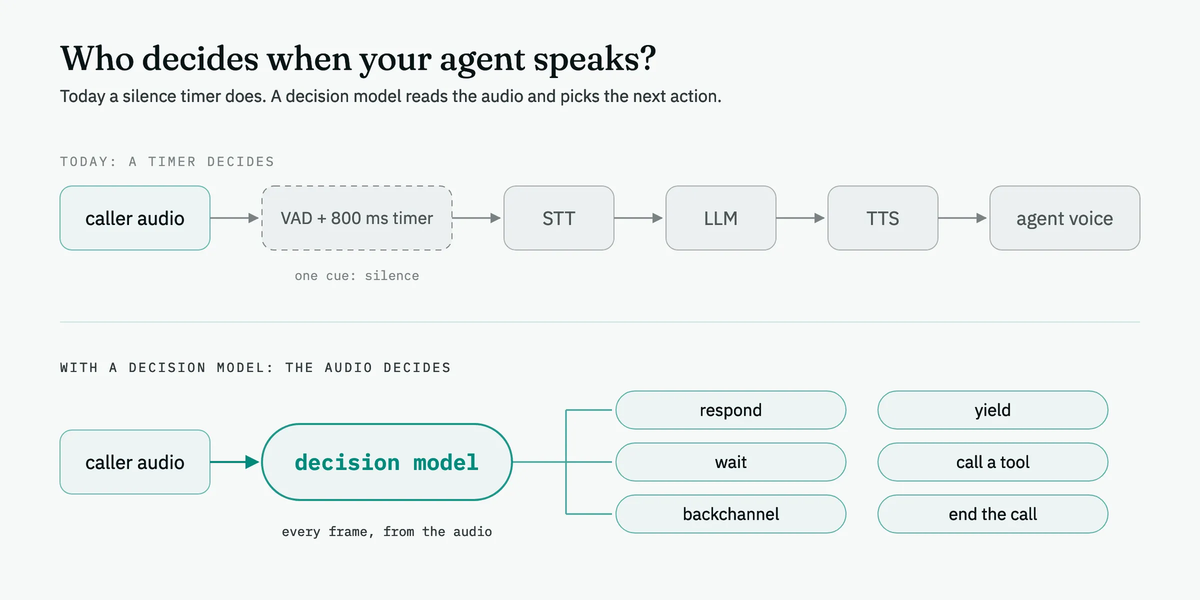
多數語音 AI 代理採串接式架構,聲音先被轉成文字,再由語言模型思考,最後再轉回語音。
這三段分別是語音轉文字、大型語言模型與文字轉語音。長文說工程師偏愛這種設計,是因為每一段都能挑最好的模型,每個中間步驟都看得到,也能緊緊控制代理說什麼、做什麼。
問題出在轉換。長文認為,從音訊轉成文字是有損失的,只有字詞留下來,猶豫、拖長的語氣、句尾的語調下降、背景噪音,以及對方轉頭和別人說話,這些都不在逐字稿裡。
於是代理只能猜。它可能在你想事情時插話,也可能在你講完之後等太久,或把禮貌語氣下的不耐煩當成一般詢問。長文把這個負責「知道現在該做什麼」的環節,稱為思考層。
這裡有一個需要補充的細節。Tazo 自己的部落格寫到,多數部署在轉文字之前,先用語音活動偵測加上靜默計時器,判斷使用者是否說完。語音活動偵測是判斷有沒有人在出聲的程式,Tazo 引用的 Daily 參考設定,是靜默 0.8 秒就視為說完。
但同一篇文章也承認,判斷說完了沒這件事,業界已經在改用音訊。
它舉了 Daily 的 Smart Turn、Krisp 的音訊模型、LiveKit 的 Turn Detector 與 Deepgram 的 Flux 為例,並提醒這些多半是廠商自己的基準。
所以「語音代理只看逐字稿」說得太滿。Tazo 真正的主張更窄:說完了沒已經有音訊方案,但回應、等待、附和、讓出發言與呼叫工具這一整組決策,還沒有一個統一的音訊模型。
長文另外引用了兩組產業數字。一組是 Deepgram 與 Opus Research 在 2025 年 3 月發布的調查,訪問 400 位北美企業主管,只有 21% 對現有語音技術「非常滿意」。
另一組是 G2 的分類頁列出超過 800 個語音 AI 產品。
這項調查問的是現有的語音技術,並不限於已上線的 AI 代理,長文把它寫成「對上線中的代理非常滿意」,範圍稍微放大了。數字是真的,但用法要留意。
接下來要看的,是長文用哪些論文支持「逐字稿丟掉重要資訊」。
延伸閱讀:Mercury Voice 主打 320 毫秒開始回答:語音 AI 變快,不能只看模型那一段
逐字稿丟掉了什麼?幾篇論文能證明與不能證明的事
這幾篇論文都支持「音訊帶著文字沒有的訊號」,但各自回答的是不同的問題,不能合併成一個通用結論。
先看長文最醒目的圖:只看逐字稿時,74.8% 的對話輪次被提早打斷,加入音訊後降到 7.8%。它的出處是 Uniphore 研究者在 2026 年 9 月上傳的論文,題目是在探討語音的哪些面向能驅動端點偵測。
端點偵測就是判斷說話者何時說完。論文做的是受控的消融實驗,也就是把聲學、韻律與文字三種訊號分別拿掉或加入,比較哪個組合最好。測試資料是 5,000 句真實的電話對話,涵蓋銀行、保險、零售與電信。
| 輸入訊號 | F1 | 誤判提早說完 | 中位延遲 |
|---|---|---|---|
| 只有聲學 | 0.927 | 9.2% | 440 毫秒 |
| 只有韻律 | 0.828 | 25.6% | 960 毫秒 |
| 只有文字 | 0.292 | 74.8% | 640 毫秒 |
| 聲學加文字 | 0.875 | 14.6% | 460 毫秒 |
| 聲學加韻律 | 0.930 | 7.8% | 400 毫秒 |
| 韻律加文字 | 0.747 | 28.5% | 640 毫秒 |
| 三者全用 | 0.909 | 10.7% | 360 毫秒 |
表格顯示,長文說的「音訊 7.8%」其實是聲學加韻律的組合,「逐字稿 74.8%」則是只用文字的版本。表中的誤判提早說完,指每句話第一次偵測就太早的比例。
加入文字沒有幫助,反而讓提早打斷增加,論文認為說話的結束主要靠語調與停頓傳達,而不是語意是否完整。
不過這個比較有幾個條件要記得。資料是 Uniphore 的專有英文電話資料集,外界無法取得,而且只取單一說話者連續占線、對方聲道活動低於 10% 的片段,所以不含插話與重疊說話。
分類器只訓練一個約 26 萬參數的小模型頭部,文字端是一個小型句子編碼器,每出現新詞就更新一次,不是讀完整逐字稿的大型語言模型。
文字版的延遲只在 5,000 句中的 853 句上計算,論文自己稱它樂觀而且不可靠。論文也寫明,結果限於同領域的兩人英文電話,在低資源語言或吵雜環境這類聲學線索較弱的情境,文字可能更有用。
第二個數字是 39%。長文說,Apple 測試一句話是不是對助理說的,加入音訊後錯誤最多降低 39%。
對應的是 2024 年的裝置導向語音偵測論文,作者來自 Technische Hochschule Nürnberg 與 Apple,其中一位的研究是在 Apple 實習期間完成。
這項研究把等錯誤率當作指標,也就是誤接受與誤拒絕一樣多時的錯誤率。最佳純文字系統是 12.15%,最佳多模態系統在 CLAP 音訊特徵下是 7.45%,相對改善約 38.7%,也就是摘要寫的最多 39%。
但同一組實驗換成 Whisper 音訊特徵,對純文字的改善是 34.6%,所以「最多」要照字面讀。最佳多模態系統還併用語音辨識的解碼訊號,所以也不只是「加上音訊」。
更重要的是,這個任務是判斷語音有沒有對著助理說,不是判斷輪流說話的時機,兩者不能直接互換。
第三組是 Meta 與卡內基美隆大學的串流檢索增強研究,長文引用它說明「提早預測工具查詢可降低 20% 延遲」。論文確實寫到工具使用延遲少了 20.7%,中位數從 2.78 秒降到 2.20 秒。
但這只是整段等待中的一環。使用者聽到第一個字的總延遲,中位數從 5.90 秒降到 5.32 秒,只少約 9.8%。
那篇論文的準確率從 11.1% 提高到 34.2%,比較對象是不查資料的模型,測試的是 Qwen2.5-7B 的語音進、語音出模型,不是逐字稿對音訊。論文也說這個做法同樣適用於打字輸入,所以它支持的是提早啟動工具的做法,而不是音訊勝過文字。
第四篇是 2026 年 3 月的 DualTurn,用 5 億參數的模型在雙聲道通話音訊上預訓練,預測輪流說話的訊號。它在動作預測的加權 F1 為 0.633,高於 VAP 的 0.389。
在字詞層級的輪流預測,它的 AUC 0.930 也高於一個 31 億參數的音訊加文字模型的 0.880。但比較對象是 VAP 與音訊加文字模型,沒有只讀逐字稿的對照。
論文摘要也把現行語音流水線描述為仰賴靜默逾時,與 Tazo 對現況的描述一致。
Tazo 部落格另外引用一項真人研究。Skantze 與 Irfan 在 2025 年人機互動會議發表,39 位成人與 Furhat 機器人對話,比較靜默計時器與 VAP 加 TurnGPT 兩種做法。
新做法的回應時間中位數是 1.5 秒,計時器是 2.7 秒,打斷率則從 16.6% 降到 6.9%。
這是少數用真人測試的證據,但新系統同時用了音訊與文字,比較對象是靜默計時器,不是純逐字稿。
Tazo 部落格寫 30 位偏好新系統,論文則是 9 位偏好基準、3 位沒有偏好,也就是 27 位偏好新系統,所以連 Tazo 引用的數字也要回原文核對。
整體來看,這些論文證明了在特定任務上,音訊與韻律提供文字沒有的線索,真人研究也只證明學習式輪流模型勝過靜默計時器。
這些研究都沒有證明一個獨立的音訊決策模型,在你的通話上會比讀逐字稿的大型語言模型更好。要看這個主張具體指什麼,得看 Tazo 對決策層的定義。
音訊決策層是什麼?Tazo 主張的運作方式與三種用法
音訊決策層是一個直接聽通話音訊、從你定義的選項中挑一個、並給出機率的小模型,語言模型仍負責寫回覆。
依 Tazo 部落格的定義,它有五個特徵:直接讀雙方的音訊波形,每隔幾十毫秒連續判斷,使用同一組動作,輸出經過校準的機率,並且獨立於語言模型之外。動作包括回應、等待、附和、讓出發言、呼叫工具與結束通話。
校準的意思是模型說有 80% 把握時,長期下來大約八成會對。長文引用研究指出,大型語言模型口頭表達的信心常常偏高,所以主張把信心交給專門的分類模型,並為每個動作設定門檻。
Tazo 也把自己和兩個相近的名字區分開來。Jev 是 TypeSafe 推出的文字型決策模型,輸入是文字,所以語音代理得先轉成逐字稿。
AudioJev 是 mocomoco 發表的音訊模型,處理 0.25 到 30 秒的短音訊並回答問題,但它的分數沒有經過校準。
長文舉了三個用途,第一個是讓圖形式代理好除錯。許多團隊把代理設計成一張狀態圖,例如問候、驗證身分、處理退款、轉人工,每一輪要決定現在在哪個狀態、下一步去哪裡。
Tazo 的另一篇文章說,用決策模型做這件事,每次轉換都會留下當時的狀態、選項、機率、門檻與音訊片段,出錯時能指出是哪一步滑掉。例如聽起來猶豫的「對,是我」不該被當成已通過身分驗證。
第二個用途是在對方說完前就預先查資料。當使用者說到「我上週下的訂單」,系統就能在他還在講話時啟動訂單查詢,等他說完時結果已經備好。
Tazo 的示範是 800 毫秒的查詢提早 1.2 秒觸發,命中率 60% 時每輪省約 480 毫秒,約每次有用的查詢會多浪費 0.67 次。
這是 Tazo 自己的算式範例,不是實測。同一篇文章也寫了安全規則:只對查詢類工具做預先呼叫,付款與預約這類會改變狀態的動作不做,預先呼叫的結果只在與最終呼叫完全相同時才採用。
第三個用途是個人代理的快速分流。語音備忘錄常常只需要判斷是任務、提醒、隨口一說,還是根本不是對代理說的,小模型能在大模型還沒醒來前先做決定。
這三種用法聽起來合理,但 Tazo 目前公布的內容並不包含效能數據。官方部落格沒有交代模型架構、輸入輸出格式、參數量或基準結果,API 金鑰、Playground 與銷售聯絡的入口,也是留下工作信箱或寄信給客服的申請方式。
官方 Manifesto 說,早期實驗確認音訊原生決策模型在多個高價值情境優於純文字決策模型,但沒有附任何資料。官網首頁還有一排公司標誌,寫的是來自這些公司的開發者,不是客戶案例,也沒有說明合作關係。
長文提到的內部實驗是,與合作夥伴的初步實驗顯示,代理裡 30% 到 40% 的語言模型工作屬於分流與選擇。這個比例沒有附資料,所以只能當作作者的估計。
延伸閱讀:PersonaPlex 語音 AI 解析:NVIDIA 邊聽邊說模型,客服導入前要測什麼
語音 AI 代理怎麼驗證?導入音訊決策前先量這幾件事
不論你是否考慮 Tazo,這場討論最有用的收穫,是 Tazo 的文章列出了評估語音 AI 代理的具體指標。
Tazo 的文章建議,不要只看單一準確率,而要在固定延遲下看「錯誤打斷率」,或在固定錯誤打斷率下看延遲。這兩個數字互相拉扯:愈快回答,愈容易搶話。
另外要看對附和的穩健度。附和是對方說「嗯」「對」這類短回應,不是要搶發言,代理卻誤以為被打斷而停下。還要量使用者插話後代理多快停下,以及呼叫工具與掛電話這類動作的精確率與召回率。
自我修正與長停頓也值得單獨測試。人說話常常重說、改口、想到一半停住,這些在乾淨資料集裡很少出現,卻是真實通話的常態。
實際做法可以很簡單。先錄下 50 通真實或接近真實的通話,在取得同意的前提下,標出每一次不該被打斷或不該等待的時刻,再用現在的流水線跑一次,記下錯誤打斷與過長沉默的次數。
接著,如果要測試任何音訊模型,用同一批通話比較,看它在固定延遲下能少多少錯誤。這個做法的好處是,不必相信任何一家廠商的數字,用你自己的資料就能得到答案。
Tazo 的文章也建議參考 Full-Duplex-Bench 這類公開基準。但這是公開基準,不是 Tazo 的結果,使用前仍要確認它的任務與你的情境是否接近。
有了驗證方法,接著可以判斷誰適合花力氣評估這件事。
適合誰、不適合誰:什麼時候值得評估音訊決策模型
這類模型適合已經有大量通話、也已經被打斷或沉默問題困擾的團隊。
具體來說,是正在營運電話客服或預約代理,而且有通話錄音、有人力標註的團隊。使用圖形式代理的團隊也特別適合,因為狀態轉換最容易被逐筆檢查。
不適合的情況同樣清楚。流程單純、只回答常見問題的代理,可能用現有的靜默計時器就能應付,不必先增加一層模型。無法合法保存或處理通話音訊的團隊,也不適合,因為音訊含有聲紋與環境聲音,取得與保存條件要先確認。
還有一種是需要公開價格與獨立評測才能採購的公司。以目前 Tazo 的狀態,網站只有搶先體驗與銷售聯絡的入口,沒有公開價格、技術文件或第三方評測,不適合放進採購流程。
另一條路是改用語音轉語音模型,也就是不經過文字、直接聽音訊並說話的模型。長文作者認為短期內它只適合簡單場景,因為不容易控制說話內容,也不容易呼叫工具與執行程式。
這是作者的判斷,而全雙工模型的進展很快,所以你可以用前面的驗證方法,把它們一起納入比較。不管選哪條路,先量自己的問題,再選工具。
在選擇之前,也要清楚這場討論的限制。
語音 AI 代理的限制與風險:長文是主張,證據還在路上
最大的限制是,這篇長文的作者就是產品的建造者,而產品目前沒有公開證據。
作者在文末直接寫明,自己正在 Tazo Labs 打造這一層,並說會在幾天內分享更多模型資訊。所以讀者應把它當成創業者的論述,而不是中立研究。Tazo 的官方文章與 Jev 和 AudioJev 的比較,只是一張功能表,不是基準測試。
Tazo 的比較文章列出 AudioJev 在 240 題固定題目上的準確率是 88.75%,但這是 AudioJev 唯一公開的結果,不是 Tazo 的。Tazo 沒有公布任何自己的分數,該文也沒有獨立評測,所以它的說法都屬於廠商自述。
其次,論文證據有適用範圍。端點偵測、裝置導向語音偵測、串流檢索與輪流說話預測,是不同的任務,各自用了不同的資料與模型大小,不能直接加總成「音訊勝過文字」。
最後是隱私與合規。音訊決策要求把原始通話送進模型,或在本機處理,兩者的資料保存與同意流程都和只處理逐字稿不同,導入前應先和法務確認。
語音 AI 代理常見問題
語音 AI 代理真的只看逐字稿嗎?
多數是串接式架構,但不是完全不看音訊。判斷使用者是否說完時,常用語音活動偵測與靜默計時器,近來也有音訊模型加入,這些都用到音訊。判斷使用者想做什麼時,才主要依賴逐字稿。
加入音訊真的會比只看逐字稿更準嗎?
要看任務。Apple 相關論文顯示,判斷語音是否對助理說時,多模態系統相較最佳純文字系統,最多能降低約 39% 的等錯誤率。Uniphore 的端點偵測實驗則顯示,聲學與韻律的組合最好,加入文字沒有進一步幫助,但資料只有單一英文電話資料集。
語音轉語音模型會取代串接式流水線嗎?
作者認為短期內不會,原因是控制與工具呼叫比較困難。這是他的判斷,不是已被證明的事實,建議用自己的通話資料比較不同方案,而不是只看廠商說法。
Tazo 現在可以使用嗎?
截至 10 月 20 日,Tazo 的網站提供搶先體驗申請與銷售聯絡。API 金鑰、Playground 與試用,都是留下工作信箱或寄信給客服的申請方式,沒有列出價格與技術文件。
結語:先量自己通話裡的錯誤,再決定要不要加一層音訊決策
這場討論最確定的貢獻,是提醒大家,逐字稿只是通話的一部分,而且在 Uniphore 的端點偵測實驗裡,音訊與韻律確實提供了文字沒有的線索。最不確定的是,一個獨立的音訊決策模型,能不能在真實通話上穩定勝過現有做法。
如果你正在做語音代理,建議先錄 50 通通話,量出錯誤打斷與過長沉默的比例,再決定要不要評估任何新模型。如果你只是關注趨勢,記得論文的數字只代表它們各自的任務。
想持續追蹤語音 AI、代理與評測方法的官方更新,可以免費訂閱 AI 郵報,後續更新會以論文與官方資料為準。
資料來源
- X 長文,Voice agents aren't listening. They're reading.(作者 Naman Jain):https://x.com/namanjn1998/status/2112166969499861352
- Tazo Labs 官方網站:https://tazolabs.com
- Tazo Labs 官方部落格,Decision models: the missing piece in the voice AI stack:https://tazolabs.com/blog/voice-ai-decision-models
- Tazo Labs 官方部落格,Ask what the moment needs:https://tazolabs.com/blog/ask-what-the-moment-needs
- Tazo Labs 官方部落格,Tazo vs Jev:https://tazolabs.com/blog/tazo-vs-jev-audio-decision-model
- Tazo Labs 官方部落格,Speculative tool calling:https://tazolabs.com/blog/speculative-tool-calling-voice-ai
- Tazo Labs 官方部落格,How audio decision models make graph agents reliable:https://tazolabs.com/blog/reliable-graph-agents-voice-ai
- Tazo Labs Manifesto:https://tazolabs.com/manifesto
- arXiv 論文,Less can be More: What Aspects of Speech Drive End-of-Turn Detection:https://arxiv.org/abs/2609.11066
- arXiv 論文,A Multimodal Approach to Device-Directed Speech Detection with Large Language Models:https://arxiv.org/abs/2403.14438
- arXiv 論文,Stream RAG: Instant and Accurate Spoken Dialogue Systems with Streaming Tool Usage:https://arxiv.org/abs/2510.02044
- arXiv 論文,DualTurn: Learning Turn-Taking from Dual-Channel Generative Speech Pretraining:https://arxiv.org/abs/2603.08216
- arXiv 論文,Applying General Turn-taking Models to Conversational Human-Robot Interaction:https://arxiv.org/abs/2501.08946
- arXiv 論文,Can LLMs Express Their Uncertainty?:https://arxiv.org/abs/2306.13063
- Deepgram,State of Voice AI 2025:https://deepgram.com/learn/state-of-voice-ai-2025