NVIDIA RTX Spark 是什麼?ProArt P16 用 128GB 統一記憶體,把大模型算力搬回本機
ASUS ProArt P16(H7607)搭載 NVIDIA RTX Spark,最高 128GB 統一記憶體讓 70B~120B 級大模型回到本機。整理規格、記憶體估算與三大自由。
AI 用得越兇,越容易在三個地方卡關:點數跑到一半見底、丟檔案前猶豫三秒、什麼事都只靠同一個模型。這三件事背後其實是同一個問題,算力放在誰手上。
ASUS ProArt P16(H7607),主打全球首款搭載 NVIDIA RTX Spark 的 ProArt 筆電,官方說法是最高 128GB 統一記憶體、最高 1 PFLOPS 的 FP4 AI 算力,並可在本機執行最高約 120B 參數的大型語言模型。本文整理 ASUS 官網與 NVIDIA 公開資料,說明 RTX Spark 是什麼、為什麼記憶體是關鍵,以及 ProArt P16(H7607)能解決哪些實際問題。
編輯判斷:本機算力最適合的情境,是需要長時間跑 Agent、處理保密素材、或要在 Windows 上驗證大模型的創作者與開發者。它不會取代雲端,最大規模的模型仍屬於資料中心。文中的規格皆為官方「最高」數據,實際表現依使用情境而異。
為什麼 Agent 時代,AI 額度特別不夠用?
2026 年,AI 的主角已經從聊天變成代理式 AI(Agentic AI)。Agent 會在背景自己讀檔案、查資料、呼叫模型幾十次,能力越強,下面三個焦慮越真實:
- 算力焦慮:本機跑不動大模型,只能排隊等雲端。
- Token 費用:Agent 一跑就是幾十萬 Token,帳單很難預測。
- 雲端隱私:未發表的作品、客戶素材與合約,真的要全部上傳嗎?
回頭看 PC 的歷史,這是同一個老問題的新章節。過去算力在你桌上,PC 是工作室;後來算力搬到雲端,筆電變成一扇窗;現在 Agent 讓我們發現,什麼都上雲,帳單、延遲與隱私都成了負擔。以下為編輯觀察,非官方說法。
NVIDIA RTX Spark 是什麼?
RTX Spark 是 NVIDIA 為 Windows PC 打造的 AI 超級晶片,把 CPU、GPU 與記憶體整合成一個平台,目標是讓筆電也能跑大模型。依 ASUS 官網與 NVIDIA 公開資料,規格如下:
| 項目 | 內容 |
|---|---|
| CPU | NVIDIA Grace,最高 20 核心(高能效 Arm 架構) |
| GPU | NVIDIA Blackwell RTX,最高 6,144 個 CUDA 核心 |
| 記憶體 | 最高 128GB 統一記憶體,CPU 與 GPU 共用 |
| AI 算力 | 最高 1 PFLOPS(FP4 AI 效能) |
| 地端模型 | 官方說明可在本機執行最高約 120B 參數的大型語言模型 |
1 PFLOPS 是 AI 推論用的 FP4 精度算力,與一般 CPU 效能數字不能直接比較。
先搞懂:CPU、GPU、RAM、VRAM 與 KV Cache 各是什麼?
後面的比較都建立在五個名詞上,先用最短的方式講完:
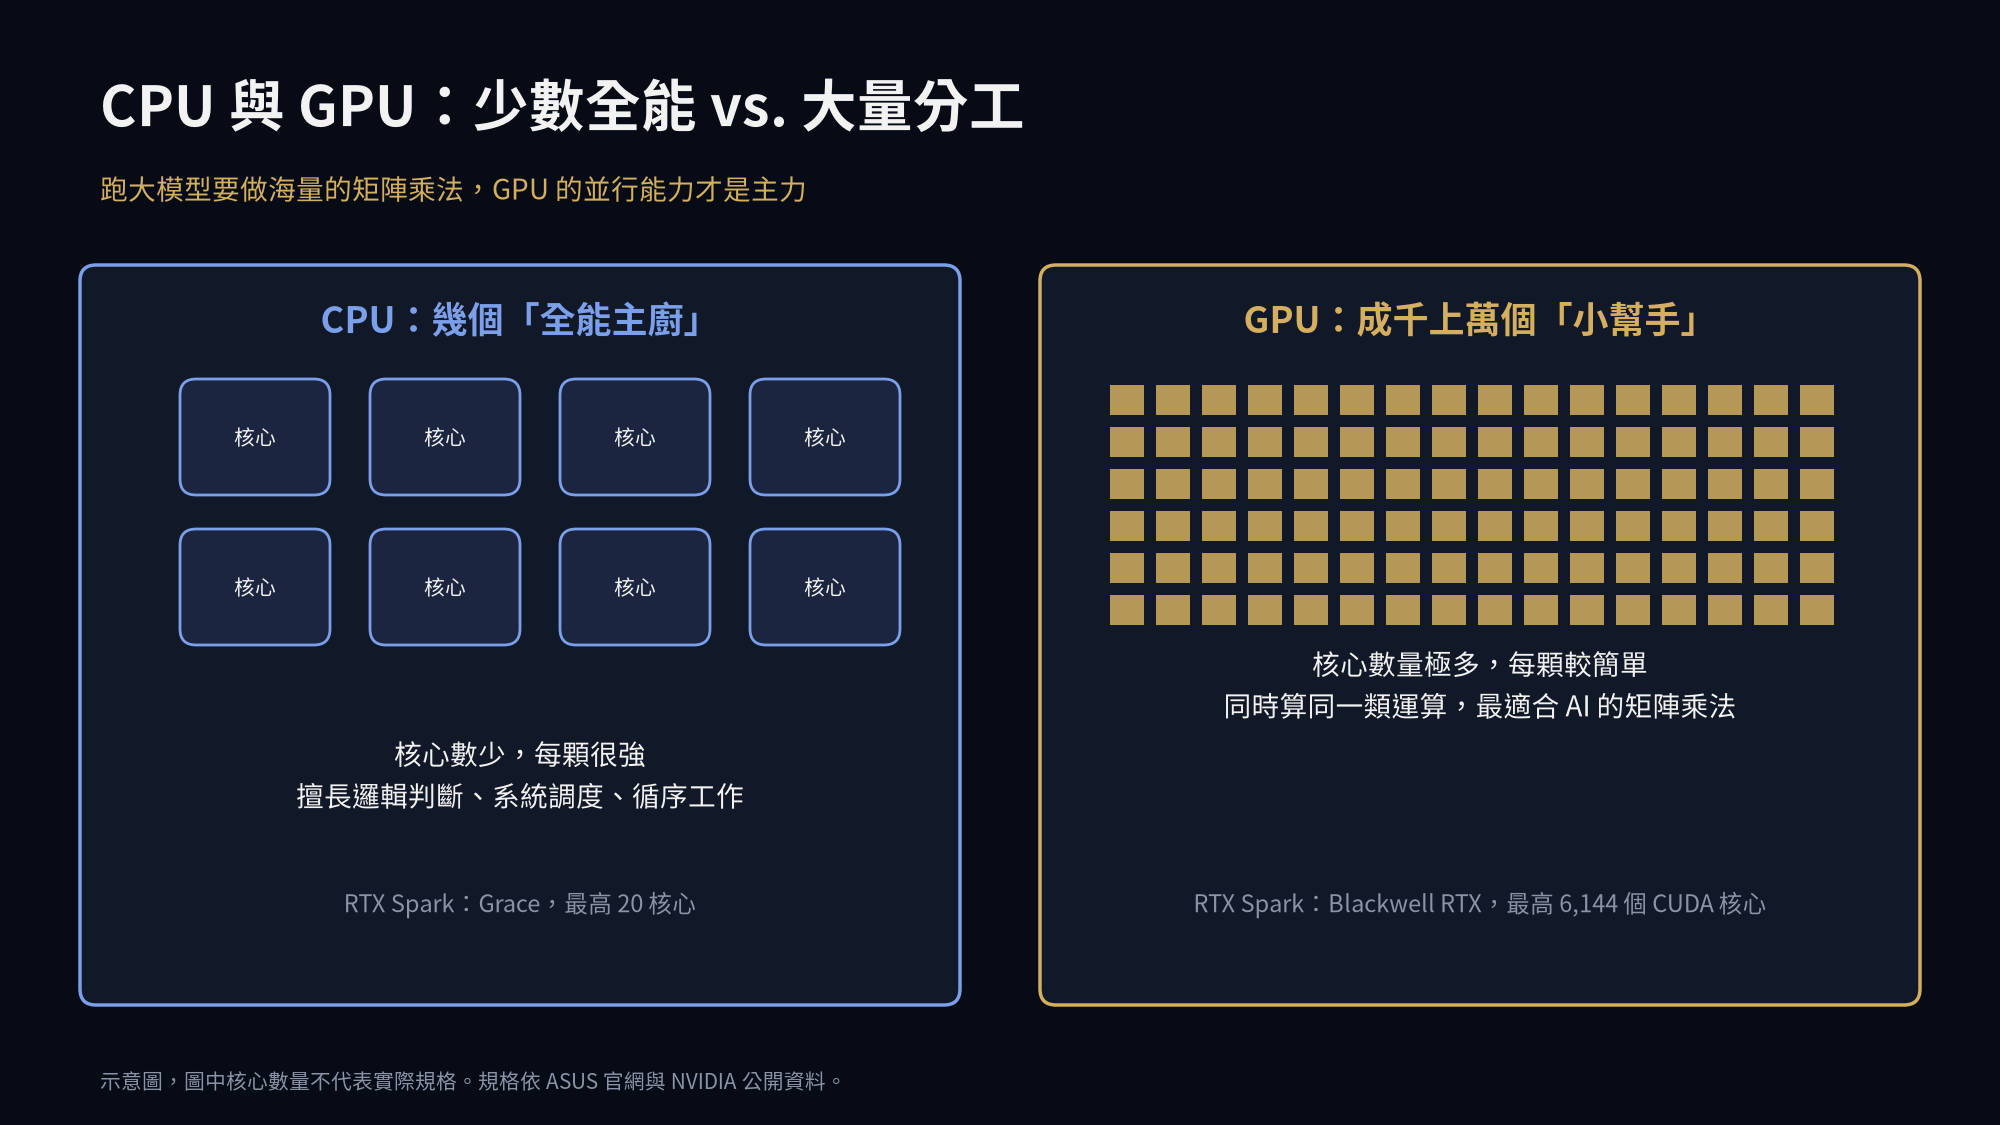
- CPU(中央處理器):電腦的總管,負責調度系統、邏輯判斷與循序工作。核心數不多,但每顆都很全能。RTX Spark 搭載的 NVIDIA Grace 最高 20 核心。
- GPU(圖形處理器):原本為繪圖而生,擁有成千上萬個較簡單的核心,擅長同時做大量同類型的運算。AI 模型的主要工作是矩陣乘法,正好是 GPU 的強項。RTX Spark 的 Blackwell RTX 最高 6,144 個 CUDA 核心。
- RAM(系統記憶體):接在 CPU 旁,容量大(16~64GB 很常見)、速度中等。
- VRAM(顯示記憶體):焊在 GPU 旁,速度非常快,但容量小,筆電常見 8~16GB。
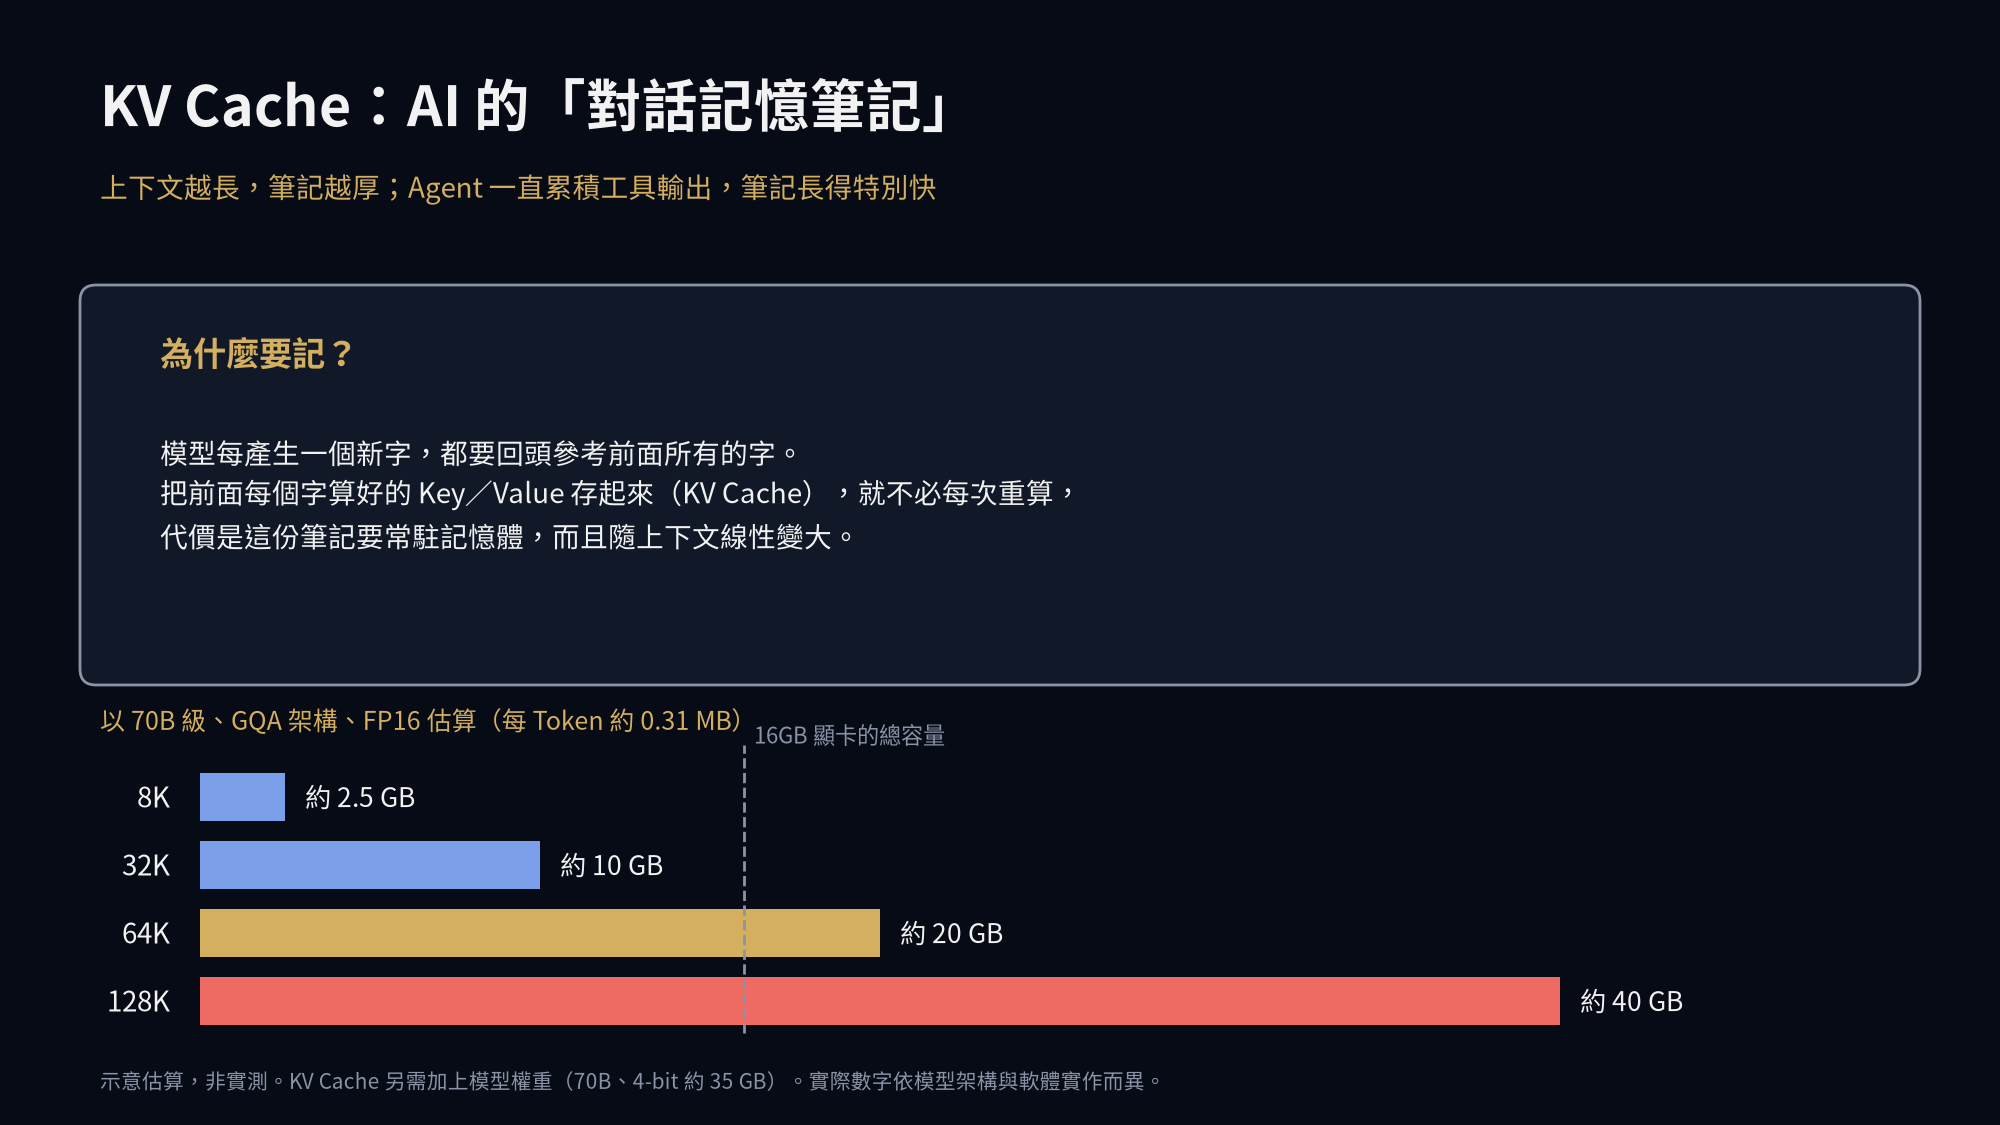
- KV Cache:模型的「對話記憶筆記」。模型產生每個新字時,都要參考前面所有的字,把前面算好的 Key/Value 存起來,就不必每次重算。代價是這份筆記會常駐記憶體,並隨上下文變長而變大。
一個大模型,怎麼從硬碟搬到 GPU?
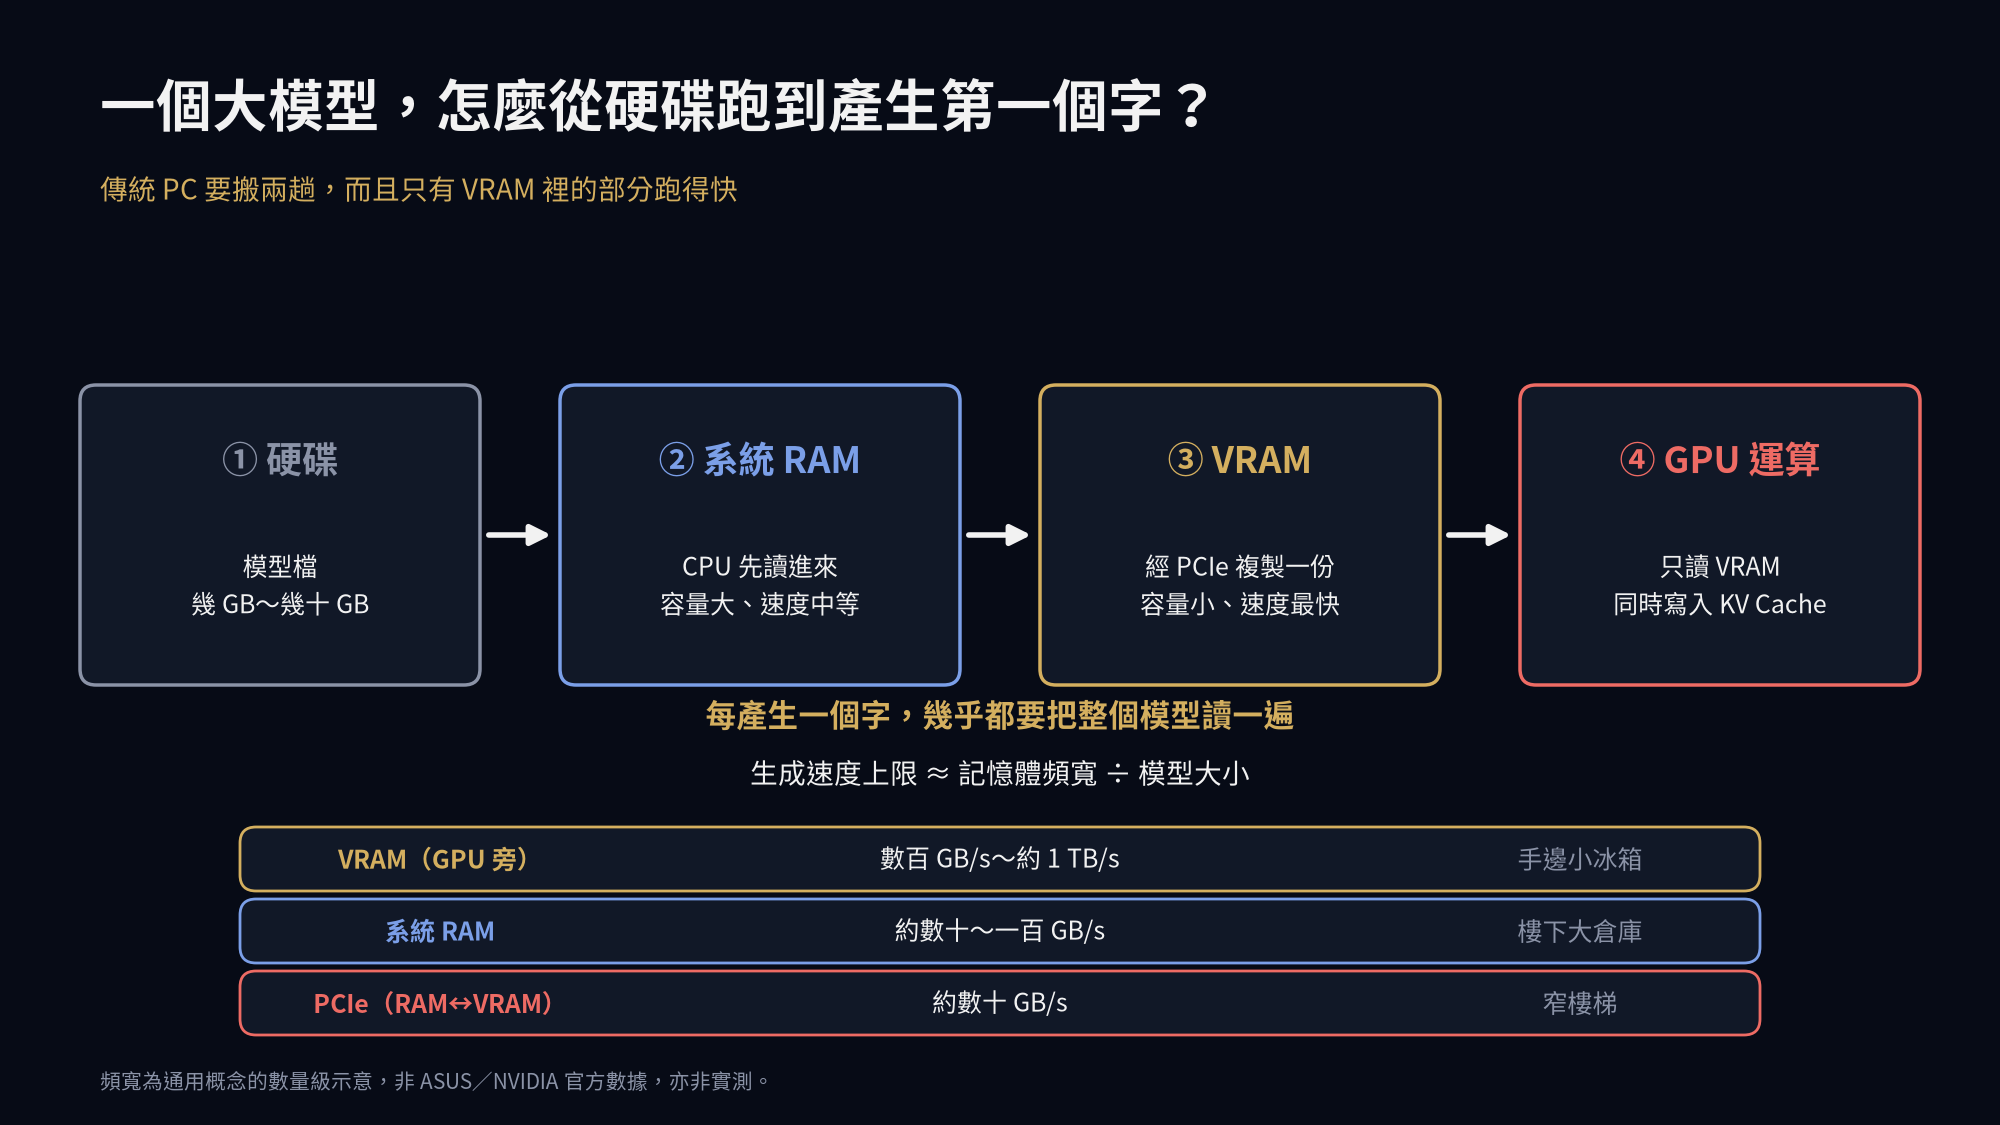
在傳統 PC 上,RAM 與 VRAM 是不同的實體記憶體、不同的位址空間,中間靠 PCIe 匯流排連接。GPU 的運算單元設計上只直接讀自己的 VRAM,想用 RAM 裡的資料,必須先複製過去。一個模型從硬碟到產生第一個字,會經過四步:
- 硬碟 → RAM:CPU 先把幾 GB 到幾十 GB 的模型檔(權重)讀進系統 RAM。
- RAM → VRAM:再透過 PCIe 複製進 VRAM。載入的這一刻,兩邊可能各存一份。
- GPU 開始運算:此後 GPU 只讀 VRAM,速度才快得起來。
- 同時建立 KV Cache:邊讀你的提問邊產生,一樣放在 VRAM。
為什麼放不下會這麼慘?因為大型語言模型一次只吐出一個 Token,而每產生一個 Token,幾乎都要把全部權重從記憶體讀一輪,所以生成速度的上限大致是記憶體頻寬除以模型大小。模型放在哪,就決定了速度。
舉例來說,一個約 40GB 的 70B 級量化模型丟進 16GB VRAM 的筆電,只有約 16GB 能放在 VRAM,剩下約 24GB 只能留在系統 RAM。那 24GB 要不是交給 CPU 算,整體被最慢的一段拖住,就是每次都經 PCIe 搬上 GPU,像廚師每做一道菜都要跑去倉庫搬一次食材。結果是本來全在 VRAM 時可能每秒數十字,溢出後掉到每秒個位數甚至更慢。以上為數量級示意,非實測。
KV Cache 是什麼?為什麼 Agent 特別吃?
KV Cache 會隨上下文長度線性成長。以 70B 級、GQA 架構的模型為例(80 層、8 個 KV heads、head_dim 128、FP16),每個 Token 約 0.31 MB,上下文拉到 128K 時 KV Cache 就約 40GB,這還不含模型權重。Agent 會不斷累積工具輸出、檔案內容與對話歷史,上下文愈來愈長,KV Cache 也跟著膨脹。
以 16GB VRAM 跑 64K 上下文為例:8B 級模型(Q4 量化)權重約 5GB、KV Cache 約 8GB,勉強擠得進;但 30B 級以上光權重就超過 16GB,70B 級的 64K KV Cache 就約 20GB。以上為示意估算,非實測。
傳統 PC 的補救辦法,各有代價
- 量化:把權重壓成 4-bit 等,變小了,但可能損失一點品質。
- 縮短上下文、量化 KV Cache:省記憶體,但 Agent 能記住的內容變少。
- 把部分層丟給 CPU 跑(offload):塞得下,但速度大幅下降。
- 退回雲端:能跑,但回到 Token 費用與隱私問題。
- WSL2 又多一層:WSL2 是一台輕量虛擬機,預設最多使用主機約一半的 RAM(可用 .wslconfig 調整),跑 AI 時系統 RAM 常被吃滿,開發環境一起卡頓。這是通用技術知識,非官方數據。
為什麼「統一記憶體」是重點?
要讓 Agent 在本機跑得順,有三個條件。以下為作者的使用經驗與觀察,非官方說法:
- 模型要夠大:想讓 tool calling(呼叫工具)穩定,模型基本上要 32B 以上。
- 上下文要夠長:64K 的 Context Length 對 Agent 並不寬裕,但以一般顯卡的 VRAM 要跑到 64K,得是相當頂級的顯卡。
- KV Cache 會吃光 VRAM:Agent 運行時的 KV Cache 佔用大量 VRAM,在消費級顯卡上常溢出到系統 RAM,效能因此被拖垮。
這三件事全部是記憶體問題。以示意估算來看:
| 情境(4-bit 量化) | 模型權重 | KV Cache | 合計 |
|---|---|---|---|
| 32B 模型、上下文 8K | 約 16 GB | 約 2 GB | 約 18 GB |
| 32B 模型、上下文 64K | 約 16 GB | 約 16 GB | 約 32 GB |
| 70B 模型、上下文 64K | 約 35 GB | 約 20 GB | 約 55 GB |
| 70B 模型、上下文 128K | 約 35 GB | 約 40 GB | 約 75 GB |
以上為示意估算,非實測。權重以 4-bit 約 0.5 位元組/參數計,KV Cache 以 GQA 架構、FP16 估算,實際數字依模型架構、量化方式與軟體實作而異。
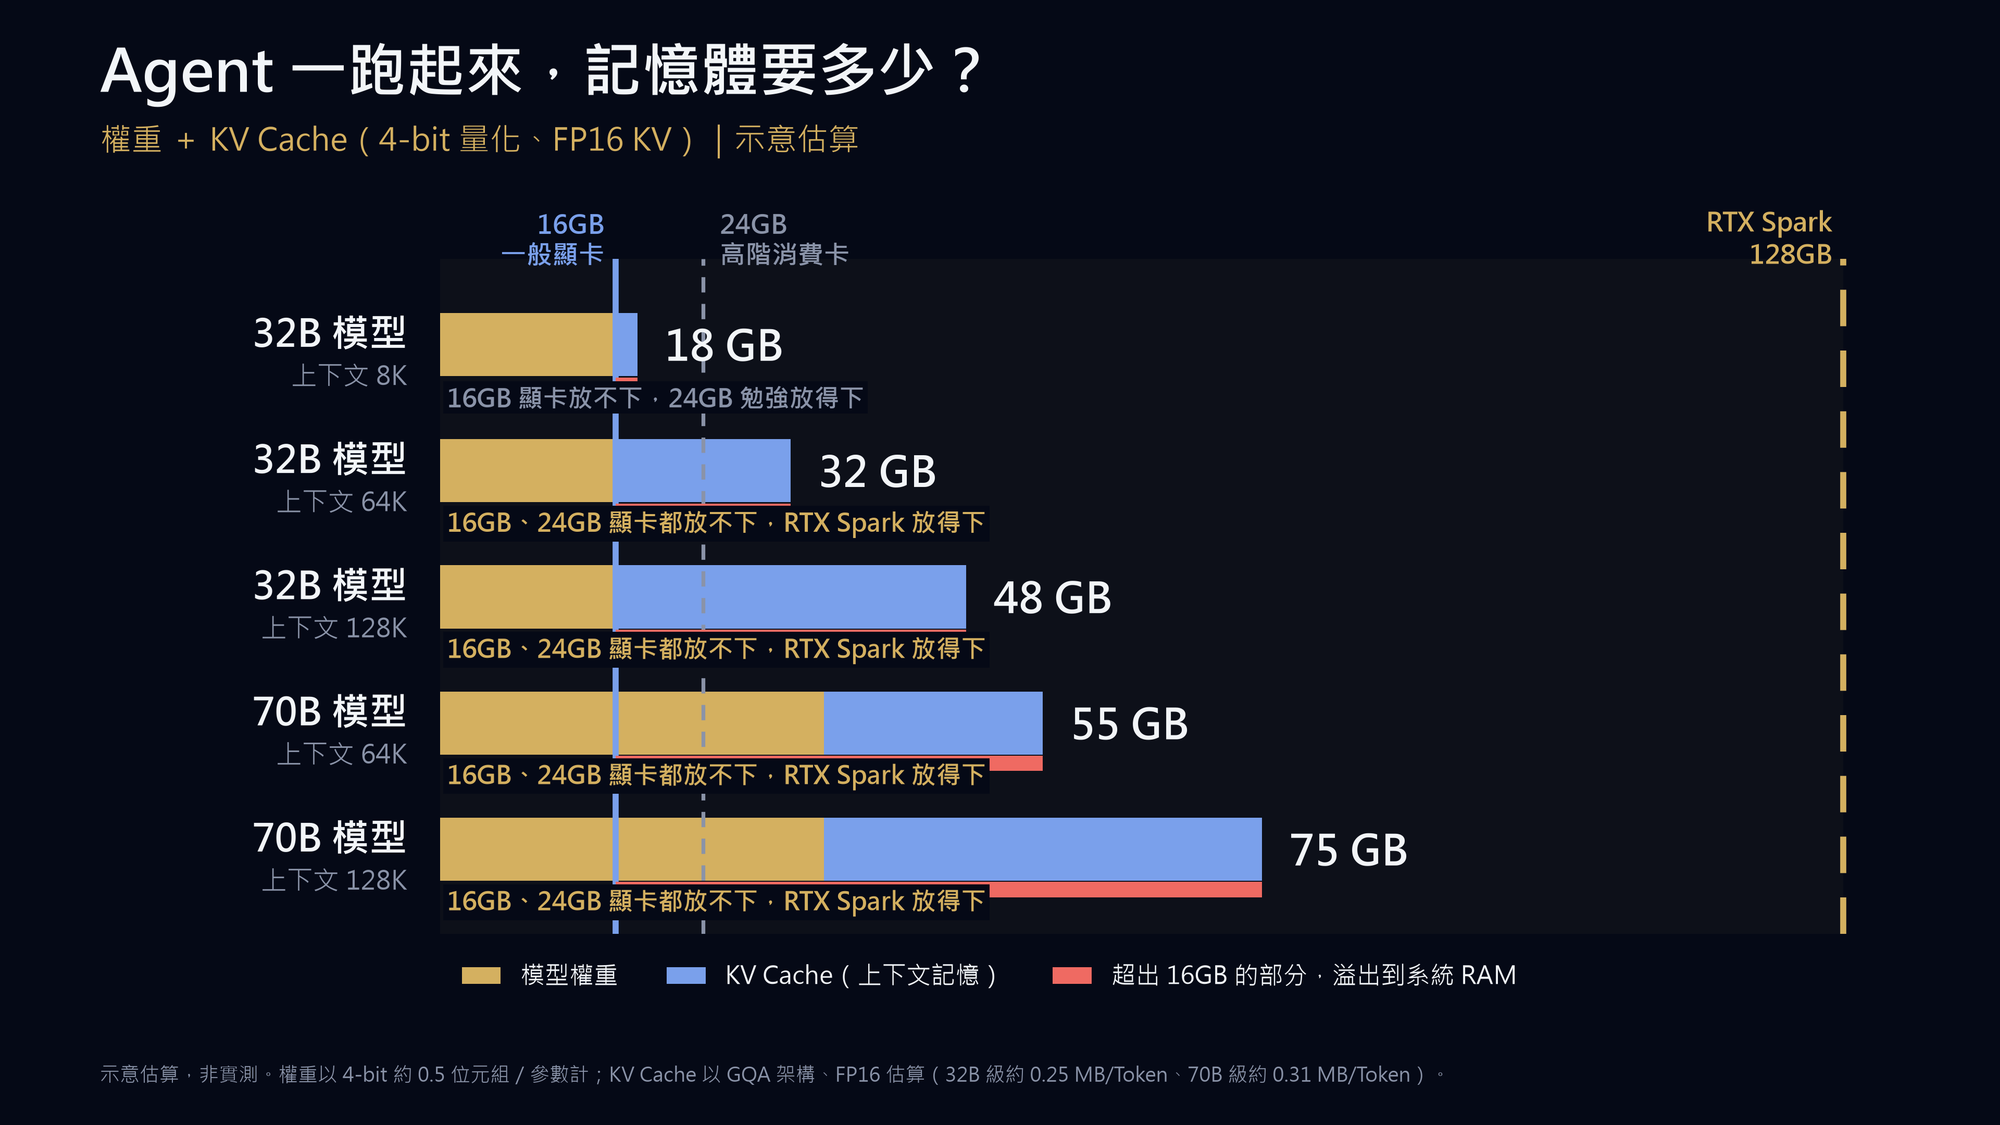
結論很直接:32B 模型加 64K 上下文就要約 32GB,一般 16GB 顯卡放不下,連 24GB 的高階消費級顯卡也不夠。
傳統 PC 的 CPU 與 GPU 各有一套記憶體,中間只隔一條窄窄的 PCIe 通道,放在 RAM 的那一段就成了速度瓶頸。可以用台灣的夜市攤位來想像:廚師(GPU)只能用手邊小冰箱(VRAM)裡的食材,食材放在樓下倉庫(RAM),就得有人跑樓梯(PCIe)一趟趟搬上來。RTX Spark 的做法,是把冰箱、倉庫和樓梯換成一間大型開放式廚房:CPU 與 GPU 共用最高 128GB 的同一個記憶體池,模型載入一次,不必複製,也不會突然撞到顯存天花板。
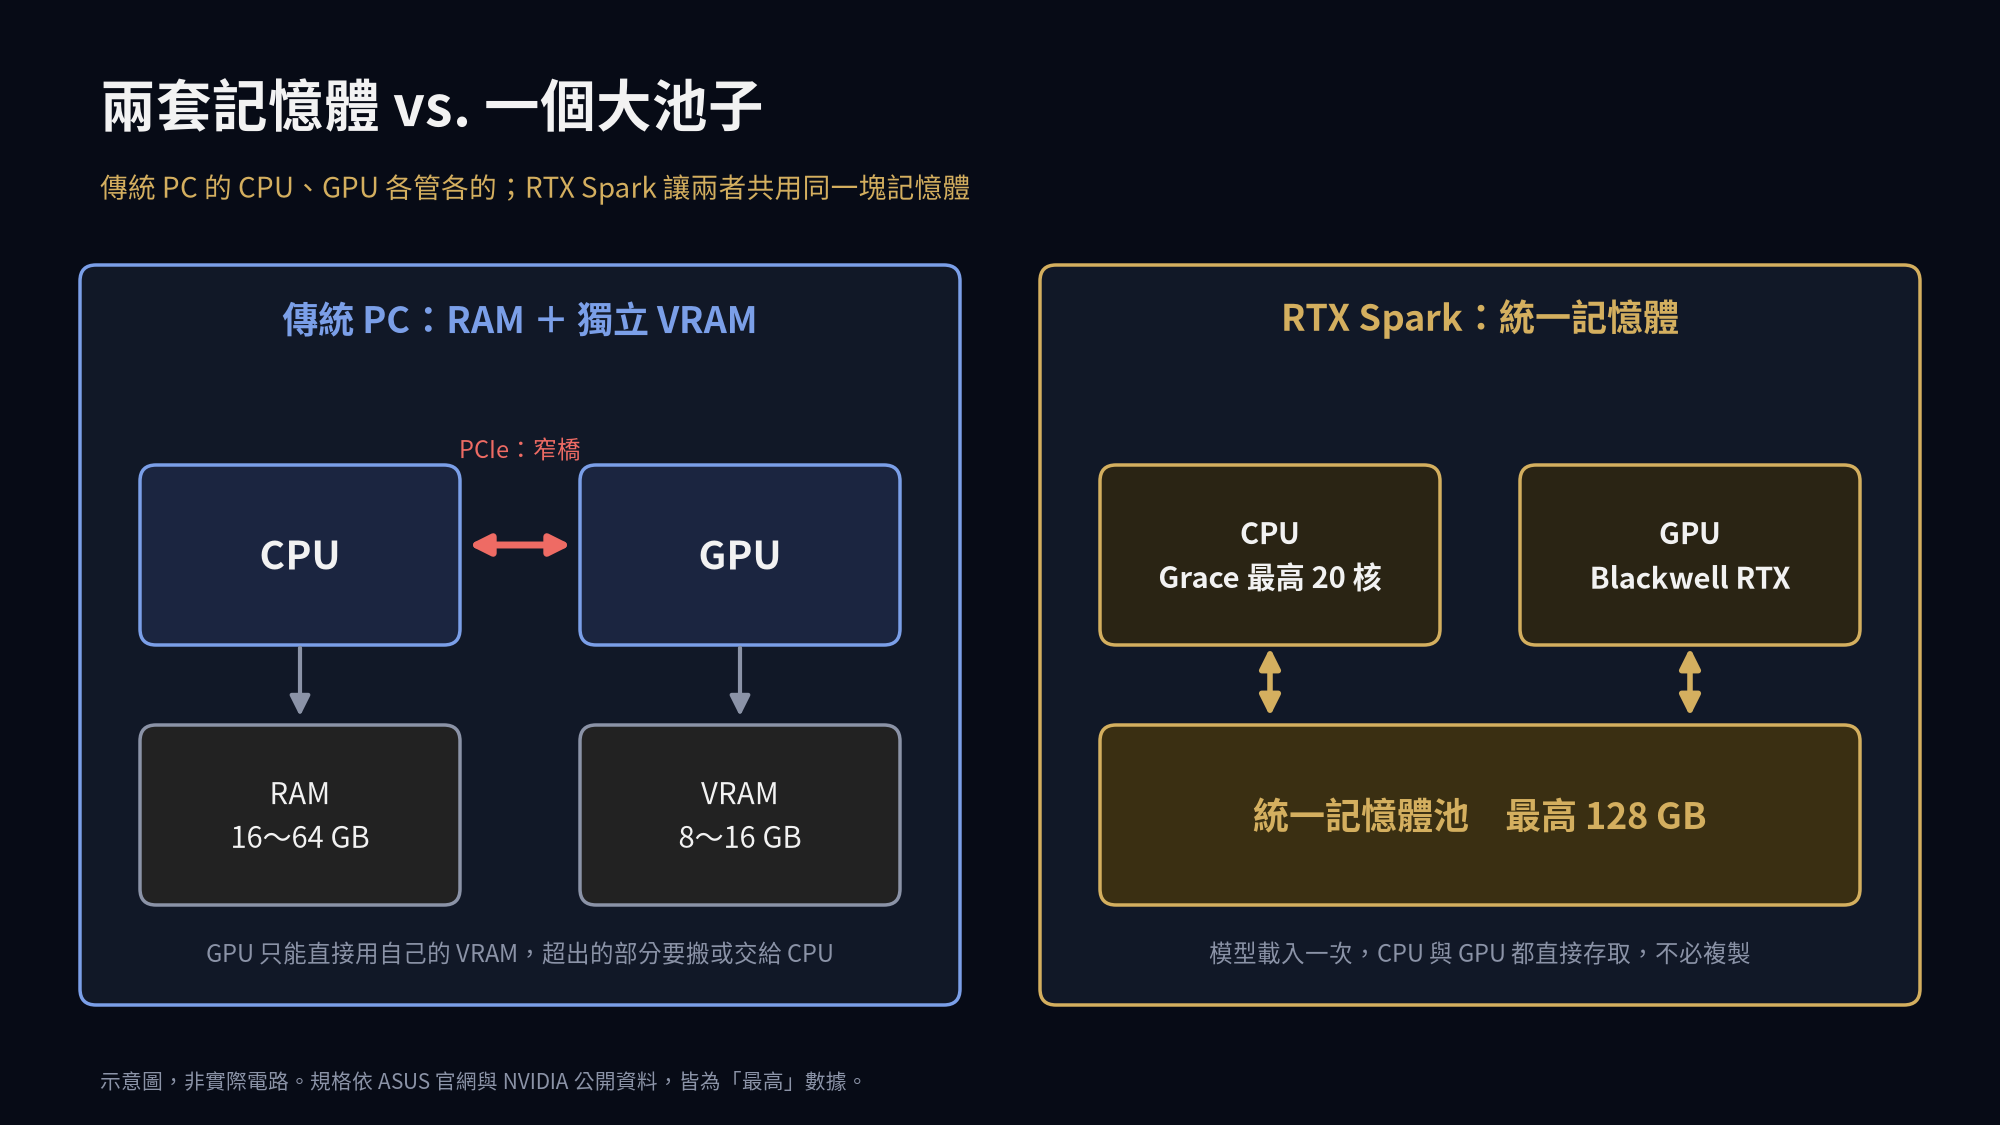
公平地說,統一記憶體解決的是容量與搬運問題,不代表所有情境都更快。記憶體頻寬仍是生成速度的關鍵,RTX Spark 的實際頻寬與各情境效能,請以官方數據與實機測試為準。
ProArt P16(H7607)帶來哪三大自由?
ProArt P16(H7607)想回答的問題是:如果算力就在你手上,這三個焦慮還成立嗎?
| 回應的焦慮 | ProArt P16(H7607)的解法 | 一句話 | |
|---|---|---|---|
| 算力自由 | 算力焦慮、Token 費用 | RTX Spark + 最高 128GB + 1 PFLOPS | 大模型在本機,不再按 Token 計費 |
| 行動自由 | 雲端隱私、機動性 | 1.77 kg / 12.9 mm、離線運算、雙色機身 | 走到哪、算到哪,資料不外洩 |
| 開發自由 | 顯存不夠、被迫退回雲端 | Windows + WSL2 + 原生 CUDA + 128GB | 雲地雙軌,大模型也能在本機開發 |
1. 算力自由:直跑地端大模型,不再按 Token 計費
過去模型太大,只能租別人的算力;想在本機跑,就只能用輕量模型。在本機跑 AI 要看四個指標,而且都跟記憶體有關:模型大小(權重要整個放進記憶體,70B、4-bit 約 35GB)、Context Length(上下文越長越吃記憶體)、KV Cache(隨上下文線性成長,70B 級、128K 可達數十 GB)、Token/s(取決於模型放在哪與記憶體頻寬)。
官方說明 ProArt P16(H7607)可在本機執行最高約 120B 參數的模型。估算來看,120B 模型 4-bit 量化後約 60GB,放進 128GB 後還剩約 68GB 給上下文與系統使用,同樣的模型在 16GB VRAM 的一般筆電根本放不下。
| 模型尺寸 | FP16 | 8-bit | 4-bit | 一般筆電 16GB VRAM | RTX Spark 128GB |
|---|---|---|---|---|---|
| 8B | 16 GB | 8 GB | 4 GB | 放得下 | 全部放得下 |
| 32B | 64 GB | 32 GB | 16 GB | 4-bit 勉強,幾乎不留上下文空間 | 全部放得下 |
| 70B | 140 GB | 70 GB | 35 GB | 放不下 | 8-bit、4-bit 放得下 |
| 120B | 240 GB | 120 GB | 60 GB | 放不下 | 4-bit 放得下,8-bit 勉強 |
| 405B | 810 GB | 405 GB | 202.5 GB | 放不下 | 放不下,仍需雲端 |
以上為示意估算,非實測,「放不放得下」也取決於上下文長度與系統佔用。
成本結構因此改變:從用多少付多少,變成一次投入,本機推論不再按 Token 計費。這裡指的是不經雲端 API 計費,不含硬體購置與電力成本。Agent 愈常跑、跑愈久,本機的優勢愈明顯。官方另提到支援百萬 Token 上下文視窗,整份專案或整本手冊丟進去也不怕被截斷。創作者可以讓 Agent 在背景整理上百支素材、產生字幕與摘要,跑一整晚,不用盯著點數。
2. 行動自由:輕薄、雙色機身、離線運作
過去「能跑大模型」幾乎等於又重又厚的工作站,想輕便就得把工作交給雲端。ProArt P16(H7607)的規格是這樣:
- 1.77 kg、12.9 mm:官方稱為史上最薄的 16 吋 ProArt 筆電,相較前一代薄 14%、輕 9%。
- 離線獨立運算:沒有網路也能跑模型,高鐵、飛機、咖啡廳、拍攝現場都能開工。
- 資料留在本機:未發表作品、客戶素材與合約不必上傳雲端。
- 創作者級螢幕:最高 4K ASUS Lumina Pro OLED,Delta E < 1、120Hz、抗反光塗層。
- 雙色機身:曜夜黑(極致抗污)與皓月銀(特殊噴砂工藝)。
情境上,到客戶現場提案時,可以直接在本機讓 AI 處理保密簡報與未公開素材,產出初稿、字幕或摘要,回到咖啡廳再繼續調色、剪輯,同一台機器完成。
3. 開發自由:Windows 上的「雲地雙軌」AI 工作流
WSL2 與 CUDA 早就有,傳統「x86 CPU + 獨立顯卡」的 Windows 筆電也能裝。但模型受限於獨立顯存,大模型在本機驗證不了,WSL2 又要佔用系統 RAM,開發環境一起卡頓。
ProArt P16(H7607)沿用同樣的 WSL2 與原生 CUDA 生態,搭配最高 128GB 統一記憶體,大模型可以直接在本機開發、除錯、驗證,再決定要不要上雲擴大規模。日常開發、隱私資料與反覆實驗留在本機;超大規模訓練或服務上線時再接雲端,兩邊使用同一套 CUDA 工具鏈。編輯推論是,Grace CPU 加 Blackwell GPU 的組合與資料中心設計思路相近,本機驗證過的流程搬上雲端時差異可望更小,這部分並非官方說法。
差別不在能不能開發,而在本機能開發到多大的模型。
跟過去的筆電相比,差在哪?
| 比較面向 | 傳統 RAM + 獨立 VRAM | ProArt P16(H7607)統一記憶體 |
|---|---|---|
| 放下 70B 模型 | 16GB VRAM 放不下,要溢出到 RAM(速度大降)或換更大顯卡 | 整個放進同一個池子 |
| 長上下文 | KV Cache 吃光 VRAM,被迫縮短上下文 | 共用 128GB,空間寬裕 |
| 沒網路時 | 大模型用不了 | 離線也能跑 |
| 資料去哪 | 上傳雲端 | 留在本機 |
| 成本結構 | 加大顯存的硬體,或持續付雲端 Token 費 | 一次投入,本機推論不再按 Token 計費 |
以上為條件與結構上的比較,未含具體金額;實際價格以官方公布為準。
使用前要注意的限制
- 規格皆為「最高」數據:1 PFLOPS、128GB、120B 都是官方標示的最高值,實際效能依機型配置與使用情境而異。
- 最大規模模型仍在雲端:405B 級模型即使量化後也超過 128GB,仍需雲端。
- Arm 架構相容性:Grace CPU 為 Arm 架構,Windows 既有應用程式(含創作軟體)的相容性,請以 ASUS 官方說明為準,購買前建議確認自己常用的軟體。
- 頻寬仍是速度關鍵:統一記憶體解決容量與搬運,生成速度仍取決於記憶體頻寬,本文未進行實機測試。
適合哪些人?
- 重度使用 Agent 的創作者:需要長時間背景運算,又不想盯著 Token 帳單。
- 處理保密素材的人:客戶合約、未發表作品希望留在本機處理。
- 要把 AI 整合進工具的開發者:在 Windows 熟悉的環境裡,用 WSL2 與 CUDA 驗證大模型,再決定要不要上雲。
如果日常只用小型模型、或幾乎只在固定地點工作,雲端服務或一般筆電可能已經夠用。
常見問題
RTX Spark 可以取代雲端 AI 嗎?
不會。本機適合日常主力、隱私資料與反覆實驗,最大規模的模型仍屬於資料中心,未來比較像「本機優先、雲端協作」的混合模式,這是編輯觀察,非官方說法。
「不再按 Token 計費」是免費的意思嗎?
不是免費。它指本機推論不經雲端 API 計費,硬體購置與電力成本仍然存在。
16GB 顯卡真的跑不了 Agent 嗎?
8B 級模型 Q4 量化約 5GB,64K 的 KV Cache 約 8GB,勉強放得下。但 30B 級以上光權重就超過 16GB,70B 級的 64K KV Cache 約 20GB,會溢出到系統 RAM,速度大幅下降。以上為示意估算,非實測。
統一記憶體會讓所有東西都更快嗎?
不一定。它消除的是 RAM 與 VRAM 之間的複製與容量上限,生成速度仍受記憶體頻寬影響。
結語:算力的鐘擺,正在擺回你身邊
從「算力在桌上」到「算力在雲端」,再到 Agent 時代重新評估本機的價值,RTX Spark 與 ProArt P16(H7607)站在這個轉折點上:把主流大模型等級的算力,裝進一台 1.77 kg、為創作者設計的筆電。雲端不會消失,但日常主力、隱私資料與反覆實驗,會越來越自然地回到你自己的機器上。
超.算力 ProArt P16(H7607)|全球首款搭載 NVIDIA RTX Spark 的 ProArt 筆電
資料來源
- ASUS ProArt P16(H7607)產品頁(產品規格主要來源)
- ASUS 官網與活動拍攝重點整理
- NVIDIA RTX Spark 官方產品頁與公開新聞稿
本文為 ASUS 合作內容。產品規格取自官方資料,記憶體與模型大小數字為編輯依公式所做的示意估算,非實測;「三個條件」與「雲地同架構」為作者觀察與推論,非官方說法。產品規格與價格可能更新。
#asus #proart #超算力 #nvidiartxspark