ElevenLabs 語音客服研究,469 個代理如何比較語音與文字,長對話為何不同?
ElevenLabs 語音客服研究分析 469 個代理,長對話語音成功率高出 10.9 個百分點。本文拆解樣本、成功案件時間、回應延遲與 98 人情境偏好,說明客服團隊如何保留比較分母並安排自己的驗收。

客服遇到取消航班或複雜訂單時,顧客往往得反覆補充背景,才能把問題說完整。這類情境除了回答正確,也牽涉等待時間,以及顧客是否願意把對話繼續下去。
ElevenLabs 語音客服研究試著比較這些差異。公司於 2026 年 11 月 2 日公布分析,並在隔日更新文章,官方貼文指出研究涵蓋 469 個同時運行語音與文字的正式環境代理。
研究讓每一個代理與自己的另一個管道比較,結果隨對話長度出現變化。簡短對話偏向文字,而超過兩分鐘的對話,語音的平均成功率高出 10.9 個百分點。
這讓客服管道的選擇更接近任務本身。顧客只要一個簡短答案,與需要釐清多個限制後完成處理,可能有不同的對話需求。
對客服團隊,這份研究值得用來設計分流與驗收。不過,正式服務資料、回應延遲分析與情境實驗各有自己的樣本,先看比較方式,才能知道每組數字能回答哪一個問題,詳見官方研究原文。
ElevenLabs 語音客服研究怎麼比較?
研究先讓同一個代理與自己比較,減少不同業務直接混在一起造成的落差。因為一個處理簡單查詢的代理,和另一個處理複雜售後的代理,本來就可能有不同的成功條件。
官方納入的代理,在二〇二六年七月至九月期間,至少各有五十段語音與文字對話。這讓兩個管道都有一定數量的正式服務紀錄,再從每個代理內部比較表現。
成功的定義則由各業務設定。對某個代理可能是完成訂位,對另一個代理可能是解決支援問題,所以研究比較的是各自業務成功條件下的結果,引用時也需要保留這個範圍。
這種設計的優點,是避免讓某種管道因為剛好服務較簡單的業務而占便宜。但管道內的顧客與具體問題仍可能不同,正式服務的觀察也需要連同任務條件理解。
為了分析複雜程度,研究使用對話時間作為近似指標。較長對話通常有更多往返與處理步驟,因此可以用來觀察,需要持續釐清的工作是否出現不同表現。
不過,時間並不能完整代表複雜度。文字對話可能因為顧客暫時離開而變長,語音對話也有等待與停頓,官方因此明確承認這是一種不完美的衡量方式。
這個限制會影響我們怎麼描述結果。可以說研究在不同時間組別觀察到差異,但若要判斷特定售後問題應該走哪個管道,仍要知道問題內容與成功標準。
有了這份比較範圍,後面的成功率就能放回同一個代理、同一類時間組別閱讀,也比較容易理解為何簡短和長對話會有不同結果,詳見研究樣本與方法。
相似取消航班情境展示,非研究原始紀錄。 來源:官方 YouTube。
長對話成功率與處理時間各說明什麼?
超過兩分鐘的對話,同時呈現成功率與成功案件處理時間的差異。這兩個指標一個看能否完成目標,另一個看完成後用了多久,因此需要分別閱讀。
成功率的差距隨對話長度改變
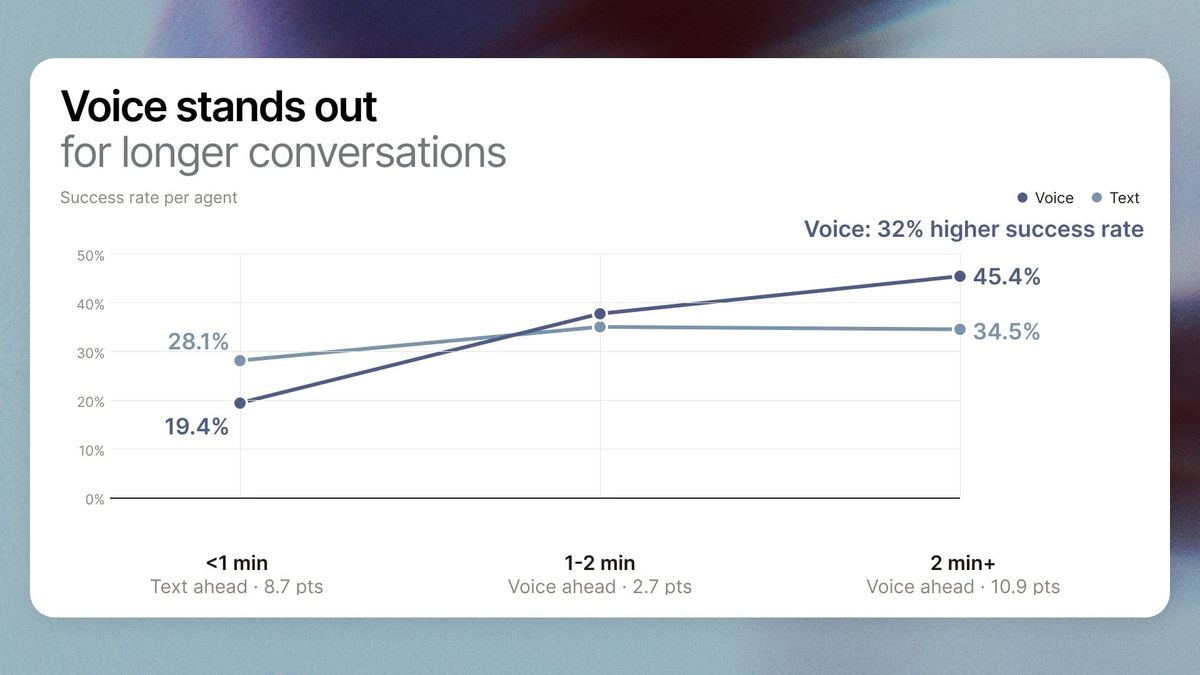
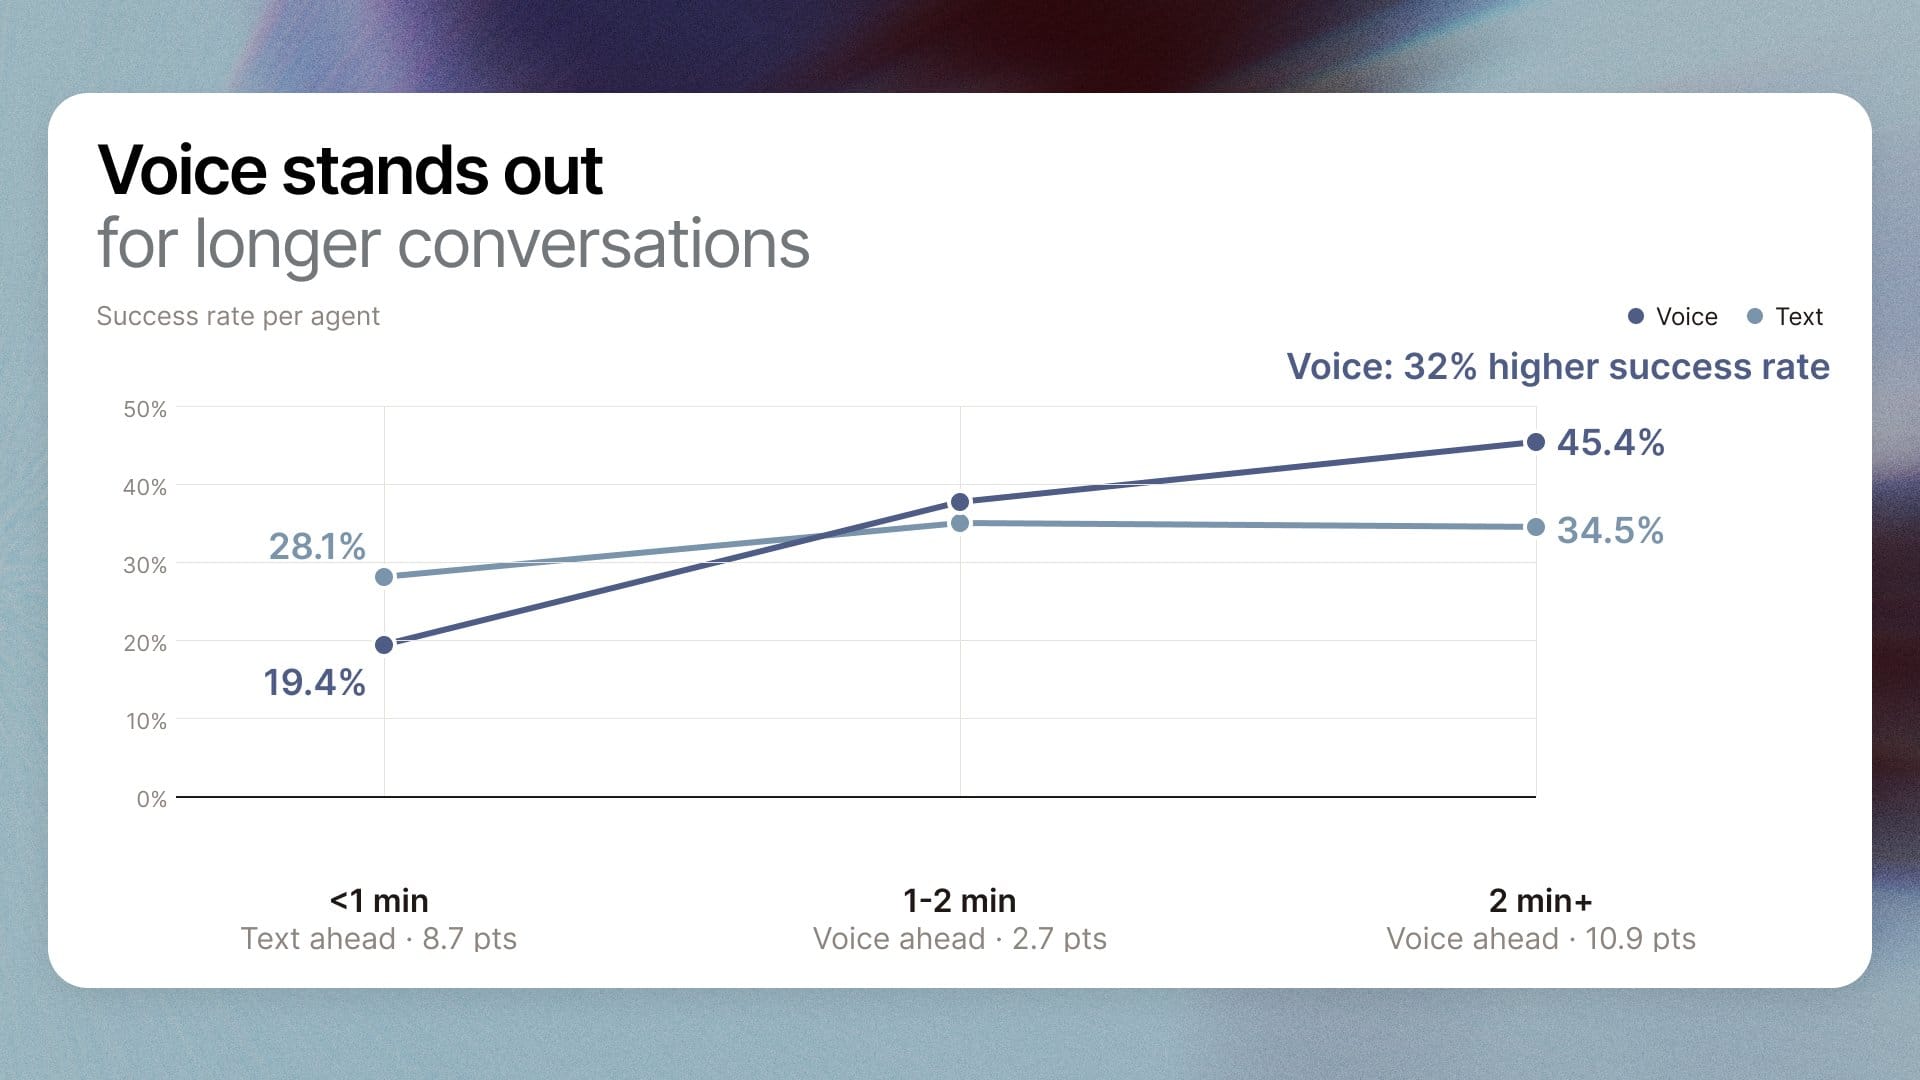
在不到一分鐘的組別,官方圖表顯示文字成功率為 28.1%,語音為 19.4%,差距為 8.7 個百分點。這與官方文字摘要所說的文字約高九個百分點一致。
到了約一至兩分鐘的組別,兩個管道的差距縮小,官方圖中語音領先 2.7 個百分點。這顯示同一份資料內,管道差異並沒有固定不變的方向與大小。
超過兩分鐘時,語音成功率為 45.4%,文字為 34.5%。兩者相減得到 10.9 個百分點,而把差距除以文字成功率,則約是三成二的相對提升。
因此,官方摘要寫的「高約百分之三十二」,對應的是相對增幅。若直接寫成成功率增加三十二個百分點,就會把原本的差距放大,讀者也無法和圖中的兩個成功率對上。
研究另指出,長對話組中,接近三分之二的代理在語音有明顯較好的表現。這補充了差異分布,但仍保留其他代理沒有同樣結果的情況,團隊需要回到自己的服務觀察。
成功案件的時間,另有一組分母
在成功且超過兩分鐘的對話中,語音平均約四點六分鐘,文字約七分鐘。這表示在這個已成功的子集合裡,語音處理時間約少三分之一。
這組數字的用途是觀察完成工作後的時間差,不能直接推算所有進線平均縮短多少。因為未成功的案件與較短的對話,都沒有放在這個比較裡。
此外,官方只在兩種管道都有足夠成功長對話的九十個代理中,計算哪個管道更快。其中百分之七十八的代理,成功案件在語音花的時間較少。
這個百分之七十八的分母是九十個代理,與整體四百六十九個代理不同。保留樣本範圍,才看得出這項結論需要哪些服務資料才能重現。
成功率與成功時間一起看,能提出一個值得驗證的方向。對需要較多來回的工作,語音可能同時影響完成機會與對話長度,但要理解其原因,還得看等待時間和顧客感受。
回應延遲與語音偏好,為何要分開看?
模型換快後的服務觀察,與九十八人的情境實驗,回答的是不同問題。前者觀察系統變動後的表現,後者則直接詢問參與者使用兩個管道後的偏好。
延遲分析觀察到什麼?
官方另分析改用更快語言模型的對話,平均端到端延遲減少百分之十六,並與成功率相對提升百分之二十六相關。端到端延遲可以理解為顧客等待整套系統回應的時間。
在這組觀察裡,十五秒內提早掛斷的比例,也從百分之二十一點一下降到百分之三點八。這說明對話能否順利開始,本身就可能與回應速度有關。
不過,官方使用的是相關性描述。這些數字可以支持團隊檢查延遲與掛斷情形,但仍需要考慮模型、任務與服務設定同時變動的可能,不能只靠觀察就算出等待時間的獨立因果效果。
如果團隊要重現這段觀察,就要在模型更新前後保存可比較的任務與設定。因為成功率和回應時間同時受到多個環節影響,這些背景越完整,後續才越容易知道要改善哪個步驟。
對實際工作而言,這段分析提醒我們,把語音做成能說話還不夠。若每次往返都等很久,顧客可能在問題尚未釐清前離開,因此速度應該與回答內容一起衡量。
情境實驗的偏好怎麼讀?
另一項研究找來九十八位參與者,模擬航班取消後需要處理安排的情境。每人都使用語音與文字,兩種管道的先後順序採隨機安排,再詢問使用感受。
結果有百分之八十五偏好語音,主要理由包括速度與同理感。這提供一個有具體情境的顧客體驗訊號,也讓研究能討論為何壓力較高的工作可能偏向說話。
但偏好本身和正式客服的完成率屬於不同指標。有人覺得語音較舒服,仍要看服務是否真的完成需求,反過來,成功處理也不必然代表顧客最喜歡那個管道。
官方文章連出的取消航班影片,是相似情境的產品展示。它可以協助理解應用方式,但不能當成這九十八人的原始實驗紀錄,引用時也應保留用途說明。
把正式服務、延遲觀察與情境偏好分開後,三組證據便各有位置。團隊接下來可以依自己要改善的是完成率、等待時間或顧客感受,選擇對應的驗收方式,詳見延遲與情境實驗說明。
客服團隊如何依任務設計驗收?
團隊可以依任務長度、完成條件與轉人工情況,建立兩個管道相同的衡量方式。這是從研究方法推導的導入安排,實際結果仍須由自己的服務資料確認。
第一步是把常見工作分成可辨認的類型。訂單狀態查詢、資料更改與複雜售後,各有不同需要補充的資訊,先按內容分類,才能知道對話時間背後真正發生什麼工作。
接著為每一類任務寫下成功條件。例如資料是否完成更新、顧客是否取得需要的安排,或問題是否必須轉交人工。這讓語音與文字都對照同一個業務目標。
時間也可以分開記錄。整段對話多久、顧客每次等待多久,以及已成功案件花多久,會回答不同的營運問題,把它們混成一個平均值,容易忽略中途離開的情況。
轉人工的原因同樣有助於理解差異。若某些案件需要額外身分確認或特殊權限,就應把原因留在紀錄裡,後續才知道問題來自管道、任務限制,還是工具沒有接上。
正式服務資料也可以保留哪些案件沒有結束。顧客提早離開、系統等待補充與轉人工處理,分別指出不同中斷位置,這些紀錄能協助團隊知道長對話到底卡在什麼步驟。
對同一任務比較時,也要留意兩個管道的使用者組成。若需要大量補充資料的人自然都打電話,直接比較總平均,就可能把任務差異算進管道效果。
這也是官方讓代理與自己比較的啟發。團隊可以先把相近條件的工作放在一起,逐步檢查哪種管道較容易完成,而不是一開始就用全公司平均做單一結論。
如果另外收集顧客回饋,就應把偏好、滿意度和實際完成分開呈現。這樣當顧客喜歡某個管道、但工作仍常失敗時,團隊能清楚知道還有哪些步驟需要修正。
當資料能保留這些前後關係,研究數字就能成為設計問題的起點。哪些任務需要立即往返、哪些適合留下文字內容,都能用具體的服務結果繼續回答。
延伸閱讀:ElevenLabs 推出 Architect,讓 AI 協助設定與測試語音代理
延伸閱讀:ElevenLabs 推出合成語音偵測:客服 AI 接到另一個 AI,該怎麼辨識?
語音客服研究常見問題
研究能證明所有客服都該改成語音嗎?
資料在不同對話長度出現不同結果,而各代理也有不同業務成功條件。較適合從自己的任務類型開始比較,再看哪些工作能重現成功率、時間或體驗上的改善。
百分之三十二和十點九個百分點有何關係?
超過兩分鐘組的成功率差距為十點九個百分點,相對於文字的三十四點五百分比,約高三成二。兩種寫法分別表示絕對差距與相對增幅,引用時需要說清楚。
百分之七十八是全部代理都比較快嗎?
這個比例來自九十個有足夠成功長對話資料的代理。它描述的是該子集合中,語音成功對話較快的代理比例,不能換成全體四百六十九個代理的結論。
取消航班實驗測到實際航空公司的處理結果嗎?
官方描述的是模擬情境,九十八位參與者用過兩種管道後表達偏好。它提供使用感受的比較,正式訂票、改票與客服案件能否解決,仍需要相應的實際服務資料驗證。
研究由誰提供?
分析由 ElevenLabs 發布,資料與實驗應依供應商研究理解。本刊沒有獨立重測,也沒有把正式服務的相關性描述為所有業務都能保證重現的效果。
ElevenLabs 語音客服研究把管道選擇拉回具體任務。對需要多次釐清的服務,最值得先驗證的是能否更順利完成工作,再把等待時間與顧客感受一起放進評估。
想持續掌握 AI 研究與企業應用進展,歡迎免費訂閱 AI 郵報。