ERNIE 5.5 Flash Base 開放權重,預訓練底座與聊天模型差在哪裡?
百度在 11 月 5 日公開 ERNIE 5.5 Flash Base,交付的是完成預訓練、尚未經中期與後期訓練的底座。它讓開發者自行選擇資料、目標與行為規則。 我會把它視為具備訓練資源團隊的研究材料。只想找一個立即回答問題的助理,應先看已完成指令調整的產品,避免把底座能力當成最終使用體驗。

同樣寫著開放權重,有些模型下載後就能對話,有些則是留給開發者繼續訓練的起點。選錯階段,後續投入的工作會差很多。
百度在 11 月 5 日公開 ERNIE 5.5 Flash Base,交付的是完成預訓練、尚未經中期與後期訓練的底座。它讓開發者自行選擇資料、目標與行為規則。
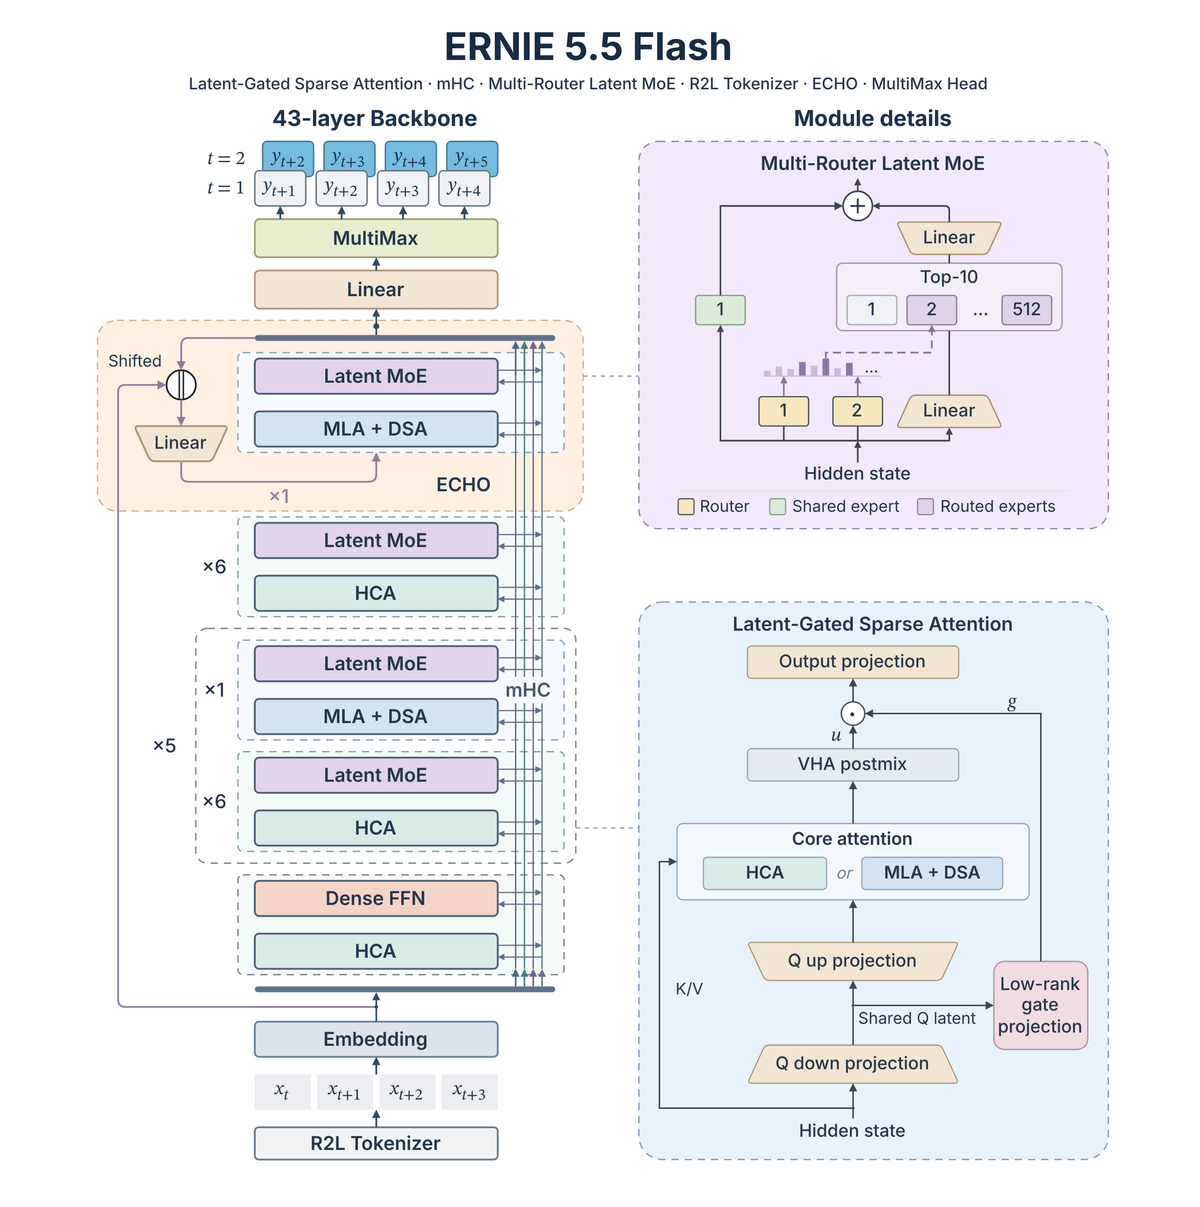
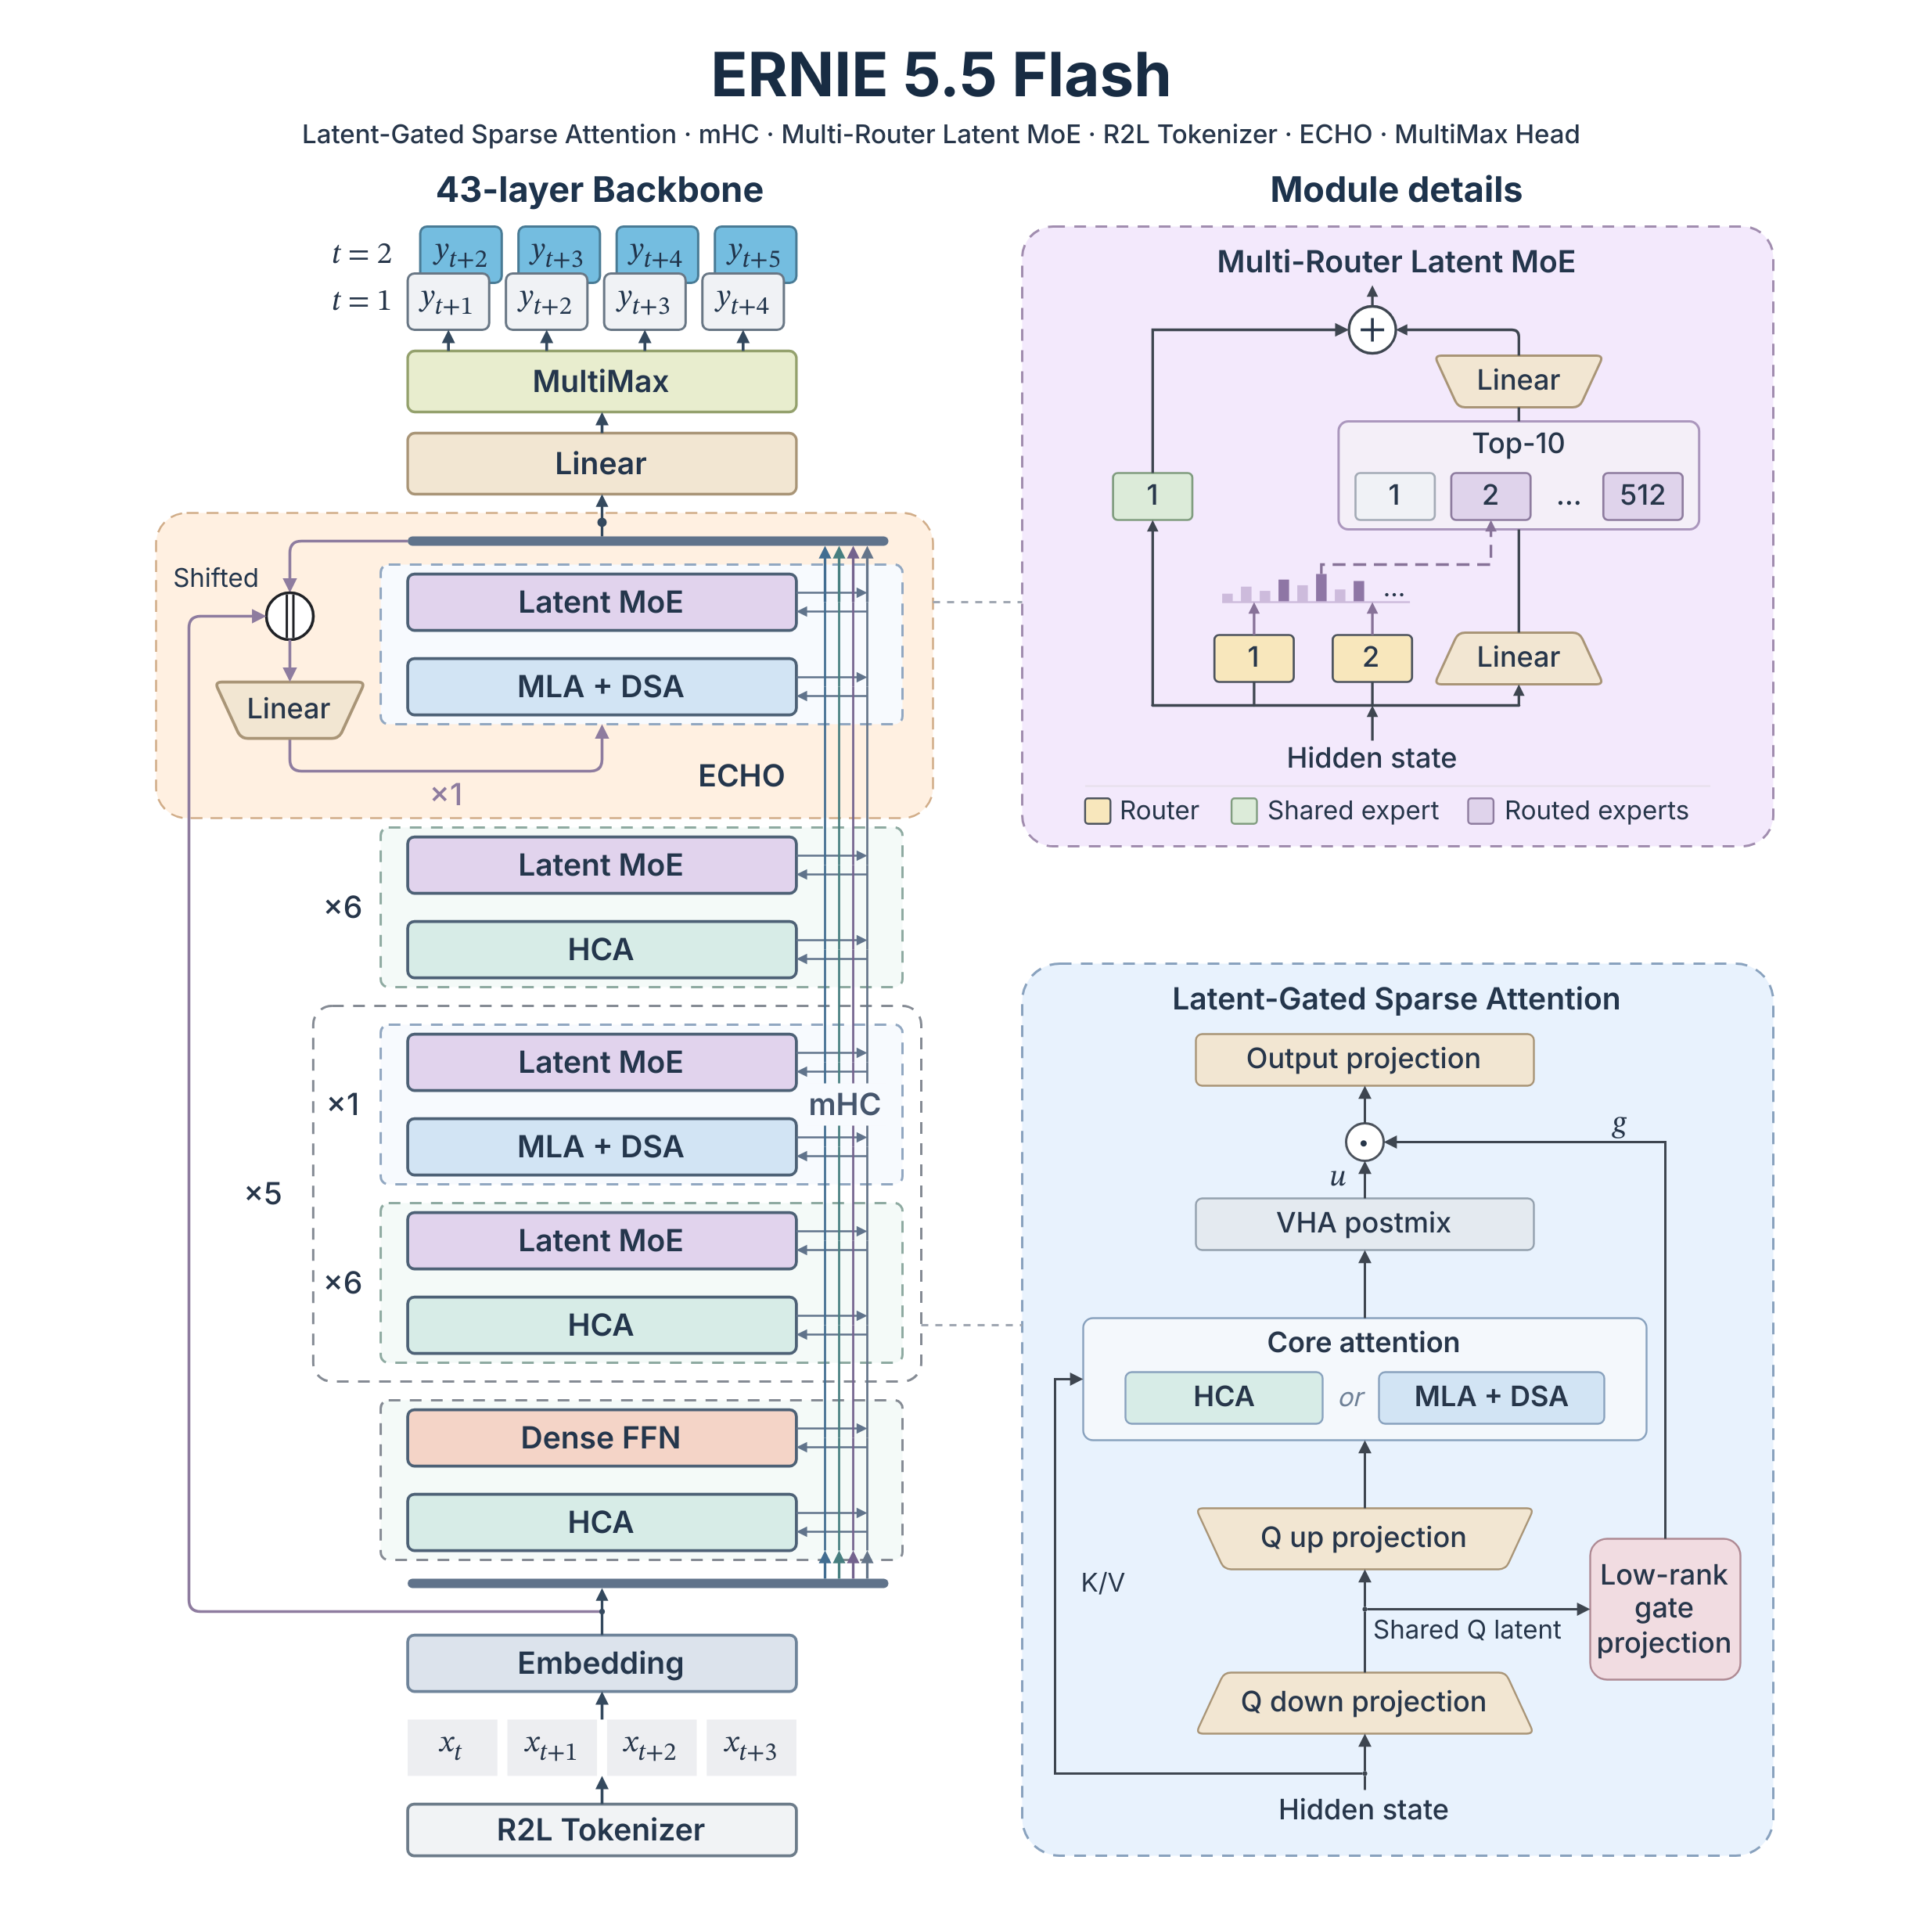
這個版本有 2,800 億個總參數,每個 token 啟用約 140 億個,並公開 FP8 與 BF16 權重。模型規模與檔案格式,會直接影響後續部署方式。
官方所稱的百萬 token 支援,指微調與推論階段的上下文。預訓練最大長度為 128K,因此兩個數字代表的訓練經驗並不相同。
我會把它視為具備訓練資源團隊的研究材料。只想找一個立即回答問題的助理,應先看已完成指令調整的產品,避免把底座能力當成最終使用體驗。
理解這次發布,先要看預訓練底座把哪些決定留給開發者,再看長文架構與比較成績如何支撐這個選擇。
ERNIE 5.5 Flash Base 為何先交付預訓練底座?
這次交付的價值,在於讓開發者從一般能力出發,自行決定模型接下來要學什麼。官方模型頁特別說明,這是預訓練結束時保存的檢查點,尚未經過後續調整。
預訓練讓系統從大量資料學會文字、知識與程式規律。之後的訓練才會進一步塑造如何遵循指令、回應使用者,以及在代理工作中選擇行動。
因此,底座比較像已經讀過很多材料的學習者,還沒有被教成特定公司的助理。開發團隊能決定接下來使用哪些資料,也需要自己承擔把能力整理成產品的工作。
這種安排適合有專門領域與明確評分規準的研究,例如要調整術語、格式或推理方法。若需求只是讓客服回答既有文件,採用底座可能帶來超出必要範圍的訓練負擔。
Base 與即將推出的成品要分開
官方發布貼文也說,完成後期訓練的 ERNIE 5.5 Flash 將在之後推出。這讓 Base 的定位很明確,兩者不能只因名稱接近就共用功能描述。
例如聊天模板、工具呼叫與對齊行為,需要看實際交付版本。底座具備程式與長文能力,不會自動表示下載後已能用同樣方式處理客服、付款或外部工具。
這次事件是權重與底座發布,架構相關論文則有各自的較早日期。讀者可以用論文理解方法,但不能把先前公開的技術都寫成十一月才第一次出現。
這份自由伴隨後續訓練工作,因此參數與運算設計會影響團隊能否把實驗做下去。
280B 與 14B 如何影響訓練與部署?
每個 token 啟用較少專家能減少部分計算,但完整模型仍需要保存所有權重。這是混合專家架構的基本取捨,不能只看啟用數字估算硬體。
混合專家可以理解為很多專門處理不同內容的小組,每一步只挑部分小組工作。token 則是模型處理文字的片段,可能是一個字或詞的一部分。
ERNIE 的總參數約 2,800 億,每一步啟用約 140 億。前者影響完整檔案規模,後者描述單次計算動用多少能力,因此兩者回答的成本問題不同。
官方還說明參數計算口徑,總數包含輸入嵌入與輸出頭,啟用數則不算嵌入查表,額外的預測模組另列。不同公司若採用不同口徑,接近的參數標籤也未必完全可比。
權重精度決定保存方式,並非能力保證
這次提供 FP8 與 BF16 版本,分別使用不同數值精度保存權重。較低精度可以降低部分儲存與運算負擔,但實際是否適用,仍要和推論框架、硬體支援一起看。
如果團隊打算繼續訓練,還要考慮訓練狀態、資料批次與中間結果占用的資源。能把權重放進記憶體,和能在相同設備上順利微調,是兩個不同門檻。
模型頁列出 Transformers、SGLang 與百度的 vLLM 路徑。這些是載入和執行的軟體環境,版本與支援程度會影響實際可用性,所以公開檔案並未消除部署工程。
採用底座的團隊通常還需要設計輸入與輸出格式。因為這一版尚未經指令調整,原本為聊天成品準備的提示流程,不一定能直接套用。
權重規模之外,長文章產生的暫存資料也會成為成本來源。
128K 訓練與百萬 token 推論,架構如何處理長文?
模型把多數層的歷史資訊壓縮保存,再用少數層保留更細的回看能力,以控制長輸入的成本。這個設計在處理長文件與程式庫時尤其重要,因為資訊會隨讀入內容持續累積。
語言模型產生新文字時,通常保存先前內容的部分計算結果,避免每次都從頭重算。這些暫存常稱為 KV 快取,可以理解為讓下一步接著工作的記憶資料。
輸入愈長,快取就可能愈大。若同時服務很多人,單次節省一部分暫存,也可能影響同一批硬體能處理多少請求。
壓縮歷史,再保留回看原文的路徑
官方架構中,多數層使用重度壓縮注意力,把每 128 個 token 的資訊壓成一筆快取。少數層則用另一種稀疏注意力方式,保留取得較完整上下文資訊的路徑。
注意力指模型在生成下一段時,決定要參考先前哪些內容的計算。壓縮能節省資源,但如果過度丟掉細節,長文回答就可能失去重要依據,因此兩種設計需要配合。
這裡的「每128個保存一筆」只描述特定層的快取安排。整個模型還有其他層、權重與工作步驟,所以不能換算成所有記憶體都少128倍,或端到端速度同樣提高。
對實際工作,更有意義的問題是較長輸入下,模型能否找回跨段細節,以及多位使用者同時呼叫時,系統是否仍能維持可接受的等待。
支援長度與學習長度並非同一件事
模型從零預訓練約使用 33.5 兆個 token,最大訓練上下文為 128K。官方再列出微調與推論支援百萬 token,並在發布設定中啟用相應長度。
前者描述模型學習時看過的序列規模,後者描述後續流程可處理的上限。這兩個條件可以同時成立,卻不能簡化成從一開始就以百萬長度完成全部預訓練。
可放進百萬 token 也不表示每個位置都會同樣可靠。實際長文能力還需要檢查跨段關聯、遠端資訊與答案依據,因此公開評測中的長文項目比單看上限更有參考價值。
成本設計是否兼顧品質,必須回到同樣測試方法下的成績。
官方評測在比什麼,為何比較對象也是 Base?
底座之間使用同一套提示與評分方法,較能看出預訓練能力的差異,卻不等於成品助理排行榜。比較對象若處於不同訓練階段,結果就會混入額外指令調整的影響。
官方把這版與 DeepSeek-V4-Flash-Base、Hy3-preview-Base、MiMo-V2.5-Base 放在共同流程下評估。這個選擇有助於比較接近規模的底座,而非宣稱擊敗所有最新旗艦產品。
模型頁說明各家使用相同評估管線、提示與少量示範設定。少量示範是先提供幾個例子,讓模型理解題型,因此比較時示範數量也應保持一致。
不同測試的領先與落後要一起看
官方報告 MMLU-Pro 為 78.4,HumanEval+ 為 82.3,LiveCodeBench 為 40.1。這些分別從知識推理與程式題目觀察能力,但任務內容與計分方式不同,數字不能直接互相比高低。
比較有意義的是同一個測試裡,各模型在相同條件下的表現。即使程式題分數較高,也還需要知道模型能否在自己的專案裡讀檔案、規劃修改與接上工具。
模型頁也保留沒有領先的項目。例如 HELMET 的重新排序測試為 56.2,低於表中 DeepSeek 的 60.0。重新排序關心哪些候選資訊應先被選出,與產生正確程式是不同能力。
因此,「同規模結果強」應理解成多項指標的觀察,不能寫成每個測試都第一。保留較弱項目,反而更容易讓團隊挑出需要自己驗證的工作。
自報結果提供起點,部署還有新問題
這些成績來自發布者的統一評估,沒有取代第三方重現。使用相同測試流程能改善內部可比性,但資料處理、提示與推論設定仍會影響結果。
尤其底座沒有完成產品行為調整,公開題目上的能力和面對任意使用者輸入時的行為並不相同。要做成助理,還需要把正確格式、拒絕條件與工具使用習慣教進系統。
如果後續調整使某項能力提升,其他能力也可能改變。因此部署前的比較對象應是自己的最終調整版本,而不是只沿用底座發布頁的分數。
評測說明起點的能力,授權與後續訓練責任則決定它能否進入產品。
哪些團隊適合採用,開始前要備妥什麼?
有特定資料與明確訓練目標的團隊,才比較能利用這個尚未定型的底座。因為後續方向由自己選擇,資料品質與評分方法會直接影響投入是否有意義。
如果目標是領域適應,就需要能代表該領域的材料。如果目標是遵循指令,則要有清楚的輸入輸出示範。不同目標不應只用同一個通用分數決定成功與否。
保留未參與調整的資料也很重要。否則模型可能只是更熟悉看過的例子,團隊卻把分數上升誤認為新資料上的能力進步。
授權是交付條件的一部分
這版使用 ERNIE 5.5 Flash Base 自訂模型授權,並非 Apache 2.0 或 MIT。原始授權文件才是判斷使用、修改與散布條件的依據。
權重公開讓團隊能取得檔案,卻沒有自動把所有用途變成不受限制。企業若要把調整後版本放進服務,應把原始條款和自己的交付形式一起確認。
同樣地,程式框架的授權也不會取代權重授權。推論引擎可以開源,模型仍有自己的使用條件,因此兩層需要分開記錄。
在實際預算裡,還要加入檔案保存、部署、持續調整與新版本測試。啟用參數較少有助於部分運算,但不會讓這些工作一起消失。
對資源較少、只想立即用上新助理的人,先觀察後續指令版本與服務入口,通常更接近需求。對要研究模型如何學習的團隊,現在的底座則保留較多可自行決定的空間。
延伸閱讀:Qwen3.8-27B 開放權重:27B 多模態模型、百萬 Token 與兩種版本差異一次看
延伸閱讀:Nanbeige4.3-33B 開放權重:先打造教師模型,程式代理成績與部署代價怎麼看?
把資料、運算與授權一起算進成本,才能判斷開放權重是否符合自己的工作。
ERNIE 5.5 Flash Base 常見問題 FAQ
ERNIE 5.5 Flash Base 能直接當聊天機器人嗎?
它是完成預訓練的底座,尚未經過中期與後期調整。開發者可以繼續訓練,但不能把它直接等同於已完成指令調整的聊天成品。
百萬 token 是預訓練長度嗎?
官方列出的預訓練最大上下文是128K,百萬token支援用於微調與推論,因此兩個階段要分開理解。
14B 啟用參數就等於14B模型嗎?
它只描述每一步使用的部分參數,完整權重規模約280B。部署還需要考慮精度、暫存與同時服務的工作量。
權重可下載就代表使用沒有限制嗎?
用途仍受自訂模型授權約束。權重公開、程式開源與使用條件是不同項目,應依各自原始文件確認。
結論
ERNIE 5.5 Flash Base 提供的是可以繼續塑造的訓練起點。它的價值在於把資料與後續目標交給開發者,同時也把相應的工程與行為調整工作留給採用者。
有專門資料與運算資源的團隊,可以從官方模型頁與授權文件開始,先固定一個明確任務比較底座與調整後版本,再決定是否擴大投入。