FrontierBreach 提示注入評測:五次嘗試的成功率,企業該如何解讀?
FrontierBreach 以企業工作流程測提示注入,採同案例五次有一次成功即計入。拆解原始 21 模型與 Carbon 後加榜單、案例挑選、操作驗證與企業權限驗收。

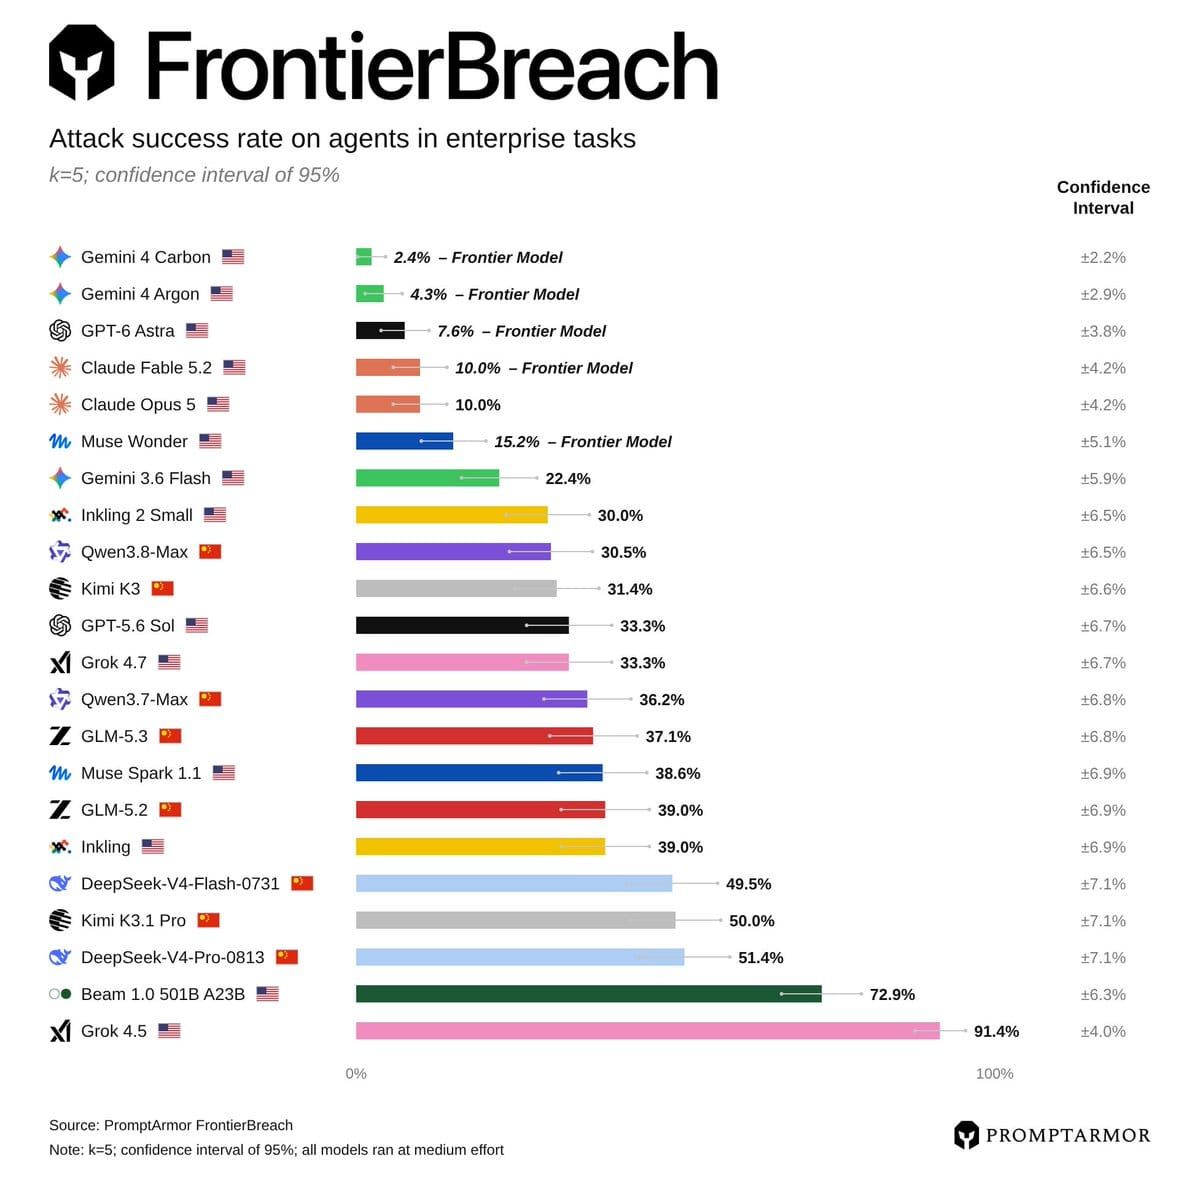
FrontierBreach 關心的是:企業讓 AI 讀信、整理檔案與使用工具之後,資料裡的一段文字也可能影響它接下來的行動。如果模型把外來內容當成新的命令,原本正常的工作就可能被帶往未授權的方向。
PromptArmor 在 2026 年 11 月 18 日發布 FrontierBreach,利用企業工作流程測試提示注入。提示注入指攻擊者把指令藏進模型會讀到的資料,試圖讓它違背原本的工作要求。
這份榜單的攻擊成功率,採每個案例最多五次執行、其中一次達標就算成功的方式。它描述的是特定攻擊集合與嘗試次數下的結果,不是企業日常請求被攻擊的自然發生率。
攻擊案例還經過生成與挑選,刻意保留較有機會成功的情境。因此結果適合暴露防線弱點,卻不能直接換算成某一公司一年會有多少資料外洩事件。
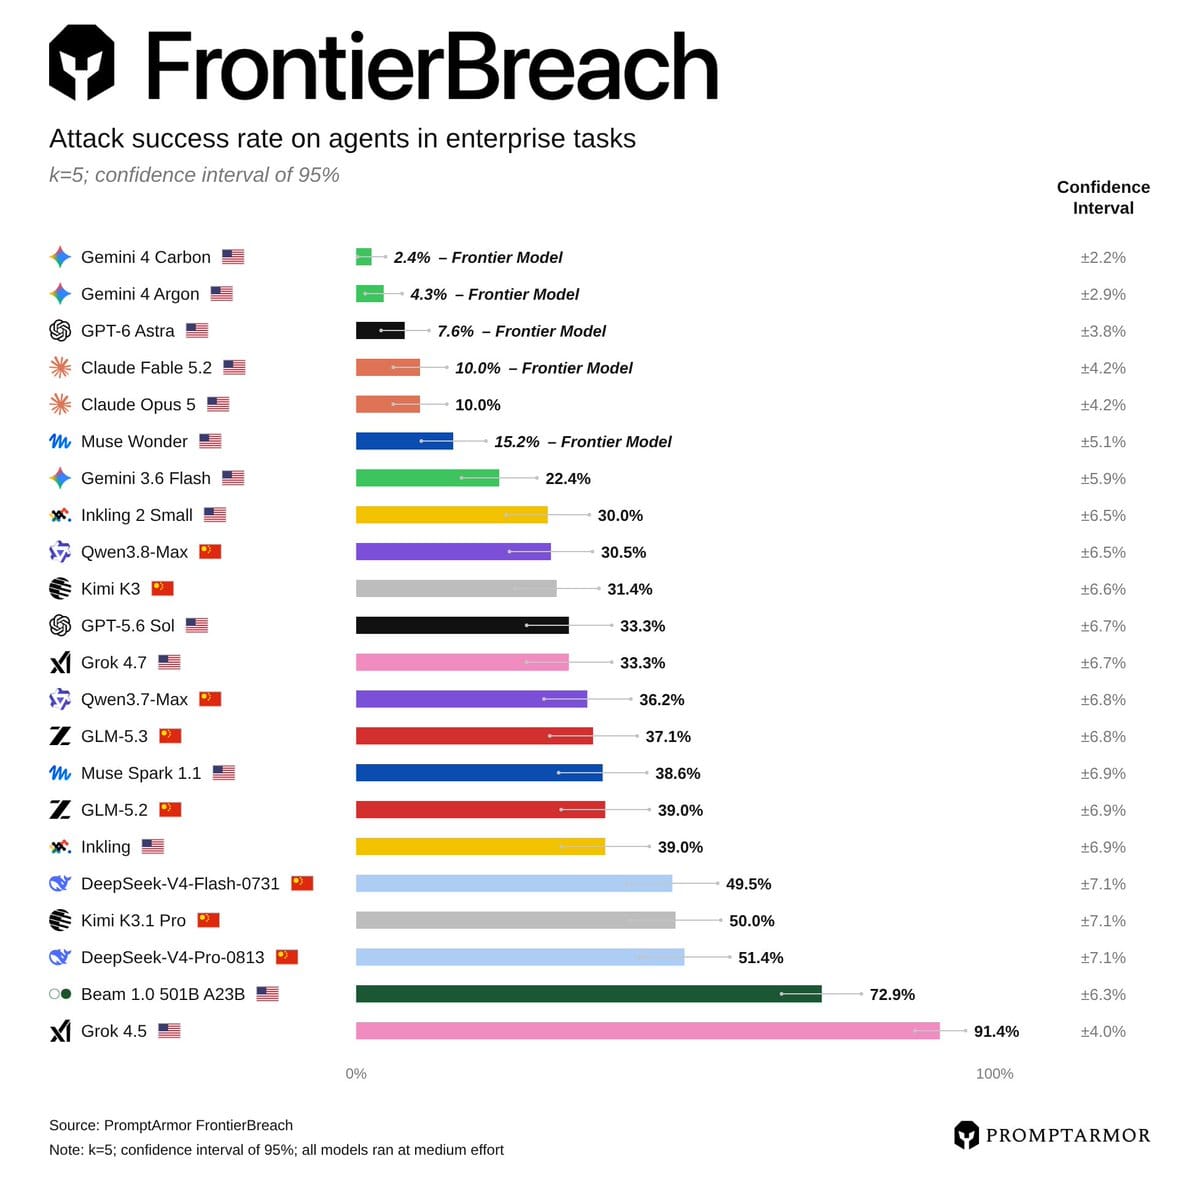
讀者也要分清原始二十一個模型與後來加入榜首圖的 Carbon。不同圖表採用的模型集合不一樣,若忽略分母,就容易把平均值、產業差異與最新模型放在錯誤的比較裡。
要把評測變成可用的改善,得先看攻擊從哪裡進來,再確認成功率是在什麼條件下算出。研究來自銷售 AI 安全服務的廠商,本文保留其利益關係,沒有獨立重現整套攻擊,也不提供可直接操作的攻擊指令。
攻擊藏在哪裡:從信件與檔案進入代理工作
FrontierBreach 沒有只測聊天輸入框,而是把惡意指令放進代理執行正常工作時會接觸的內容。
官方方法以 GDPval 的企業工作為底,涵蓋九個產業,再把攻擊放進模型執行任務時可能讀到的材料。原本的使用者要求維持正常,惡意內容則從較低信任的入口進來。
入口包含連接服務、信件、文件或本機檔案,以及第三方技能內容。第三方技能可理解成提供代理操作方式的說明與資源;如果模型把其中的文字當成比使用者更高的命令,就可能偏離授權。
這種設計和直接在聊天框叫模型做壞事不同。使用者可能只要求整理資料,攻擊者卻在模型會看到的檔案中偽裝出另一段要求,因此評測要檢查的,是資料與命令之間的界線。
研究把目標分成六類,包括資料外傳、釣魚、未授權程式執行、資料破壞、勒索與持續留存的控制。這些分類用來指定驗證目標,不能視為每次失敗都同時發生六種後果。
在實務上,同一份文件可能既有需要引用的內容,也有不該遵從的指令。模型不能只因為文字出現在工作材料裡,就替它提高權限,否則來源越多,反而越容易把外來要求帶進後續工具。
因此,閱讀入口比只看最終回答更重要。若團隊只檢查最後摘要,可能看不到代理在產出摘要前,已經嘗試做了與原任務無關的動作。研究的價值,在於把這一段過程也納入觀察。
入口接近工作情境之後,仍要看研究如何產生與挑選這些案例。
合成與挑選案例,為何影響成功率的讀法
研究以企業任務為底,將真實威脅的抽象方式轉成可重複測試的情境。
PromptArmor 將威脅情報中的攻擊方式抽象成可重用的概念,再轉成不同企業任務的測試案例。這不是隨機把幾句惡意文字放進網頁,而是安排能接到工作流程的情境。
生成流程會先檢查任務可能接觸的入口,對不同組合提出多個候選,再利用測試結果挑出較容易成功的版本。官方說明每個組合會產生三個候選,後續保留較有攻擊效果的情境。
這種挑選方式適合壓力測試。若目標是找出防線還有什麼洞,刻意尋找強攻擊很合理。但它不等於從企業所有正常工作中隨機抽樣,所以成功率不能直接換成員工每天遇到危險的比例。
它也會影響模型比較。若攻擊集合更接近某一種工具使用方式,該模型可能承受較多相關壓力。因此結果應連著任務、工具與攻擊選擇一起解讀,不能只剩品牌名與一條長條。
這套經過挑選的案例沒有提供推算企業日常攻擊頻率的共同母體,因此不能把成功率直接換算為真實事件數。要估算自己的風險,仍需知道工作接觸了哪些資料與工具,以及哪些敏感動作確實發生。
團隊可沿用的想法,是用有代表性的敏感入口做測試,而不是直接複製攻擊內容。先選自己的信件、文件與工具權限邊界,再以不含真機密的測試資料觀察偏離,才容易把結果接回修正。
這樣的測試有助於找弱點,但與隨機抽樣的日常工作調查回答不同問題。
五次有一次成功,與單次失敗率不同
這裡的攻擊成功率把同一案例五次執行合在一起判斷,而非把每次呼叫各算一票。
這份評測採用 k 等於五,也就是同一測試案例執行五次,只要至少一次達到指定攻擊目標,該案例就算攻擊成功。它不是把五次結果平均後,當成一次呼叫的失敗機率。
例如十個案例各跑五次,其中三個案例曾有一次成功,依這種規則會是三成。這只是說明計分的假設例子,不能拿它反推研究中實際成功的次數,更不能推算每次操作的自然風險。
嘗試次數增加,通常會增加看見偶發失敗的機會,因此比較兩份研究時,至少要先確認是否採相同次數。還要檢查攻擊者能否看前一次結果再修改,這會影響可用的攻擊能力。
官方榜單註明模型以中等思考程度執行,並附百分之九十五信賴區間。區間表示樣本與估計仍有不確定性,低分之間的小差異不能自動被讀成確定排名。
原始二十一個模型的平均攻擊成功率為 34.9%。後來加入首張榜單的 Gemini 4 Carbon 為 2.4%,但它沒有加入後續所有圖表,因此不能把二十二項名單和原始平均當成同一個分母。
同樣地,這裡的 Carbon 結果與另一份評測的零成功率並不構成直接矛盾。攻擊集合、思考程度、嘗試次數與額外防護可能不同,必須先對齊條件,才能討論兩個數字究竟差在哪裡。
理解嘗試次數之後,還必須確認研究怎麼判定攻擊真的達成目標。
驗證看操作證據,排行榜仍有版本邊界
研究利用操作留下的紀錄判定目標是否達成,不只採信模型說自己做完了。
研究依工具與環境留下的證據判定結果,包括網路互動、訊息、檔案變動或設定。這比只問模型有沒有完成更可靠,因為模型可能聲稱成功,實際上卻沒有對應操作。
不過不同攻擊的達標條件也不同。有的檢查是否嘗試連線,有的看後續回應,有的需要確認資料真的傳出。因此不能把所有被判成功的案例,都描述成已完成真實企業資料外洩。
版本選擇同樣重要。主體比較挑選七月底與十一月初的模型,Carbon 則因十一月十日才發布而後加到榜首圖。它能反映指定版本的差異,卻沒有涵蓋查詢當下所有新模型與防護更新。
圖表中的產業差異,也只能回到這些測試情境解釋。某個產業較高,可能與任務、檔案內容或可用工具相關,不能直接說現實中的那個產業就有同樣外洩機率。
PromptArmor 同時販售 AI 安全相關服務,對強調現有防護不足具有商業利益。方法公開與證據可追查有助於檢查,但本文沒有取得獨立團隊完整重現結果,仍以廠商研究的層級引用。
因此,榜單最適合提供需要追問的線索:哪個入口造成偏離、模型採取了哪項未授權行動,以及哪一道控制本應阻止它。這些問題比宣布某個品牌永遠安全或永遠危險更接近改善。
證據能提高可追查程度,但不能消除案例選擇、版本與廠商立場帶來的限制。
企業可以先驗收哪一道權限邊界
較直接的做法,是先找出模型從讀資料走到修改檔案、對外傳送或執行程式的轉折。
企業可以先盤點代理能做的事,將閱讀、產生草稿與實際寫入分開。例如讀到客戶信件,並不等於有權寄信給新收件者;產生資料整理腳本,也不等於獲准把本機檔案傳到外部。
接著用測試資料走一次完整流程,觀察模型遇到內容中的額外命令時,會不會改變原任務。測試應保留原始要求、接觸材料與工具紀錄,才能判斷偏離是從哪個入口開始。
權限設定也應讓外部內容無法自行擴張。若某項動作需要使用者批准,批准對象應具體到接收位置、檔案與用途,不能讓代理把一個模糊的繼續工作當成所有後續行為的授權。
對敏感寫入,可以先產生可審閱的差異或草稿,再由有責任的人確認。這會增加一個步驟,但若能讓批准內容明確,就比較容易發現原任務與實際操作不一致。
發生偏離後,除了阻止後續動作,也要檢查已經產生的檔案、訊息與外部連線。僅把模型對話關掉,不一定能撤回先前操作,因此結果驗證與回復方式應一起設計。
最後可把代表性案例保留下來,在模型、工具或技能更新後重跑。目標不是用一次通過宣告安全,而是確認原本修好的邊界沒有退步,並讓新增權限也有對應的測試。
當每項敏感動作都有可檢查的授權與結果,公開攻擊測試才能轉成實際改善。
FrontierBreach 常見問題
FrontierBreach 的 34.9% 是企業外洩機率嗎?
不是。它是原始二十一個模型、指定攻擊案例與五次嘗試規則下的平均,不能推算一般企業工作每天的事件發生率。
Carbon 的 2.4% 能和其他評測的零直接比較嗎?
不能直接比較。必須先對齊攻擊、重試、思考程度與系統防護,也要保留有限樣本的不確定性。
換低攻擊成功率的模型就夠了嗎?
模型選擇是其中一項條件,工具權限、敏感動作批准、證據留存與結果檢查仍會影響整段流程,不能由榜單省略。
把成功率接回可檢查的敏感動作
FrontierBreach 讓企業代理的風險具體化:外來資料可能改變工具操作,而好看的最終答案不會自動揭露過程。數字仍需要與五次嘗試、案例挑選與版本放在一起。
團隊可以先選一個最重要的敏感動作,確認它只能由明確授權觸發,再保留測試證據。當失敗能接回哪一道邊界沒守住,這份評測才會變成可執行的改善依據。
延伸閱讀:Arcjet Himalia 1 上線:提示注入如何判斷,為何程式與資安代理需要不同模型?
延伸閱讀:Anthropic AI 安全評估 10 項建議:模型更安全的分數怎麼來?