Granite Speech 5.0 更新:多語轉寫、兩千詞提示,為何不等於支援中文聽寫?
Granite Speech 5.0 更新二十億參數模型、多語高速轉寫與多人錄音版本。本文分清中文翻譯和中文聽寫、兩千詞提示、說話者與時間指標,以及批次吞吐量不等於即時等待的原因。

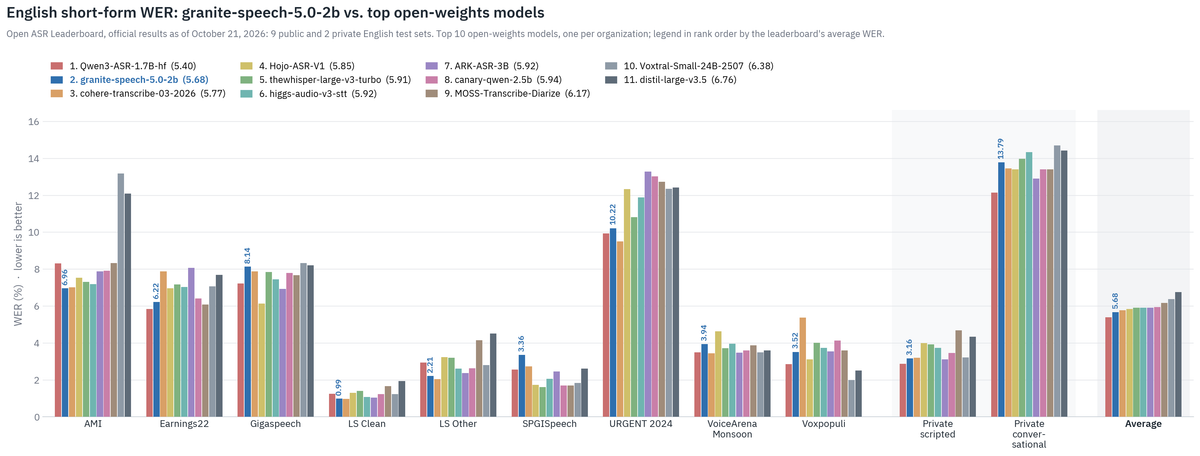
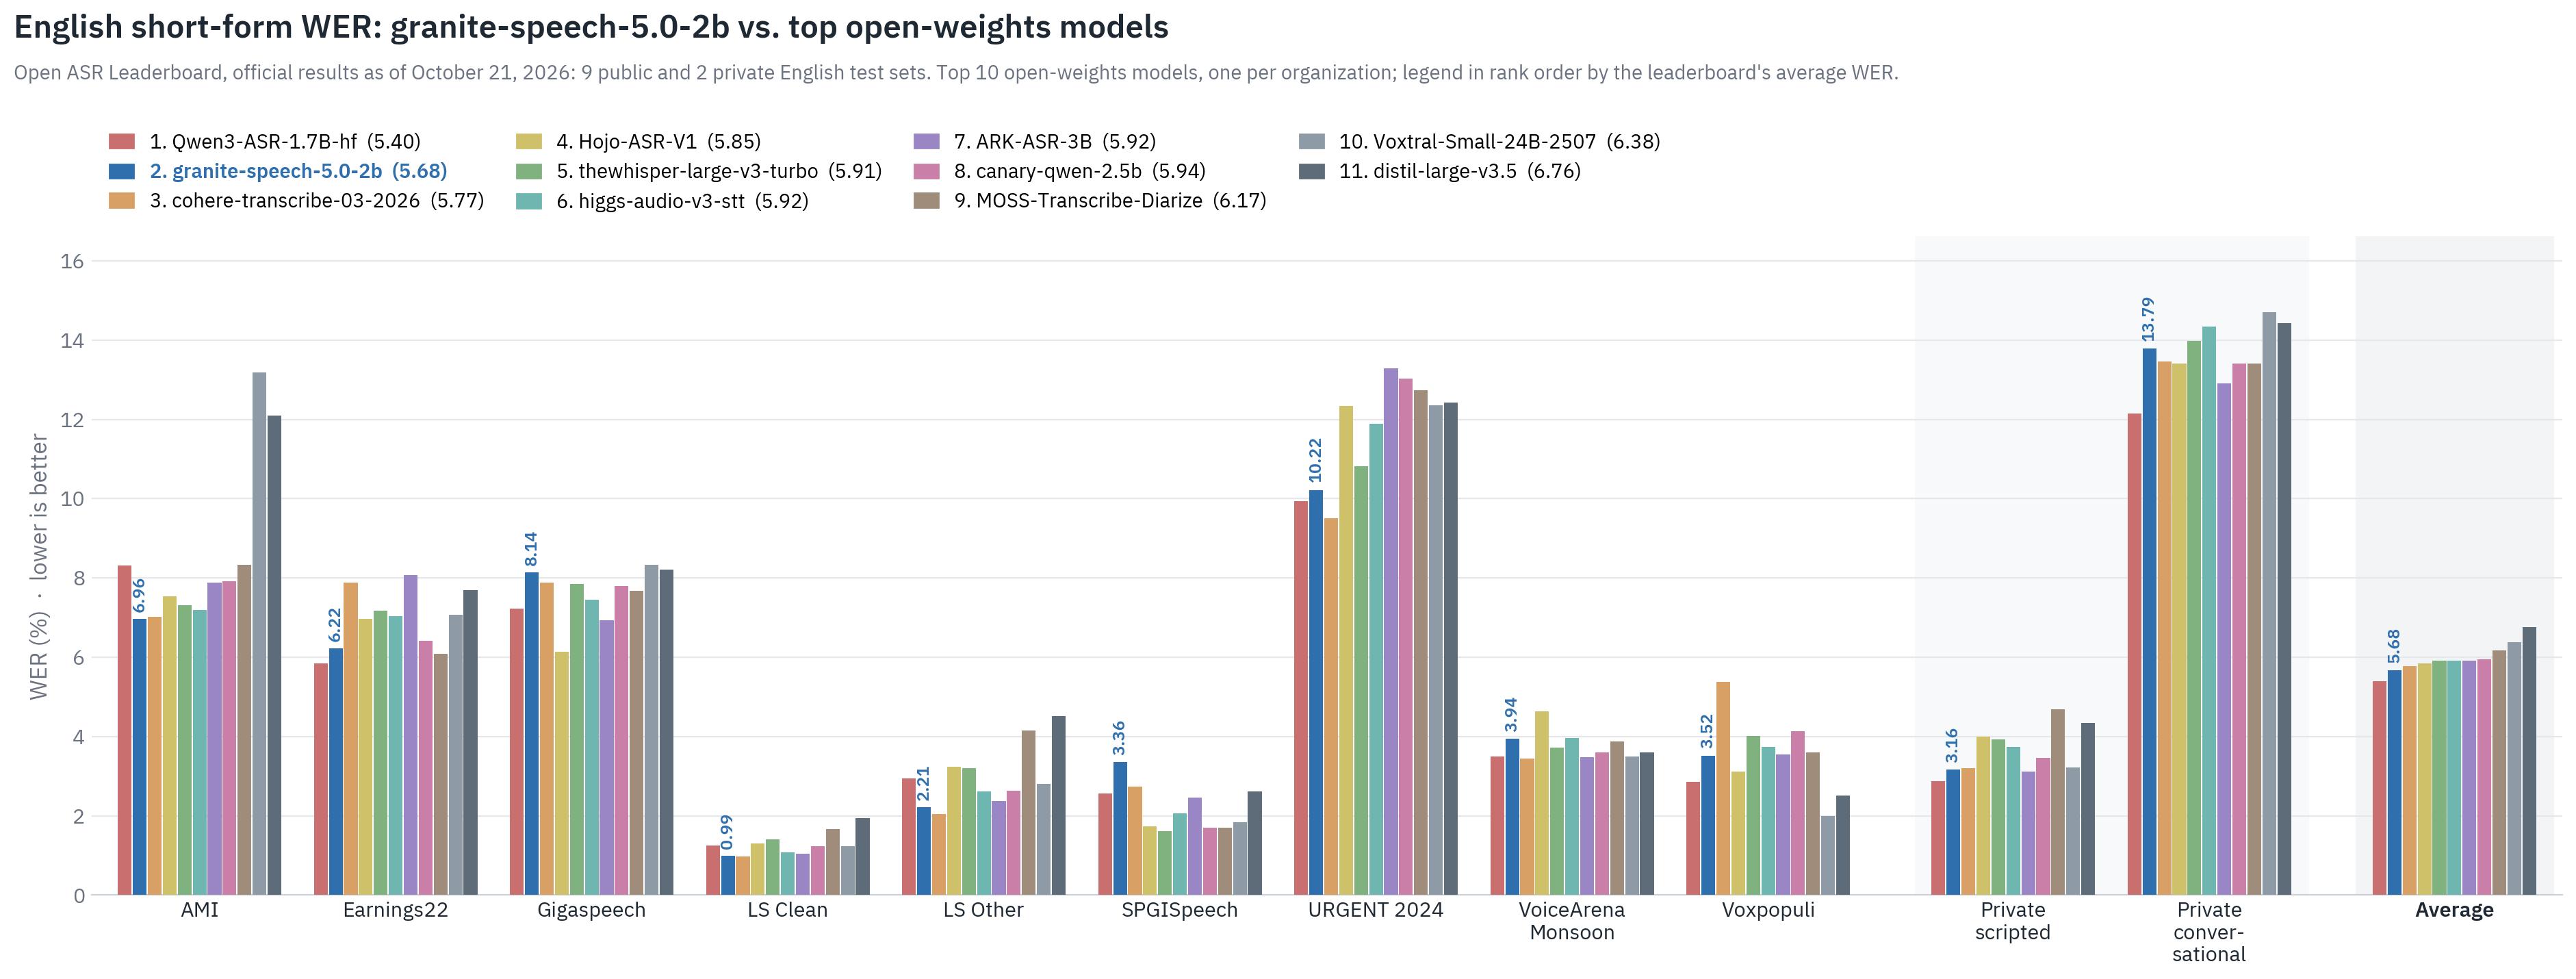
會議逐字稿錯一個人名,後面的搜尋和摘要也可能跟著錯。Granite Speech 5.0 這次把辨識品質、關鍵詞提示與說話者歸屬分成不同模型處理。
IBM 在 2026 年 10 月 21 日的更新文章裡,公布新二十億參數模型,也修訂小型高速轉寫和多人對話版本。它們的任務不同,不能只看版本數字決定誰較新。
對台灣讀者最容易混淆的是中文支援。官方列出英語翻譯成中文的方向,並沒有把中文列入新模型的語音轉文字輸入語言。
官方也提供最多兩千詞的提示名單,協助辨認產品名與縮寫。但提示只是偏向指定詞彙,不能保證錄音裡真的出現過那些詞。
處理英語或日語等支援語言的團隊適合測試,主要需求是台灣華語聽寫的人,則應先選有相應語言證據的模型。
先確認錄音語言與輸出目標,才能把三個模型放在正確的位置。
Granite Speech 三個版本各負責什麼?
Granite 新二十億模型重視辨識與翻譯,小型高速版負責大量轉寫,多人版本則補上人物與時間。因此,選擇應從工作問題開始,而不是把所有檔案當成同一個模型的大小版本。
依 IBM 的更新文章,新模型叫 5.0 2B,高速更新叫 5.0 470M Turbo CTC,多人版本則保留 4.1 2B Plus 名稱。
2B 與 470M 表示參數量級,也就是模型學到後保存多少數值。較小參數通常有利降低資源需求,但不能只憑大小推定每種語言的辨識表現。
Plus 沒有改成 5.0,是因為架構、提示格式與介面保持相同,主要改進權重。權重是訓練完成後保存的核心數值,所以同樣介面也可能因模型更新而產生不同結果。
這對既有系統有直接意義。若已經使用多人版本,可以先比較新舊權重在相同錄音的結果,未必需要把整條呼叫流程重新寫一遍。
Granite 高速版則從原本英語轉寫擴充多語,並加入自然標點與大小寫。它處理的是更快產生逐字稿,沒有因此變成能接續聊天的語音助理。
以下先依任務區分,避免把功能最少但速度快的模型,誤當成任何工作都適合的選擇。
| 版本 | 主要任務 | 優先核對的限制 |
|---|---|---|
| 5.0 2B | 多語聽寫、翻譯與詞彙提示 | 輸入語言與翻譯方向 |
| 5.0 470M Turbo CTC | 高吞吐、多語轉寫 | 不等同翻譯與多人歸屬 |
| 4.1 2B Plus | 多人錄音、人物與時間 | 人物歸屬與時間定位品質 |
表裡顯示,轉寫內容正確與知道誰在何時說話,是不同需求。處理訪談的人可能更重視後者,批次整理短錄音的人則可能先看前者與速度。
用途分開後,第一個需要核對的限制是語音輸入支援哪些語言。
中文翻譯與中文聽寫為何不同?
英語錄音轉成中文文字是翻譯,中文錄音轉成中文文字則是另一種辨識任務。因此,文件出現 Mandarin,不足以證明能處理中文會議逐字稿。
5.0 2B 模型卡列出的聽寫語言為英、法、德、西、葡與日語,翻譯支援這些語言與英語互轉,並額外提供英語轉義大利語和中文。
這裡兩個方向不對稱。英語可以翻成中文,不代表中文聲音也可以翻回英語,因為後者需要模型先理解另一種聲音輸入,不能只從輸出文字能力推定。
高速版的聽寫語言則包含義大利語,合計七種。它和二十億模型的語言清單不完全相同,所以選型時應直接對照各自模型卡,而不是只讀家族介紹。
對台灣使用者,這讓結論很清楚。主要做英語或日語錄音可以納入比較,主要處理華語或台語錄音,就應先找有對應語音輸入證據的方案。
混合語言也需要單獨測試。文件列出支援數種語言,不等於保證同一句在不同語言間切換時表現相同,尤其人名與產品名稱常會跨語言出現。
Granite 新版本可以在提示中指定輸入語言,幫助模型選擇預期的轉寫方向。但若聲音本身模糊或語言設定不對,這個提示也可能無法解決問題。
Granite 5.0 2B 的訓練使用約三十九萬小時公開音訊,並加入針對日語聽寫、關鍵詞和翻譯的合成資料。這說明模型不是只靠擴大語言清單,而是對特定能力增加訓練材料,但資料量不能直接當成每種語言的品質保證。
因此,實際測試應保存原始錄音和預期文字,分別記錄一般詞與專有名詞錯誤。只看一段看似通順的輸出,可能漏掉語言支援沒有涵蓋的內容。
翻譯還多了一層意思保留。原音可以辨識正確,轉成另一種語言時仍可能簡化限制或改變語氣,所以翻譯品質不能只用聽寫錯字率評估。
輸入語言吻合之後,領域詞彙才是改善逐字稿的下一個因素。
兩千詞提示如何幫助專有名詞?
提示名單把辨識偏向業務詞彙,但仍需要錄音證據與錯字檢查。這適合處理產品名稱、人名與縮寫,卻不表示名單裡的詞一定應該出現在逐字稿。
Granite 官方說 5.0 2B 的關鍵詞清單上限提高到兩千詞,可用於支援語言的聽寫與翻譯。這是一種事先提供領域線索的方法,讓模型不用只依一般常見字詞猜測。
例如錄音包含公司內部的產品代號,提供正確拼法有機會減少近音詞誤寫。但若名單塞進大量與錄音無關的詞,也不能假定清單越長就越準。
所以兩千是可容納範圍,而非推薦每段錄音一定要填滿的數量。選擇與當次內容直接相關的詞,更容易理解輸出變化來自哪些提示。
官方評測也將關鍵詞和一般詞分開觀察。它比較有無提示時,特定詞的辨認表現,這與整段逐字稿所有文字的錯字率並不是同一個分母。
Granite 多人 Plus 更新使用二十詞清單時,官方列出被提示詞的錯字率由 11.79 降至 6.48。這是指定測試的改善,不能直接套成兩千詞清單也一定有相同比例。
標點和大小寫則改善文字可讀性。對英文逐字稿,產品名的大小寫可能影響搜尋,句子邊界則影響後續摘要,所以這些功能有實際工作價值。
但可讀性改善不會自動修正事實。模型可能把一段話加上漂亮標點,卻仍然認錯其中的數字,所以閱讀起來順和忠實記錄聲音需要分開檢查。
5.0 2B 的模型卡建議以約兩分鐘片段處理,較長錄音先切段。這提醒使用者,長會議不一定適合直接整段送入。切段方式也要保留足夠前後文。
文字正確之後,多人錄音還有誰說了哪句的問題。
人物與時間改善要用哪些指標看?
說話者歸屬和時間誤差測的是逐字稿的定位品質,不能跟一般錯字率混成同一種準確率。對需要回聽證據的工作,這些定位能力和文字本身同樣重要。
4.1 2B Plus 模型卡提供不同指標,分別處理說話者標記、帶人物的逐字稿、時間位置與長錄音。
官方摘要中,每個詞的平均時間定位誤差 AAS,由 210.86 毫秒降至 98.54 毫秒,表示在其測試定義下位置更接近參考。它測量字詞位置偏移,並非產生逐字稿的等待時間。
長錄音的詞錯誤率由 13.53% 降至 10.22%,這裡計算的是字詞替換、刪除與插入造成的錯誤。比例較低表示在指定資料裡更接近參考逐字稿。
說話者相關的 cpWER 則由 30.50% 降到 28.48%,它把人物歸屬納入比較。因此,單純字詞都對,若分給錯的人,對多人工作仍可能造成問題。
這也解釋為何人物錯誤值得獨立列出。會議裡把甲的承諾記成乙說的,後續待辦分配就可能出錯,即使整段文字看起來沒有明顯語病。
另一個人物指標 WDER 從 4.40% 降到 4.10%,官方摘要以約百分之七的相對改善描述。相對比例與百分點差異不能混用,更不能把它當成所有人物判定都接近百分之百。
對訪談或客服電話,合理的驗收應保留重疊說話與中途換人的片段。因為安靜輪流發言的錄音,通常無法凸顯實際多人物環境最常遇到的困難。
時間標記則可用來點擊回聽。若定位偏移太多,編輯每次都得往前或往後找,所以官方這項改善雖然不像模型參數醒目,卻直接影響人工修稿成本。
這些品質差異也影響高速轉寫的數字能不能用在自己的工作。
如何選出適合錄音流程的模型?
有明確支援語言的團隊適合用自己的短錄音比較品質,再評估批次速度與後處理成本。因為錄音語言不合,其他漂亮數字就難以轉成可用成果。
Granite 官方對 Turbo CTC 報告約 19,870 倍即時處理量,這是大量音訊批次處理的吞吐指標。它把處理音訊長度和計算時間相比,並不代表使用者說完後幾乎沒有等待。
Turbo CTC 採不需逐字回看前一個輸出的解碼方式,從聲音特徵直接對應文字。這是它適合大量轉寫的重要原因,也解釋為何它的功能取捨不同於接上語言模型的翻譯版本。
Granite 高速版此次還針對回音與遠距收音加強訓練。這和把錄音音量放大不同,因為反射聲音會改變時間結構,所以部署者最好保留真實會議室錄音,而不是只用乾淨朗讀測試。
批次工作可以同時處理多段錄音,藉此提高設備使用率。即時字幕則要在新聲音進來時持續產字,所以兩者雖然都關心速度,衡量方式並不相同。
因此,一間公司若有大量歷史錄音,可能更在意總共多久整理完,而現場會議字幕則更在意新詞多久出現,以及後續會不會改字。不能拿同一個吞吐數字回答全部問題。
新多語高速版的模型卡也註明,當時榜單正式條目仍是較早英語版本,新數字屬作者補充量測。引用時應保留版本差異,避免把新成績冒充已在同一榜單完成更新。
這次三個主推版本以 Apache 2.0 提供,但家族裡另有帶非商業條款的舊變體。下載時仍要核對完整名稱,不能因同屬 Granite 就把不同授權混成一種。
對要在本機處理錄音的組織,開放權重提供了部署選擇。不過,資料記錄、檔案保存與誰能回聽,仍由應用程式設計決定,並非模型授權自動解決。
本次更新值得測的理由,是品質、詞彙控制與人物定位各有具體改進。本文沒有獨立跑這些測試,因此不把官方數字改寫成已確認適用所有錄音的效果。
把錄音語言、轉寫任務與驗收資料先固定,開放權重才容易轉成可靠流程。建議先比較一段安靜錄音、一段遠距收音與一段多人插話,保留原音供人工核對。
如果主要需求是中文轉寫,應先比較明確支援對應語音的模型。
延伸閱讀:MAI-Transcribe-2 是什麼?Microsoft 語音轉文字模型,速度、價格、中文支援與限制解析
較小模型也常有自己的語言與速度範圍,不能只用檔案大小選擇。
延伸閱讀:Underdog Bark 3.0 是什麼?163 MB 語音辨識模型的準確度與第一名說法怎麼看
Granite Speech 常見問題
Granite Speech 5.0 支援中文聽寫嗎?
本次二十億模型列出的中文能力是英語翻譯成中文,沒有把中文放入語音聽寫輸入清單。主要處理中文錄音的人,應另外核對可用模型。
高速版能取代多人 Plus 版嗎?
兩者重點不同,高速轉寫不等於同時具備相同人物歸屬與時間定位功能。應依實際需要的輸出選擇。
兩千詞提示能保證專有名詞正確嗎?
不能。它提供辨識線索,仍須對照原音檢查,尤其錄音模糊或提示與內容無關時,更不能把名單當成事實。