IBM 聯手輝達與費米實驗室打造量子-古典協同平台,同步攜手 AMD 開源 Pelagos 解碼器框架
IBM 在 SC26 同步宣布與輝達、費米實驗室共建物模組化量子-古典平台,並攜手 AMD 開源 GPU 加速量子糾錯解碼框架 Pelagos,跨晶片 8 卡吞吐量提升 7.01 倍。

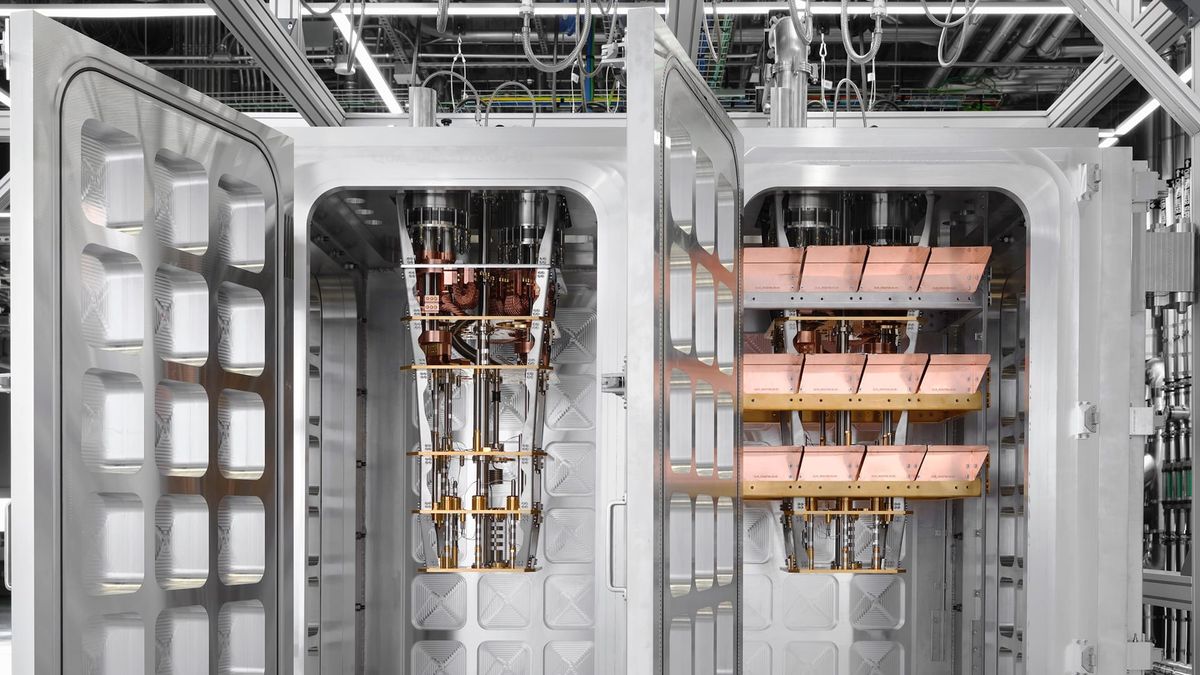
很多人以為量子電腦會像電影情節一樣單獨取代傳統超級電腦,但 SC26 大會揭露的真實路線完全相反:IBM 正把量子計算全面塞進 GPU 超算機房。
2026 年 11 月在芝加哥 SC26 超級運算大會上,IBM 同步祭出兩項跨陣營合作。第一項是聯手輝達與美國能源部費米實驗室,共建模組化量子-古典協同平台。
第二項則是攜手 AMD 正式開源名為 Pelagos 的 GPU 加速量子糾錯解碼器框架,實測跨晶片 8 卡配置可將解碼吞吐量大幅推升 7.01 倍。
量子計算一直卡在「雜訊太高、解碼太慢」的物理瓶頸,單靠量子晶片自己根本無法即時修正運算錯誤,必須依賴身旁的古典高速 GPU 幫忙即時算錯題、調度資源。
IBM 這次一手綁定輝達與國家實驗室解決系統共置與排程,另一手拉攏 AMD 用 Triton 開源生態打破單一晶片綁定,等於替實用級容錯量子電腦鋪平了軟體與算力底座。
接下來我們會拆解 IBM 與輝達、費米實驗室的協同平台架構、Pelagos 解碼器框架如何用 Triton 衝出 7.01 倍效能、Slurm 排程整合的意義,以及這對量子計算商業化時程的影響。
IBM 為何同時結盟輝達與 AMD 推進量子-古典協同
在外界看來,同時與互為競爭對手的輝達跟 AMD 宣布重磅合作似乎有些矛盾,但放在量子計算的工程現實裡,這步棋其實極為精準。
當代量子系統的發展早已過了「只比誰的量子位元數量多」的階段。現在真正決定一台量子電腦能不能跑出有用結果的,是量子處理器與傳統超級電腦之間能不能做到微秒等級的低延遲協同運算。
單靠量子晶片無法獨立運作的工程現實
量子位元極度脆弱,環境裡的一點電磁干擾或熱雜訊就會讓量子態崩潰。要讓量子電腦執行複雜運算,系統必須在極短時間內不斷讀取輔助位元的狀態,並即時算出對應的修正指令送回量子晶片。
這套名為「量子糾錯解碼」的工作本身是純粹的古典計算問題,需要極強大的平行算力。如果解碼速度追不上量子位元出錯的速度,錯誤就會像雪球一樣越滾越大,導致整場運算徹底作廢。
分進合擊的生態系戰略布局
因此,IBM 選擇將兩件事拆開處理。在硬體共置與國家實驗室研究上,IBM 借重輝達在國家級超算的既有佈局與 DGX 系統,與費米實驗室聯手驗證實體機房整合。
而在量子糾錯解碼軟體層,IBM 與 AMD 選擇擁抱開源,推出跨晶片通吃的 Pelagos 框架。這種設計確保未來各大超算中心無論機房裡裝的是 AMD 還是輝達的加速器,都能直接運行同一套量子糾錯工具,不被單一硬體供應商鎖死。
延伸閱讀:Google Willow 魔法態培育登上 Science:錯誤降約 40 倍,離實用量子電腦多遠?
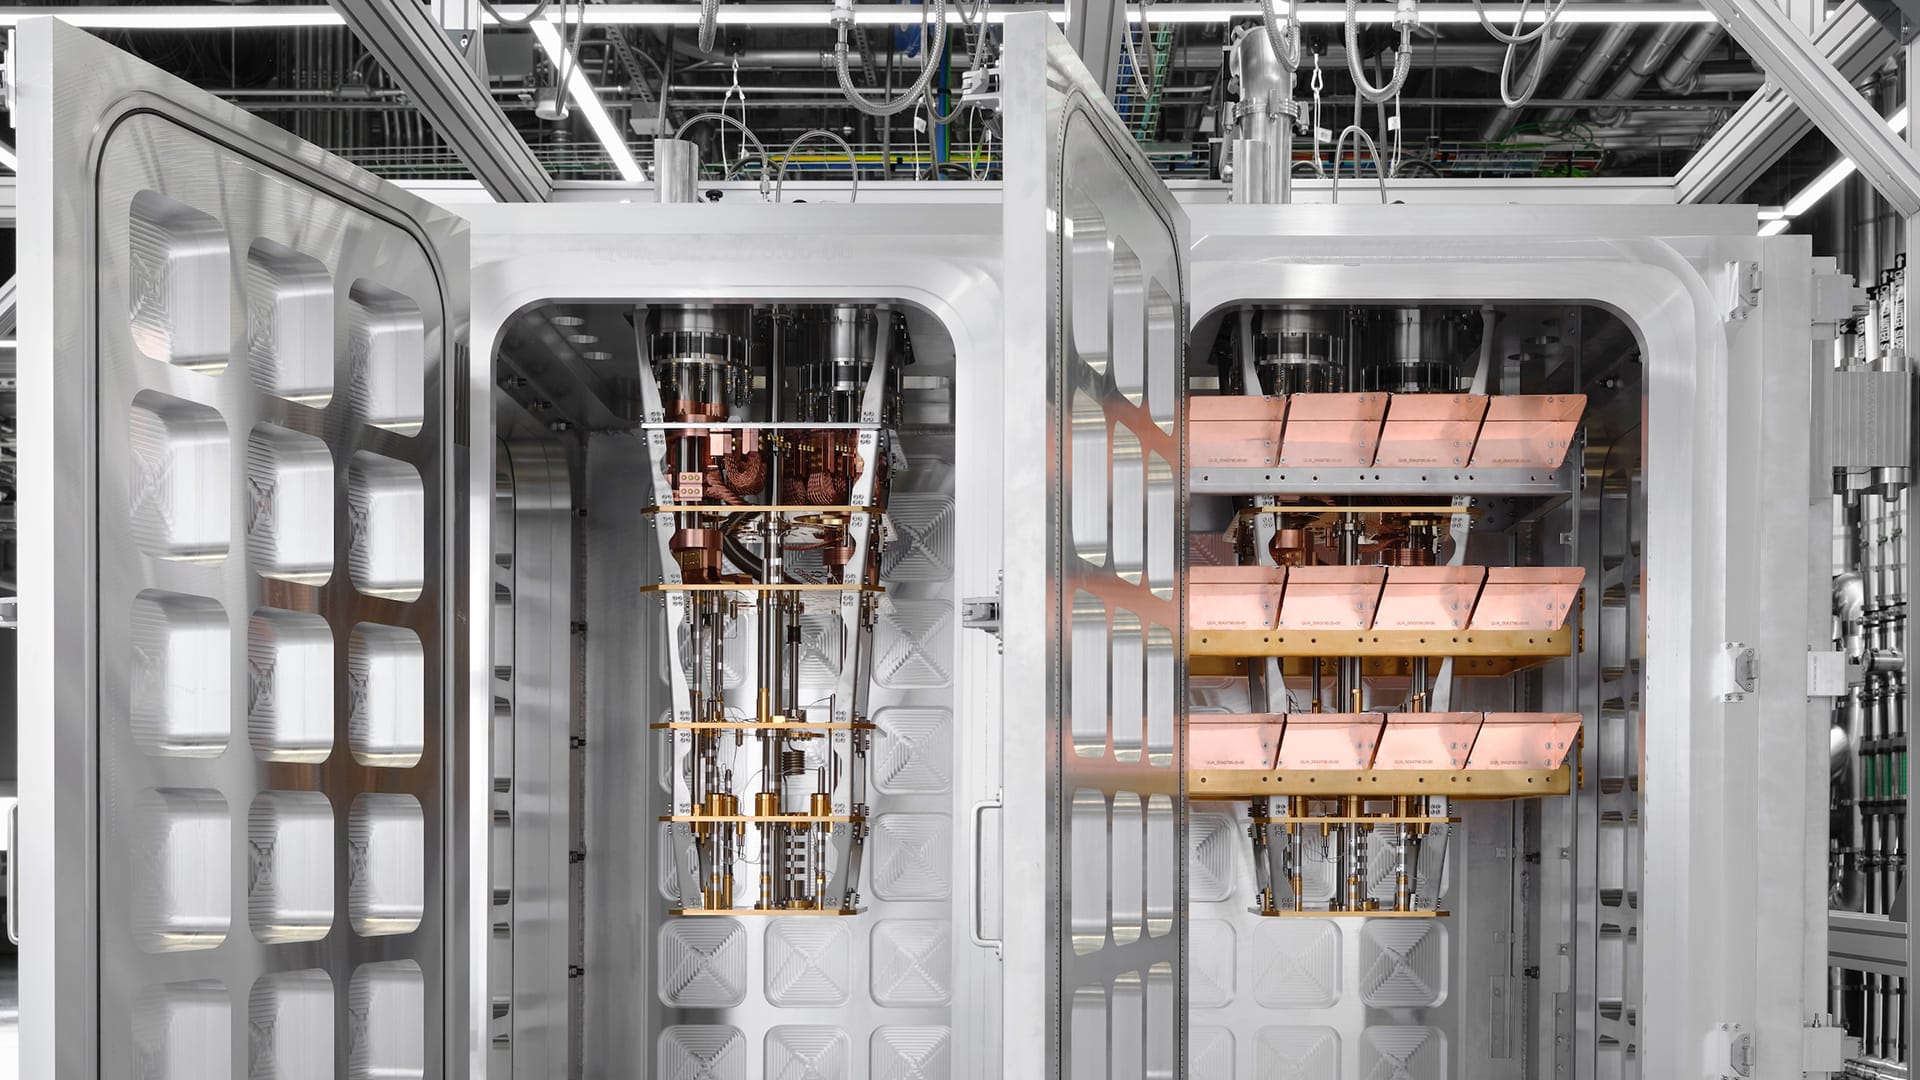
IBM、輝達與費米實驗室共建的量子-古典平台架構
這項三方合作的核心基地位於美國能源部旗下的費米國家加速器實驗室。三方計畫建置一座模組化的量子-古典協同設計平台,直接把前沿量子硬體搬進高效能 GPU 運算環境旁邊。
在硬體配置上,該平台將實體共置輝達的 DGX B200 加速運算系統與 IBM 的 Nighthawk 量子處理器。實體共置代表兩套截然不同的運算架構共享極短距離的高速光纖或專用互連通道,把訊號來回的物理延遲壓到最低。
瞄準高能物理與核子物理的複雜模擬
費米實驗室之所以親自下場主導這個平台,是因為高能物理與核子物理研究正面臨傳統超算的極限。模擬粒子碰撞、強交互作用或複雜量子多體系統時,所需的計算資源會隨著粒子數量呈現指數級暴增。
透過這套模組化協同平台,物理學家可以把最適合量子處理器計算的核心量子演化步驟交給 Nighthawk,再把龐大的數據統計、前處理與誤差緩解交給旁邊的 DGX B200 叢集,兩者像接力賽一樣交替推進運算。
為什麼強調「模組化」設計
過去許多實驗性量子系統都是高度客製化的孤島,只要換一代晶片,整套冷卻與控制介面就得打掉重練。IBM 與合作夥伴這次特別強調模組化架構,目的就是把量子處理器、低溫控制電子元件與古典算力節點標準化。
當每個元件都能透過標準介面抽換升級時,國家實驗室就能在不重建整座機房的前提下,平滑接軌未來更高位元數的新一代量子處理器。
| 合作項目 | IBM × 輝達 × 費米實驗室協同平台 | IBM × AMD Pelagos 開源解碼框架 |
|---|---|---|
| 核心任務 | 硬體共置與模組化量子-古典系統協同設計 | GPU 加速量子糾錯解碼器評估與高吞吐執行 |
| 關鍵軟硬體 | IBM Nighthawk 量子處理器與輝達 DGX B200 | 基於 Triton 編譯框架,支援 AMD 與輝達 GPU |
| 實測突破亮點 | 降低實體互連延遲,鎖定高能與核子物理 | 跨晶片 8 卡配置下,解碼吞吐量提升 7.01 倍 |
| 產業與研發影響 | 推動超算中心建立標準化量子-古典機房架構 | 降低研發門檻,加速容錯量子演算法迭代 |
Pelagos 開源解碼器框架如何實現 7.01 倍吞吐量
在所有公布數據中,最讓工程師眼睛一亮的是 Pelagos 的效能表現。IBM 與 AMD 聯手開發的這套開源框架,專門用來幫助研究人員在真實規模下評估並執行量子糾錯解碼器。
量子電腦要達到容錯門檻,每秒產生的錯誤校驗數據量非常龐大。研究人員在設計新世代解碼演算法時,往往需要針對數十億個模擬出來的錯誤樣態進行壓力測試,傳統單純靠 CPU 模擬往往一跑就是好幾天。
基於 Triton 實現跨晶片 GPU 加速
Pelagos 最聰明的技術選型,是建構在開源的 Triton GPU 程式設計框架之上。過去寫高效能底層核心程式通常要綁定特定廠商的專有語言,但透過 Triton,Pelagos 可以用一套統一的程式碼同時編譯並最佳化於 AMD Instinct 加速器與輝達 GPU 上運行。
根據官方在 SC26 釋出的基準測試結果,Pelagos 在 8 卡 GPU 配置下,能將量子糾錯解碼的整體吞吐量推升高達 7.01 倍。這代表原本需要一週才能測完的十億級錯誤樣態模擬,現在不到一天就能拿到統計結果,大幅加快容錯量子電腦的研發週期。
讓研究人員專注在演算法而非底層除錯
對量子演算法科學家來說,寫出高效率的並行 GPU 排程並不是他們的強項。Pelagos 把平行記憶體管理、錯誤樣態批處理與多卡通訊全部封裝在開源架構裡。
研究團隊只要把設計好的解碼邏輯放進框架,就能立刻在不同品牌的 GPU 叢集上驗證準確率與延遲表現,這對整個開源量子社群而言是一次重大的基礎設施升級。
延伸閱讀:Claude Mythos 5 設計量子電路:更少閘與量子位元,研究成果怎麼看?
Slurm 排程與 QRMI 如何讓超算中心無縫納管量子算力
就算硬體接上了線、軟體也跑得夠快,如果傳統超算中心的主管不知道怎麼把量子工作排進既有系統,這台機器依然很難發揮價值。這正是這次 SC26 另一項低調卻極為關鍵的軟體更新:Slurm 整合。
Slurm 是全球超級電腦中心最普及的開源工作負載管理系統,負責決定成千上萬名研究人員的計算任務誰先跑、分配幾顆 CPU 與幾張 GPU。
把量子處理器變成標準排程資源
透過 IBM 開發的量子資源管理介面 QRMI 與最新的 Slurm 套件整合,超算管理員現在可以把量子處理器直接定義成排程系統裡的一種標準硬體資源。
當一名化學家或物理學家提交混合運算腳本時,Slurm 會自動協調何時分配古典 CPU 與 GPU 節點、何時把子任務送往量子處理器執行,並在運算結束後自動釋放資源。
從實驗室預約制走向自動化工作流
過去使用量子電腦經常需要手動預約時段,並用獨立的雲端介面提交電路,跟傳統高效能運算叢集完全脫節。納入 Slurm 排程之後,量子計算正式成為超級電腦自動化工作流的一環。
這種工作流程的統一,對於未來企業與國家實驗室真正把量子算力納入日常研發管線,具有決定性的推動作用。
跨晶片量子軟體生態系對產業競爭的深層意義
把 SC26 這兩項公告放在一起看,可以發現量子計算的競爭焦點已經明顯轉移。過去幾年各家巨頭比拚的是誰先宣稱做出百位元或千位元晶片,但硬體數量提升後,軟體排程與即時糾錯反而成了更難跨越的鴻溝。
打破單一 GPU 生態系鎖定的戰略保險
在古典高效能運算領域,許多科學軟體長年高度依賴特定廠商的專有函式庫,導致超算中心在採購新硬體時缺乏議價空間。IBM 這次與 AMD 聯手將 Pelagos 建構在開源的 Triton 之上,等於替量子糾錯領域立下一個跨晶片相容的基準線。
對正準備建置量子-古典混合機房的國家實驗室與雲端業者來說,這代表未來無論採購 AMD Instinct 加速器還是輝達 GPU,都能直接沿用同一套量子糾錯解碼管線,大幅降低長期被單一供應商鎖定的架構風險。
從單純科研走向材料與製藥商業驗證的關鍵一步
高能物理與核子物理雖然是費米實驗室的首要目標,但這套模組化協同架構與高速解碼框架驗證成熟後,最快受惠的商業領域將會是新材料設計、電池電解質模擬與複雜分子催化反應。
這些工業級應用同樣需要反覆在量子態模擬與古典數值最佳化之間來回切換。當實體延遲被壓低、糾錯解碼吞吐量暴增七倍以上,量子計算才真正有機會跨過實驗室展示階段,開始解決傳統超算算不動的真實產業難題。
對台灣半導體與高速運算生態系來說,這波量子-古典融合趨勢也揭示了一個明確方向:量子電腦的興起並不會減少市場對先進 GPU、高速光纖互連與低溫控制晶片的需求,反而會讓高效能古典算力成為每一座量子運算中心不可或缺的標準配備。
常見問題
Pelagos 是什麼?只有用 IBM 量子電腦的人才能用嗎?
Pelagos 是 IBM 與 AMD 在 SC26 共同開源的 GPU 加速量子糾錯解碼框架,建構在 Triton 之上。任何研究量子糾錯演算法的團隊都能免費使用它,並且可以在 AMD Instinct 或輝達 GPU 上測試數十億個模擬錯誤樣態,不限於單一商業硬體。
為什麼 IBM 一邊跟輝達合作,一邊又跟 AMD 開發 Pelagos?
這反映出超算中心的多元硬體現況。IBM 與輝達、費米實驗室的合作側重於特定國家級實驗室的系統共置與協同研究;而與 AMD 聯手打造基於 Triton 的 Pelagos,則是為了確保量子糾錯軟體能跨晶片運行,讓整個量子生態系不受限於單一 GPU 品牌。
量子-古典協同平台跟一般雲端呼叫量子 API 有什麼差別?
一般雲端呼叫必須透過網際網路把任務排隊送到遠端,延遲高達數十毫秒甚至數秒,無法支援即時的量子糾錯與高頻互動計算。實體共置的協同平台把量子處理器與 DGX B200 放在同一機房並透過高速通道互連,能實現微秒級的緊密互動。
8 卡吞吐量提升 7.01 倍代表實用量子電腦馬上要來了嗎?
7.01 倍提升的是在多張 GPU 上模擬與執行量子糾錯解碼器的運算速度,這能顯著加速研究人員開發低延遲解碼演算法,但距離大規模商用容錯量子電腦仍需克服量子位元數量與實體雜訊控制等硬體挑戰。
結語
IBM 在 SC26 端出的量子-古典協同平台與 Pelagos 開源解碼框架,清楚畫出了未來五年的量子計算落地路徑:量子處理器不會取代 GPU 超算,而是作為超算機房裡的一種新型加速器與古典晶片並肩作戰。
這份整理適合關注量子運算工程化進度、超算異質整合架構以及開源 GPU 工具鏈的研發人員與科技投資人;不適合期待明年就能在個人電腦或一般企業資料庫全面換裝量子算力的讀者。因為現階段的主戰場仍在國家實驗室與高能物理等前沿領域,但基礎排程介面與跨晶片解碼框架的成熟,正把這條時間線穩步往前推進。
如果你想持續追蹤量子計算、高階 GPU 超算與開源硬體框架的實質進度,歡迎免費訂閱 AI 郵報,每週幫你過濾雜訊、直擊真正的技術里程碑。