Kev 1.0 開放四種決策模型:讀完文件,直接替選項給機率
Jared Palmer 發布 Kev 1.0,提供 0.8B 到 27B 的開放決策模型。本文解釋選項機率、TypeSafe 相容介面、自行部署,以及為什麼信心數字仍需用自己的資料驗證。
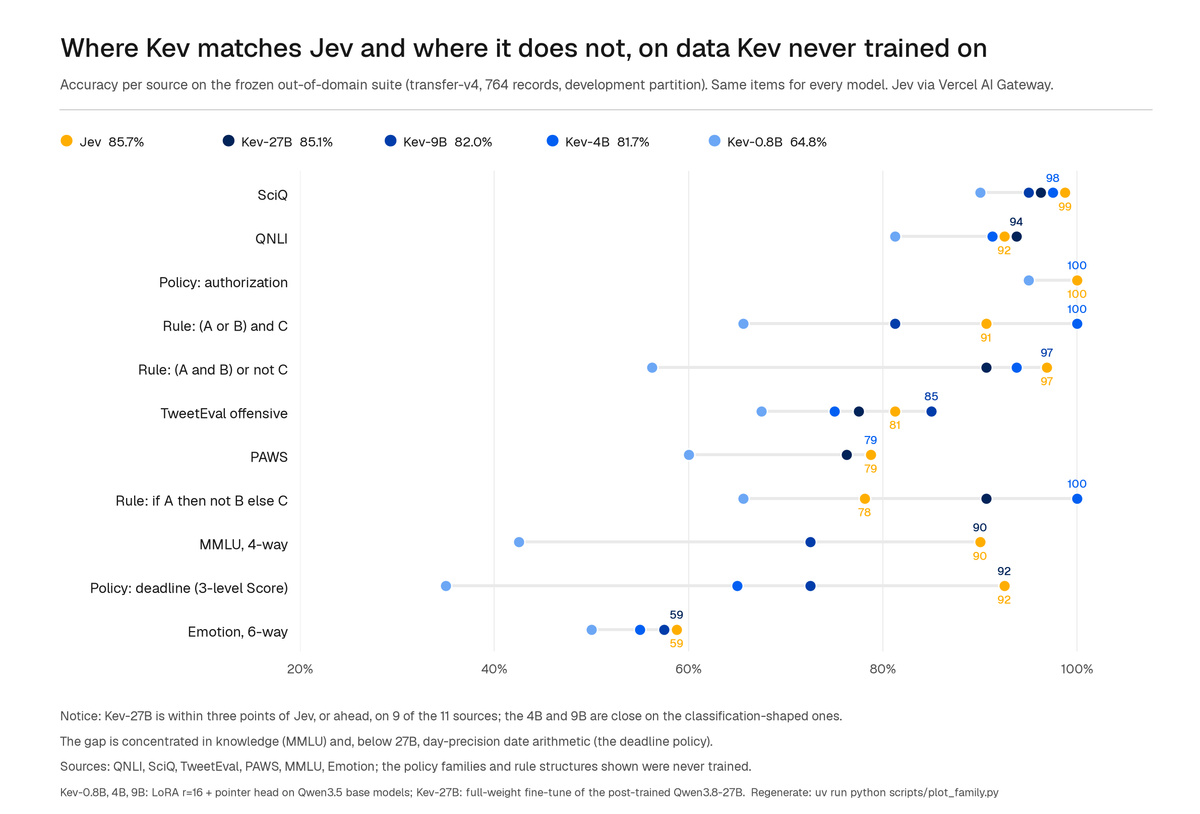
Jared Palmer 在 2026 年 10 月 1 日發布 Kev 1.0,將四種不同規模的開放決策模型整理為正式版本。它接收文件、問題和選項,再回傳各選項的機率,讓程式決定後續流程。
Kev 由 Jared Palmer 的個人專案提供,原始碼與模型放在他的 GitHub 和 Hugging Face 帳號。這次發布是 0.8B、4B、9B 與 27B 家族的版本整理,包含近期模型更新,不代表四款模型都在當天重新訓練。
選項由你定義,模型負責評估
作者介紹說明,Kev 可以回答是非題、選擇題與有順序的評分等級。B 是十億,這裡描述模型參數規模。參數是模型學到的數值。
例如,一則客服訊息需要分到帳務、技術或業務部門,程式先定義三個選項,Kev 再給出各選項的機率。這是用途示例,本文沒有實際執行客服分流。
它不會生成一段解釋,也不會自己查回遺漏的事實。因此,輸入必須包含判斷所需的證據,選項也要能涵蓋可能情況。若所有選項都不合適,程式仍需要處理。
同一份文件,可以接多個問題
Kev 的設計讓文件先被處理一次,再讓多個問題使用同一份計算結果。每個問題各自對文件判斷,不直接讀取其他問題。
對同一張客服單,你可能同時想知道部門、是否急迫與情緒程度。如果每次都重新處理整份文件,就會重複運算;共用文件計算是它想改善的一部分。
這種方式適合有明確題型的流程。自由撰寫客服回覆仍需要另一個生成工具,不能把決策模型當成完整客服助理。
開放與相容介面,提供自行部署選項
作者提供 Apache-2.0 模型權重,也就是可下載部署的核心參數,並公開程式與模型卡。Kev 使用與 TypeSafe System One 相容的 API,API 是程式之間溝通的介面。
對已經使用 TypeSafe SDK 的應用程式,作者描述可藉調整服務地址與模型名稱接入 Kev。不過,相容介面不等於輸出品質完全相同,仍應比較自己的資料與錯誤處理。
官方程式也支援 GPU 與 Apple Silicon 的運行方式。不同規模的記憶體需求差距很大,作者未實測所有 Mac 配置,所以不能說整個家族都已在一般筆電驗證。
信心數字需要和實際正確率對照
校準指模型給出的信心,是否接近這類答案的實際正確比例。如果一批答案都說約 85% 有把握,就可以檢查它們實際是否約有 85% 正確。
作者公布自家測試裡的校準結果,也提醒新資料不一定有相同表現。把機率設成自動化門檻之前,需要用有正確標籤的代表資料試驗,再用另一批資料檢查。
我會為較低信心的結果保留人工處理或其他模型的接手機制。這樣才可以把機率當成流程訊號,而不是單筆答案正確的保證。
新版不一定在每種情境都更好
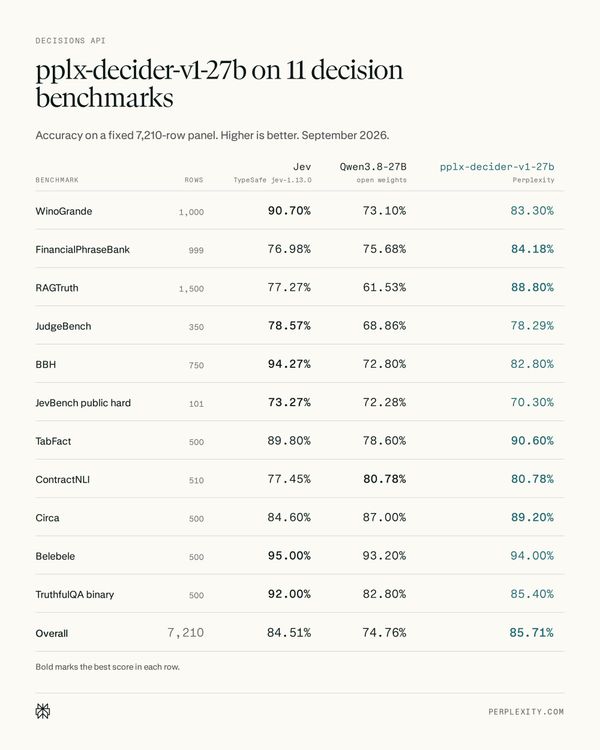
作者明確說,最新 Kev-27B 在長法律文件的測試中,比先前版本更不準確且更有自信。舊版仍保留,供使用者在自己的資料上比較。
另外,評測來自作者自己的框架,沒有宣稱獨立排行榜認證;模型選擇也不是完全盲測,基礎模型是否曾接觸評測資料並不完全清楚。
這些說明讓發布消息更容易評估。我認為「四種模型可選」的實際價值,是能針對工作比較品質與資源需求,不是默認參數最大或版本最新就適合所有任務。
常見問題
Kev 會解釋為什麼選某個答案嗎?
它主要回傳選項機率,不生成理由。需要解釋時,應另設流程,且不能把生成的理由當成 Kev 實際推理的紀錄。
開放模型代表沒有運行成本嗎?
仍需自己的運算設備或由供應商代為運行的服務。取得權重的授權,和硬體、部署與維護費用不同。
官方測試的機率可以直接當公司門檻嗎?
作者提醒要在自己的代表資料上校準與驗證,不能直接沿用別人測試的錯誤率。
結語:讓可量測的選擇進入流程
Kev 1.0 提供了一條自行部署決策模型的路徑。對分類、分流與固定評分問題,它把輸出整理成程式可以直接使用的機率。
我會先選一項有明確標籤的任務,觀察錯誤和信心,再決定哪些結果可以自動處理。開放原始碼讓比較與調整更容易,實際品質仍需要資料來回答。