NVIDIA Long-Transduction 研究:AI 讀得下長資料,不代表能一路做對
NVIDIA 研究以算術、排序與表格轉換測試長任務可靠性。本文解釋 Long-Transduction 的輸入加輸出長度、格式與難度影響,以及為什麼長上下文規格不等於完成品質。
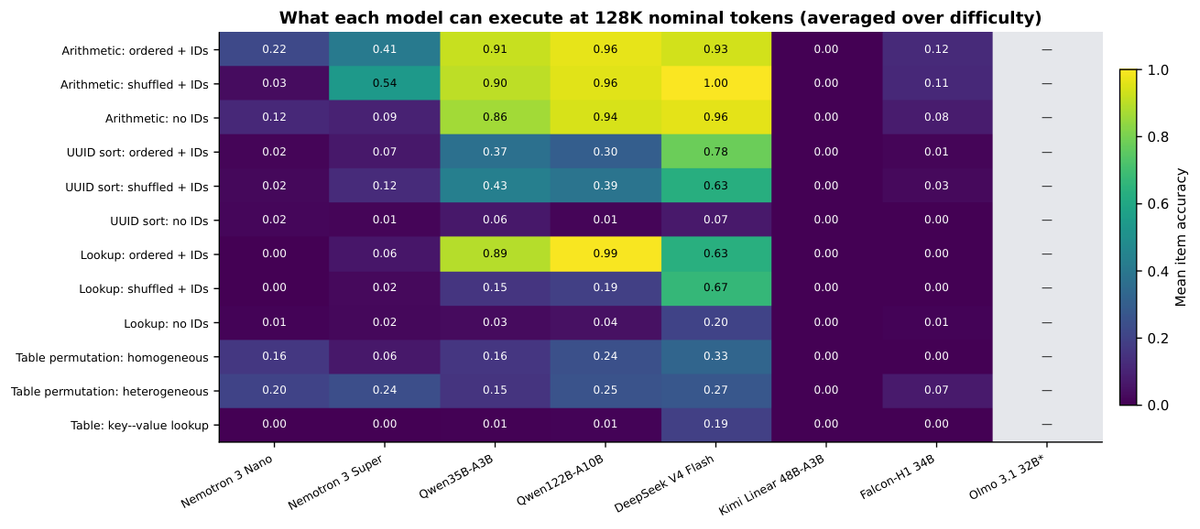
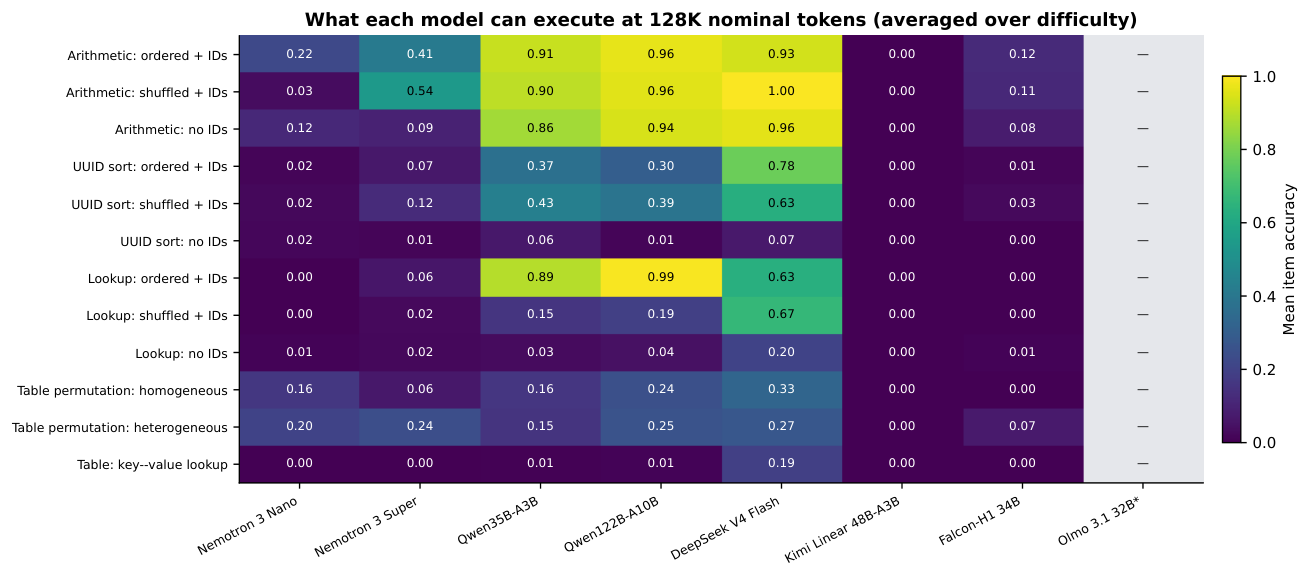
一個 AI 模型能接收很長的文件,是否就能把每一筆資料都正確處理?NVIDIA 研究者在 Long-Transduction 中,把長流程拆成可逐筆驗收的小任務,觀察模型是否持續使用正確資料、完成操作並保持輸出對齊。
論文在 2026 年 9 月 30 日提交,近期在 X 的 AI 研究討論中被分享。它關注的問題很實際:當 AI 要逐筆整理大量資料時,漏掉一筆或找錯位置,可能讓後面的結果也出問題。
「讀得下」和「做得完」是兩種能力
上下文是模型處理當前工作時能參考的內容,包括輸入和已經產生的文字。長上下文規格說明容量,卻不會直接保證整個任務正確。
原論文用重複、需要依賴輸入資料的操作做測試,包括算術、排序、查找變數與表格轉換。每一筆都能和預期答案比較,研究者因此可以看錯誤從哪裡開始。
例如,模型把某一行漏掉,後面每行就可能錯位。這是解釋長資料操作的例子,不代表任何真實企業已經發生這一筆事件。
長度、格式與局部難度分別測
Long-Transduction 會改變三種條件:整體任務長度、輸入資料格式,以及每個小操作的難度。這樣可以分辨哪些錯誤和長度有關,哪些和表示方式有關。
格式測試包含保留或移除資料的編號。沒有編號時,一筆遺漏可能讓後面的對應關係一起偏掉。即使每個算術操作本身不難,持續找到正確的那筆資料仍然是挑戰。
我認為這種逐筆驗收很有價值。只看最後總結是否像答案,可能無法發現中途已經遺漏資料;檢查每個需要的輸出,才能知道結果是否完整。
128K 指輸入與所需輸出的合計
論文的 4K 到 128K 是名義上的輸入加輸出長度,不能寫成輸入文件就有 128K token。Token 是模型處理文字的小單位,不等於固定數量的中文字。
在最大測試階段,資料平均約有 65,374 個輸入 token,預期輸出約 61,240 個。測試輸出隨輸入一起變長,所以它觀察的是長時間持續轉換資料的能力。
論文測試八個開放模型,其中七個涵蓋完整設定,Olmo 因上下文限制停在較短階段。這些條件需要保留,才能看懂不同模型分數的比較範圍。
62.8% 是相對下降,不是百分點
研究報告,將名義長度從 4K 擴大到 128K 時,整體表現平均相對下降約 62.8%。相對下降描述原本表現減少的比例,不能改寫成準確率減少 62.8 個百分點。
其中一個例子是 DeepSeek 的整體逐筆準確率,從約 0.909 降到 0.554。這說明指定診斷裡的長度影響,不表示模型在所有工作都會以同樣比例下降。
格式與局部難度也影響結果。因此,部署流程不能只看模型標示的容量,還要評估自己資料的編號、對應方式與任務複雜度。
這是診斷,不是完整企業代理排行榜
論文明確說明,這套合成測試不涵蓋規劃、工具選擇、多輪互動、恢復流程、權限或人工接手。它也不是完整的真實企業工作環境。
研究的價值,是把持續執行中的基本問題測出来。不能據此宣稱某個模型在所有企業任務失敗,也不能把測試順位當成完整產品比較。
我會把它轉成實務上的驗收問題:是否每筆都有輸出、是否對得上來源,以及中斷後如何核對進度。把大批工作分段處理並逐筆查驗,是可以考慮的工程方式,本文沒有實測一套保證有效的解法。
常見問題
長上下文模型不值得用了嗎?
長容量仍能處理更多內容。研究提醒的是,容量和持續正確操作需要分開驗證。
128K 測試代表輸入就有 128K 嗎?
不是。論文使用輸入加預期輸出的名義長度,最大階段的輸入平均約 65K token。
可以直接當成真實企業成功率嗎?
不能。這是控制條件下的合成診斷,沒有涵蓋完整代理系統的所有功能。
結語:用完成證據衡量長任務
Long-Transduction 把 AI 長任務的問題從「能放多少內容」推進到「每筆是否正確執行」。這對大量資料轉換與長時间代理工作,都提供了有用的觀察角度。
我會把來源對應、遺漏檢查與逐筆驗收放進流程。模型規格說明容量,完整且正確的結果才說明工作真的完成。