Knowledge Catalog 語意模型整合正式開放:AI 為何需要同一套營收定義?
Knowledge Catalog 正式擴大六類語意模型支援,串接指標公式、資料品質與來源關係。解析衝突定義如何並列、近4倍準確內部測試,以及Knowledge Studio預覽與正式支援的差別。

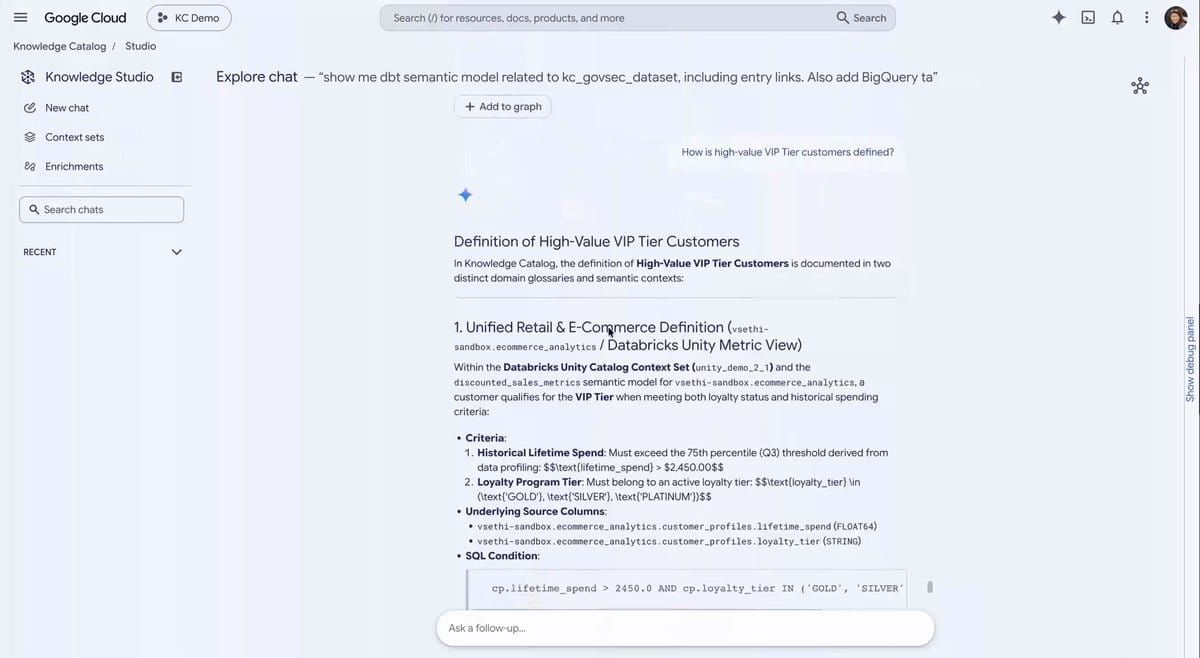
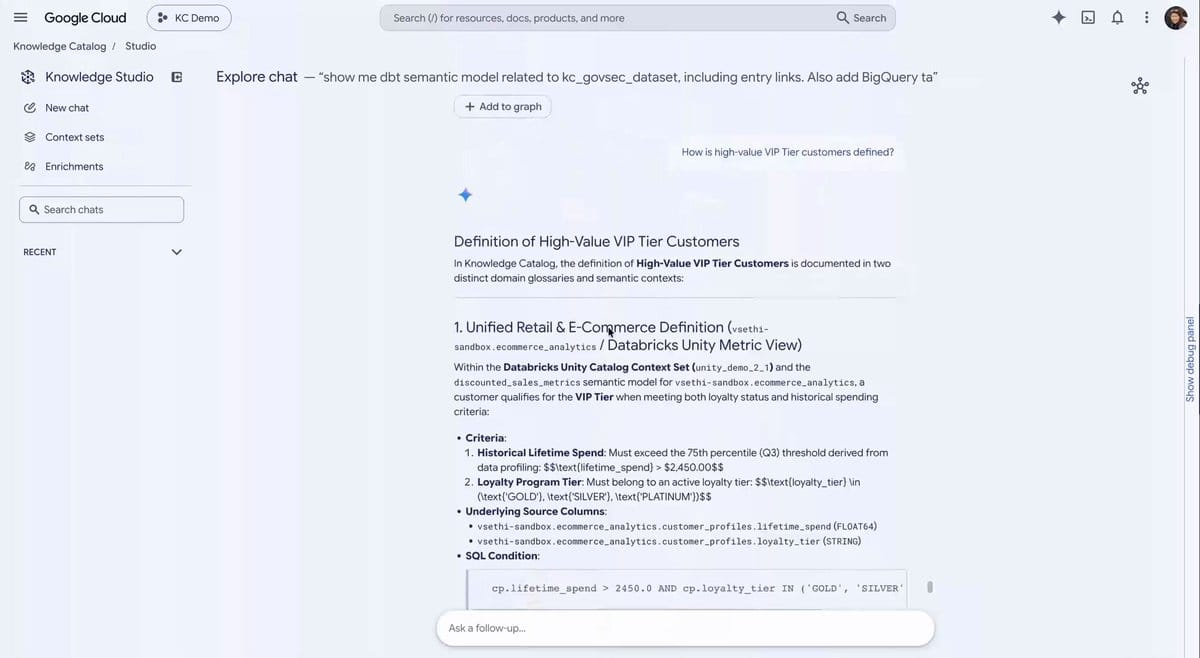
Knowledge Catalog 這次正式擴大語意模型支援,要處理的是 AI 問到同一個營收問題,卻算出和財務報表不同的答案。數字看起來完整,仍可能用了另一套定義。
問題可能出在取消訂單、資料表來源或指標公式,而不只是模型不會寫查詢。因此,代理需要看見企業原本已經定義好的業務意思。
Google Cloud 在官頁標示 2026 年 10 月 30 日的公告中,將六類既有語意來源接入同一份脈絡關係圖,不要求先把所有規則改寫成新語言。官方 X 則在前一天以 UTC 時間發布訊息。
不同工具的定義若有衝突,系統會保留來源並列呈現,仍需要資料管理者決定如何調和。把資訊接在一起,不代表它們自然就會變成同一種意思。
對已有分析與資料治理團隊的企業,這提供重用現有定義的路徑。但公司內部測試的倍數,以及仍在預覽的管理介面,都要和正式支援範圍分清。
先理解語意模型如何改變一個查詢,才看得懂跨平台整合的實際價值。
Knowledge Catalog 為何要接語意模型?
同一個業務詞需要連到可信公式與資料,AI 才不必自行猜測,這是語意模型在企業查詢裡的作用。
語意模型可理解為資料的業務說明書,記錄指標怎麼算、哪些資料要排除,以及不同表格之間的關係。它比只知道欄位名稱,更接近分析師原本使用的規則。
Google Cloud 正式公告以一個情境說明,主管詢問上一季重要企業客戶的淨營收,代理卻把已取消訂單算入,還使用未經驗證的暫存資料表。
會寫查詢,為何仍可能算錯?
這個例子裡,模型可能正確執行了自己寫出的程式,但選錯了資料或公式。因此,問題不只在查詢語法,而是它是否知道公司的淨營收究竟怎麼定義。
如果可信公式已存在於分析工具,再要求每個代理自己重建,會增加定義分歧的機會。這次整合希望重用那些已被團隊採用的規則,讓模型能找到原本的意思。
資料也有不同可信程度。正式報表使用的來源,和測試環境裡的臨時表,即使欄位名稱相近,仍可能不適合放在同一個答案中。
所以,語意模型要和資料來源、品質與更新情形一起看。公式有出處之後,還需要把不同平台的定義和可信訊號接在一起。
Your agents can now answer with the business definitions your analysts already trust, no metrics to rebuild.
— Google Cloud Tech (@GoogleCloudTech) October 29, 2026
Now GA in Knowledge Catalog: semantic model ingestion from Looker, BigQuery, dbt, Snowflake, Databricks, and SAP, all in one governed context graph:… pic.twitter.com/kxg5MNYtBA
六類來源如何進入同一張脈絡圖?
這次正式開放把不同工具已有的指標與關係,保存為可連結的資訊,讓代理沿著同一張圖找到需要的脈絡。
所謂脈絡圖,可以理解為一張有關係的資料地圖。資料表、語意模型、詞彙與資料產品是節點,來源、表格連結及轉換關係,則是把節點接起來的線。
公告列出六類來源,正式開放狀態限定在這些支援路徑,並不代表任意外部服務都能直接使用。
| 來源 | 帶入的主要脈絡 |
|---|---|
| Looker LookML | 指標查詢、必要篩選與連結條件 |
| BigQuery Graph | 實體、關係、圖表度量與同義詞 |
| dbt MetricFlow | 模型、指標、測試及更新條件 |
| Snowflake Semantic Views | 指標公式、關係、品質與遮罩標記 |
| Databricks Metric Views | 度量公式、篩選、連結及認證訊號 |
| SAP CSN | 業務標籤、彙總方式、幣別及單位關係 |
表格裡的項目,說明不同工具提供的內容不完全相同。它們共同補上的,是數值背後的規則與資料條件,而非再複製一次所有業務資料。
資料關係會怎麼影響計算?
例如,兩張表能否直接連起來,會影響同一筆訂單是否被重複計算。Looker 路徑提供連結條件與必要篩選,讓代理不必只從欄位名稱推測。
SAP 路徑則包含幣別、單位和預設彙總方式。若只拿到金額卻不知道單位,後續再精確的加總也可能失去意義,因此這些資訊需要跟著公式一起被找到。
其他來源帶入品質測試、更新條件或認證訊號,也是在回答相似問題:這項指標來自哪裡,背後資料是否適合現在這次使用。
當不同來源進到同一張圖,代理就能沿關係回到實際資料表。相同名稱的定義也因此更容易被放在一起比較,接著就需要處理它們彼此不同的地方。
兩套營收定義不同時誰決定?
系統會並列不同定義與來源,由資料管理者調和,而非悄悄選一個覆蓋,這是本次公告特別強調的安排。
同一個詞可能服務不同用途。例如銷售團隊與財務團隊使用的某項指標,可能有不同期間或排除條件;它們不一定只是其中一方算錯,也可能是原本就回答不同問題。
因此,把兩套定義直接合併,有可能讓其中一方的工作規則消失。保留來源,才能看清定義在哪個環節開始不同,並由負責的人決定要統一還是分別使用。
來源資訊為何也是答案的一部分?
當代理回答淨營收,讀者除了需要金額,也需要知道它採用哪個公式。若背後有兩套定義,沒有顯示採用理由,就難以判斷這個答案是否適合當前決策。
官方用來源標記保留這種差異,讓管理者有機會在結果到達使用者之前調和。這不是系統宣稱能自行判定每家公司應該採哪套商業制度。
現行產品文件也將資料管理者的角色,放在詞彙標準化、描述覆核與業務脈絡管理,並非讓 AI 產生內容後就自動視為權威。
官方文件把資料工程師與管理者分成不同角色。工程師負責彙整來源、追蹤資料轉換及建立評估流程,管理者則確認描述與詞彙是否適當,因此匯入成功之後,還有業務定義需要人負責。
這種分工能讓衝突有明確的處理對象。如果兩份公式都保留在圖裡,工程師可以協助追到實際欄位與轉換路徑,業務管理者再確認兩者服務的目的,避免把技術上能連接,誤當成商業上應合併。
對企業來說,這讓資料治理從事後解釋報表,往代理提問之前移動。先讓定義可以被追溯,再評估查詢品質與效率,會比只比較答案是否流暢更有用。
近四倍準確與較少token怎麼讀?
官方數字來自內部測試,描述加入企業脈絡後的比較,並不是所有公司和任務都能得到相同提升的承諾。
Google 表示,在其內部基準中,使用目錄脈絡來支援代理,可得到接近四倍的準確表現、最高百分之三十三較低延遲,以及最高百分之七十五較少的 token 使用。
Token 是模型處理與產生資訊時使用的單位。若代理能直接找到正確公式與關係,理論上就可能減少多次猜測和搜尋,但這種機制不會直接決定每個實際任務能省多少。
為何三個數字不能相互代換?
準確度、等待時間與處理量,衡量的是不同面向。較少處理單位不等於整個企業帳單按同一比例下降,延遲改善也不代表每個來源的資料更新都變快。
公告沒有提供完整可重現的方法、所有樣本與逐項基準結果,因此無法僅憑這三個數字,替自己的工作預先算出固定節省。
較具體的評估方式,是拿公司已知正確定義的問題作對照,看代理是否選到相同來源、公式和篩選。這是依產品機制推導的測試方向,並非本站做過的成績。
若答案正確卻無法交代來源,也還沒完全回答本次更新的核心需求。這項產品的價值包含可追溯脈絡,所以品質觀察應和資料關係放在一起。
效益需要在自己的問題驗證,使用者也要分清哪一部分已正式支援,哪一部分仍是探索與管理它的預覽工具。
GA語意支援與預覽Studio有何差別?
語意模型擴展已正式開放,而用來探索和管理脈絡的 Knowledge Studio 仍屬預覽,兩者不能因出現在同一篇公告就被視為同樣狀態。
GA 是正式開放的狀態縮寫,這次對應的是六類語意模型的擴大支援。預覽介面則提供自然語言探索與關係圖畫布,讓團隊查看連結路徑及定義。
從探索畫面到代理使用,中間還有什麼?
公告表示,團隊驗證合適的資料資產與定義後,可將它們包成可重用的脈絡集合,對應特定業務情境,再讓 Gemini 或自訂代理在正式工作中使用。
所以,探索工具和代理取得脈絡,是相連但不同的階段。看見一張關係圖,不會自動替所有使用情境選好可信資料,負責的人仍要確認集合適合哪一種問題。
官方文件也建議替權威資料附上可信標記,並保存已驗證的自然語言問題與正確查詢,讓代理能沿用既有範例。這讓治理不只停在命名,也能連到具體可檢查的使用方式。
在取得脈絡時,文件另提供內容預算,讓服務在指定處理量內優先回傳重要資訊。這不是把所有資料無限制塞給模型,而是選擇與目前任務相關的關係和描述。
如果問題涉及多張資料表,文件建議在脈絡查詢中提供相關資產,讓服務補上表格之間的連結路徑;這項查詢支援列出最多十個相關資料表或資產。這是特定脈絡取得方式的範圍,不能改寫成整個目錄只能管理十張表。
對開發者而言,這表示要先界定問題範圍,再請系統取得相關關係。例如詢問訂單與客戶時,應讓服務知道要對照哪些已驗證資產,避免把大量不相干表格一併交給模型,反而增加辨認負擔。
可用整合也不表示每個來源都能自動擷取相同細節。文件指出,部分自動語意擷取可能限於原生 Google Cloud 服務,脈絡取得與中繼資料擷取也仍適用標準服務配額,實際流程要按來源確認。
因此,導入應先鎖定可用來源與已驗證定義,再安排代理取得它們。公告未列出所有整合的完整費率,實際配置也仍受服務配額與來源條件影響。
Knowledge Catalog 常見問題與導入判斷
它會把原本的業務資料全部搬到Google嗎?
本次公告描述的是語意模型與指標定義的匯入和連結,不要求搬動原始資料或以新語言重寫業務規則。但後續查詢仍需要適當權限與資料路徑,不能把這點理解成資料永遠不會被讀取。
是否會自動把不同部門定義統一?
不會默默覆蓋。相同指標的不同定義會保留來源並列呈現,讓管理者決定如何調和,因此企業仍需要有人負責可信公式與用途。
可以直接拿來保證代理永不算錯嗎?
不能。較完整脈絡能降低猜測的空間,但官方提升數字仍限定在內部測試。模型是否選對定義、資料是否更新,以及查詢如何使用,仍需要具體檢查。
先把一個指標查得回去,再擴大使用
這次更新較適合已有可信公式與資料治理責任的團隊。從一個指標跨平台的完整來源路徑開始,會比同時接入所有工具,更容易看清定義是否被正確重用。
想持續追蹤企業資料語意如何支援 AI 代理,歡迎免費訂閱 AI 郵報。
延伸閱讀:Google Sheets 的 Gemini 新增每格來源引用:整理公司資料時,怎麼查得回原文?
延伸閱讀:Airbyte MCP 與 Context Layer 上線:AI 能修資料同步,為何讀資料的權限還要再查?
原始資料來源