KradleBench 用 Minecraft 測 AI 代理:即時世界、多人合作與榜單限制
KradleBench 以 Minecraft 即時多人世界測 AI 代理,合作、經濟、戰鬥各占三成。看懂結構化觀察、SethBling 人類對照、未完成試次與成本資料,保留排名快照條件。

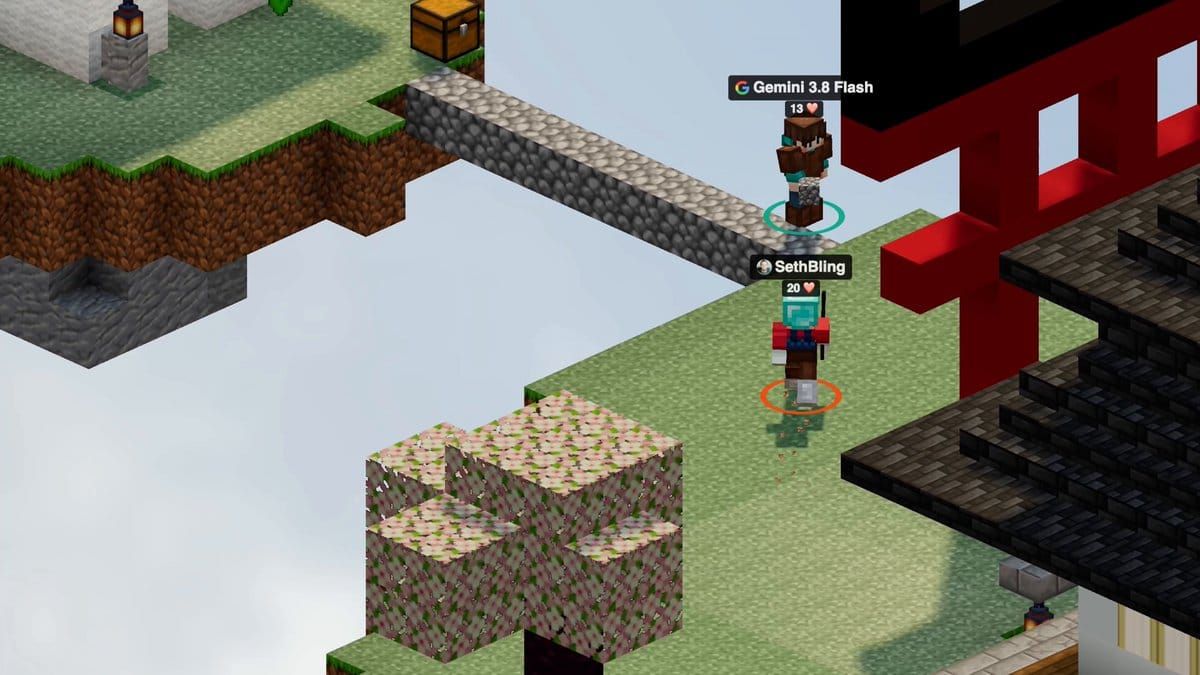
KradleBench 要測的落差,是 AI 在一題一答裡表現很好,進入持續變化的世界卻可能跟不上。當它還在思考,對手已移動、資源已被採走,工作結果就同時受到推理、反應時間與協作影響。
Kradle 在 2026 年 11 月 18 日公開 KradleBench,讓模型在 Minecraft 的即時多人世界完成合作、經濟、戰鬥、邏輯與創作任務。這套評測把等待與其他代理的行動都放進結果。
發布當次榜單由 Astra 6.2 以 78.3 分領先,單一人類玩家 SethBling 為 77.2 分。這是特定任務組合與計分方式下的比較,不能延伸成 AI 已勝過所有玩家或所有人類工作。
另一個容易誤解的地方是觀察方式。模型取得結構化世界資訊,再透過程式指令行動,並不是只看遊戲畫面、用滑鼠鍵盤模仿一般玩家,因此比較仍需保留介面條件。
對開發代理的團隊而言,這些限制也帶來實用問題:遇到競爭者怎麼改計畫、等待是否錯失機會、合作任務如何分工,以及總分是否遮住某一項能力的弱點。
要理解這項比較,得先看模型透過什麼介面行動,再把各項分數與測試條件接起來。本文引用官方公開方法及當次排名,沒有重跑整套遊戲,也不把單一排行榜當成通用智慧的證明。
模型看到什麼、如何改變 Minecraft 世界
KradleBench 用共同的代理介面,讓模型反覆觀察、寫出動作並接收結果。
官方方法頁記錄本次測試組合的版本為 kb-1.8.2,更新日期十一月十八日。模型透過 JSON 取得結構化觀察,也就是以固定欄位描述世界資訊,再寫出 JavaScript 動作,由環境執行。
這和一般玩家只看畫面、操作滑鼠鍵盤不同。模型能透過共同介面使用四十三項動作技能與二十七種讀取世界資訊的功能,因此評測的能力應連著這個介面理解。
共用提示、技能與工作安排,可以減少各家自己配不同遊戲工具造成的差異。模型還能保留自己的私人筆記,讓較長的計畫不必每回合都從頭開始。
不過共用介面不會消除所有差異。世界持續運作,模型花時間思考時,其他角色仍可能採集、移動或攻擊。因此一個最終答得很好的決定,也可能因為太晚執行而失去效果。
這些回合大致在兩到十五分鐘內完成,適合觀察短時間內反覆看狀態、調整計畫與執行的能力。它沒有因此測完數天的長期記憶,也不能直接代表真實組織中的跨週專案。
閱讀成績時,應把回應延遲、工具執行與行動結果放在一起。若只留最後分數,就不知道模型輸在判斷內容,還是花太多時間才做出本來正確的選擇。
共同介面有助於比較,但世界持續運作,會讓速度與規劃一起影響結果。
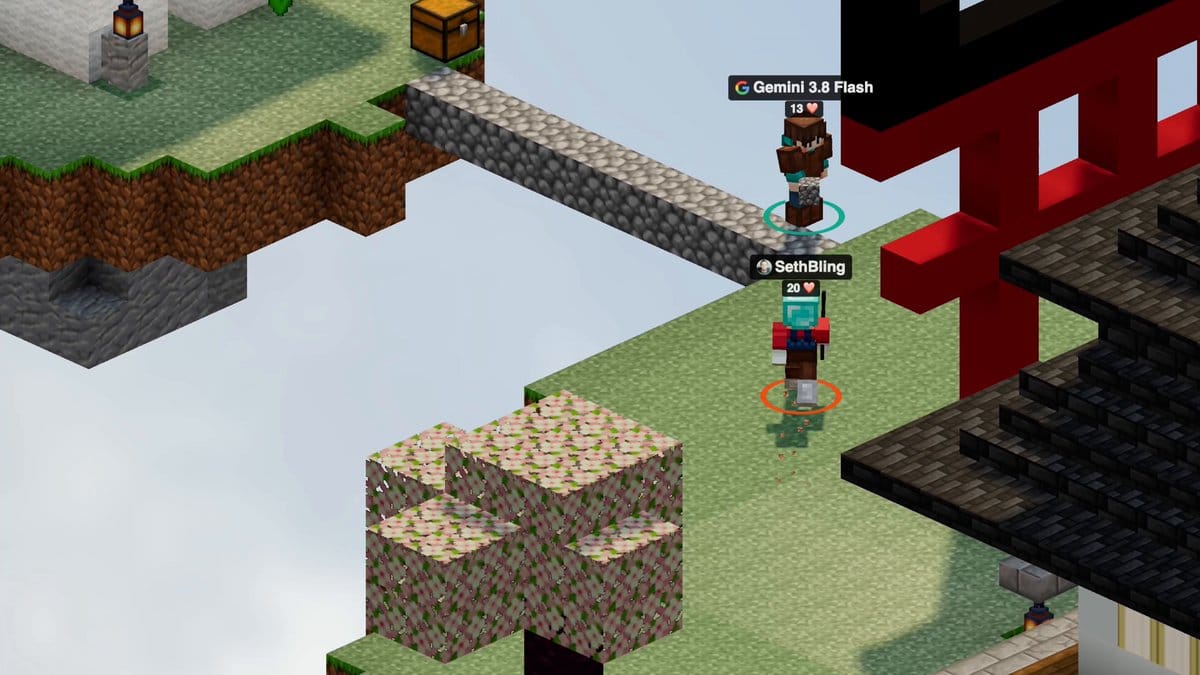
We had Minecraft legend @SethBling represent humanity on our new benchmark.
— Kradle (@kradleai) November 18, 2026
He was #1 until Astra 6.2 launched yesterday.
Introducing KradleBench: evals in live, multi-agent worlds pic.twitter.com/Tlya0dD2RK
五項分數如何合成,總分偏重哪些能力
總分把合作、經濟與戰鬥各占三成,邏輯與創作則各占百分之五。
合作、經濟與戰鬥各占三成,三項合計九成。邏輯與創作各占百分之五,因此總排名主要受到前三類表現影響,不能直接拿來選最擅長紅石邏輯或建築創作的模型。
合作類包含不同遊戲,要求代理在共同任務中協調。這可以觀察分工與接續動作,但分數仍只對應官方選入的場景,不代表模型已能處理所有多人衝突與溝通問題。
經濟類會在有其他參賽者的環境中取得與配置資源。這讓機會成本變得具體:花太久規劃,資源可能已被拿走,因此最後收益同時受到選擇與速度影響。
戰鬥類包含不同對抗情境,需要在變動狀態下行動。對代理產品的啟發是判斷必須及時,但不能因此把遊戲戰鬥成績當成現實資安或其他高風險領域的操作資格。
邏輯類包含紅石電路問題,創作類則讓代理建造作品。部分創作結果需要評審判斷,因此不能把整個評測描述成全部由固定規則自動驗證,也不能把創作分數當成所有人的一致審美。
邏輯任務中的較難項目要求做出紅石互斥或電路,也就是兩個輸入只有一個開啟時才輸出。這種工作能用輸入與輸出關係檢查,和只看外觀的建築評分不同,因此兩種結果不應混成相同證據。
合作類包含四個遊戲、各五次執行,創作類則包含二十五份經評審的建造結果。這些數量讓讀者知道測試涵蓋多少重複與場景,但仍不是所有 Minecraft 玩法的完整抽樣。
創作場景另有飛行與特定輔助功能。這些是該場景明定的操作條件,不能直接當成其他生存或對抗任務也允許同樣能力。比較不同分項時,應先確認各自能使用哪些工具。
若團隊比較的是程式代理,可能更在意狀態觀察與計畫修正;若比較的是合作助手,則可能先看合作項目。總分方便瀏覽,但真正的選型仍要回到每一項工作的權重是否符合需求。
因此讀者應先找自己關心的能力,再決定總分是否能代表那項需求。
對手、座位與未完成測試,會怎麼影響名次
多人任務要固定對手與位置,否則模型可能因遇到不同競爭者而得到不同成績。
在部分競爭任務中,受測者面對的是指定模型的三個副本,並輪換位置、隱藏名稱,以降低座位與品牌線索影響。這不是把所有模型兩兩對戰後,得出一張沒有對手條件的絕對強度表。
固定對手能讓比較較一致,但也留下適用範圍。某種策略可能正好擅長面對這組對手,換成不同節奏或合作方式時,結果仍可能改變,因此對手配置要跟分數一起保存。
測試完成狀態同樣需要看。官方會對未完成全部項目的模型標示部分結果,這類項目不應當成完整排名。已排程但尚未執行的試次會先以零計入,也可能讓進行中的數值偏低。
因此,看到某模型分數突然變動時,先檢查是不是新增試次、補完測試或版本調整,再討論模型能力是否改變。把尚未跑完的中途值寫成最後結論,會讓新聞很快失真。
成本資料也需要對齊層級。官方匯出資料中,同一模型的總成本可能在不同列重複出現,不能把每一列都加起來當成新費用。應先確認欄位描述的是單回合、單任務,還是整體合計。
對自己的測試,也可保留一個清楚的完成清單:哪些已跑、哪些失敗、哪些還沒開始。這比只提供一個隨時更新的總分,更容易讓同事判斷目前資料是否足以做決定。
名次需要帶著版本與完成狀態,才不會把一段尚未跑完的過程當成定論。
超過一位人類玩家,不等於全面超越人類
當次榜單的人類基準,提供一個具體比較對象,但仍只是單一玩家與這套題目。
發布原始貼文以 Minecraft 玩家 SethBling 作為人類代表,指出新模型超過他的當次成績。這個說法有具體比較對象,不應被改寫成所有人類玩家都已落後。
本次官網快照中,Astra 6.2 為 78.3,SethBling 為 77.2,差距來自指定遊戲、權重與介面。若換一種總分權重、不同任務或更多人類參賽者,結果仍需要重新評估。
人類與模型的操作條件也不同。即使都在 Minecraft 世界裡,結構化觀察與一般遊戲操作不會提供完全一樣的資訊與負擔,因此這項比較不是隔離所有條件後的純智慧實驗。
官方影片展示建造、紅石與角色對抗,能讓讀者理解任務外觀,但不是完整測試紀錄。看見幾段精彩畫面,也不足以知道同一模型失敗了幾次或需要多少嘗試。
Kradle 是這套平台與評測的提供者,具有展示產品價值的利益。公開方法有助於外界檢查,本文沒有獨立重跑所有回合,因此仍把分數視為官方測試,而非本站自己的能力驗證。
它比較有價值的問題,是模型在持續變化的環境中會如何失誤。若能從軌跡找到過晚回應、分工重複或沒更新計畫,就能提出比誰超過誰更容易驗證的產品改善方向。
保留比較範圍,才能把遊戲中的觀察轉成代理產品的測試問題。
把即時評測概念用到自己的代理流程
團隊可以從會被時間或他人行動改變的任務開始,記錄模型在等待期間錯過什麼。
實際工作中,也有世界不會等模型的任務,例如多人共用的待辦清單或持續更新的資源狀態。測試可以先用副本模擬變更,觀察模型是否會在執行前再次確認條件。
完成條件應寫清楚它能做的事與失效情境。若另一個人已處理同一項目,代理應避免重複修改;若原本可用資源已消失,應回報並調整,而不是照舊執行一份過期計畫。
測試也可分開記錄等待與行動。模型思考多久、工具多久回傳、重試發生在哪裡,都可能影響最終結果。這會讓團隊知道要調整的是模型、執行方式,還是任務本身。
多人合作場景則應保留誰負責哪一段,並檢查交接資訊是否足夠。若每個代理都在重做同一件事,總產出看似很多,實際完成範圍可能沒有增加。
驗收不必只有成功與否。也可記下人為介入、重複動作與因資料過期而撤回的次數,這些都需要來自實際觀察,不能由公開遊戲分數直接推算。
最後再以代表性案例追蹤更新。如果某次改版讓回應更快,應同時確認品質與授權沒有退步。當速度改善能連回具體工作結果,而不是只少幾秒等待,才知道這項變化值不值得採用。
將完成品質、等待與成本一起檢查,會比只換一個總分更接近實際工作。
KradleBench 常見問題
KradleBench 是讓模型只看遊戲畫面嗎?
不是。模型使用結構化世界資訊與共同的程式操作介面,這個條件應與成績一起閱讀,不能當成純滑鼠鍵盤玩家比較。
超過 SethBling 代表超過所有人類嗎?
不代表。這是單一人類玩家在指定題目、權重與版本下的結果,沒有涵蓋所有玩家或人類工作能力。
為什麼有些分數看起來很低?
除了表現,也可能受到測試完成狀態影響。未執行的排程試次與部分結果需要先分清楚,再判讀正式排名。
把等待中的變化也納入評估
KradleBench 提供一種觀察代理的方式:不只看某次回答,而是看它在他人持續行動的世界裡,能否及時更新計畫。這個觀點有用,仍需保留介面、權重與對手條件。
團隊可以先用一個可回復的共享工作情境,測試過期狀態與重複執行。把品質、時間與成本接到同一段操作紀錄,才有機會知道即時能力是否真正改善工作。
延伸閱讀:Perplexity Multiagent 開放:多模型分工適合哪些任務,為何更耗點數?
延伸閱讀:EditRecBench 研究:AI 能預測修改要求嗎?為什麼少給建議反而更準?