L3G-World 研究:讓 AI 記住走過的場景,9FPS世界生成怎麼來?
L3G-World用可更新的潛在3D Gaussian記憶,讓生成場景在轉頭與返程時更一致。解析單張H100的9.02FPS、返程測試、靜態場景限制,以及程式與權重尚待公開的條件。

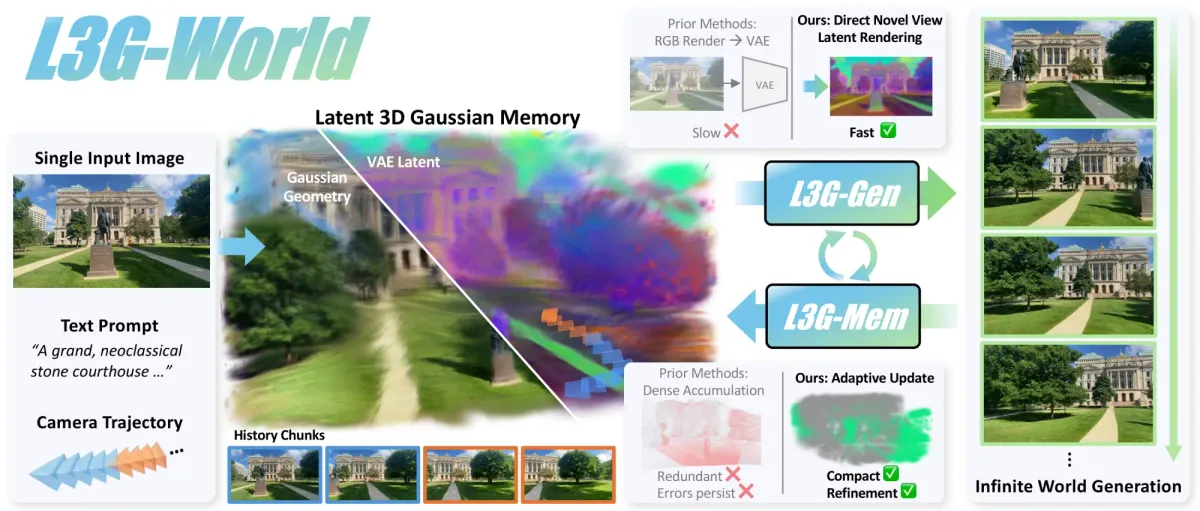
AI 可以生成一條往前走的影片,卻不一定記得回頭時那扇門原本在哪裡。L3G-World 處理的正是這種問題:場景前後不一致,會讓長時間探索失去可信的空間關係。
KAIST 等研究者在 2026 年 10 月 29 日公開這項研究,嘗試用會更新的三維記憶保存場景,而不是每產生一張新影格就把所有內容不斷往後堆。
系統把單張影像、文字和相機路徑接到兩個模組:一個產生影片片段,另一個把片段補進記憶,並在再次看見舊區域時修正既有表示。
它也把影像生成器使用的壓縮特徵存進記憶,免去每次先畫回一般圖片再重新編碼。這讓記憶的讀寫方式成為生成效率的一部分。
論文在單張 H100 的特定設定報告每秒約九張影格,但測到的主要是靜態場景與受控相機路徑。它不是可任意模擬動態人物與物理的完整遊戲世界。
要理解這項進展,得先看記憶如何形成、返程測試驗證什麼,再看速度和公開條件。這樣才能分清研究展示的價值,以及目前還沒有解決的問題。
L3G-World 為何需要一份可修改的場景記憶?
若每次轉頭都重新生成,模型可能產生合理畫面,卻無法保證仍是同一個地方。第一次看見兩扇窗,走開後再回頭卻變成三扇,對單張圖來說可能合理,對連續空間而言就失去一致性。
一種做法是保留過去的影格或中間計算,讓後來的生成參考歷史。但影片愈長,要保留與讀取的內容也可能愈多,長時間探索便不只是多產幾秒影片,還會遇到記憶體和注意力計算的負擔。
另一種做法,是把看過的內容放進三維場景表示。相機移動時,可以從對應位置取回既有空間資訊,而不是只在一串時間順序的影格中尋找線索。
L3G-World 採用的3D Gaussian,可以先理解成帶著形狀、位置與特徵的空間小斑點。許多斑點共同描述場景,讓模型在某個相機位置讀取適合的視角資訊。
新區域補記,舊區域修正
單純把每一段影片都變成新斑點再加入,仍可能在同一區域重複累積。研究因此讓 L3G-Mem 先看現有記憶覆蓋到哪裡,再把新的表示放到不足的區域,而非每次從頭堆一份相同內容。
已經有記憶的地方,也不是永遠固定。當後續片段帶來新的觀察,更新器會修正看得見的既有幾何和特徵,降低早期重建錯誤一路保留下去的問題。
這裡的「觀察」也可能來自系統剛生成的影片,不一定是額外拍到的真實影像。因此,修正能提高生成流程的自洽,卻不能自動保證每次修改都更接近真實世界。
記憶不只要保留內容,也必須能在重訪時修正早先的錯誤。這是本研究和只把歷史資料一直往後加的方式,最值得分開理解的地方。
記憶如何直接接到下一段影片?
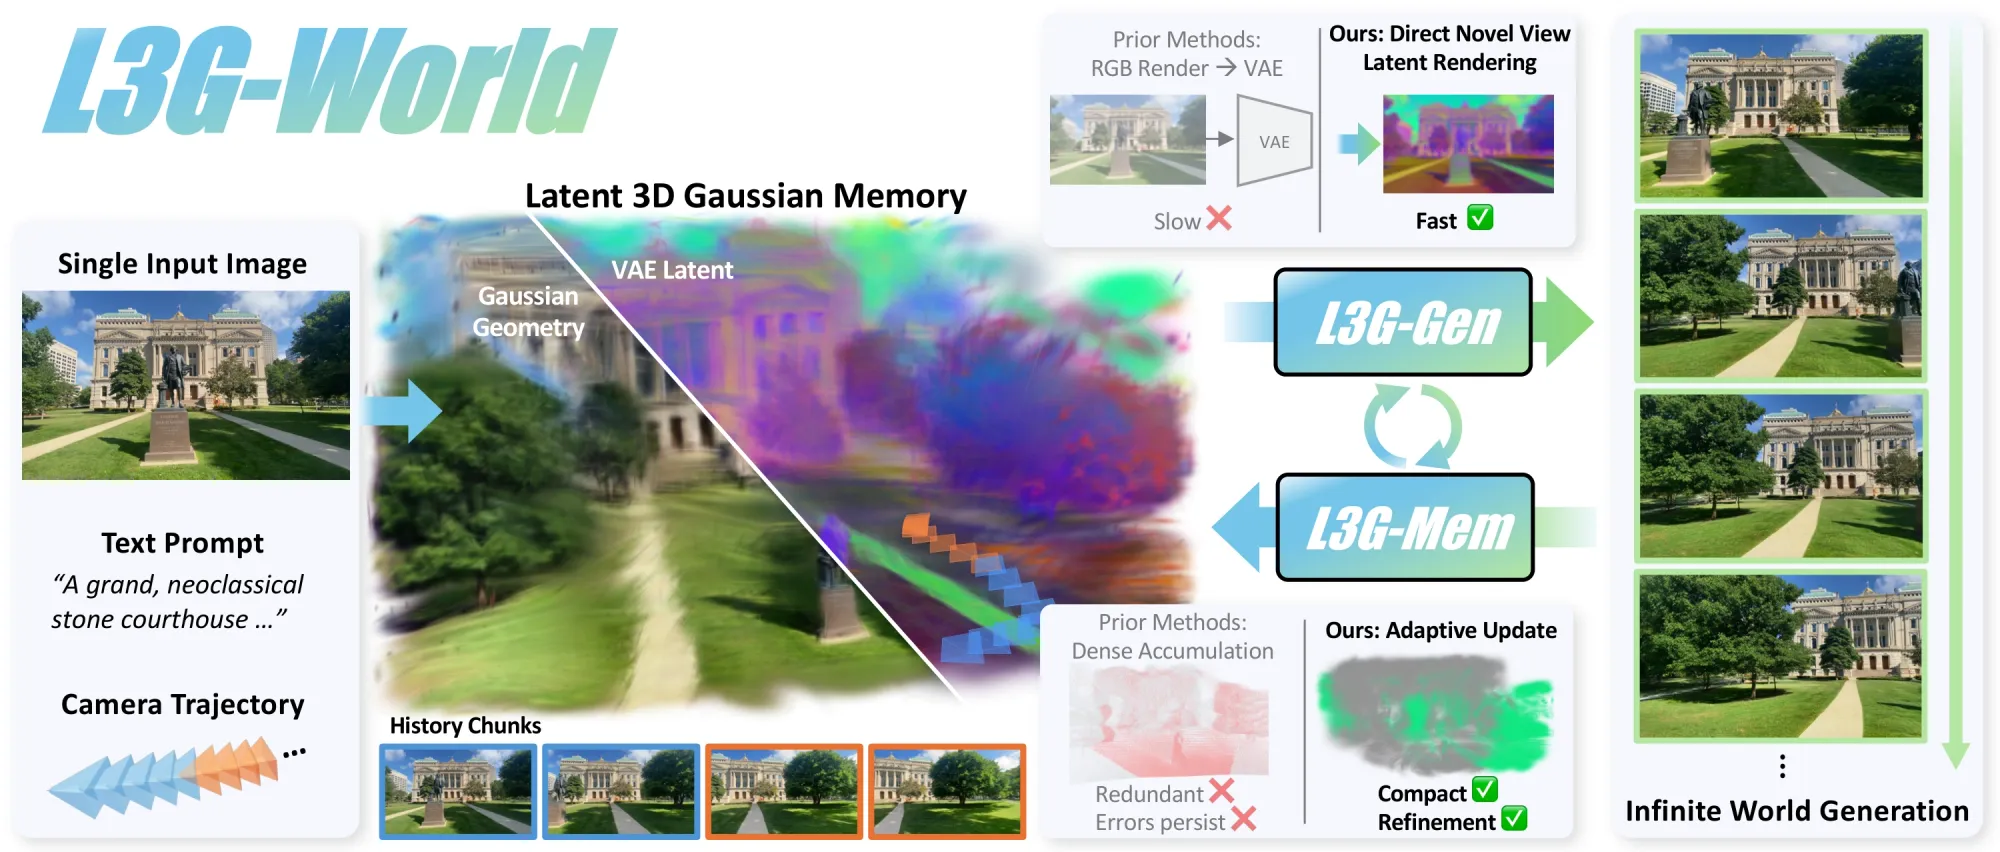
L3G-Mem 把場景寫成帶有壓縮影像特徵的三維 Gaussian,讓 L3G-Gen 直接讀取。兩個模組會隨影片生成反覆交換資訊。
從單張輸入開始,更新器先建立初始記憶。接著,系統依指定的相機路徑,把記憶轉成對應視角的條件,交給影片生成器產生下一段,再把產出的內容送回更新器,作為下一輪的依據。
省掉一次轉回圖片再壓縮的往返
影片模型通常使用較緊湊的影像特徵進行生成。VAE 就是負責圖片與這種壓縮表示之間轉換的模型,讓生成器在較小的表示空間工作。
如果三維記憶只保存一般顏色外觀,每次給影片模型讀取之前,就需要先把某個視角畫成圖片,再透過 VAE 重新編碼。這種往返在只看一次時或許可以接受,連續產生很多片段時卻會反覆付出成本。
本研究讓每個 Gaussian 額外保存 VAE 特徵,讀取時直接產生影片模型需要的壓縮條件。它減少的是記憶和生成器之間的轉換,不是聲稱只要存入壓縮特徵,所有生成運算都不見了。
L3G-Gen 本身仍要執行影片生成。研究採用影片擴散變換器,也就是逐步把雜訊轉成影片內容的模型,再用少步蒸餾降低需要的步驟。蒸餾可以理解為讓較省步驟的模型學習較完整生成流程的表現。
因此,整體速度同時來自較有效的記憶讀寫與生成器調整。若只看到記憶渲染快了很多,就把倍數套到整段影片,會漏掉仍存在的其他工作。
省去重複轉換後,記憶才比較能跟上連續生成的節奏。研究的核心因此落在如何讓後續生成以較低負擔持續利用記憶。
原路回來的481影格,測的是自洽還是真實?
研究安排相機先離開再沿原路返回,檢查同一位置的兩次畫面是否相似。這種返程設計,使「能否記得先前場景」有了一個可以對照的觀測方式。
作者在 DL3DV 與 RealEstate10K 的測試部分建立四百八十一影格路徑,讓前半段探索、後半段反向走回。比較對象是相同相機姿勢、卻在不同生成時間點出現的影格。
若回程的窗戶位置、牆面紋理或空間結構改變,對照就能反映差異。論文使用像素與視覺特徵相似度等指標,讓結果不只停在作者挑出的示範畫面。
與自己一致,不等於未知空間已被測量
這套方法測的是生成世界前後是否一致。它沒有讓輸入照片看不到的背面變成真實資料,也沒有把模型補出的房間視為實際建築的精準重建。
例如,假設一張室內照片沒有拍到走廊盡頭,模型可以生成一個合理延伸,並在回頭時保留那個延伸。這個本文假設說明的是自洽,不能用來證明現場真的有同樣的走廊。
作者也比較完整版本與少步的 Fast 版本。加速後仍能保留部分長時一致性,但各項品質與相機控制並非完全相同,不能把完整版本的最好品質和 Fast 的最高速度拼成同一個保證。
此外,論文在 RealEstate10K 上並非每個指標都領先。其他方法在某些相機姿勢誤差或三維一致性指標有較好結果,顯示這是一組品質與效率取捨,而不是所有能力都同時壓過所有比較對象。
對照系統也有適配條件。附錄交代,部分原本使用多視角或離散動作的系統,需要配合本次單圖與相機路徑重新安排輸入。結果應在作者公開的比較協定下閱讀,不能泛稱所有使用方式都得到相同結論。
自洽證據支持世界記得自己生成過什麼,仍不能證明未知區域與現實一致。這個界線,對想把世界模型用在設計、遊戲或模擬的人尤其重要。
9.02FPS與7.4GiB,必須帶哪些條件?
論文的總生成速度是在單張 H100、480乘832解析度與四百影格流程下量測。每秒9.02張影格描述這個設定的整體吞吐,不是一般筆電、手機或任意解析度的保證。
同一張效率表列出峰值 GPU 記憶體7.4GiB。GiB是記憶體容量單位,這個峰值看的是執行流程的占用,和三維記憶本身只占多少 MiB,是不同範圍。
若只取出較小的三維記憶容量,就推定整個生成器也只需要那麼多顯存,會漏掉模型權重,也就是模型訓練學到的數值,以及其他執行空間。反過來,顯卡本身的總容量,也不能當成每次請求一定全部使用。
總速度、重建與讀取不是同一欄
論文另外的品質與記憶效率比較,使用單張 A100。這裡分別量測記憶建立、一般圖片渲染,以及供影片模型使用的 VAE 特徵渲染,並非每一欄都在報告完整影片的產生速度。
原作者公布的部分大倍數,來自省掉圖片再編碼的記憶讀取路徑。即使該步驟很快,後面仍要生成影片和更新記憶,因此不能把數百倍讀取提升改寫成影片本身快了數百倍。
四百影格的總效率測試,和四百八十一影格的返程品質測試,也應各自保留。前者用來看流程資源與吞吐,後者用來比較探索後返回的場景,兩者不是同一次操作的所有數字。
每秒約九張影格在研究中被稱為即時生成,但它仍低於常見影片播放的每秒二十四或三十張。對互動用途是否足夠,還要看展示方式、控制需求與等待感,不能只靠「即時」兩字判斷。
不同硬體、不同模組和不同實驗表,不能把數字拆出來當同一個部署保證。保持條件完整,讀者才知道研究解決的是哪個瓶頸。
為何還不能直接當作可下載的遊戲引擎?
這項工作主要處理靜態場景一致性,不是會自行移動物件的完整世界動態。原作者把分開處理動態內容與固定幾何列為未來方向,沒有宣稱人物、車輛和可互動物件都已被完整建模。
即使記憶不再隨每一張影格重複累積,探索全新區域時仍會增加。這讓它較接近隨走過的空間成長,而不是「無限世界使用固定零成本記憶體」。
論文也指出,早期生成或更新中的錯誤仍可能往後傳。更新機制能修正一部分問題,卻沒有消除長時間生成的全部誤差,因此不能用一段順暢示範保證任意長度都不會失真。
程式與權重仍須分項看公開進度
截至本次查詢,官方 GitHub 的四項釋出計畫仍未勾選完成,包括記憶模組、生成器、整合推理程式與 Fast 權重。專案有影片和論文可讀,不代表一般使用者已拿到完整可執行系統。
授權也分層處理:原始程式列MIT,記憶權重涉及禁止商用的CC BY-NC 4.0,生成器與Fast權重則依NVIDIA模型授權,相關相依元件和資料另有條件。
因此,不能只看到程式庫中的MIT字樣,就寫成全套權重已開放且可任意商用。真正要整合時,還需要對照實際釋出內容與每一部分適用的條款。
研究價值在於更有效的記憶架構,實際整合仍要等公開產物與更多驗證。它提供的是一條讓長時生成更一致的研究方向,沒有直接交付一個包含物理、碰撞與遊戲邏輯的完整引擎。
L3G-World 常見問題
每秒九張影格,是所有設備都能達到嗎?
不是。論文的9.02FPS有單張H100、解析度和生成流程等條件。其他設備、設定或未釋出的實作,不能只靠這個數字推定相同性能。
回頭看見同一個場景,代表重建符合現實嗎?
不代表。返程測試觀察生成內容能否維持一致,照片未提供的區域仍可能是模型補出的。自洽和對真實場景的正確還原,需要不同證據。
可以處理獨立移動的角色和物件嗎?
目前研究主要針對靜態場景,原作者沒有把動態物件的完整建模當成已解決能力。不能從相機可以移動,推定場景裡每個物件都具備真實動態。
現在能下載全套模型商用嗎?
本次查詢的官方釋出清單仍有未完成項,權重條款也與程式不同。應等實際產物並逐項核對授權,不能把研究頁的公開展示當成完整商業部署許可。
延伸閱讀
原始資料來源
想持續追蹤世界模型、3D記憶與研究限制,歡迎免費訂閱 AI 郵報。