Langford 離職:他說 Recycler 就是 FBT,只差不重要的細節
Langford 離職話題中,他在 X 說 Recycler 就是 FBT,只差不重要的細節,還寫了做得好。本文對照他的貼文、部落格、Microsoft 頁面與兩篇論文,說明哪些能證實。

John Langford 離職的消息,在 2026 年 11 月 15 日因為一則 X 貼文再度擴散。貼文稱,一位資深的微軟 AI 科學家離職,說他的研究連被認真考慮都沒有。
貼文接著說,ByteDance 後來發表了他稱為同一個想法的成果。它也說這位科學家是微軟研究院約 50 人實驗室 AI Frontiers 的共同創辦人,該實驗室 9 月被併入,但併入的對象在貼文這裡被截斷。
這件事不是 11 月 15 日才發生。他在 2026 年 11 月 6 日於自己的部落格發表〈The End of AI Frontiers〉,貼文是九天後的轉述。
貼文說他稱 ByteDance 的成果為同一個想法,這點有他本人的話支持。
他在 2026 年 11 月 3 日 UTC 的 X 貼文中,把 ByteDance 的 Recycler 稱為 “the Full Bandwidth Transformer up to inessential details.”
中文為本文翻譯:就是 Full Bandwidth Transformer,差別只在不重要的細節。這是他的單方判斷,他的貼文結尾還寫了 “Nice work!”,意思是做得好。Full Bandwidth Transformer 簡稱 FBT,是他共同署名的論文提出的語言模型架構。
但部落格沒有這句話。這句話寫在 X 貼文裡,比部落格早將近三天,這是本文依時間換算。Recycler 的論文則把 FBT 稱為同期工作,並列出差異。兩種說法並列,所以本文不判斷有沒有沿用,也不推測任何人的動機。
先看他的部落格寫了什麼,再看他在 X 上寫了什麼。
Langford 離職的部落格原文怎麼寫?
部落格原文是 John Langford 的第一手敘述,不是 Microsoft 的正式說法。站內已有文章整理他對組織分歧的敘述,所以本文只摘要部落格內容。
他寫道,AI Frontiers 是 2023 年 ChatGPT 發布後,他與幾位同事因為想讓研究更有組織,而在微軟研究院內成立的子組織。他估計團隊約 50 人。
2026 年 9 月初,團隊被併入 Microsoft AI。他承認這在表面上合理,因為兩個 AI 組織合併可以集中力量,但他認為實際上,前 Inflection 團隊出身的領導層重視擴大規模而不是做研究,兩邊不相容。
這是他的評價,所以不能當成 Microsoft 的政策。原文沒有點名任何一位 Microsoft 主管,貼文結尾被截斷處的人名,在原文中也找不到。
他寫的離開經過很簡單:安置好自己的團隊成員後離開,並說其他創始領導成員似乎也得出相近結論。他也說,在 Microsoft AI 時,他無法讓創新進入使用,甚至很難被認真考慮。
原文寫的是創新,沒有指明是哪一項研究,也沒有說 Microsoft AI 拒絕過哪一篇論文。所以貼文的第一個說法有原文支持,但說成他的研究,比原文具體。
他也說明為什麼不回微軟研究院,理由有兩個。一是他不願待在研究成果沒有實際用途的公司,二是他擔心做好研究就會有好結果的基本約定出現破裂。
至於 ByteDance,原文只在談研究價值時提到,說 ByteDance 的實驗顯示 FBT 的變體,可能和兩倍大小的模型相當。部落格沒有出現同一個想法這句話。
所以部落格把 ByteDance 放在研究回報很大的論點下當例子,沒有拿它來控訴任何人。同一個想法這句話在哪裡,要看他在 X 上寫了什麼。
他在 X 上怎麼說 Recycler 與 FBT?
本文讀到他在 X 上的三則相關貼文,第一則說得比部落格直接,也最關鍵。它發在 2026 年 11 月 3 日 UTC 23:17,也就是台北時間 11 月 4 日上午 7:17。
貼文先放上 Recycler 頁面與 FBT 的 arXiv 頁面連結。
接著他說 Recycler 是 “the Full Bandwidth Transformer up to inessential details.” 中文為本文翻譯:就是 FBT,差別只在不重要的細節。
然後他寫道,ByteDance 的實驗更完整,涵蓋強化學習,規模更大,並跨模型大小比較。結尾是 “Nice work!” 中文為本文翻譯:做得好。
這些都是他的單方說法,但從措辭看,他沒有使用指控或抱怨的字眼,本文讀到的三則 X 貼文與部落格,也沒有他指控 ByteDance 沿用的說法。
Windows Latest 在 2026 年 11 月 14 日的報導,把這點轉述為除了小細節,Recycler 就是 FBT,與他的 X 原文相符。
第二則是 11 月 6 日回覆串中的一句話。一位使用者引用部落格的兩倍大小說法並稱讚 FBT,另一位使用者 @ahatamiz1 則問這個說法的出處。
@ahatamiz1 的看法是,FBT 在推論時是低成本的小改動,但靠多花訓練算力換取更好的資料利用,不會讓模型大小或訓練成本減半。這是對方的意見,本文只轉述。
他回覆說,請看 ByteDance 的結果,他們與大 2.4 倍的模型比較,用的是 “model sizes we could not afford to test.” 中文為本文翻譯:我們負擔不起測試的模型大小。
第三則在 11 月 13 日 UTC 18:06,他引用另一個帳號介紹的縮放研究,把兩者寫成 FBT/Recycler。他說參數越多、每個參數對應的訓練資料越多,效益越明顯,原文是 “the more benefit you see.”
本文沒有讀被引用的研究本身,所以不評論它的結論。三則貼文一致的地方是,他都把 FBT 與 Recycler 放在同一條路線上談。稱讚的字眼只見於第一則。
這些是他的說法,Microsoft 方面怎麼說,要另外看。
Microsoft 公開說了什麼?
本文能查到的 Microsoft 官方文字,只有實驗室頁面上的一則更新,內容只到合併與延續研究,所以並沒有回應他的個別評價。
微軟研究院 AI Frontiers 頁面有一則 2026 年 9 月 14 日的更新。
原文是 “Microsoft Research AI Frontiers is now part of Microsoft AI!” 中文為本文翻譯:AI Frontiers 已成為 Microsoft AI 的一部分。
同一頁還寫了延續研究的承諾。大意是,實驗室會在 Microsoft AI 繼續追求前沿的代理與模型研究,並預告之後會分享更多轉型消息。以上是本文對頁面文字的轉述,不是逐字引用。
Windows Latest 在 11 月 14 日寫道,Microsoft 尚未公開回應此事。本文查閱的來源裡,也沒有看到 Microsoft 的聲明、新聞稿或發言人說法。
所以兩種敘述並排存在。Microsoft 說研究會在新組織延續,但 Langford 說他所在的團隊已告結束,而且他無法讓創新進入使用。
兩段話描述的是同一次合併的不同層面,因此不能直接判斷誰對。能確認的事實是,合併發生在 2026 年 9 月,他在 11 月 6 日公開說明自己的離開。
另外,他寫的是 AI Frontiers 已告結束,Microsoft 頁面寫的是它併入 Microsoft AI,兩者都沒有說整個微軟研究院關閉。
要回答貼文提出的核心問題,就得進入技術層面:兩個團隊的論文做了什麼,差異在哪裡。
Full-bandwidth Transformer 想解決什麼問題?
Full-bandwidth Transformer 要解決的是,語言模型每生成一個字,最上層的內部狀態就被丟掉。這個模型簡稱 FBT,論文由 Xi Wang、Ziyang Cai、John Langford 等 8 人署名。
因為語言模型是一個字一個字生成的,所以每一步,模型都在內部算出一組數字,稱為頂層隱藏狀態,可以想成它對上下文的內部理解。
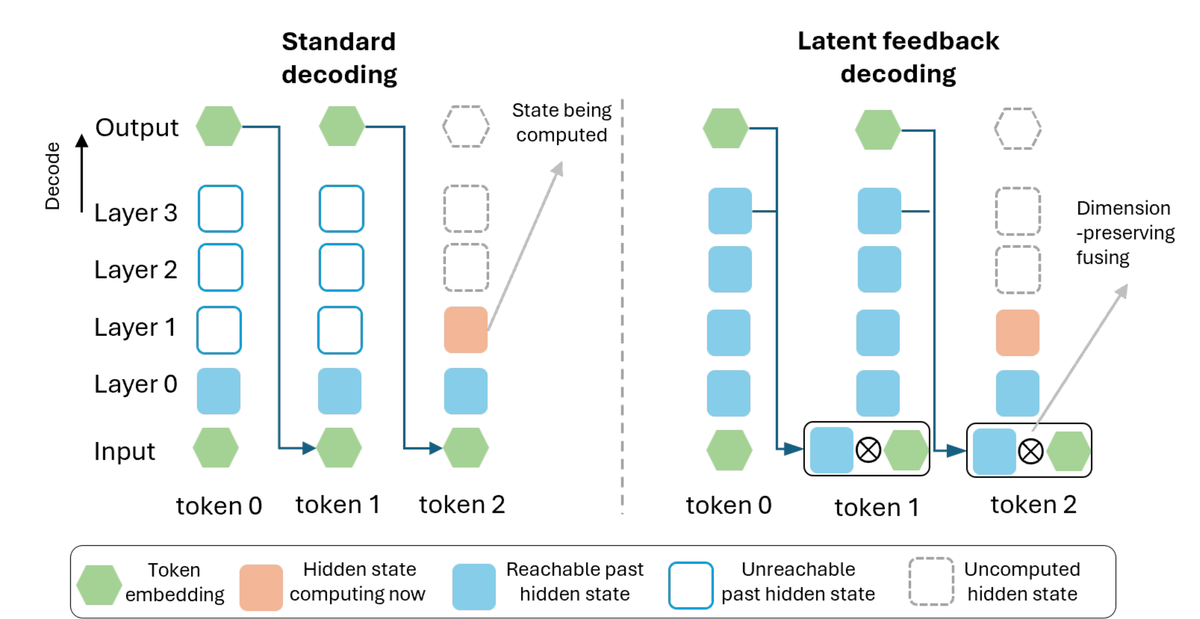
但在標準做法中,只有被挑出來的那個字會送回下一步,隱藏狀態本身被丟掉。FBT 的作法,是把前一步的隱藏狀態,和那個字的嵌入合併後再送回。嵌入是把字轉成的一串數字。
論文用閘控線性單元來合併兩者,這是一種讓模型自己學習取捨的合併方式。作者稱,這樣下一步能重新用上前一步算出的資訊,而且標準架構與快取機制都不必改。
訓練是難處。transformer 是多數大型語言模型採用的架構,優點之一是能平行訓練,但回饋讓計算必須逐位置依序進行,破壞了這個優點。
作者用多次前向傳遞近似它,而且在預訓練後期才引入回饋。前向傳遞就是模型把輸入完整算一遍。
論文報告的數字來自 1B 參數的模型,訓練量多達 400B 個 token。token 是模型處理文字的基本單位,約略是一個字或字的一部分。
作者稱,在解碼額外成本可忽略的情況下,FBT 與用約 1.5 倍 token 訓練的標準模型相當或接近。
這篇論文在 arXiv 的第一版是 2026 年 8 月 9 日,第二版在 10 月 1 日。論文註明,第一與第二作者的工作是在 Microsoft AI Frontiers 實習期間完成的。
10 月,ByteDance Seed 發表的 Recycler 論文,做法與 FBT 相近。
ByteDance 的 Recycler 做了什麼,兩者有多像?
Recycler 也把前一個 token 的隱藏狀態送回下一步,這是兩篇論文明顯的共同點。ByteDance Seed 的論文標示日期為 2026 年 10 月 25 日。
Recycler 的出發點,是在主模型旁加一個小型預測模組的做法,稱為遞迴多 token 預測。作者觀察到,這種模組只用主模型約 2% 的參數,損失卻接近一個約四分之一大小的獨立模型,因此認為隱藏狀態回饋很有價值。
它用一個輕量轉接器處理前一步的隱藏狀態,再以加法與 token 嵌入合併,所以論文說這個設計的解碼成本與標準 transformer 大致相同。
關鍵在於,Recycler 的論文自己引用了 FBT。它把 FBT 稱為同期工作,說 Recycler 在注入位置上與 FBT 較接近,但使用較簡單的加法轉接器,以及依賴解碼時外推的較淺多次傳遞近似。
也就是說,ByteDance 自己承認方向相近,也自己列出了差異。下表整理兩篇論文各自寫明的內容。
| 項目 | Full-bandwidth Transformer | Recycler |
|---|---|---|
| 標示日期 | arXiv 第一版 2026 年 8 月 9 日 | 論文標示 2026 年 10 月 25 日 |
| 回饋的內容 | 前一步頂層隱藏狀態與 token 嵌入 | 前一個 token 的頂層隱藏狀態與 token 嵌入 |
| 合併方式 | 閘控線性單元 | 輕量轉接器,以加法合併 |
| 訓練做法 | 預訓練後期才引入,並混入少量更深的回饋傳遞 | 固定回饋深度的多次傳遞,涵蓋預訓練、微調與強化學習 |
| 論文自述的效率 | 約 1.5 倍 token 的標準模型相當或接近 | 摘要稱勝過參數多 2 至 3 倍的模型 |
「兩倍大小」和「1.5 倍資料」是同一件事嗎?
不是,兩篇論文與 Langford 的原文用的是不同的倍數,不能直接互換。
FBT 摘要說的是訓練資料量,約 1.5 倍 token。論文導言另說,模型在讀提示詞的預填階段多跑兩到三次傳遞時,可與用兩倍 token 訓練的標準模型相當。這裡比的是資料,不是模型大小,所以不能和參數量直接比。
Recycler 摘要說的是參數量,勝過多 2 至 3 倍參數的模型。但在預訓練對照中,同尺寸 Recycler 的下游平均為 64.76,2.4 倍大小的基準為 66.43,所以是接近而不是超過。
論文也寫明,這三個終點不是等訓練預算的比較,重點是 Recycler 在解碼成本不變下接近較大的模型。
他的部落格寫的是兩倍大小,X 回覆寫的是 2.4 倍。後者與 Recycler 論文的 2.4 倍基準一致,但前者的兩倍是怎麼來的,本文沒有讀到說明。
他接著問,如果訓練與推論成本能減半,對一個投資額接近一兆美元的產業值多少。這是他的推算,不是任何論文的實測結果。
Windows Latest 也提醒,基準分數追平較大的模型,不會自動等於成本減半。兩篇論文也都寫到訓練要多花算力,沒有以金額計算成本。
FBT 的表 1 把 400B token 的訓練折算成相當於 512B 或 600B token 的計算量。Recycler 則寫道,它的訓練成本是標準模型的 2 倍,訓練設定為兩次前向傳遞。
數字單位對不上,所以「同一個想法」能走到哪一步,要看兩方的說法怎麼並列。
「同一個想法」:兩方的說法怎麼並列?
同一個想法的說法有他本人的話支持,但這是單方判斷,Recycler 論文的措辭不同。本文不替任何一方裁決。
他的說法是,Recycler 是 FBT,差別只在不重要的細節,並稱讚 ByteDance 的實驗更完整,所以哪些細節不重要,是他的判斷。
ByteDance 的論文則把 FBT 稱為同期工作,並說明兩者在注入位置上較接近,差異在於轉接器較簡單,以及依賴解碼時外推的較淺多次傳遞近似。
這兩種說法不一定互相矛盾,因為一個強調核心機制,另一個強調方法差異。但哪一種描述更貼近事實,本文沒有判斷依據,也不替任何一方推測動機。
日期也要並列。FBT 第一版在 8 月 9 日,Recycler 標示 10 月 25 日,相隔約 11 週,這是本文依兩個日期換算。
同時,Recycler 的論文引用了 FBT,並稱它是同期工作。本文讀到的資料中,沒有任何來源指控 ByteDance 沿用了 FBT,也沒有這種說法的原文。
另外,兩篇論文的效率宣稱,本文都沒有找到獨立團隊的重現。所以截至 2026 年 11 月 16 日,這些數字只能當成各自團隊的自述。
還有一點要分開看。貼文把他在 Microsoft AI 的經驗,與他對 ByteDance 論文的評價前後並列,但本文沒有找到他把兩者連成因果的原文。
Langford 離職常見問題
Langford 離職是 Microsoft 的官方說法嗎?
不是。這是他在自己部落格寫的第一手敘述。Microsoft 官方頁面只說 AI Frontiers 併入 Microsoft AI,本文沒有查到針對他文章的公開回應。
Langford 本人說過 Recycler 就是 FBT 嗎?
說過。他在 2026 年 11 月 3 日 UTC 的 X 貼文寫,除了不重要的細節就是 FBT,並稱讚 ByteDance 的實驗,但部落格沒有這句話。
Langford 在指控 ByteDance 沿用他的想法嗎?
本文讀到的三則 X 貼文與部落格,沒有這樣的說法,他寫的是 “Nice work!” Recycler 論文引用 FBT 並稱它是同期工作,有沒有沿用,本文沒有證據可下結論。
這個想法真的能讓模型成本減半嗎?
本文沒有查到這樣的實測(截至 2026 年 11 月 16 日)。減半是他的推算,兩篇論文報告的倍數分別是資料量、參數量與基準分數,沒有直接換算成成本。在訓練端,兩篇論文寫的都是額外算力,不是節省。
延伸閱讀:John Langford披露AI Frontiers整併後離職:研究方向與模型規模的取捨怎麼看?
結語:把貼文當線索,把他的原話與論文當依據
這篇整理適合想確認離職消息來源的讀者,也適合想比較 FBT 與 Recycler 的人,因為它把貼文、部落格、他的 X 貼文與兩篇論文的說法分開列出。
它不適合拿來裁定 ByteDance 與 Microsoft 團隊誰先做出什麼,也不適合據此判斷哪一種架構更省成本,因為兩邊的數字單位不同,也沒有獨立重現。
我的判斷是,比較穩妥的讀法是分成四層:他的部落格、他的 X 貼文、Microsoft 的公開頁面,以及兩篇論文各自寫明的內容。四層合在一起,能確認他認為兩者只差不重要的細節、ByteDance 稱 FBT 為同期工作,算不算同一個想法則要看怎麼定義。
延伸閱讀:Microsoft MAI 自研模型進度:3 兆參數級預訓練完成,離可用產品還有多遠?
資料來源
- John Langford 的 X 貼文:Recycler 與 FBT(2026 年 11 月 3 日 UTC)
- The End of AI Frontiers(hunch.net,John Langford,2026 年 11 月 6 日)
- John Langford 的 X 回覆:與大 2.4 倍的模型比較(2026 年 11 月 6 日 UTC)
- John Langford 的 X 貼文:FBT/Recycler 縮放研究(2026 年 11 月 13 日 UTC)
- Full-bandwidth Transformer(arXiv:2608.08888)
- Recycler: Cost-Free Latent Reasoning via Hidden State Recycling(ByteDance Seed,2026 年 10 月 25 日)
- Microsoft Research AI Frontiers(Microsoft Research,頁面含 2026 年 9 月 14 日更新)
- Ali Hatamizadeh(@ahatamiz1)2026 年 11 月 6 日回覆貼文
- International Cyber Digest 的 X 貼文(2026 年 11 月 15 日)
- "No path to real use": a veteran Microsoft AI scientist quits(Windows Latest,2026 年 11 月 14 日)