LiquidCodec 公開設計:74M 語音編解碼器跑在 CPU,87 倍即時速度代表什麼?
LiquidCodec 公開串流語音編解碼設計。解析74M模型、M4 Max單執行緒87倍即時解碼、音質與TTS測試差別,以及量化下載與LFM授權限制。

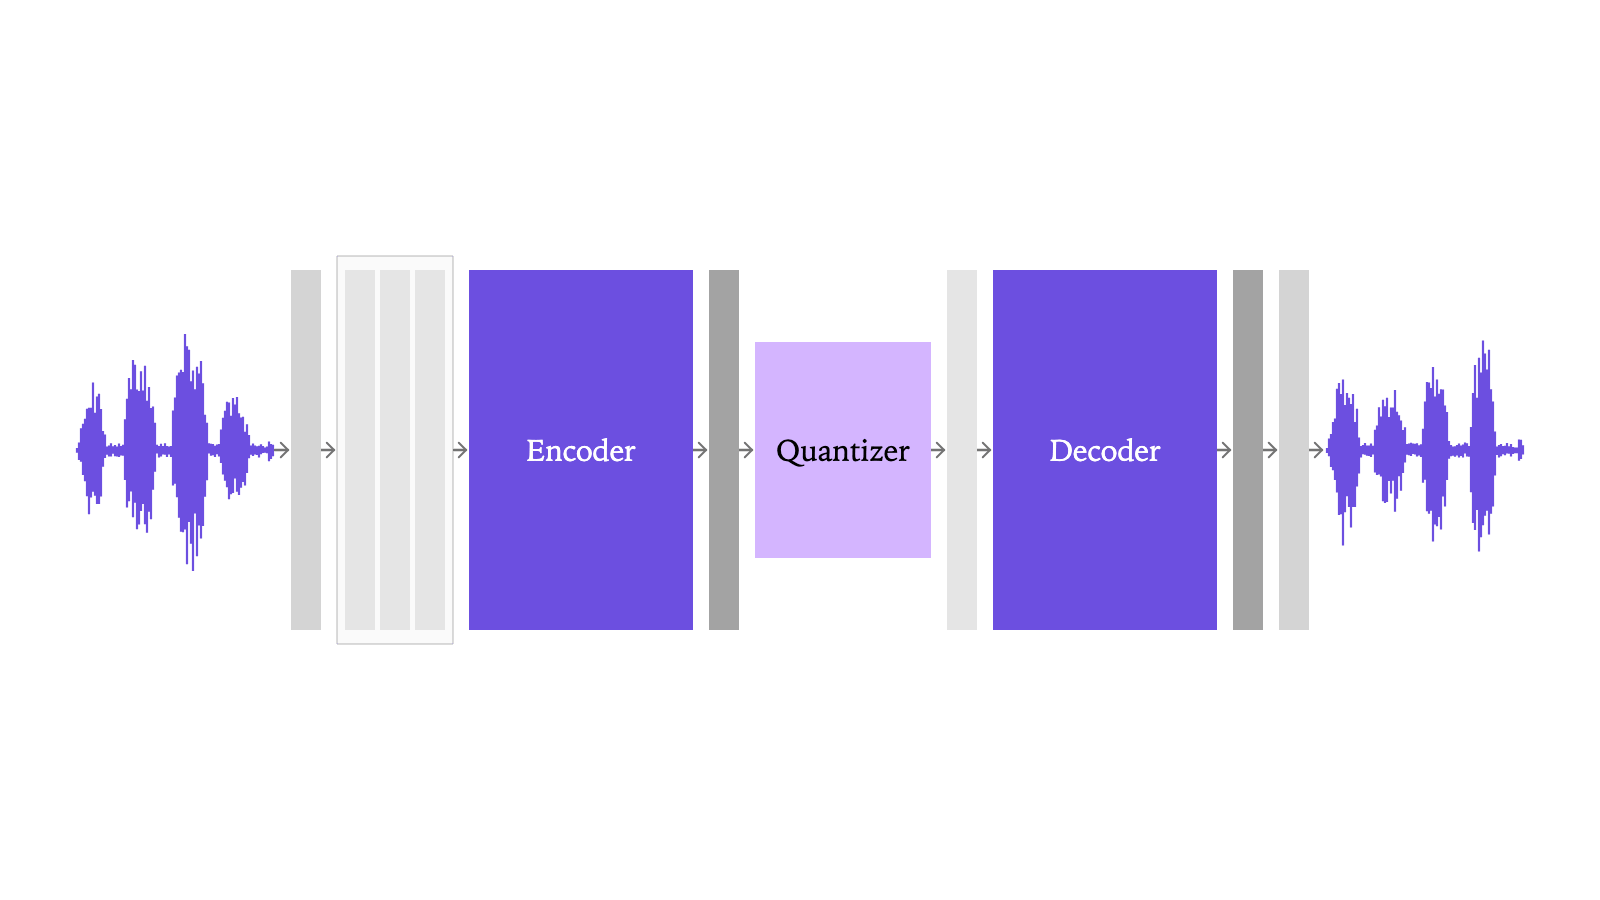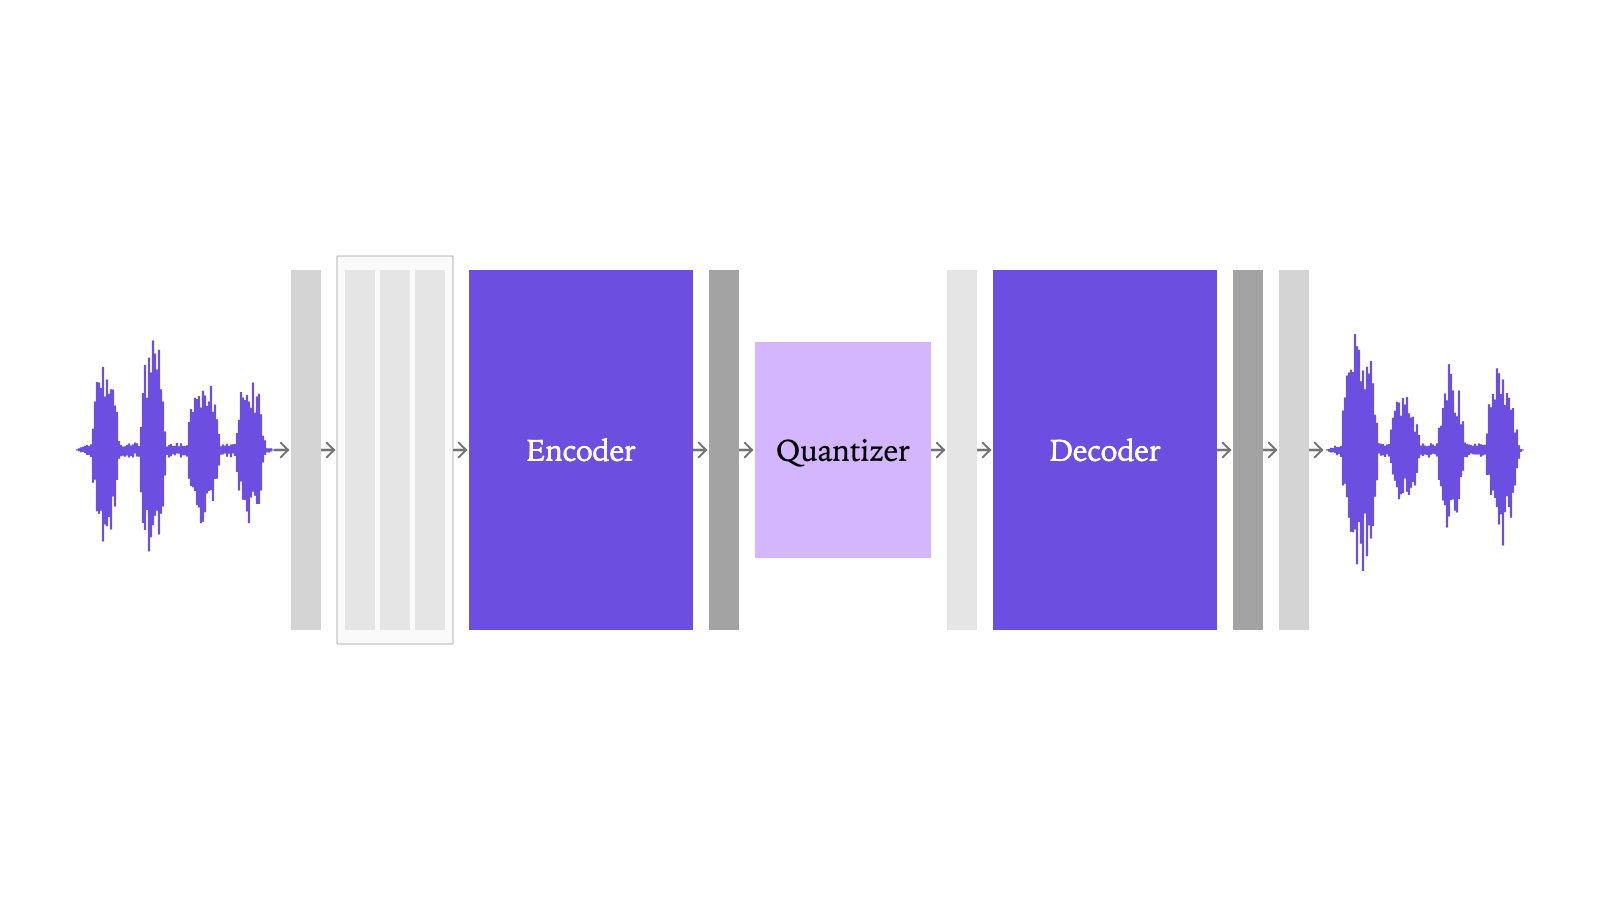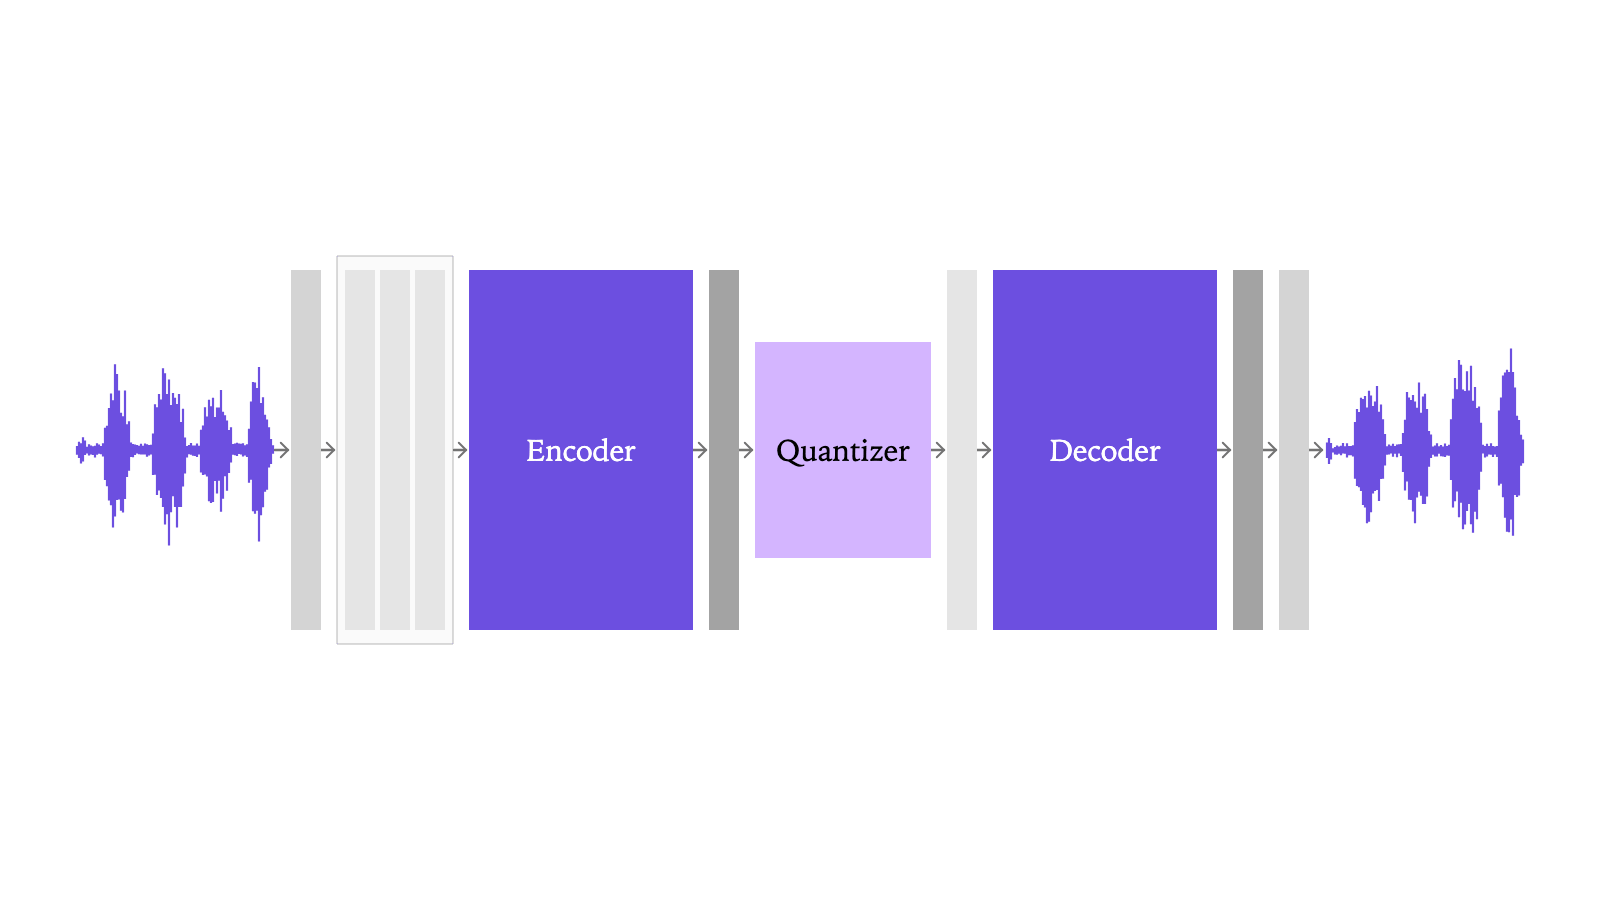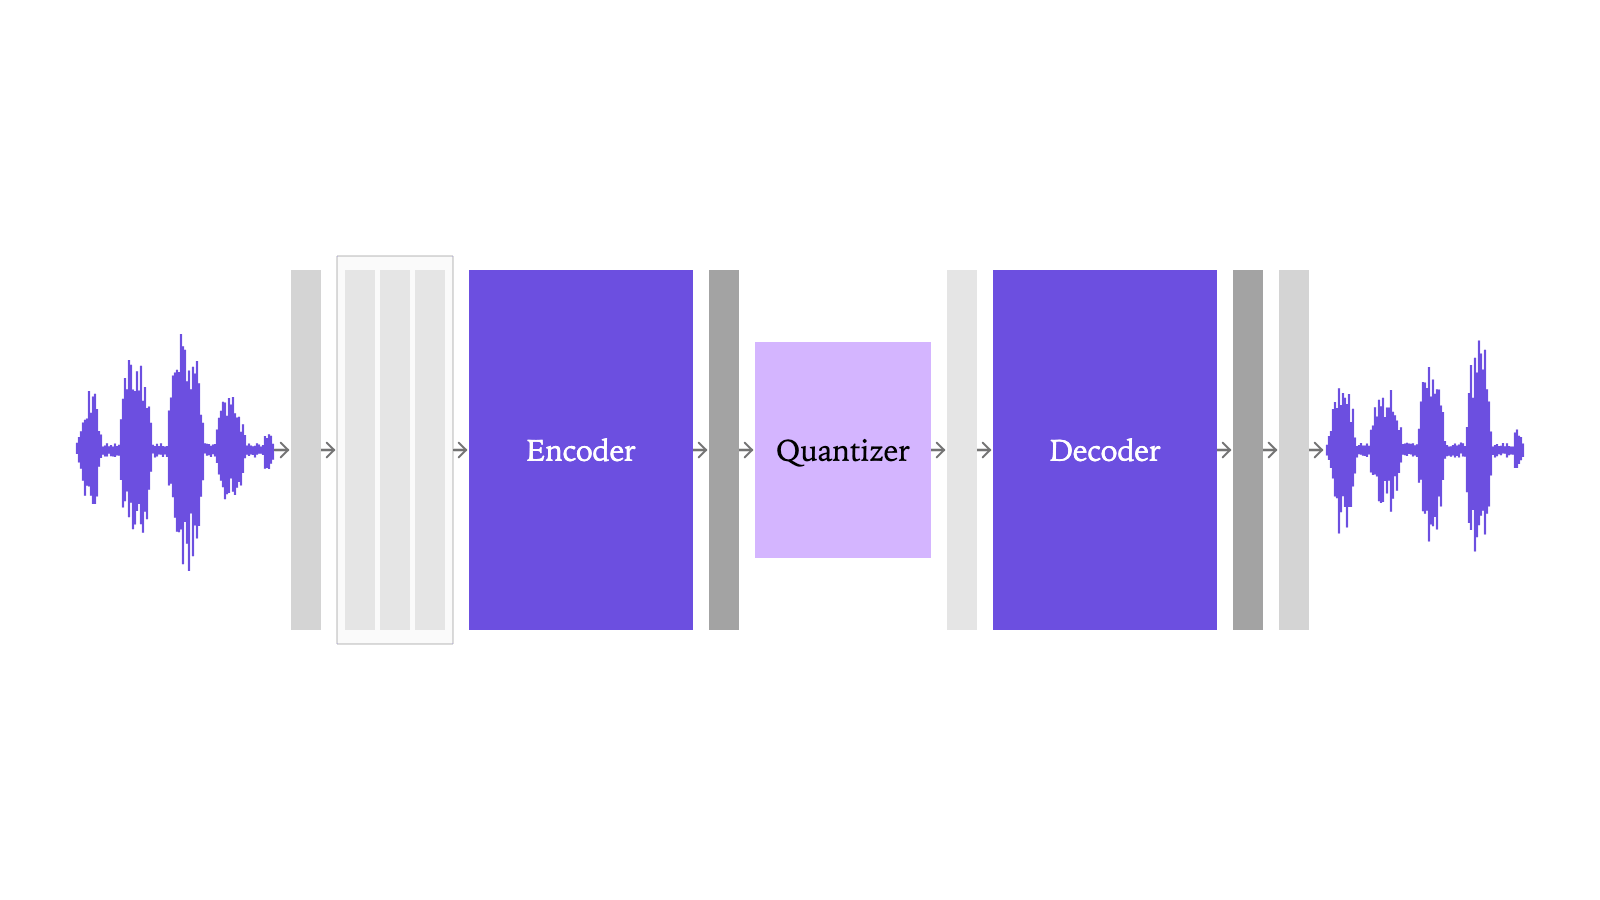
LiquidCodec 把聲音變成語音模型能處理的代碼,再把預測出的代碼還原成聲音。對本機語音 AI 而言,模型想好要說什麼之後,還要過這一關才能讓你聽見。
Liquid AI 在 2026 年 11 月 12 日公開這個約七千四百萬參數編解碼器的技術設計,並提供模型權重,也就是模型學到的數值。它已用在十月底介紹的 LFM3 語音與多模態模型,這次解說聚焦聲音如何有效率地進出模型。
官方在 Apple M4 Max 的單一 CPU 執行緒、FP32 條件下,測得編碼約三百六十一倍、解碼約八十七倍即時速度。這是在量測音訊轉換,沒有包含一整段對話的理解、思考與傳輸。
這個設計同時追求聲音還原品質,以及讓後面的語音模型容易預測代碼。還原得好,和能順暢生成新語音,是兩種需要分別比較的能力。
我會建議開發本機語音產品的團隊,先量清楚編解碼在整條回應中佔多少時間。若主要瓶頸在語言模型或網路,換一個快編解碼器,未必就能解決使用者感受到的等待。
要判讀八十七倍的速度,先看編解碼器在語音流程的位置,再看測試如何把速度、音質與生成能力分開。
LiquidCodec 把聲音和模型代碼互相轉換
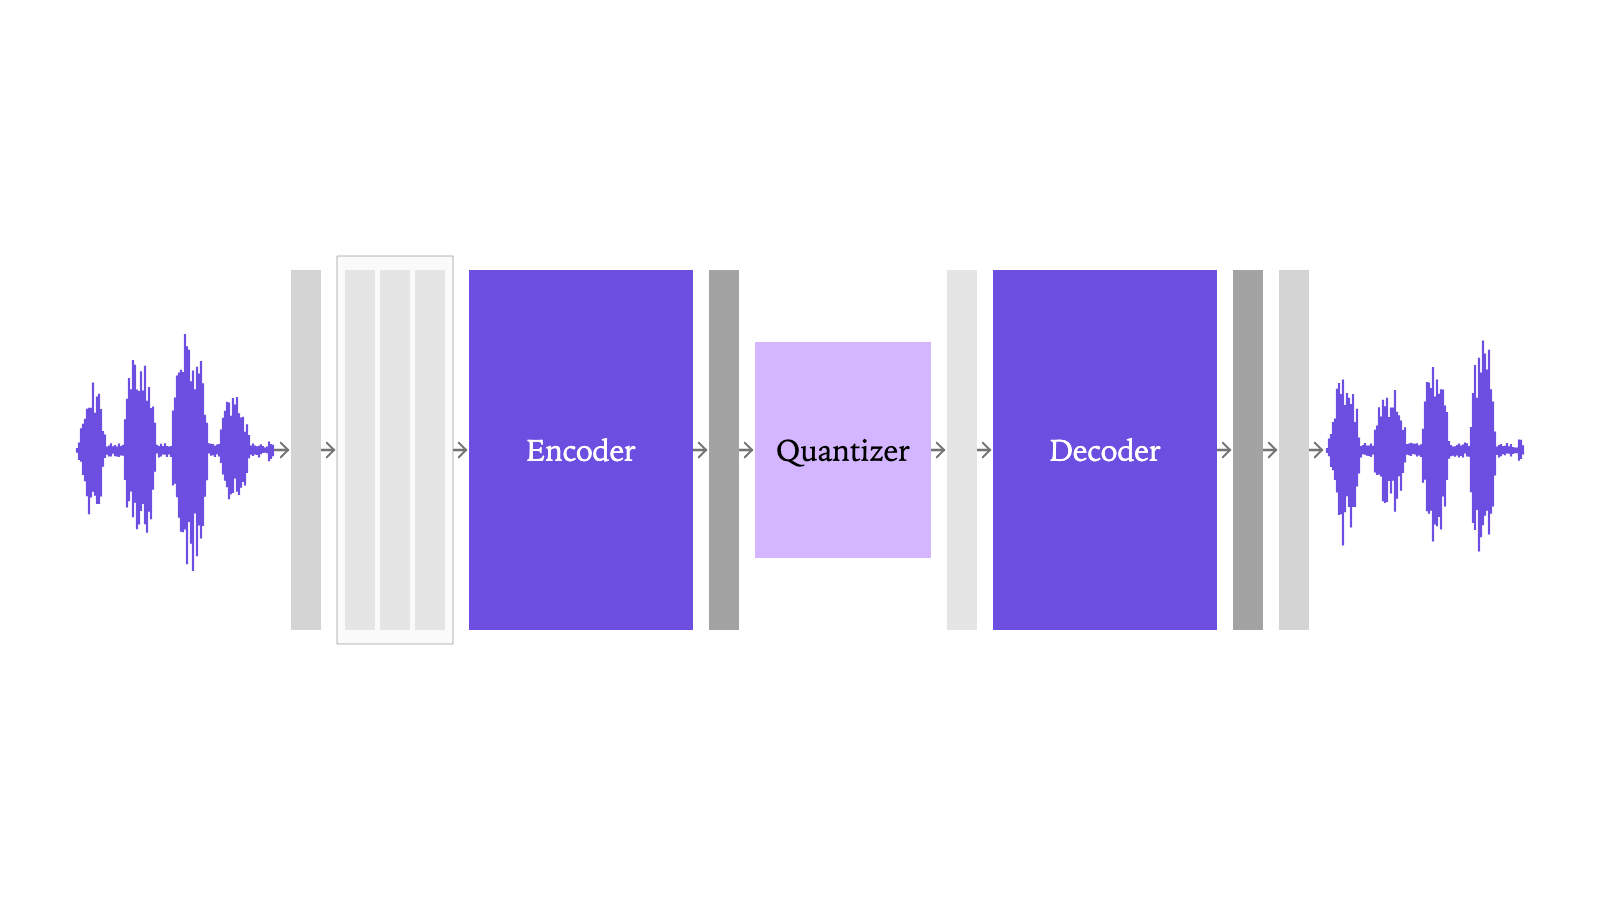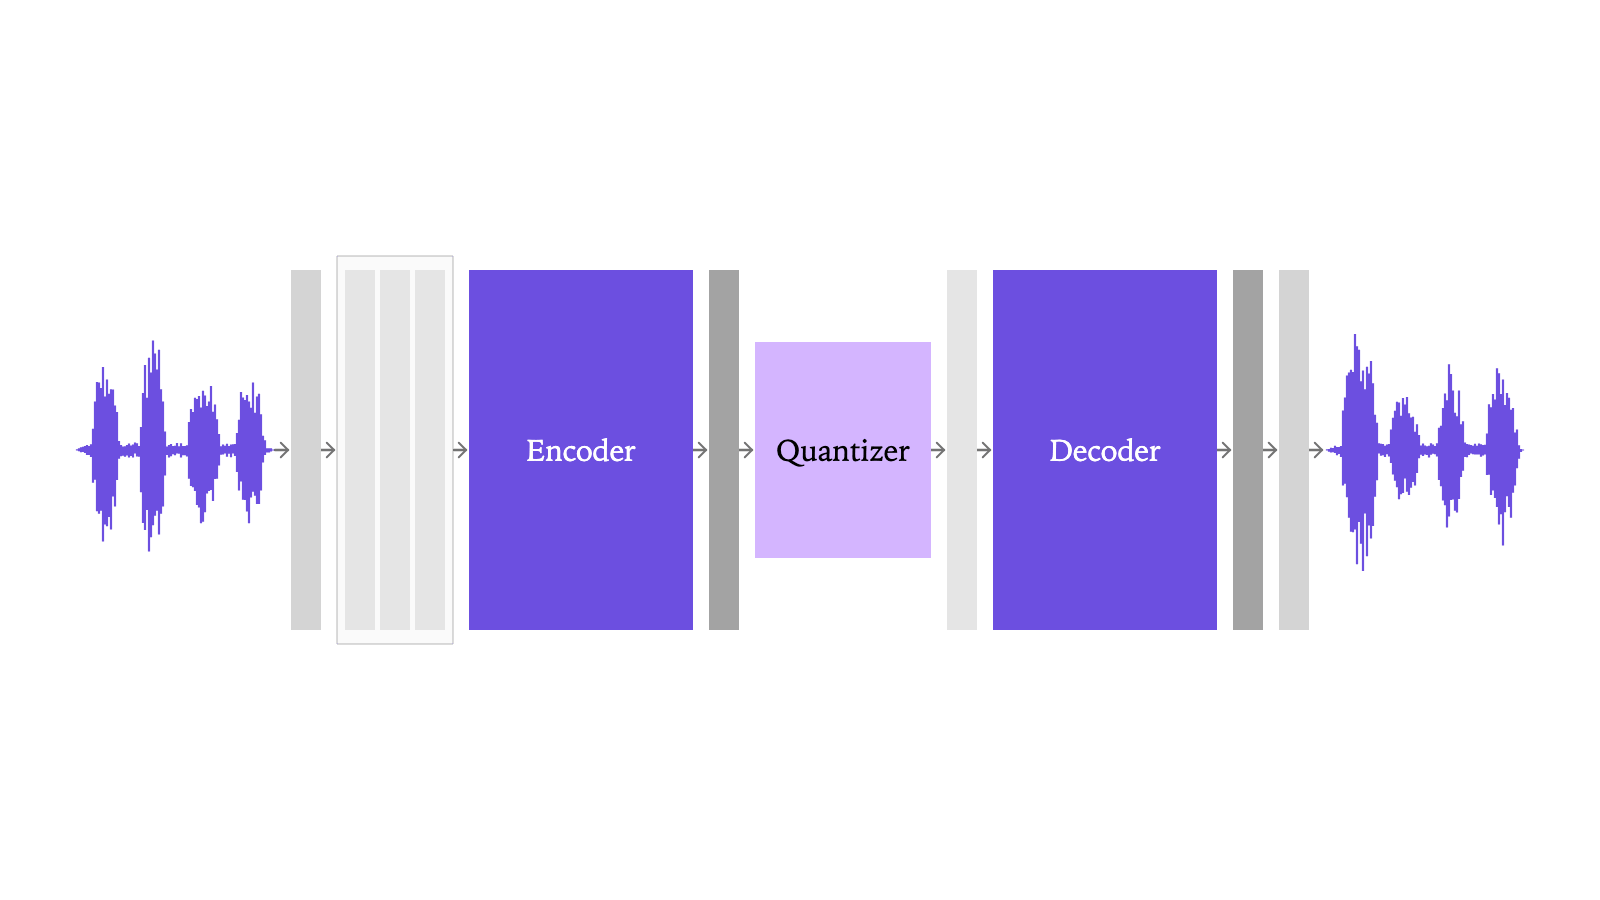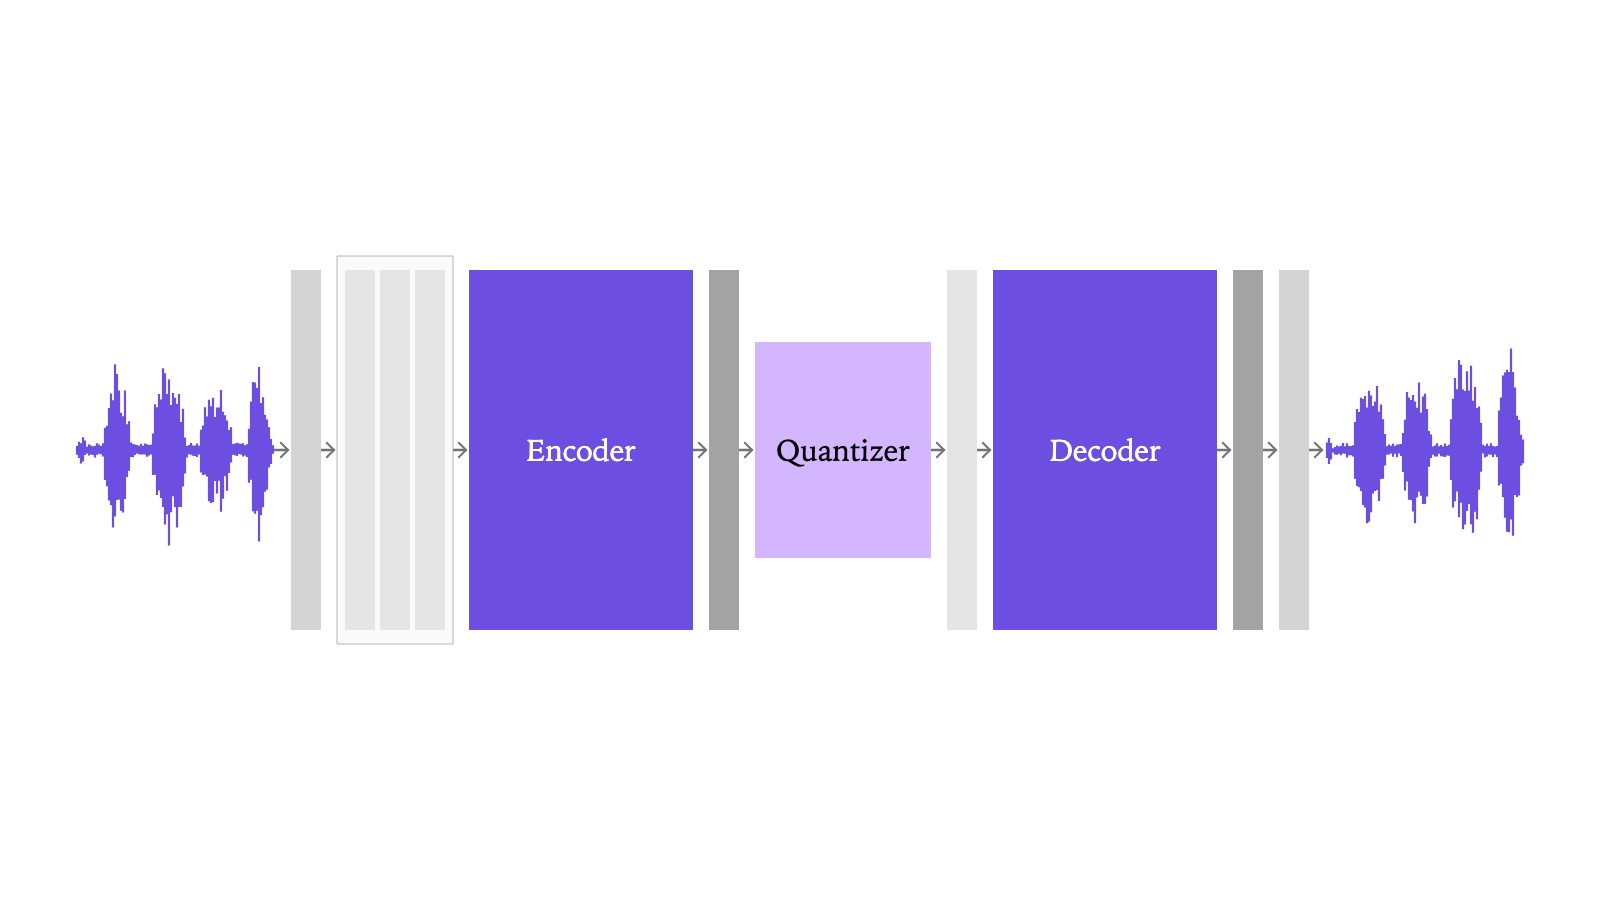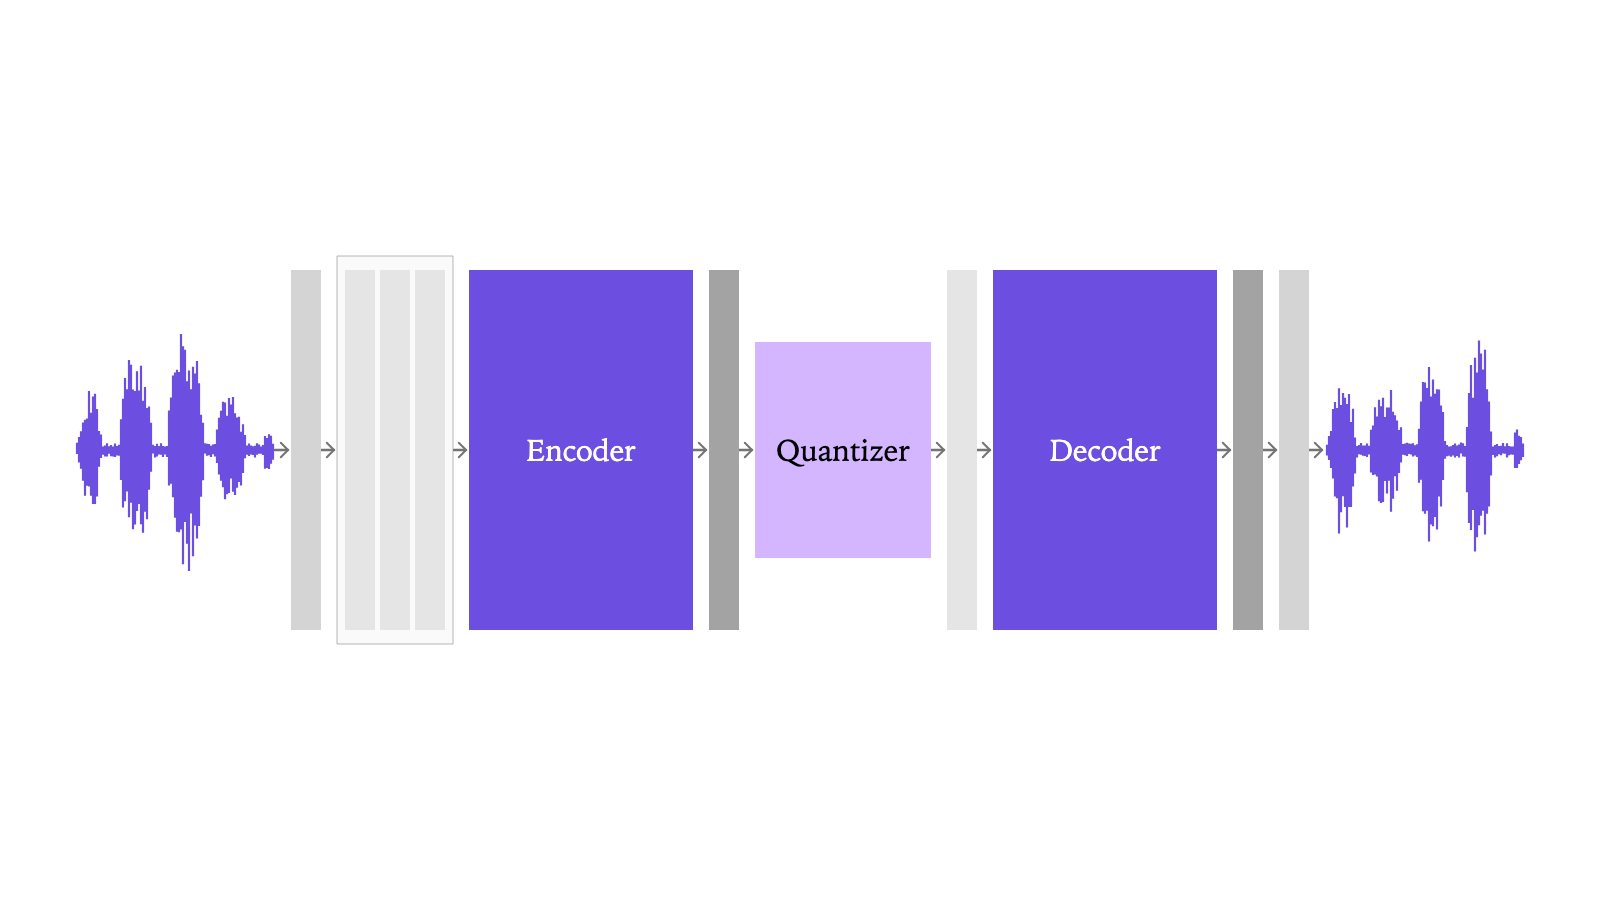
編解碼器處理波形和離散代碼之間的轉換,並不單獨承擔整個語音助手的理解與回答。波形是錄音裡連續變化的聲音,離散代碼則把這些特徵變成模型方便處理的單位。
因為聲音需要雙向轉換,流程也分成編碼與解碼。編碼器先把聲音轉成特徵,再壓成代碼。解碼器則接收代碼,還原成可以播放的聲音。語言模型在中間預測要產生的內容,屬於另一段工作。
因此,說話自然的助手除了要理解問題,也要能把生成結果及時轉成聲音。若這最後一段太慢,即使語言模型已完成預測,使用者仍可能在等待播放。
Liquid AI 在前一代語音模型使用第三方編碼器,再替換自己的解碼器加速。這次則連編碼端一起設計,讓公司能同時調整輸入表示、生成難度與輸出速度。
先分清模型包裡每一層的任務
這個編解碼器約七千四百萬參數,指的是這個編解碼器的數值規模。因為完整助手還包含其他模型,它不等於整個 LFM3-Audio 或 LFM3-Omni 的大小,不能因為編解碼器小,就推論完整助手只需要同樣資源。
模型卡寫明,它處理二十四 kHz 單聲道語音。這表示每秒以二萬四千次取樣表示一條聲道,應用接入不同來源時,仍需要先對齊音訊格式,不能只把任意檔案原樣送進去。
分清這一層之後,才知道快八十七倍究竟省下哪一段等待。
八十七倍即時速度,是音訊長度除以解碼時間
官方測速固定 Apple M4 Max、單 CPU 執行緒與 FP32,讓不同編解碼器能在同一條件比較。FP32 是以三十二位元浮點數進行運算的精度,和後面四位元量化的條件不同。
所謂八十七倍即時速度,可以理解成一秒運算約處理八十七秒聲音。它比較的是聲音長度與解碼時間,不是人在對話中每問一句,就能比原本快八十七倍收到完整回答。
官方表格也提供即時因子 RTF,算法剛好相反:處理時間除以音訊長度,越小越快。它的解碼約為零點零一一五,編碼約零點零零二八,才對應到約八十七倍與三百六十一倍。
這是單一 CPU 執行緒的測試結果,不代表模型一定要動用整台電腦才能達成。反過來,也不能直接移植到其他手機、耳機晶片或多個工作同時執行時的表現。
處理得快,和什麼時候能開始播放不同
模型以每秒十二點五格處理音訊,平均每八十毫秒一格,每格包含十二個代碼。這種分塊方式適合串流,但第一段聲音何時到耳朵,仍受緩衝、生成與播放系統影響。
例如解碼端已經足夠快,語言模型卻還沒預測出下一格,播放器仍要等待。要判斷產品瓶頸,應量整條工作路徑,而非只依編解碼測速決定最後體驗。
運算速度高於播放速度,仍要搭配分塊與其他模型工作才能成為流暢對話。
分組量化減少依賴,讓語音代碼更容易預測
LiquidCodec 將特徵分組量化,減少不同碼本必須依序相互修正的關係。量化是把連續數值對應到有限選項,碼本則描述可用代碼所代表的數值組合。
先前常見的殘差向量量化,會由前一組碼本先表示部分訊號,下一組再補前面沒表達好的差距。它能逐步修正內容,但前後之間也形成依賴,不容易把每一組都當成互不相干的選項。
它採用分組有限標量量化,把特徵分成能各自量化的群組。不同群組不用以同樣方式逐層補殘差,後面的生成方法因此有機會平行預測多個代碼。
這並不表示每一種應用都會自動用上最佳平行方式。它提供較適合這類預測的表示,實際生成仍需要搭配後面的模型架構和訓練方法,不能只靠換碼本就保證整體加速。
編碼器與解碼器也採對稱設計,並使用 LFM3 運算模組。編碼端是因果式處理,也就是依已接收到的內容往前運算,適合持續送入新聲音的串流流程。
解碼端直接預測頻譜係數,用來描述聲音不同頻率的構成,減少一些其他編解碼器需要的逐步放大運算。這讓速度來自多項設計,而非只由參數數量決定。
這個選擇不只影響壓縮,也需要透過語音生成實驗確認後面的模型是否真的受益。
還原音質與生成語音,分開固定條件比較
重建測試把錄音轉來轉去,生成測試則要求模型從文字產生新的語音。前者知道原錄音的代碼,後者需要語言模型自己預測代碼,遇到的錯誤來源不同。
如果只看重建,可能選到能把原音存得很像,卻不容易讓生成模型學習的表示。所以官方除了比較還原音質,也固定一套文字轉語音實驗,檢查同樣訓練資源下的生成結果。
依公司說明,生成比較使用相同的十萬一千小時、六種語言資料,模型架構、運算預算和資料順序也固定。只因各編碼器代碼不同而調整相應輸入與輸出,並彙整三個生成種子的結果。
在八組重建測試上,這個模型的 ViSQOL 音質評分最高、梅爾距離最低。這兩種指標分別觀察可感知品質與聲音頻譜差異,不能延伸成所有音質指標都取得第一。
生成測試中,使用它的模型在八組資料的自然度評分領先,字詞辨識錯誤相關指標則有四組最好。這個差異很重要:聲音聽起來自然,和每個字都念得準,仍是兩個面向。
官方也以另一個 Qwen3 小型骨幹重做比較,報告方向一致。不過這些仍是公司控制的實驗,本刊沒有重跑,也沒有因此證明每個下游模型都能取得同樣優勢。
多語訓練,不等於每種語言都被充分評測
第一階段訓練用了二十六萬四千小時、一百零七種語言資料,後續再以五萬五千小時較乾淨語音改善品質。訓練涵蓋很多語言,和測試集涵蓋哪些語言,是不同口徑。
模型卡另明說,音樂、歌唱與環境聲尚未評估。開發台灣語音服務時,也應保留自己的口音、混合語言與專有名詞,不能只從多語資料量推論每種日常情境都已驗證。
指定測試的優勢能支持設計方向,仍不能推論所有語言、音樂與裝置都同樣表現。
小數值格式降低佔用,下載包與授權要一起看
四位元解碼器由量化感知訓練支援,但沒有在這份模型庫獨立提供所有量化檔。量化感知訓練是在調整模型時就考慮低精度的影響,讓部署時降低數值精度有機會少損失一些品質。
公司報告,Q4_0 解碼器佔用可縮小約三點五倍,重建品質只有小幅變化。這個比例針對解碼器,不能改寫成整個語音模型或整台設備都少用同樣比例的記憶體。
十一月十六日查閱的模型卡,單獨提供 BF16 權重給 Transformers 使用。模型權重是模型學到的數值,程式載入它們後,才依相應架構進行編碼與解碼。
Q4_0、Q4_K_M 與 Q8_0 等量化解碼版本,則包在 LFM3-Audio 和 LFM3-Omni 的 GGUF 下載中,配合裝置端推論。不能因為文章列出幾種格式,就以為單獨編解碼模型庫有每一份檔案。
開放權重有其商業使用條件
模型卡採 LFM Open License v1.0,而非 Apache 或 MIT。條款列有年營收一千萬美元的商業使用門檻,超過門檻的商業使用,不能只依這張授權直接放行。
這使小型試驗、研究和大型商業部署需要分開核對。計畫把模型放進產品的團隊,應依自己的法律實體與使用方式查看原始條款,不把「可下載」當成所有規模都無限制使用。
權重能下載,不代表每個商業規模都適用同一張免付費授權。
先量整條語音回應,再決定是否替換編解碼器
實際試用應同時記錄編碼、模型生成、解碼與播放起點,才能找出使用者在等什麼。若大部分時間花在網路或模型產生內容,編解碼加速能改善的只是一部分。
因為接入格式會影響測試,第一輪可以用固定格式、相同內容的語音,比較還原聲音與處理時間。確認資料轉換正確之後,再接到生成模型,避免把取樣率或聲道設定問題誤判成模型品質不佳。
確認編解碼的輸入輸出正確後,才比較完整回應。保留使用者說完、第一段代碼出現、第一段聲音可播放,以及整句結束的時間,較容易知道等待是集中在開頭,還是播放途中會斷續。
因為不同內容會暴露不同錯誤,測試聲音也應接近日常使用。姓名、數字、英文夾雜中文,可能比一般朗讀更容易暴露錯誤。同時聽音質和核對內容,能避免自然的聲音掩蓋念錯資料。
部署到自己的設備後,再觀察其他工作同時進行的影響。官方單執行緒測試提供共同基準,但產品還可能同時處理麥克風、畫面或工具呼叫,需要量實際資源競爭。
這次公開值得注意的地方,是它把聲音表示和後續生成放在同一組比較裡。先找到自己的瓶頸,再決定改哪一層,會比直接把八十七倍當成產品承諾更有用。
讓延遲與音質都對上自己的語言和硬體,才有依據決定是否採用。
LiquidCodec 常見問題
只下載編解碼器,就能語音聊天嗎?
它負責聲音和代碼之間的轉換,還需要其他模型理解內容、決定回答與產生相應代碼。七千四百萬參數描述編解碼器,不是完整助手的全部規模。
八十七倍代表回答可以快八十七倍嗎?
這是特定硬體和精度下,音訊長度除以解碼時間的比值。完整回答還要等待編碼、模型生成和播放,不能沿用同一倍率。
可以拿來做音樂或歌聲嗎?
目前模型卡明寫以語音訓練與評估,沒有提供音樂、歌唱或環境聲品質結果。想用在這些內容,需要另行測試,不能把語音指標直接套用。
量化版解碼器在哪裡下載?
官方說明它們包在 LFM3-Audio 和 LFM3-Omni 的 GGUF 版本中。單獨的 Liquid-Codec 模型庫主要提供 BF16 權重,選檔案時要對應自己的推論工具。
如果你正在做本機語音,先用相同錄音與回應內容量出每一段等待,再回官方模型卡選擇相應版本。速度能否成為產品價值,要由你的語言、設備與完整流程共同確認。
延伸閱讀:Liquid AI 推出 LFM3:六款小模型處理文字、影像與語音,本機部署前先看什麼?
延伸閱讀:Shizuku-Duplex 是什麼?日語全雙工語音 AI 的官方評測怎麼看