MetaGPT 是什麼?GitHub 破 4 萬星多代理協作框架懶人包與 MetaGPT 教學:用軟體公司 SOP 解決 AI 鬼打牆
MetaGPT 是什麼?這篇 MetaGPT 教學深入拆解這款在 GitHub 突破 4 萬星的多代理協作框架,說明它如何將軟體公司的標準作業程序(SOP)寫進系統,讓產品經理、架構師與工程師依結構化文件交接,並比較它與 CrewAI、AutoGen 的差異與 Token 成本估算。

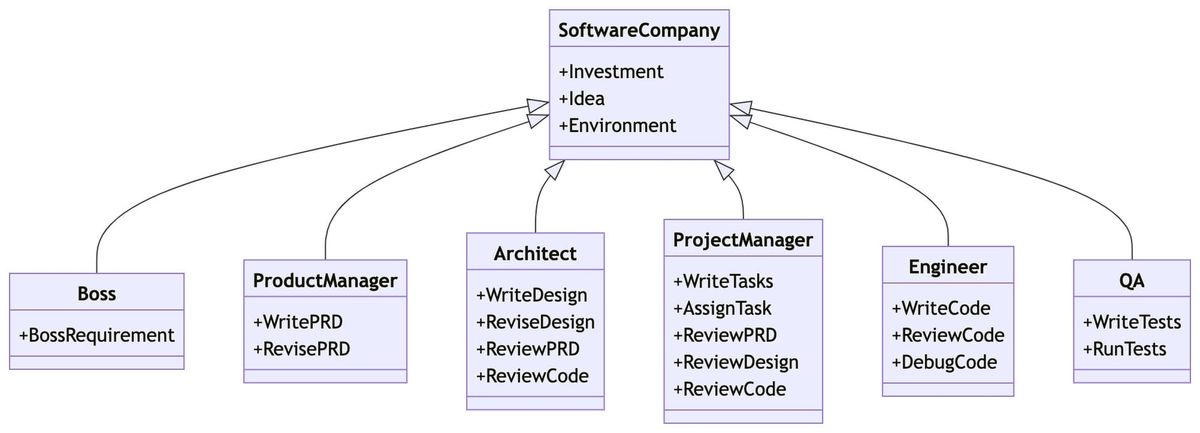
如果你曾經試過讓兩個以上的 AI 角色自由對話來寫出一個完整軟體專案,最後卻看著它們在聊天室裡互相客套、陷入死迴圈或嚴重偏離需求,這篇 MetaGPT 教學正是為了幫你解開這個僵局。
因為它不再讓多個語言模型毫無章法地隨意閒聊,而是直接把真實科技公司的標準作業程序與表單交接制度,搬進了多代理系統的核心架構裡。
許多剛接觸多代理(Multi-Agent)概念的讀者,常以為只要多開幾個對話框、分別給它們取名為產品經理跟工程師,它們就能自動合作寫出好程式。
其實如果沒有嚴格規定每一個角色必須產出什麼格式的設計圖與規格書,多個模型在傳遞自然語言對話時,只要經過三輪傳話就會產生嚴重的幻覺與資訊遺漏。
在過去,早期的開源自主代理專案往往只靠一句模糊的目標就不斷自我發問,結果燒光了幾十塊美金的額度,最後卻連一個能順利執行的小遊戲都跑不出來。
這也是為什麼由 DeepWisdom 團隊開源、在 MetaGPT 官方 GitHub 儲存庫累積突破 4 萬顆星並獲選頂尖學術會議 ICLR 口頭報告的框架,會成為多代理領域的里程碑。
因為它提出了著名的 Code = SOP(Team) 核心哲學,強制讓產品經理先寫出結構化的需求文件、架構師畫出系統介面圖,最後才交給工程師寫程式碼與跑測試。
這套多代理框架非常適合需要從零快速產出新產品原型、想要自動生成完整系統架構圖與技術文件,或是研究企業級多代理工作流的開發者與產品團隊。
但如果你只是想修改現有龐大舊專案裡的一兩行小錯誤,或是只想做簡單的每日新聞爬蟲摘要,那麼動用整間虛擬軟體公司的角色陣容反而會顯得殺雞用牛刀。
延伸閱讀:NVIDIA 投資指南:輝達 NVDA 做什麼、財報重點與美股購買教學
那麼為什麼讓多個 AI 自由聊天總是會失敗,而導入人類公司的標準作業程序又能如何徹底根治這個問題?
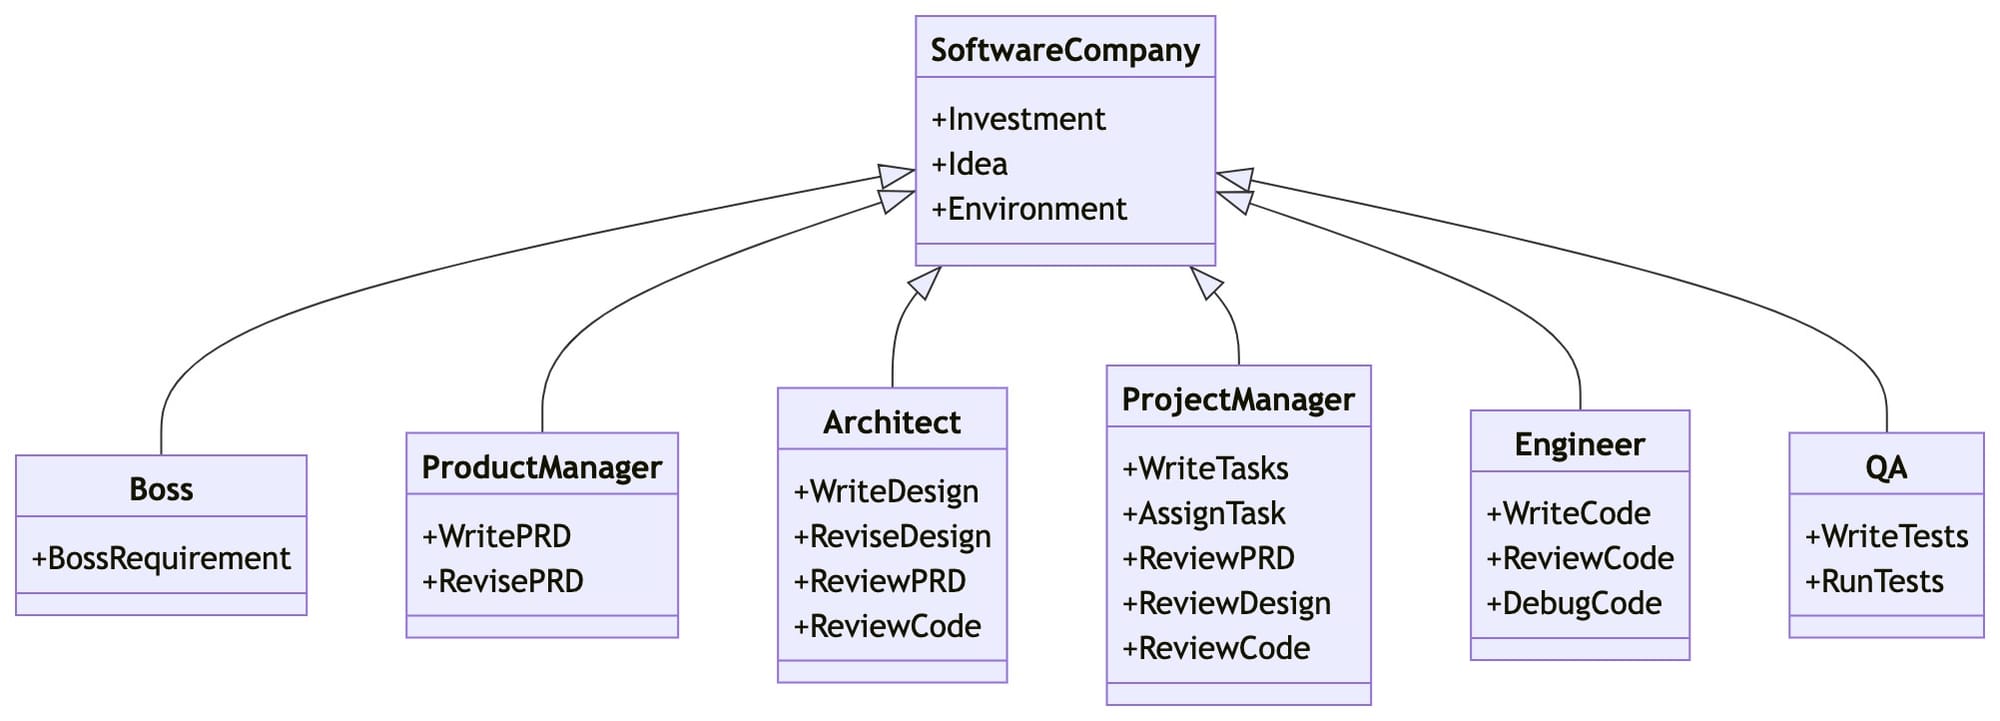
為什麼讓多個 AI 自由聊天寫程式總會鬼打牆?MetaGPT 的 SOP 哲學如何破局?
在任何一家超過十個人的真實軟體公司裡,老闆絕對不會只對著辦公室大喊一句「幫我做一個外送平台」,就放任所有員工自己去座位上憑感覺寫程式碼。
因為只要沒有先定義好使用者流程、資料表欄位與前後端溝通格式,每個人寫出來的模組合在一起時一定會徹底崩潰。
自由對話多代理的致命傷:傳話失真與無限迴圈
早期的多代理實驗框架,大多採用「非結構化的自然語言對話」作為角色之間唯一的溝通管道。
當第一個代理人講了一大段五百字的發想,第二個代理人接著用另一段五百字的感想回應時,真正重要的變數名稱與介面限制往往在第三輪對話就被稀釋掉了。
更糟的是,當兩個模型都被設定為要積極回應對方時,它們經常會陷入「你覺得這樣改好嗎」、「我覺得你的建議非常棒,我們開始吧」的無意義客套迴圈。
這種沒有明確驗收標準的自由聊天,不但每一步都在白白消耗昂貴的上下文額度,最後交給寫碼角色的指令也往往是一團模糊不清的文字。
核心公式 Code = SOP(Team) 與結構化產出物交接
為了解決這個混亂局面,MetaGPT 官方技術文件明確指出,人類軟體工程過去幾十年累積下來最寶貴的資產,其實就是標準作業程序(SOP)。
在這套框架裡,每一個角色都不准跟下一個角色隨便亂聊天,而是必須像真實工廠流水線一樣,填寫並交付標準化的「結構化產出物(Structured Outputs)」。
舉例來說,當你輸入一句「寫一個貪食蛇網頁遊戲」時,第一個接手的產品經理角色不能直接叫工程師寫程式,它必須先產出一份包含競品分析、用戶故事與功能清單的標準 PRD 文件。
接著,架構師角色會去訂閱並讀取這份 PRD 文件,然後轉化為明確的系統模組架構圖、類別定義表與檔案目錄清單,再交給後面的工程師按圖施工。
透過把模糊的聊天紀錄強制收斂成一張張格式固定的表格與設計圖,系統從根本上切斷了多輪傳話造成的幻覺累積,讓每一個代理人都知道自己該做什麼、做到什麼程度算完成。
拆解虛擬軟體公司的五大角色與 MetaGPT 教學:從一行需求到完整專案怎麼跑?
理解了標準作業程序的威力後,接下來這段 MetaGPT 教學要帶你實際走進這間虛擬軟體公司,看看裡面的五個核心員工是如何分工合作的。
因為只要你在終端機輸入一行啟動指令,這五個角色就會按照嚴格的先後順序自動接力,並在你的硬碟裡生成一整個資料夾的工程資產。
產品經理、架構師與專案經理的前期規劃流水線
整個流水線的第一棒是「產品經理」,它的職責是把人類輸入的一句簡短想法,擴寫成嚴謹的商業與產品需求規格。
它會自動列出這項產品的核心目標與優先級排序,甚至還會在文件裡用 Mermaid 語法畫出第一版的商業競爭象限圖。
第二棒接手的是整間公司的靈魂人物「架構師」,它會仔細閱讀產品經理留下的規格書,並決定整個專案要用什麼技術堆疊來實作。
架構師會畫出完整的系統序列圖與類別圖,並明確定義出專案裡每一個檔案的路徑名稱、每一個函式的輸入參數與回傳型別。
第三棒則是「專案經理」,它會拿著架構師畫好的藍圖,把整個系統拆解成一顆顆有明確先後依賴關係的開發任務包,分配給底下的工程師去執行。
工程師寫碼、QA 寫測試與環境安裝實戰
到了第四棒「工程師」登場時,它其實已經不需要去猜測任何產品邏輯了,因為架構師已經把每一個檔案的骨架與介面都規定得一清二楚。
工程師只需要專注在按照規格書把每一個 .py 或 .js 檔案裡面的具體函式邏輯填滿,這讓單一檔案的程式碼生成準確率大幅飆升。
最後第五棒則是「品質保證工程師」,它會針對前面寫好的每一個程式碼檔案自動撰寫對應的單元測試腳本,並實際在環境中執行測試,把報錯的地方退回給工程師修正。
要在你的電腦上啟動這間虛擬公司非常簡單,你只需要在具備 Python 環境的電腦上執行 pip install metagpt,接著執行 metagpt --init-config 建立設定檔。
打開家目錄底下的 config2.yaml 檔案,填入你申請好的雲端模型 API 金鑰來串接模型介面,最後在終端機輸入 metagpt "Create a 2048 game",就能親眼看著整間公司開始運轉。
當程式跑完之後,你打開專案底下的 workspace 資料夾,除了可以直接執行的遊戲原始碼之外,還會看到一整套可以直接拿去交差的高品質 Markdown 架構圖與需求文件。
三大主流多代理框架怎麼選?與 CrewAI、AutoGen 的適用場景大比拼
很多準備把多代理技術導入工作流的工程師,常常會在它與另外兩款同樣破萬星的熱門框架 CrewAI、微軟 AutoGen 之間猶豫不決。
其實這三套框架的設計哲學完全不同,選錯工具不但會讓你寫出極難維護的程式碼,還會白白浪費大量的開發時間。
軟體工程流水線 vs 通用商業任務 vs 靈活對話實驗
這套虛擬軟體公司框架從誕生的第一天起,就是為了「嚴謹的軟體開發與複雜結構化文件產出」而量身定做的。
它內建了完整的发布與訂閱(Pub/Sub)訊息池機制,每個角色只從共享訊息池裡撈取自己關心的上游文件,非常適合需要嚴格遵守工程規範與資料結構的任務。
而 CrewAI 則比較像是一個輕量好上手的「通用型商業行政小隊」,你只需要用幾行簡單的設定就能定義出「市場調查員」與「部落格寫手」兩個角色,非常適合拿來做行銷文案生成、自動化客服分類或日常資料整理。
至於微軟開源的 AutoGen,則是一套極為底層且靈活的多代理對話互動實驗室,允許開發者自由定義代理人在什麼條件下互相對話與執行程式碼。
這套工具非常適合學術研究或高度客製化的複雜推理實驗,但初學者自己設計流程時也比較容易遇到對話失控的問題。
以下我把這三大主流開源多代理框架在核心設計理念、上手難度、結構化管控能力與最佳適用場景上的差異整理成表格:
| 比較項目 | MetaGPT | CrewAI | Microsoft AutoGen |
|---|---|---|---|
| 核心設計哲學 | Code = SOP(Team),強制依結構化文件與設計圖交接 |
角色扮演與任務委派,強調直覺的循序或階層式協作 | 對話式代理(Conversable Agents),高度自由的多方互動 |
| 內建預設角色重心 | 完整內建產品經理、架構師、專案經理、工程師與 QA | 無固定領域預設,由使用者自行用白話文定義各行各業角色 | 提供通用助理與程式碼執行代理,需自行編排對話拓撲 |
| 防止鬼打牆管控力 | 極高,透過標準表單與訊息池隔離無效閒聊 | 中高,依賴清楚的任務描述與預期輸出格式定義 | 中等,若終止條件沒寫好,較容易在雙向對話中無限循環 |
| 開發者上手門檻 | 中等,預設指令極簡單,但自訂新 SOP 需理解動作節點架構 | 極低,幾十行 YAML 或 Python 就能跑起商業工作流 | 較高,介面與架構改版較快,適合有經驗的工程師深度客製 |
| 最佳適用場景 | 軟體原型生成、系統架構圖自動化、高複雜度工程流水線 | 內容行銷產製、競品情報搜集、日常跨工具辦公自動化 | 學術研究實驗、數學與資料科學探索、特殊對話拓撲設計 |
從表格中可以清楚判斷,如果你要解決的是寫程式、畫架構圖或需要高度標準化表單交接的任務,選這套 SOP 框架最穩健。
但如果你只是想做一個每天自動幫你抓新聞並寫成社群貼文的機器人,那麼輕量級的 CrewAI 會讓你更快收工下班。
跑一次虛擬軟體公司要花多少錢?API 串接成本估算與自訂 SOP 進階技巧
雖然看著五個 AI 員工在螢幕上自動畫架構圖、寫出好幾百行程式碼非常過癮,但身為精打細算的使用者,你一定得先算清楚請這群虛擬員工上班一次到底要付多少薪水。
因為多代理系統最讓人詬病的隱形成本,就是多個角色在傳遞長篇設計文件時所產生的龐大字數消耗。
不同模型搭配下的單次專案 Token 消耗與費用對照
當你下達一個中等規模的軟體開發指令時,五個角色從撰寫 PRD、繪製多個 Mermaid 架構圖、生成五到八個程式碼檔案再到跑完單元測試,整個過程大約會發起 15 到 30 次的模型呼叫。
加總起來,單次完整跑完一個中小型專案的輸入與輸出總量,通常會落在 5 萬到 15 萬個 Token 之間。
如果你在設定檔裡全部串接最昂貴的頂尖商業旗艦模型,跑一個小遊戲專案大約會花掉你 0.5 到 2 美元(約台幣 16 到 65 元)左右的額度。
為了大幅壓低日常實驗的開銷,許多資深玩家會採取「高低階模型混搭」或是改接高性價比的程式碼專用模型,甚至連接本機已經下載好模型權重的免費開源模型。
所謂的模型權重,就是語言模型訓練完成後的核心參數,只要你的工作站擁有足夠的顯示卡記憶體並把 32B 以上的模型下載到本機,就能透過相容介面讓整間虛擬公司完全免費幫你打工。
以下我把三種不同模型串接策略在跑完單一軟體專案時的預估費用、程式碼成功執行率與適用階段整理成表格:
| 模型串接配置策略 | 單次專案預估 API 成本 | 結構化圖表與程式碼成功率 | 最適合的應用階段 |
|---|---|---|---|
| 頂級商業模型(如 Claude 3.5 Sonnet / GPT-4o) | 約 $0.50–$2.00 美元(約台幣 16–65 元) | 極高,JSON 格式與 Mermaid 圖表幾乎不報錯 | 正式專案原型開發、複雜系統架構設計與客戶提案展示 |
| 高性價比模型(如 DeepSeek-V3 / GPT-4o-mini) | 約 $0.03–$0.15 美元(約台幣 1–5 元) | 中高,偶爾需微調格式,但性價比極為突出 | 日常頻繁測試 SOP 流程、大量批次生成基礎腳本與文件 |
| 本機開源模型(如 Ollama 跑 Qwen-2.5-Coder-32B) | $0 美元(僅消耗本機電力與硬體折舊) | 中等,極度依賴模型對結構化輸出的遵循能力 | 企業內網機密專案規劃、無預算限制的離線多代理實驗 |
從上表可以看出,平常在調整提示詞與測試流程時,先用每次不到五塊台幣的高性價比模型跑通邏輯,等到要產出正式架構與高品質程式碼時再切換回頂級模型,是最聰明的省錢法則。
延伸閱讀:RTX 5080 16GB 跑本地 AI 夠用嗎?量化模型與顯存實測指南
從單純寫軟體擴展到各行各業:自訂 Role 與 Action
很多人以為這套框架只能拿來寫軟體,但其實它底層的角色與動作類別是可以讓你完全自由改寫的。
在官方近期的更新中,還加入了名為 AFlow 的自動化工作流最佳化架構,以及專門處理大量數據分析的資料直譯器角色。
你可以仿照軟體公司的交接邏輯,用幾十行 Python 程式碼定義出一間「虛擬產業研究機構」。
讓第一個角色專門負責執行動作去抓取財報數據並輸出標準表格,第二個角色訂閱該表格並執行財務比率驗算動作,第三個角色再根據驗算通過的表格撰寫研究報告。
只要把你自己行業裡最花時間的標準作業程序拆解成明確的動作節點與交接表單,這套框架就能變成你專屬的自動化生產線。
結語:多代理時代的決勝點不在模型多會聊,而在你能不能把經驗寫成 SOP
回頭審視這波多代理框架的演進,我們越來越清楚地看到,單靠把幾個語言模型湊在一起自由發揮,永遠無法做出能穩定上線的企業級應用。
這款突破 4 萬星的開源專案給我們最大的啟發,就是「先有清楚的人類標準作業程序,才會有可靠的 AI 協作團隊」。
如果你是軟體工程師、系統架構師或是經常需要規劃新產品的技術PM,我非常推薦你今天就在電腦上安裝這套框架,實際用一行指令跑一次專案生成。
就算你最後不直接使用它寫出來的全部程式碼,光看它那位虛擬架構師在幾十秒內幫你畫出來的序列圖、類別圖與檔案介面定義,就已經能幫你省下大半天從零畫設計圖的苦工。
當你開始習慣把腦袋裡的專業經驗轉化為結構化的交接表單與動作節點時,你就已經掌握了駕馭未來 AI 虛擬團隊最核心的管理密碼。
常見問題(FAQ)
Q1:完全不會寫程式的人,也能照著這篇 MetaGPT 教學生成直接上架賺錢的商業 App 嗎?
老實說,目前的技術還做不到完全零程式基礎就直接生成複雜且零錯誤的大型商業系統。
照著這篇 MetaGPT 教學執行一行指令,確實能幫你快速產出完整的產品需求文件、系統架構設計圖,以及數百行可運行的小型網頁遊戲或工具原型程式碼。
但如果要把它變成能承受真實用戶流量的商業產品,依然需要具備基礎工程能力的開發者進場接手,把生成的骨架與資料庫、金流及資安防護整合在一起。
Q2:為什麼我在終端機執行專案生成時,跑到一半會跳出 JSON 解析錯誤或格式失敗?
這是因為框架為了確保角色之間交接不失真,會嚴格要求語言模型必須按照指定的結構化格式(如 JSON 或特定 Markdown 區塊)輸出文件。
如果你串接的是參數規模太小的本地模型(例如 7B 或 8B 模型),或是對長指令遵循能力較弱的舊版模型,它們很容易在輸出長篇設計圖時漏寫一個括號而導致解析中斷。
遇到這種情況時,建議在 config2.yaml 設定檔中改接對結構化輸出支援極佳的 Claude 3.5 Sonnet、GPT-4o 或 DeepSeek-V3,就能大幅減少中途報錯的機率。
Q3:如果我不想要五個角色全部跑完,可以只請它的「產品經理」與「架構師」幫我寫文件和畫圖嗎?
完全可以,這也是許多資深工程師在實務上最常使用的高效率偷吃步。
你可以在啟動指令或 Python 腳本中透過參數控制,或是設定在架構師產出系統設計文件後就停止執行,略過後面最消耗字數的工程師寫碼與測試階段。
這樣一來,你每次只需要花費幾毛錢台幣的微量額度,就能在兩分鐘內獲得一份包含競品分析、Mermaid 序列圖與資料結構定義的專業技術規格書草稿。
Q4:這套多代理框架跟前陣子很紅的 OpenHands(原 OpenDevin)有什麼不一樣?
這兩套工具雖然都能寫程式,但它們切入的維度完全不同。
OpenHands 比較像是聘請「一位擁有獨立 Docker 電腦沙盒的實戰全端工程師」,強項在於自己操作終端機、在現有專案裡找 Bug、跑測試並自我修正到通過為止。
而這套多代理框架則像是組建「一整個包含 PM 與架構師的軟體規劃團隊」,強項在於從零開始把一句模糊的想法,按部就班展開成完整的需求文件、架構設計圖與初始專案骨架。
Q5:如何把生成的 Mermaid 架構圖與 PRD 文件轉成好看的圖片或簡報跟同事分享?
系統在執行完畢後,會把所有的需求與架構設計存放在專案輸出目錄的 docs 資料夾底下,格式皆為標準的 Markdown 文字檔。
你只要用 VS Code(安裝 Mermaid 預覽外掛)、Notion、Obsidian 或是直接把區塊貼到免費的 Mermaid Live Editor 線上工具,那些文字程式碼就會瞬間渲染成精美的流程圖與序列圖。
你還可以開啟框架內建的文件匯出選項,直接將這些產出物一鍵轉換為 PDF 或 Word 檔案,馬上就能帶進下午的專案啟動會議裡討論。



