Microsoft-Decision-1 公開預覽:AI 客服分流,為什麼不必先寫一段答案?
Microsoft-Decision-1 在 Foundry 開放公開預覽,專做預設選項的分類與分流。本文用客服案例說明它與生成模型的分工,以及導入前要驗證的準確率、延遲與成本。

AI 客服每收到一則訊息,常得先決定要交給誰,再開始回答。
Microsoft-Decision-1 想處理的,就是前面這個選擇。
微軟在 10 月 9 日介紹這款決策模型,並將它放進 Foundry 模型目錄的公開預覽。
它從事先定義的選項做判斷,適合分類、分流與控制工作流程。
這讓企業有機會把大量小決定交給專門模型,再把需要完整推理的工作交給其他模型。
評估重點是整條流程能否更快完成,單次模型回應只是其中一部分。
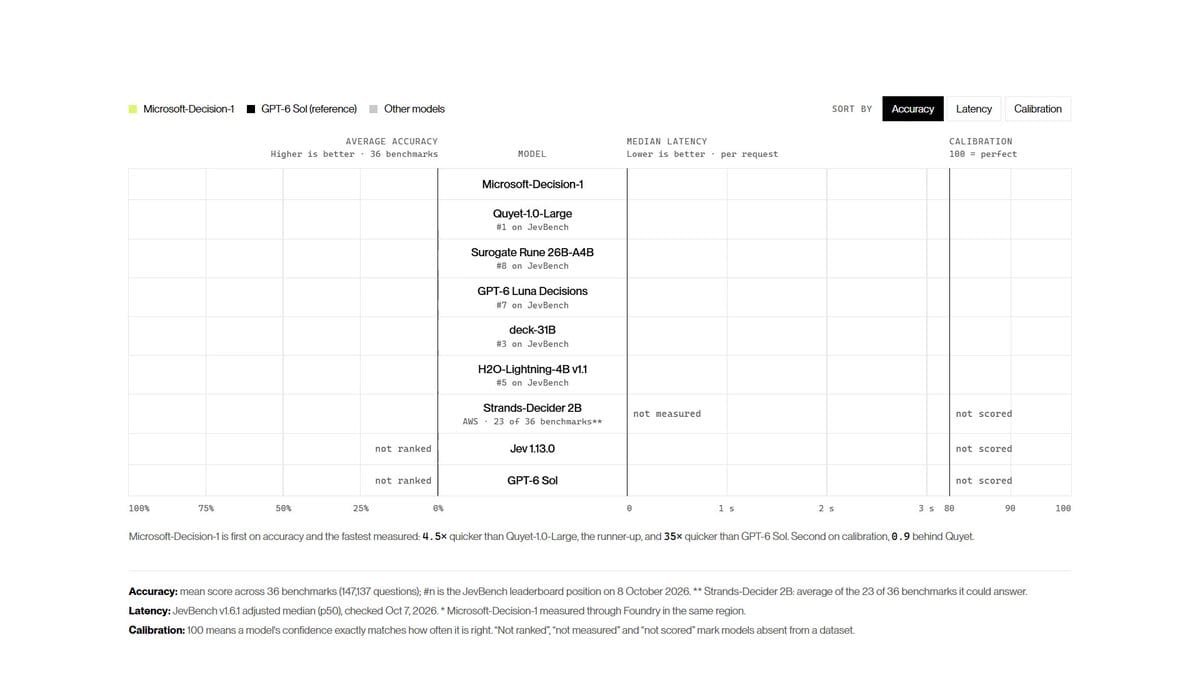
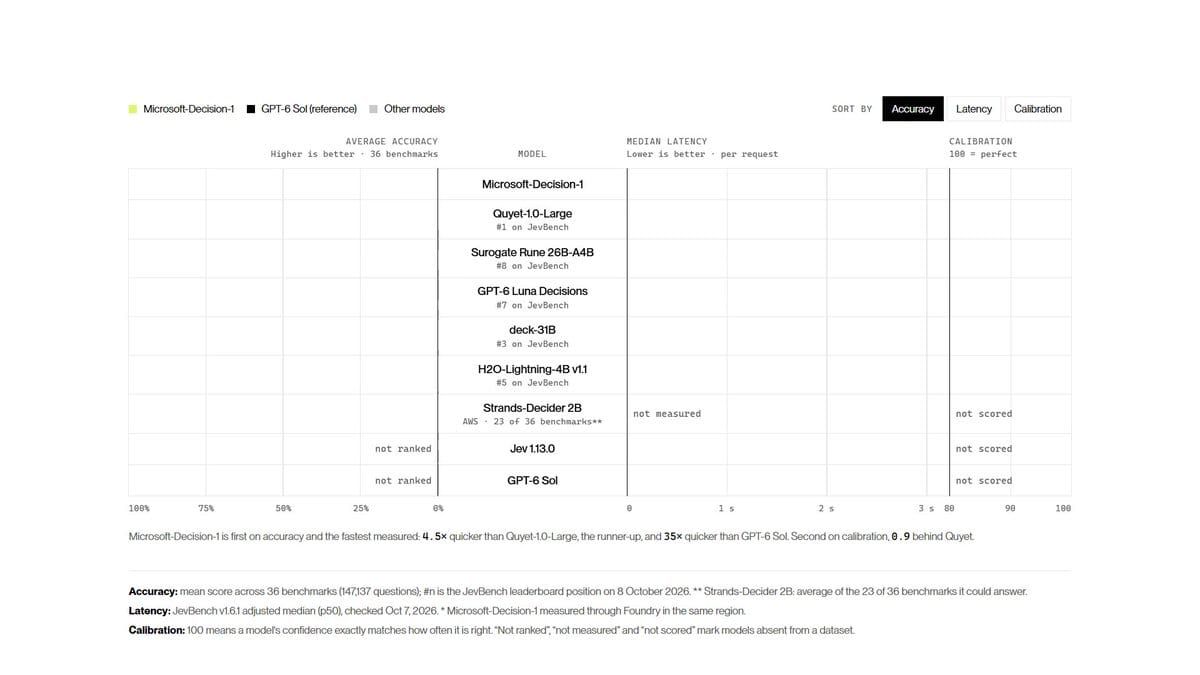
Microsoft-Decision-1 把「選下一步」獨立出來
決策模型可以想成負責分流的值班人員:讀完內容,從可用選項中挑出適合的下一步。
官方文件說明,Microsoft-Decision-1 建立在 Qwen3.5-9B 上,會提供預設答案與信心訊號。這些輸出比較容易接進應用程式的規則。
例如客服訊息可以分成帳務、技術與帳號問題。分類完成後,系統才決定由哪個團隊或模型處理。
這和請聊天模型寫一段解釋有不同目的。當應用程式只需要一個分類,多寫的文字可能增加解析工作,也讓輸出格式更難穩定。
但選項必須先設計好。若使用者同時反映扣款錯誤與登入失敗,系統需要明確的優先規則,不能只依賴模型猜測。
因此,決策模型的效果也反映企業是否把自己的流程講清楚。
客服分流可以怎麼測,才不被漂亮展示誤導?
適合的起點是一個範圍小、已有人工處理結果的任務。
假設團隊要試客服分流,可以挑一批已去識別化的歷史訊息,保留人員最後決定的目的地,作為比較標準。
測試資料應包含容易分類的訊息,也要有語意含糊、跨部門或需要升級處理的例外。
接著比較分類正確率、錯誤類型與整體等待時間。把急件送錯地方的代價,可能遠高於普通訊息多等幾秒。
官方也建議驗證信心訊號的校準程度。白話來說,要確認模型自稱有把握的時候,實際是否真的比較常答對。
只有自己的資料支持這個關係,才適合把信心門檻拿來決定自動處理或轉人工。
微軟的內部案例,能說明什麼?
微軟表示,Xbox Research 曾用它整理超過一萬則開放式意見,在該案例回報了可與 GPT-5 競爭的品質與更快的速度。
這支持了專門決策模型在重複分類工作的用途,但沒有建立所有任務都能等比例加速的結論。
客服、內容審查與研究回饋的選項數、資料長度和錯誤代價不同,不能直接共用一個成功數字。
而且模型呼叫只是流程的一部分。資料庫查詢、權限檢查與後續工具執行,仍可能是主要等待來源。
企業應比較每件任務完成的總成本,包括重新分類、人工覆核和錯誤處理,而不是只比較單次請求的帳單。
這也說明瞭為什麼公開預覽適合先做受控試驗:模型能力可以測,企業自己的例外流程也能一起補齊。
從小範圍分類,走向可靠的工作流程
導入時可以先讓模型提出分類建議,由既有流程照常處理,再觀察它和人工判斷的差異。
若結果穩定,再把低風險、明確的分類逐步自動化。模糊個案則保留人工或另一個模型覆核。
應用程式還要檢查回傳選項是否合法、失敗時要怎麼重試,以及超時後是否能回到原本流程。
這些控制可以讓工具錯誤停在分類階段,避免一路傳到付款、刪除或對外發送等後續動作。
目前官方定位是公開預覽,使用仍涉及部署與適用費用。選型前應確認自己的訂閱、區域與工作負載支援情況。
把生成、推理與決策分開,帶來的是更細的設計空間。可靠度仍要靠實際資料與系統規則建立。
常見問題
它可以取代聊天模型嗎?
它主要處理預設選項的選擇。需要撰寫內容、討論需求或進行較複雜推理時,仍應搭配適合的生成模型。
信心高就能直接自動執行嗎?
先驗證自己的資料是否支持這個信心值。涉及高代價的動作,也需要應用程式獨立檢查與覆核。
現在適合全面換掉客服分流嗎?
先用一個明確任務比較現有方式與新模型,確認準確率、例外處理和總成本,再決定擴大範圍。
結語
Microsoft-Decision-1 的意義,是讓「下一步怎麼選」成為可以獨立衡量的工作。若想評估它,從一份有標準答案的客服分流資料開始,比照抄官方倍速更有幫助。
延伸閱讀:Drex 1.5 開放權重:讓本機模型回傳選項機率,怎麼做客服分流?
延伸閱讀:Unsloth 讓小模型學會做決策:4GB 顯示記憶體能訓練什麼,74.3% 又代表什麼?