NVIDIA AIPerf 是什麼?看懂 AI 推論延遲、吞吐量與多人使用效能
NVIDIA AIPerf 是生成式 AI 推論測試工具,可量測首字等待時間、輸出速度、延遲分布與併發負載。本文整理重要指標,說明如何避免只用每秒 token 比較 AI 服務。

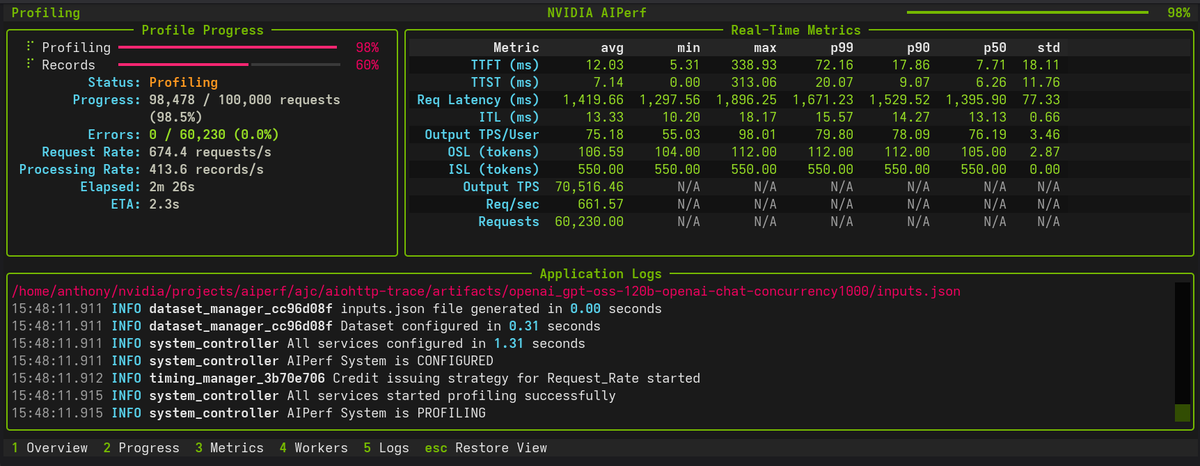
AIPerf 是 NVIDIA 生態系中的生成式 AI 效能測試工具,能向模型服務送出一組請求,記錄使用者等待多久、答案生成多快,以及同時多人使用時的表現。它測量的是整個服務的推論效能,適合評估部署方式是否符合應用需求。
近日 X 上的開發者分享了 AIPerf,讓「AI 速度」這個常見問題重新回到測試方法。聊天畫面看起來很快,可能只是請求較短或只有一位使用者;正式服務還要處理長文件、尖峰流量與少數特別慢的請求。
AIPerf 可以測試哪些服務
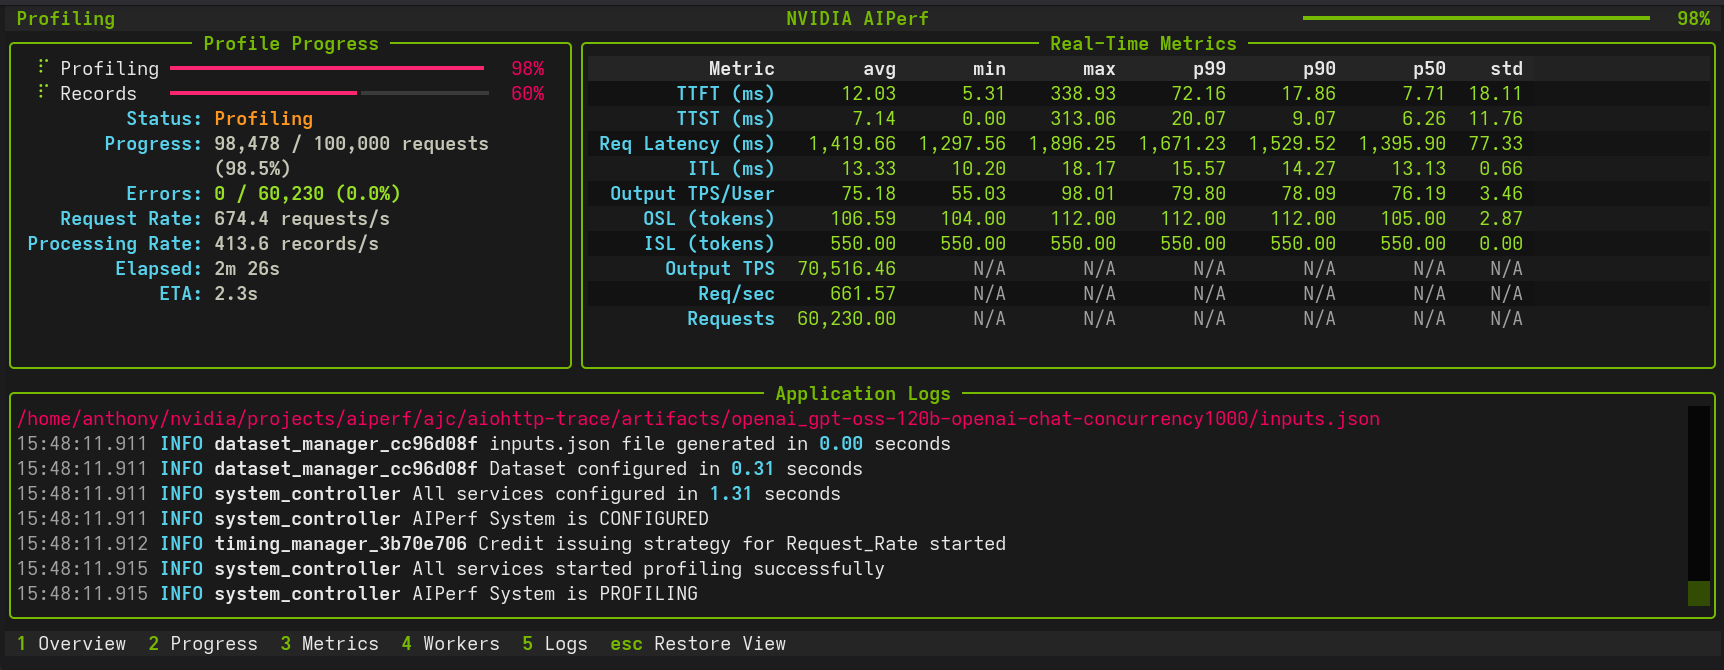
依官方儲存庫,AIPerf 支援多種端點與測試資料,包括 OpenAI 相容的聊天介面、文字生成,以及嵌入、音訊和影像等類型。端點是提供模型服務的網路入口,工具會依對應格式送出請求。
官方入門範例使用 Ollama 建立本地模型服務,再由 AIPerf 發送測試。正式評估時,也可以改用自己的推論伺服器與工作負載。工具提供命令列顯示、報表與匯出資料,方便把不同配置放在相同條件下比較。
四個指標,看見使用者真正的等待
Token 是模型處理文字的單位,可能是一個字、部分單字或符號。每秒 token 數能描述輸出速度,但還不能完整反映體感。
| 指標 | 意義 | 對使用者的影響 |
|---|---|---|
| 首個 token 時間 | 從送出請求到開始輸出 | 按下送出後等多久 |
| token 間隔 | 相鄰輸出單位的時間 | 文字出現是否順暢 |
| 請求總延遲 | 完成一整個回應的時間 | 任務多久做完 |
| 吞吐量 | 一段時間可處理的總工作 | 同時服務多少使用者 |
p99 是第 99 百分位的延遲,可理解為約 99% 請求會落在這個時間以內。平均值可能很漂亮,p99 卻很高,表示少數使用者仍會等很久。
併發量和請求頻率有什麼差別
併發量是同時進行中的請求數;請求頻率是每秒送進多少新請求。AIPerf 提供這些不同負載模式,也支援逐步增加負載與重播請求軌跡。
假設客服助理平常只有少數人使用,活動開始後卻有大量詢問湧入,只測單人回答速度就容易漏掉排隊問題。比較服務時,應讓輸入長度、輸出長度、負載模式和模型設定一致,再觀察延遲是否隨人數快速上升。
官方範例數字為什麼不能當排行榜
README 明確標註,範例輸出來自僅使用 CPU 的執行,並非官方效能基準。它的作用是教讀者看報表,不能用來判斷哪張 GPU 或哪個模型最快。
同樣的模型,在不同硬體、推論引擎、快取狀態與提示長度下,結果都可能改變。測試報告應記錄這些條件,並確認暖機是否完成。暖機是先讓服務載入模型與建立必要狀態,避免把初次啟動的等待和穩定運作混在一起。
我的判斷是,小團隊可以先用最常見的三種真實請求建立測試集,再增加併發量。這比先追求複雜的測試參數更能回答產品問題,也比較容易看出改動究竟改善了哪一類任務。
常見問題
AIPerf 會讓模型變快嗎?
它負責量測與分析。改善速度仍需要調整硬體、推論設定、快取或應用設計。
吞吐量高,聊天一定比較順嗎?
不一定。系統可能提高總處理量,卻讓每個人的首字等待或輸出間隔增加。
可以測正式服務嗎?
可以測可存取的服務,但負載測試應依服務容量規劃。先從測試環境與低負載開始,能避免干擾正常使用。
結語:先定義體驗,再決定效能目標
AIPerf 的價值,是把「感覺很快」變成能比較的資料。聊天助理、文件摘要和批次處理各有不同需求,先決定可接受的等待時間,再看指標,才能選到適合產品的配置。