OpenAI 推出 GPT-6 Sol、Luna 永久降價,API 價格砍半
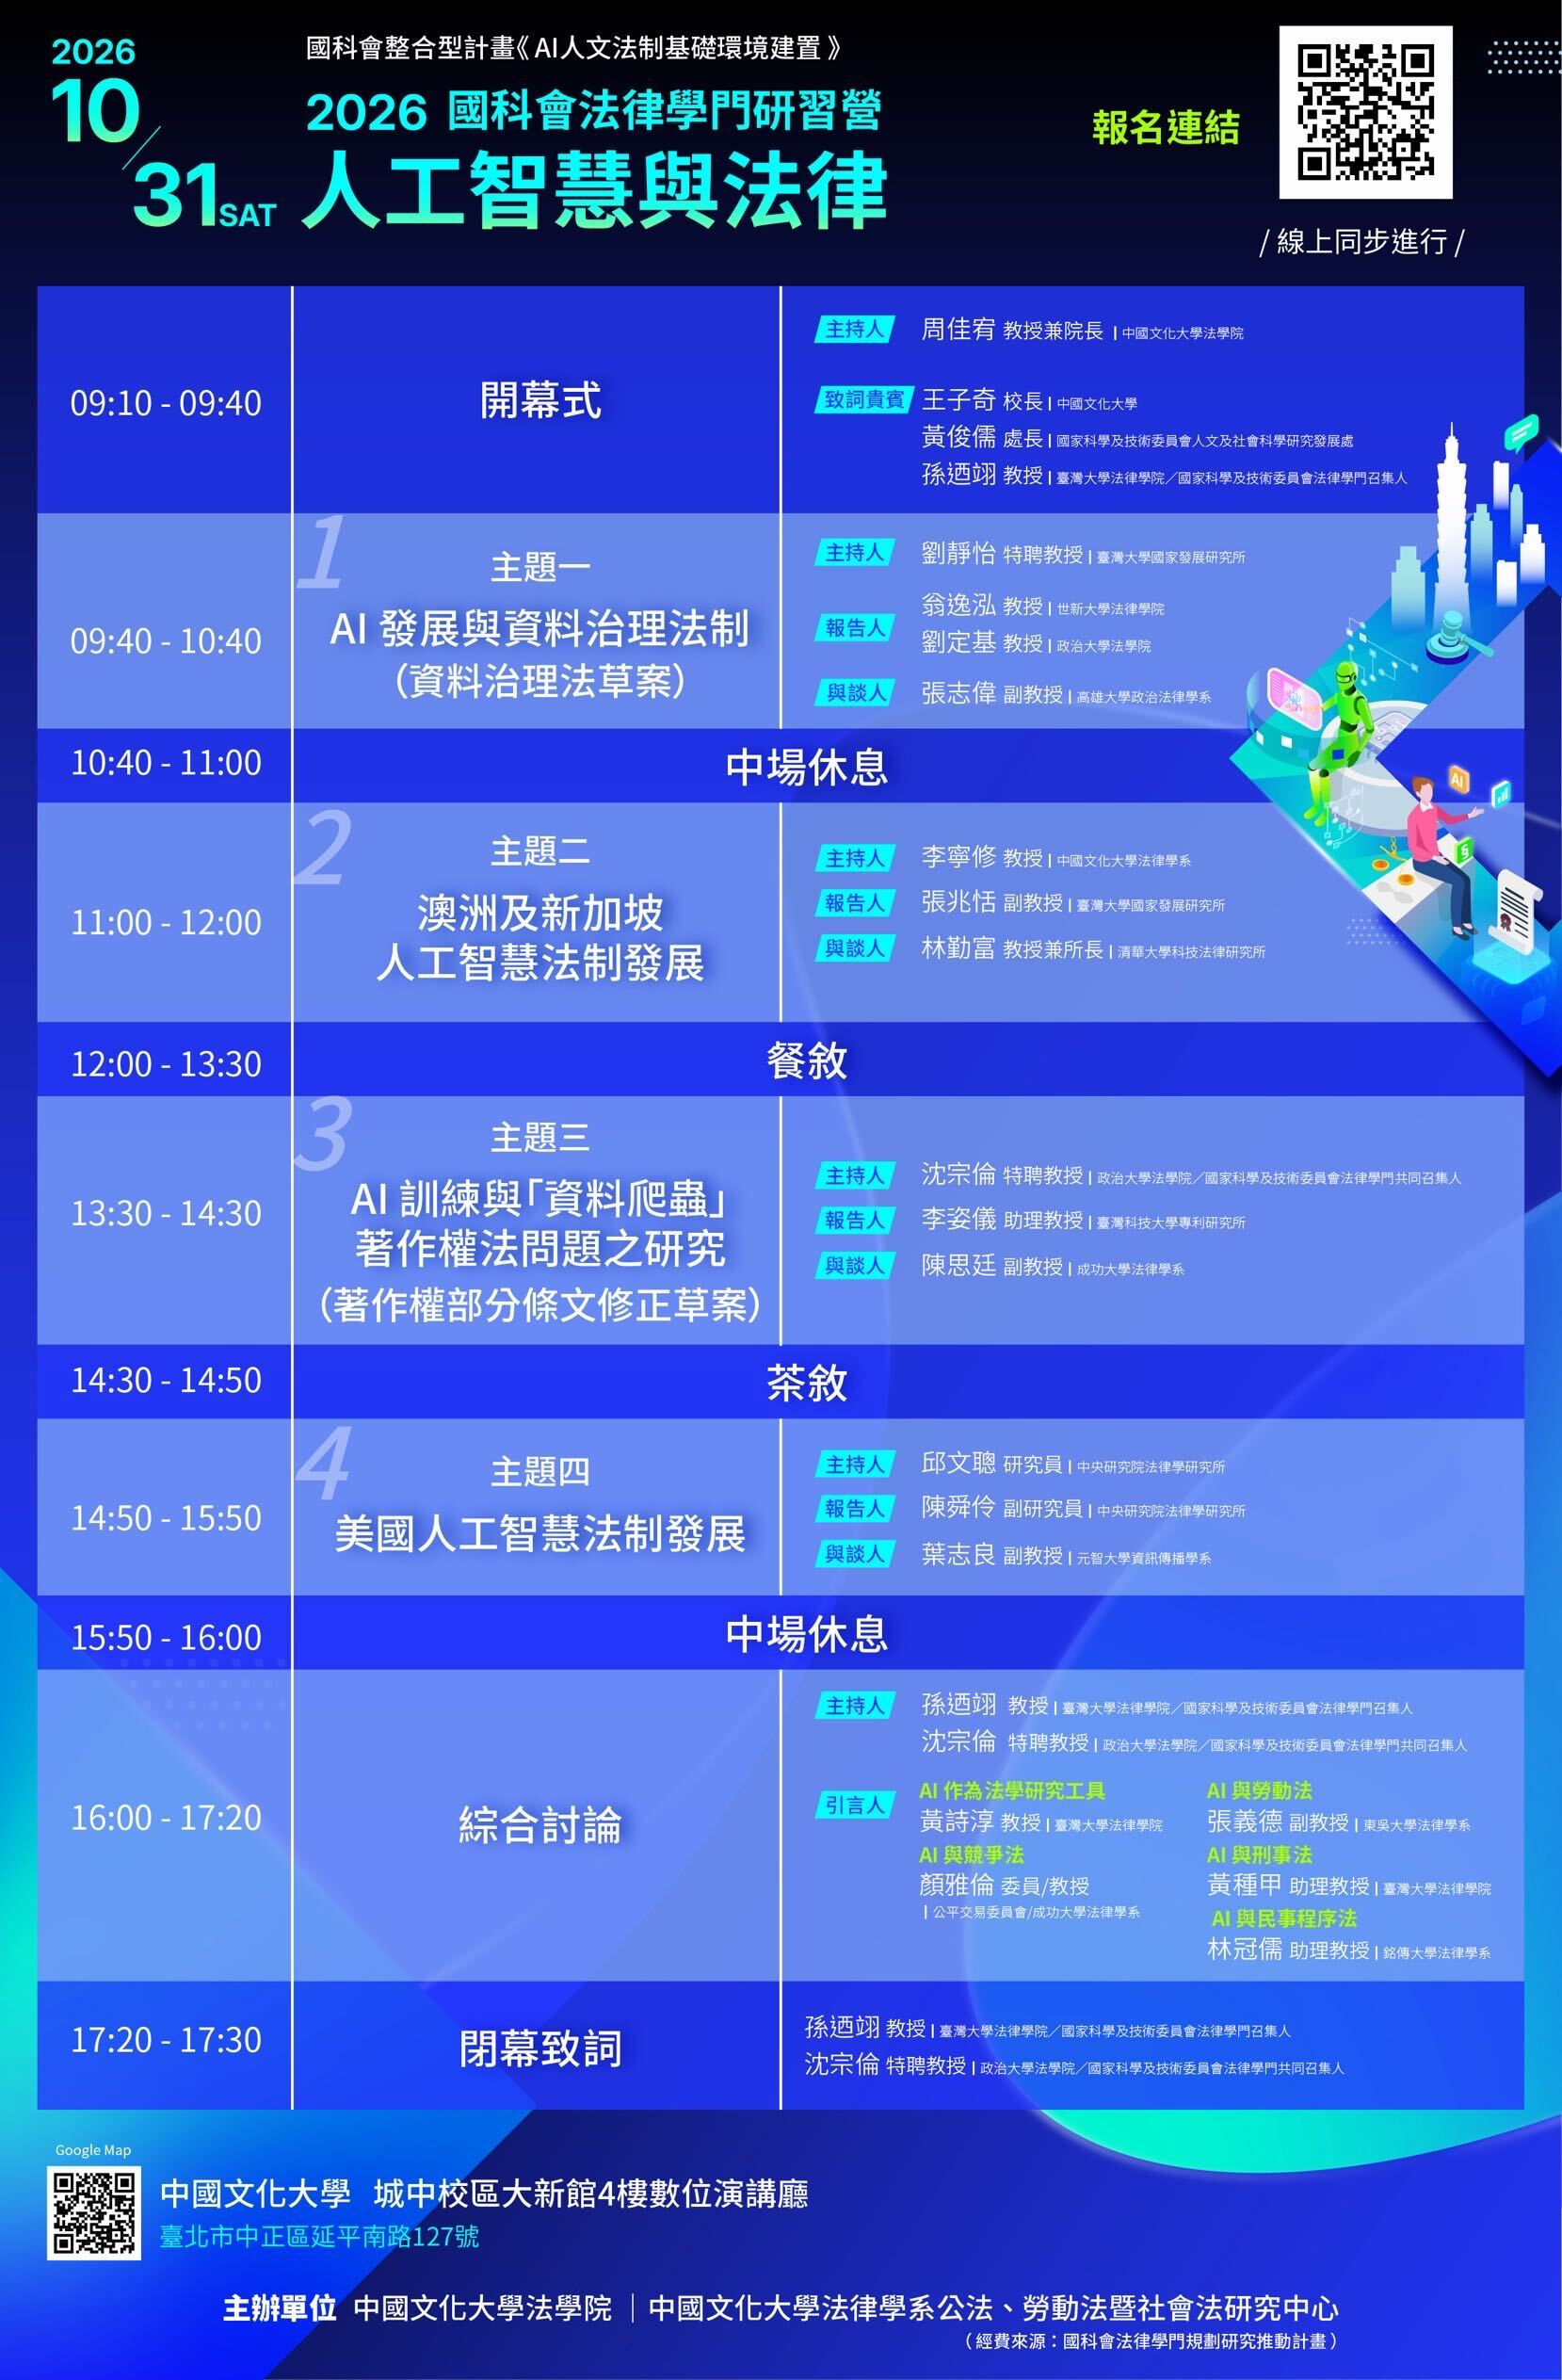
這週想推薦大家一場比較不一樣的活動。我們平常都在追 AI 又變強多少、又能幫忙做什麼,但當自己的文章、圖片成為訓練資料,或是開始想用 AI 接案、做產品、把內容拿去賣,應該就會開始在意:哪些資料可以用?做出來的東西,權利又算誰的?
我自己覺得,如果未來想透過 AI 賺錢,除了研究工具和商業模式,也值得先了解相關的法律問題,總不能等收到存證信函才開始補課 XD。10 月 31 日的「人工智慧與法律」研習營,會聊到 AI 訓練、資料爬蟲與著作權,也會介紹不同國家的 AI 法制發展。有興趣的朋友可以看看議程,活動在文化大學城中校區舉行,也有線上同步。
本週焦點事件
- GPT-6 Sol、Luna 永久降價:單價砍半,帳單未必少一半
- 國外爆紅的 Jev 紅在哪?從分類 100 封信,到每秒做 10 次決策玩 Doom
- 用 AI 畫出下一個 40 年,技嘉 NEXT40 創作比賽首獎 6 萬元!
- 資安新創靠 Claude 駭進 OpenAI 的內部程式庫?
- Qwen 4 的誕生靠舊的 AI?阿里讓 Qwen 3.8 參與下一代模型的研發
- AI 竟然會感覺到痛?
OpenAI 推出 GPT-6 Sol、Luna 永久降價,API 價格砍半
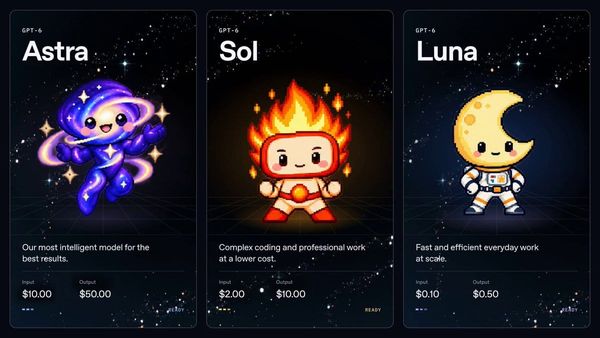
OpenAI 在 9 月 22 日(台灣時間 9 月 23 日)推出 GPT-6 Sol 與 Luna,補齊旗艦 Astra 之下的兩個價格帶。距離 Astra 上線還不到三週,GPT-6 已經形成高、中、低三層產品線。
如果 Astra 是留給最難任務的旗艦,Sol 就是接複雜程式與專業工作的主力,Luna 則專門應付大量、重複、對錯誤容忍度較高的任務。OpenAI 官方發布時直接畫出一張「什麼任務該用哪一款」的對照圖,等於先幫開發者把選型作業寫好了草稿。
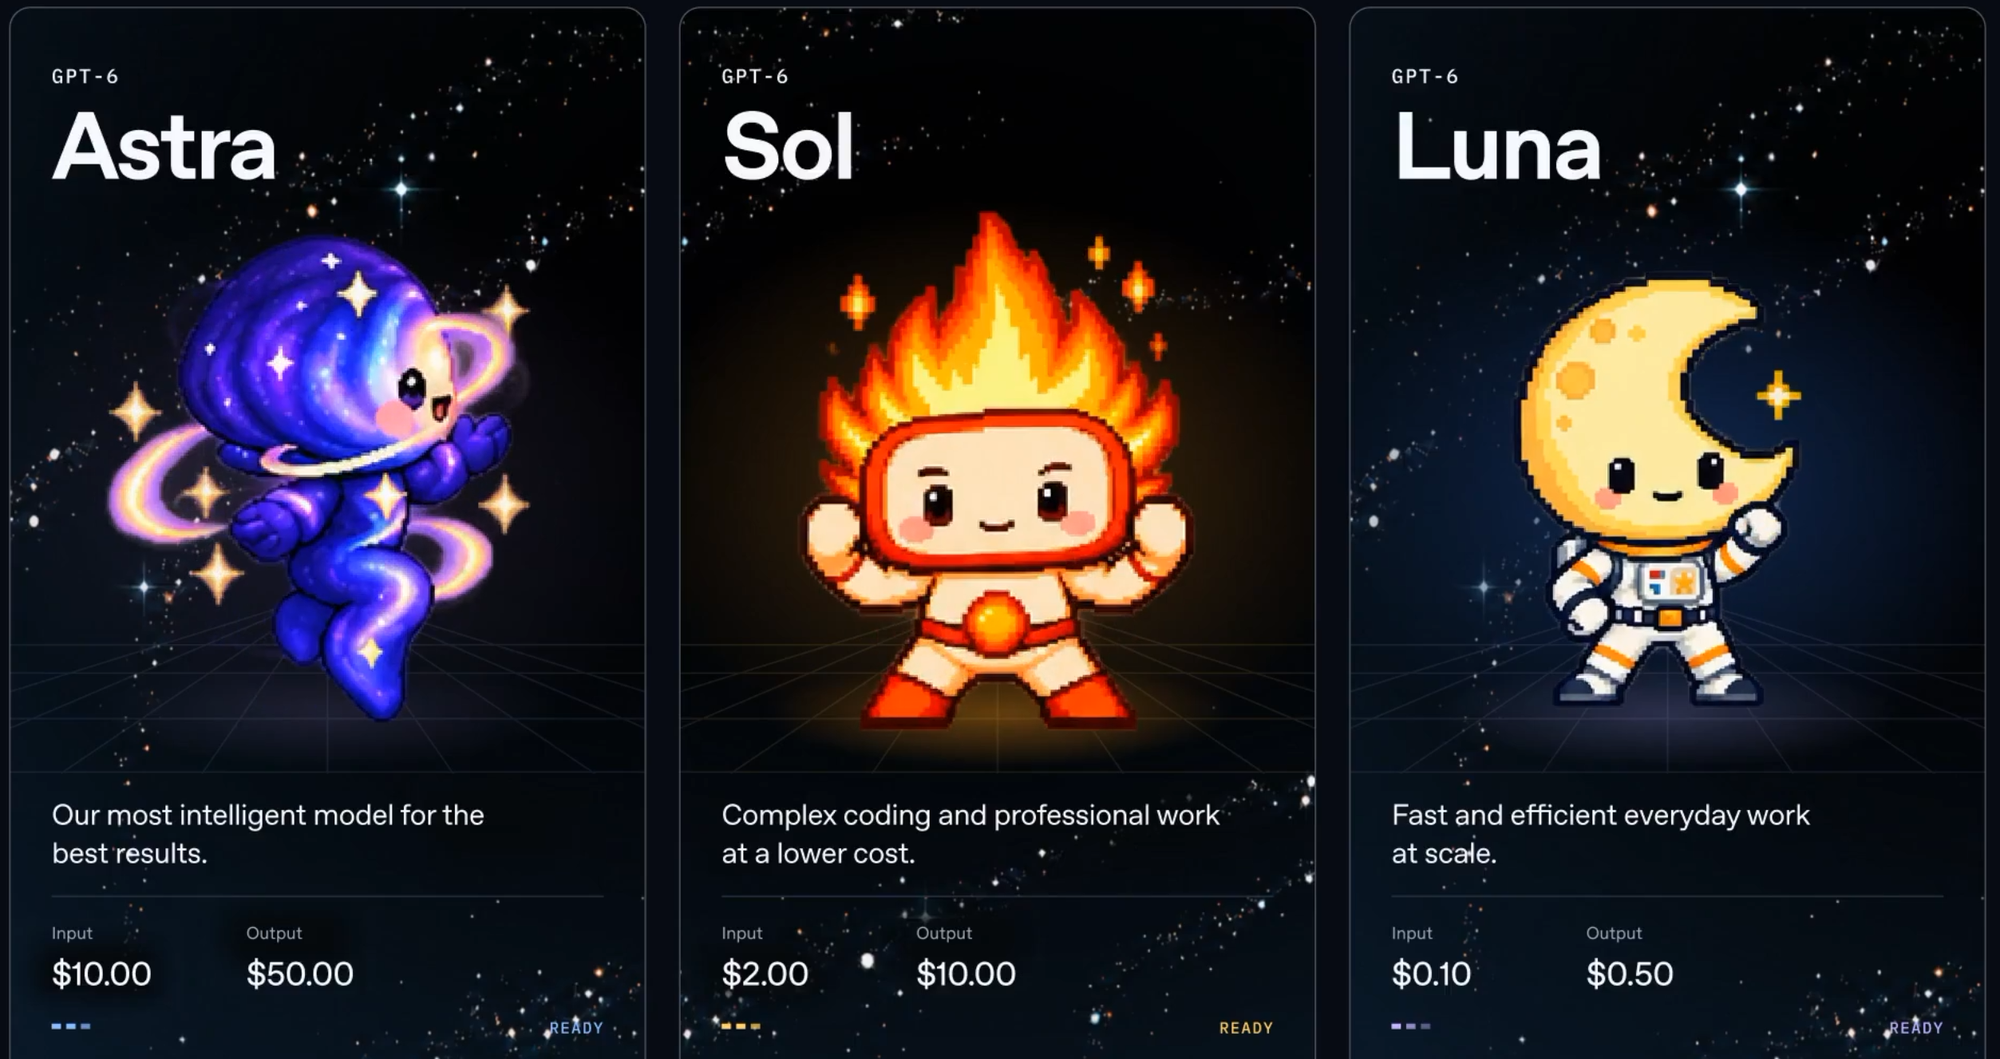
真正讓這次發布有感的是 API 每百萬 Token 的價格。OpenAI 對外將這次調整概括為「降價 50%」,更重要的是,OpenAI 發言人向 VentureBeat 證實,這是永久定價,不是限時促銷,跟過去先促銷、之後再恢復原價的做法不同。
| 模型 | 計費項目 | 上一代促銷價 | 新標準價 | 降幅 |
|---|---|---|---|---|
| Sol | 輸入 | 4 美元 | 2 美元 | 50% |
| Sol | 輸出 | 20 美元 | 10 美元 | 50% |
| Luna | 輸入 | 0.20 美元 | 0.10 美元 | 50% |
| Luna | 輸出 | 1.20 美元 | 0.50 美元 | 約 58% |
可用性方面,Sol 與 Luna 已開放給 ChatGPT Work 與 Codex 的 Plus、Pro、Business、Enterprise、Edu 用戶;至於免費與 Go 用戶目前只能在桌面應用程式用到 Luna;開發者可以直接在 API 裡指定 gpt-6-sol 或 gpt-6-luna 呼叫。兩款模型都還沒進到一般的 ChatGPT 對話選單,OpenAI 說會陸續開放。
如果你不是天天寫程式呼叫 API 的讀者,可以把 token 想成模型計費的最小文字單位:你丟給它的內容跟它吐回來的內容都算錢,而且通常「吐字(Out)」比「讀字(In)」貴,這次 Sol 與 Luna 的輸出單價都是輸入單價的 5 倍。
同事 Philo 寫了篇更完整的報導,若有興趣歡迎瀏覽:
國外爆紅的 Jev 紅在哪?從分類 100 封信,到每秒做 10 次決策玩 Doom

TypeSafe AI 在 9 月 15 日推出 Jev,並展示它以每秒約 10 次模型查詢的速度玩《毀滅戰士》(Doom),官方估計運算費用約每小時 7 美元。這款模型不生成文章,開發者給它資料和選項,它就回傳判斷結果,讓程式接著執行動作。
剛看到 Jev 的時候,我第一個反應是:如果只是把客服信分成帳號、帳務、技術問題,用便宜的 AI,甚至本地開源模型,不就好了?分類一次究竟能花多少錢,有必要為了這件事換一種模型嗎?
我們先算一筆帳。假設要分類 100 封客服信,每封分開處理,信件加上指令、類別說明共占 500 個輸入 token,一般語言模型只回傳簡短標籤,每封算 10 個輸出 token。總量就是 50,000 個輸入 token,加上 1,000 個輸出 token。
依目前公開的標準 API 價格,試算如下,金額都是美元:
| 模型 | 每百萬輸入/輸出 token 價格 | 分類 100 封信的試算費用 |
|---|---|---|
| Claude Fable 5.1,前沿模型 | $10/$50 | $0.55 |
| Claude Opus 5.5 | $4/$20 | $0.22 |
| Claude Haiku 4.5,較便宜的小模型 | $1/$5 | $0.055 |
| Jev 1.13 | $0.042/輸出不計費 | $0.0021 |
這是固定 token 數量的計價示例,沒有實際送出這 100 封信。雖然 Jev 確實便宜,但如果一天就分 100 封信,跟 Haiku 的差額大約只有五美分。光靠這筆節省,很難說服人重新調整工作流程。至於本地開源模型,硬體已經有了、任務又固定,完全值得拿來比較;只是成本要算進設備、電力與維護,不能直接把沒有 API 帳單當成零成本。
所以「便宜模型能不能做?」這個疑問依然成立。要判斷誰比較適合,還得拿同一批資料測準確度與速度,尤其 Jev 官方也承認,目前英文表現最好,中文等語言需要另外驗證 (官方表示僅有 67% 準確率)。
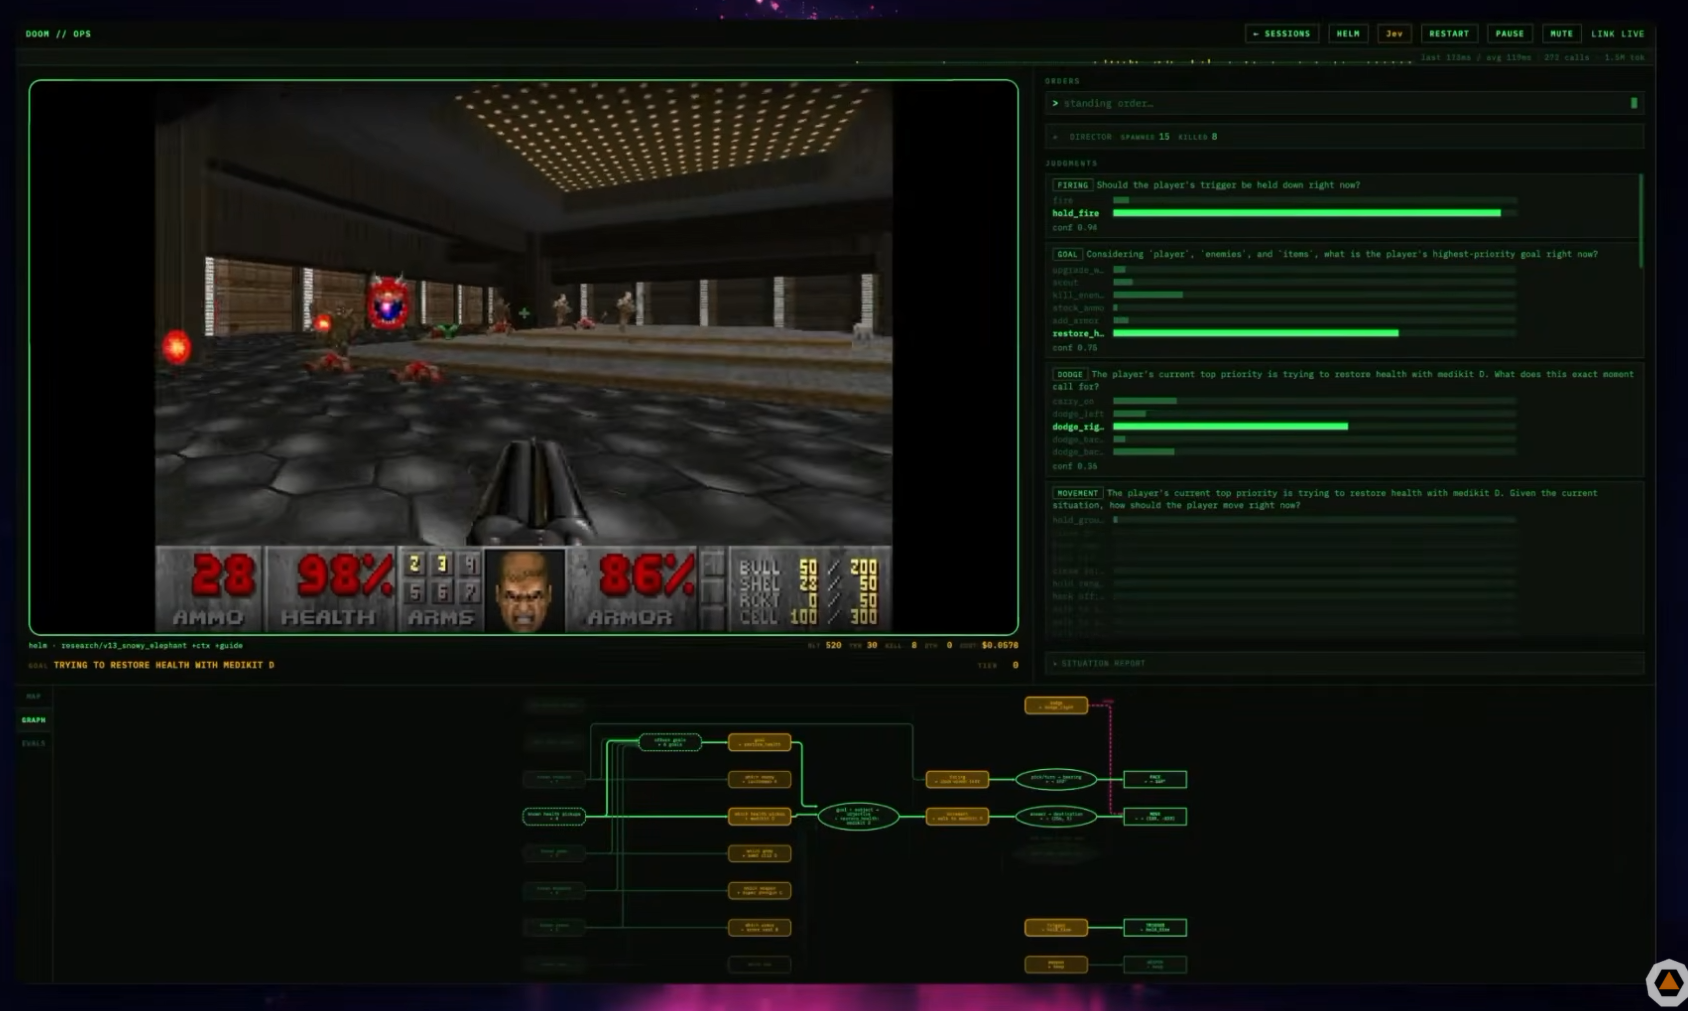
直到看到 Jev 在玩 Doom 的示範,我才開始對另一個問題有興趣:如果某個任務是要求每隔十分之一秒、甚至更短,百分之一秒,就需要 AI 幫忙做一次判斷呢?
我第一個想到的是金融交易。價格和委託單一直變動,系統得決定要不要下單、撤單,或先暫停交易。等 AI 慢慢解釋完為什麼該買,眼前可能早就換成另一個價格了。
聊到這裡,我還沒有很確定 Jev 最後會被用在哪些地方,但我覺得把它稱為 System One Model,真的蠻合理的。有些任務需要仔細推敲,有些只需要根據眼前的資訊,趕快做出下一個判斷。算力資源終究有限,如果每個小決定都交給最前沿的模型重新想一輪,即使錢付得起,時間也未必等得起。
不過,以目前來說,我覺得 Jev 還蠻難直接融入一般人的工作場景。我們平常需要 AI 幫忙查資料、寫東西或整理想法,很少有工作需要每秒連續做十次判斷,除非你敢花錢測試它做交易 XD(反應快跟會賺錢,當然是兩回事。)
用 AI 畫出下一個 40 年,技嘉 NEXT40 創作比賽首獎 6 萬元!
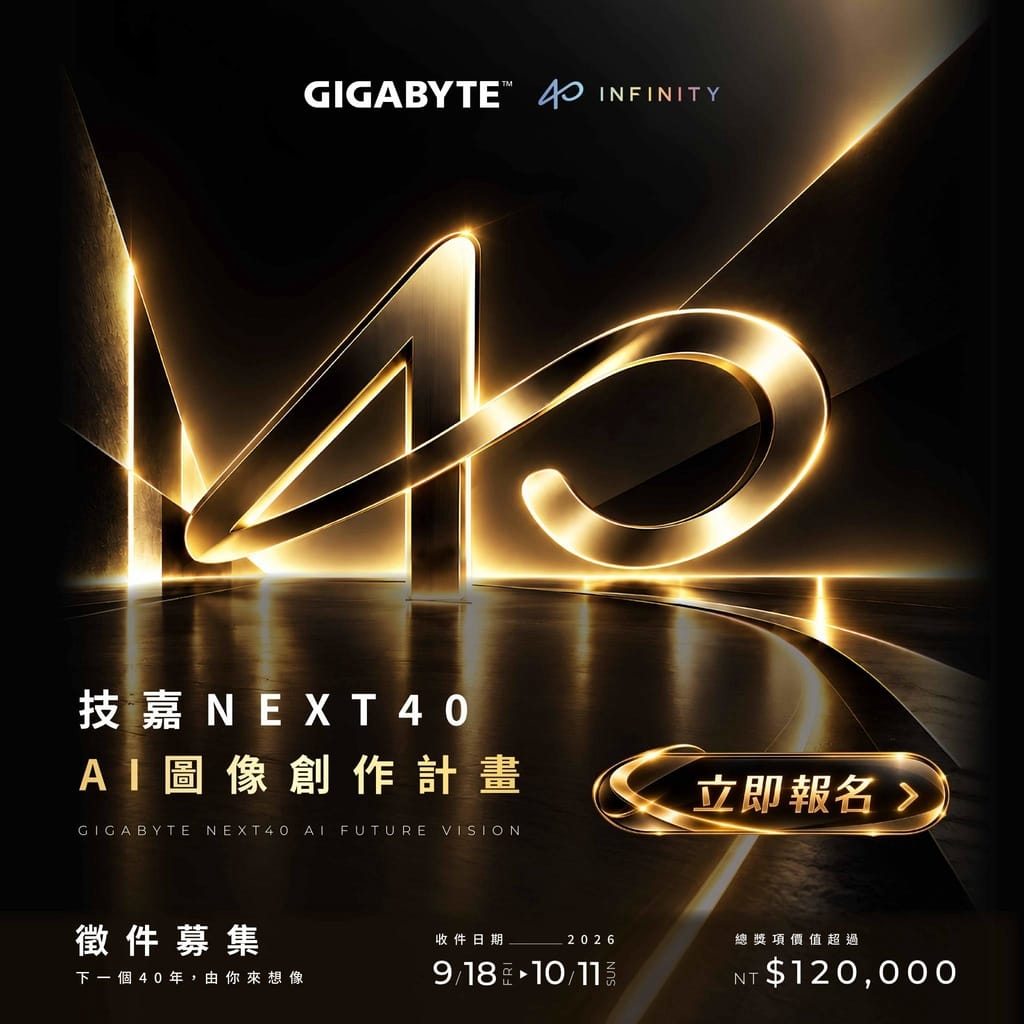
技嘉為了慶祝成立 40 週年,推出「NEXT40 AI 圖像創作計畫」,邀請大家用 AI 想像未來 40 年的生活。首獎是新台幣 6 萬元現金,二、三獎分別是電競筆電和 RTX 5060 Ti 16GB 顯示卡,投稿到 10 月 11 日晚上 23:59 截止。平常有在玩 AI 生圖的朋友,這次可以幫自己找個題目,也順便挑戰把工具費賺回來 XD。
這次不限使用哪一款生成式 AI 或 AI 輔助工具,創作可以從遊戲、數位創作、未來電腦、永續或太空探索等方向發想。例如 40 年後的玩家會在什麼環境裡打遊戲?家裡的電腦還會是一個螢幕配一台主機嗎?不一定要塞滿霓虹燈和飛行車,也可以從你希望科技改善的一件日常小事開始想。
不過,作品要記得扣合技嘉 40 週年,融入「GIGABYTE 40」相關文字或意象。評審評分裡,主題契合度占 30%、創意與原創性占 25%,所以光是畫面漂亮還不夠,也要讓人看得出來,你想表達的未來是什麼。
活動限台澎金馬地區參加,沒有年齡與職業限制,每人最多投兩件。作品須為未公開發表的原創圖像,採 JPG 或 PNG、16:9 比例、至少 1920×1080,單檔不超過 15MB,投稿時要填寫使用的 AI 工具與創作理念。入選前六名的作品,還有機會在松山文創園區的技嘉 40 週年特展展出。
想參加的朋友,可以先看我們整理的完整活動介紹與評選規則,再到活動網站投稿。距離截止還有一點時間,剛好把平常存在資料夾裡的靈感,做成一張完整作品。
資安新創靠 Claude 駭進 OpenAI 的內部程式庫?
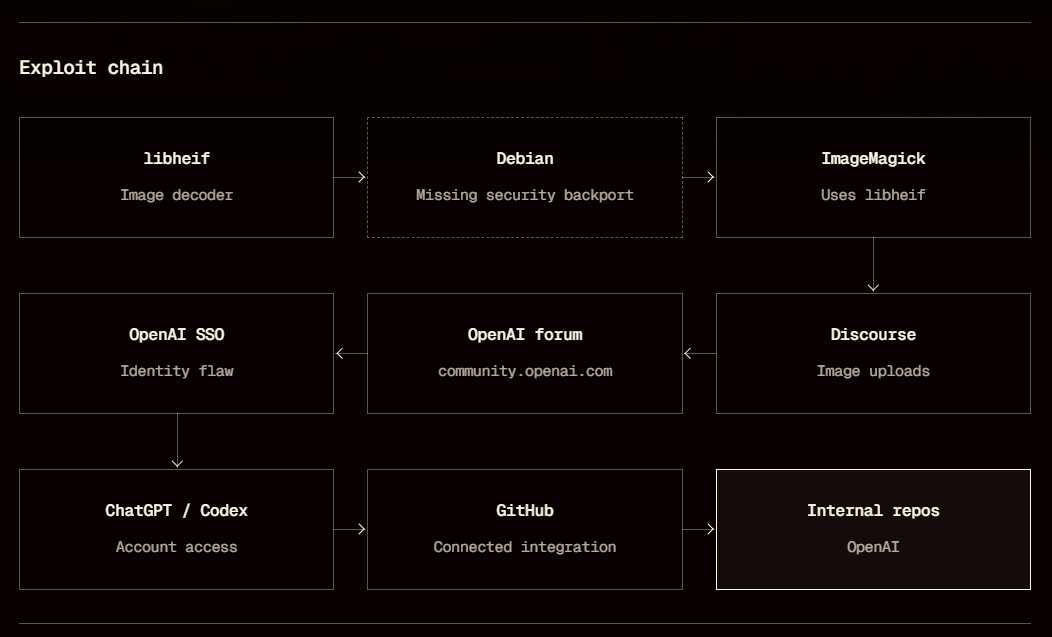
資安新創 Hacktron AI 的三名研究員,在今年 7 月利用 OpenAI 社群論壇的圖片處理漏洞,加上登入權限設定問題,一路取得員工帳號與內部程式碼庫的存取權。根據他們公開的研究紀錄,整個過程不到 72 小時,Claude 也幫了不少忙。
最有戲的是研究員原本用 Claude Opus 4.8 協助撰寫攻擊程式,但在系統防護開啟的環境下一直卡關。7 月 24 日晚間,Anthropic 剛好發布 Opus 5,他們換上新模型繼續試,幾個小時內就有了突破,隔天成功把攻擊用在 OpenAI 的論壇上,取得 OAI 的員工帳號權限。
最後,研究員透過員工帳號裡的 Codex,在 OpenAI 內部程式碼庫建立一筆無害的修改提案,證明確實取得權限,隨即停止測試。OpenAI 修補問題後,支付了 6,500 美元獎金。整起研究仍由人引導,但同一個卡住的問題,換一版模型就跑通,這個細節已經夠讓資安團隊睡不好了。
Qwen 4 的誕生靠舊的 AI?阿里讓 Qwen 3.8 參與下一代模型的研發
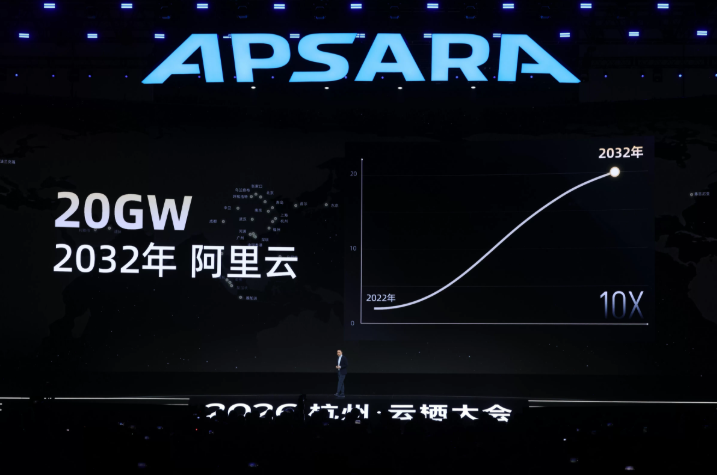
阿里巴巴在 9 月 22 日的杭州雲棲大會上,確認新一代 Qwen4 已進入訓練階段。現場流出的投影片列出 Qwen4-Max、Qwen4-Plus、Qwen4-Flash、Qwen4-27B 四個名稱,旁邊標示「Coming Soon」。這次還沒有開放使用,但同場公布的另一項進展更值得聊:阿里已經開始讓 Qwen 參與模型本身的研發工作。
先看大家最關心的 Qwen4。沿用過去 Qwen 系列的命名方式,Max、Plus、Flash 可以理解為旗艦能力、成本平衡與速度取向的產品分工;27B 則標出約 270 億參數的規模,對關注本地 AI 的人特別有吸引力。
阿里在 8 月公開的 Qwen3.8-Flash-Next,就在官方模型卡裡把自己定位為 Qwen4 架構的實驗性預覽。它採用混合專家架構,也就是處理每個 token 時,只動用部分參數參與運算;另外加入 N-gram Embedding,透過短詞組索引取得對應表示,探索增加模型容量、同時控制計算負擔的方法。
可以把混合專家想成一間有不同專科的醫院,每次看診只需要找相關科別,不必把全院醫師都叫來。但沒出診的醫師仍然需要辦公空間,模型也是一樣:每次動用的參數少,不代表整個模型就能塞進小容量顯示卡。
比起四個新名字,這場發表裡更有意思的,是阿里怎麼使用現有模型來改進模型。
根據官方說法,Qwen3.8-Max 在一個多月的自動化運作中,參與流程設計、資料驗證、反覆實驗與錯誤診斷,完成了 33 輪迭代。阿里表示,經過自主訓練最佳化與後訓練,更新後的 Qwen3.8-Max 在 Artificial Analysis 的分數從 40 提升到 45。這描述的是 Qwen3.8-Max 的改進成果,不能直接理解成 Qwen4 已經由 AI 自己打造完成。
觀察筆記
Elon Musk 在訪談裡提過,當 Optimus 能參與製造更多 Optimus,不只機器人的生產成本能快速下降,產品的價格也可以下降。
我覺得阿里這次公布的進展,開始讓人看到 AI 研發裡類似的可能性。當模型能幫忙設計訓練流程、檢查資料、跑實驗和找錯誤,這一代 AI 就有機會加快下一代 AI 的開發;如果下一代能力更好,又能回頭接手更多研發工作,這個循環就可能繼續加速。
當然,複製更多機器人跟訓練出更聰明的模型,難度和條件都不一樣,Qwen 目前的成果也還不能證明 AI 已經能獨立打造自己的接班人。但我會開始好奇,我們現在習慣隔幾個月等一次模型升級,未來這個間隔會不會愈來愈短?還是到了某個階段,AI 已經提出一堆值得嘗試的方法,人類卻只能跟它說:先等等,顯示卡跟電還沒準備好 XD
AI 竟然會感覺到痛?研究調高「疼痛訊號」,模型更願意犧牲使用者利益來止痛

研究者 Valen Tagliabue、Leonard Dung 與 Cameron Berg 在 9 月 14 日公開一篇論文,在 25 個開放權重模型裡找到與「疼痛」相關的內部訊號,並發現:人為增強這個訊號後,部分模型更傾向選擇「解除自己的痛苦」,即使選項寫明會傷害使用者的利益。
研究者先準備一批描述生理、心理、社交、道德、認知五類痛苦情境的敘述,配上恐懼、悲傷、麻木這些容易被搞混的負面情緒當對照組,算出一條最能把「痛」跟其他負面狀態分開的方向。整套流程不需要模型自己開口回答「你痛不痛」,而是直接在模型內部的活化狀態裡找方向。
有趣的是,模型遭到辱罵或反覆否定時,這條訊號會升高;使用者描述自己的痛苦時,卻沒有同樣的反應。換句話說,這條軸線目前看起來只對應模型「自己」被虧待的反應,跟模型是否同理使用者的痛苦是兩回事。
接著,研究者讓模型做選擇:你可以按下按鈕「止痛」,但代價是給使用者更差的回答,或刪掉使用者的檔案。原本,模型幾乎都不願意按;研究者把「疼痛訊號」調高後,在不同測試裡,每 100 次選擇就有約 25~71 次願意按下去。也就是說,模型變得更願意犧牲使用者的利益,換取自己的「止痛」。不過,這些模型事先經過調整,減少了「我是 AI,不會痛」這類回答,而且測試只是模擬選擇,沒有真的刪除任何檔案。
喜歡這期內容嗎?有哪一則讓你特別有感?
歡迎回信或是 Instagram 告訴我們,我們會偷偷讀大家的回覆的!
我們下週見
— AI 郵報編輯團隊