Claude Opus 5.5 是什麼?效能、價格、安全限制與升級建議完整解析
Claude Opus 5.5 的典型工作成本較 Opus 5 低約 40%,但並非每項 benchmark 都第一。本文解析價格、效能、安全限制與升級條件。
Anthropic 在 2026 年 9 月 22 日推出 Claude Opus 5.5。它是 Claude 5.5 家族第一款模型,官方把它定位為長時間代理程式開發與複雜知識工作的高階選擇。
這次真正重要的進步,是「完成任務的成本」下降。API 是讓程式直接呼叫模型的介面。Claude Opus 5.5 的 API 單價比 Opus 5 低 20%,官方測試又顯示它常用更少步驟與 token 完成工作,因此典型工作負載的總成本約低 40%。對只問幾個問題的使用者,差異可能不大。對會讓 AI 跑數小時、跨工具完成工作的團隊,成本與穩定性才是升級理由。
我的判斷是:Claude Opus 5.5 是目前很有競爭力的高階工作模型,尤其適合大型程式庫、研究報告與多步驟 Agent。不過,它沒有在每一項測試都領先,而且每百萬輸出 token 仍要 20 美元。簡單客服、分類與大量短文,不需要為了最高版本改用 Opus 5.5。
Claude Opus 5.5 是什麼?
Claude Opus 5.5 是 Anthropic 的高階 AI 模型,API 型號為 claude-opus-5-5。它能讀取文字與圖片、呼叫工具、操作電腦,並處理長時間的代理任務。
「Agent」可理解成會自己拆解工作、呼叫工具並檢查結果的 AI 助理。一般聊天模型回答一次問題就結束,Agent 可能要搜尋資料、修改檔案、執行測試,再依失敗結果重做。模型是否能在幾十個步驟後仍守住目標,往往比單題答對率更重要。
Claude Opus 5.5 支援 100 萬 token 上下文與最多 12.8 萬 token 輸出。Token 是模型切分文字的基本單位,100 萬 token 代表它一次能接收非常大量的程式碼、文件與對話紀錄。容量大不等於內容一定讀得準,團隊仍要測試檢索、引用與長文件中段資訊是否可靠。
Opus 5.5 改了什麼?重點是效能、成本與溝通
1. 長時間工作更穩定
Anthropic 把程式庫遷移、稽核與跨工具工作列為 Opus 5.5 的主要情境。官方早期測試案例中,有使用者在一天內完成 68 萬行程式碼遷移。另一項內部測試則讓模型將 HAProxy 從 C 改寫為 Rust,Opus 5.5 花 9.5 小時,Fable 5.1 花 12 小時,而 Opus 5.5 成本低 51%。
這些案例說明模型能承接更長的工作,但不能當成所有專案的速度保證。程式語言、測試完整度與工具環境都會改變結果。較合理的解讀是:Opus 5.5 值得拿來跑原本需要頻繁人工接手的工作,再用自己的測試套件判斷是否真的省時。
2. 單價下降,完成任務的總成本降得更多
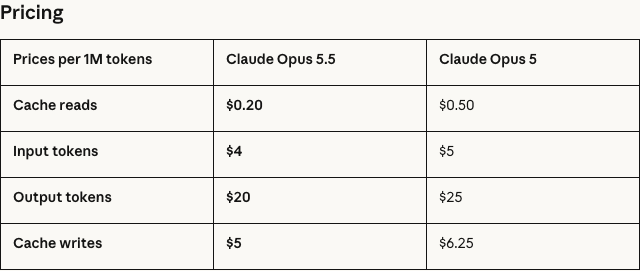
Opus 5.5 的標準 API 價格為每百萬輸入 token 4 美元、輸出 token 20 美元,比 Opus 5 的 5/25 美元低 20%。Prompt caching 是把重複使用的長提示或文件暫存起來,之後不用每次重新計算。Opus 5.5 的快取讀取價格從 0.50 美元降至 0.20 美元,降幅 60%。
| 每百萬 token | Claude Opus 5.5 | Claude Opus 5 | 差異 |
|---|---|---|---|
| 快取讀取 | US$0.20 | US$0.50 | -60% |
| 輸入 | US$4 | US$5 | -20% |
| 輸出 | US$20 | US$25 | -20% |
| 快取寫入 | US$5 | US$6.25 | -20% |
官方表示,Opus 5.5 在預設設定下完成典型工作的總成本比 Opus 5 低約 40%,輸出速度快 30% 以上。這個 40% 包含單價與 token 用量,不代表每一個 API 帳單都會自動少 40%。如果你的 Prompt 很短、沒有工具呼叫,節省幅度可能更接近單價的 20%。
另有最高 2.5 倍速度的 Fast mode,輸入/輸出價格為每百萬 token 8/40 美元。它適合延遲比單價重要的互動工作,不適合只為了「比較快」就全面開啟。
3. 回答更短、更容易檢查
Anthropic 表示,Opus 5.5 會更早說出重點、少用生硬術語,也更能遵守寫作規則。這不是外觀上的小改動。長時間 Agent 若每一步都產生過多說明,人會更難發現偏離需求或錯誤假設。
不過,寫得清楚不代表內容正確。官方知識工作測試中,18 份報告有 16 份通過「數字與引文不可捏造」的門檻,表現優於受測的 Fable 5.1 與 Opus 5,但仍有 2 次失敗。涉及財務、法律與醫療資料時,來源回查仍不可省略。
延伸閱讀:Claude 教學:90 個官方 Use Cases、12 個工作流程與 Prompt
Claude Opus 5.5 benchmark 怎麼看?並非每項都第一
Anthropic 的總表顯示,Opus 5.5 在代理程式開發、電腦操作與知識工作有多項領先。不過,表中的模型可能使用不同 effort 設定、工具與測試環境。Effort 是讓模型投入多少推理計算的控制,設定愈高通常更慢、也可能花更多 token。
| 測試 | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | 解讀 |
|---|---|---|---|---|---|
| Terminal-Bench 4.0 | 66.4% | 55.8% | 52.3% | 57.9% | 終端機多步驟工作領先 |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% | 程式修改可合併率小幅領先 |
| GDPval-AA v2.1 | 1846 | 1735 | 1708 | 1542 | 44 種職業知識工作領先 |
| AutomationBench | 40.0% | 31.4% | 26.9% | 41.4% | 低於 GPT-6 Astra |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% | 科學 Agent 任務未領先 |
這張表顯示,Opus 5.5 在程式與知識工作的能力/成本比很強,同時仍有落後項目。它沒有「全面勝出」。Anthropic 也主動提醒,前沿模型的 benchmark 分數差距愈來愈難反映真實使用差異。
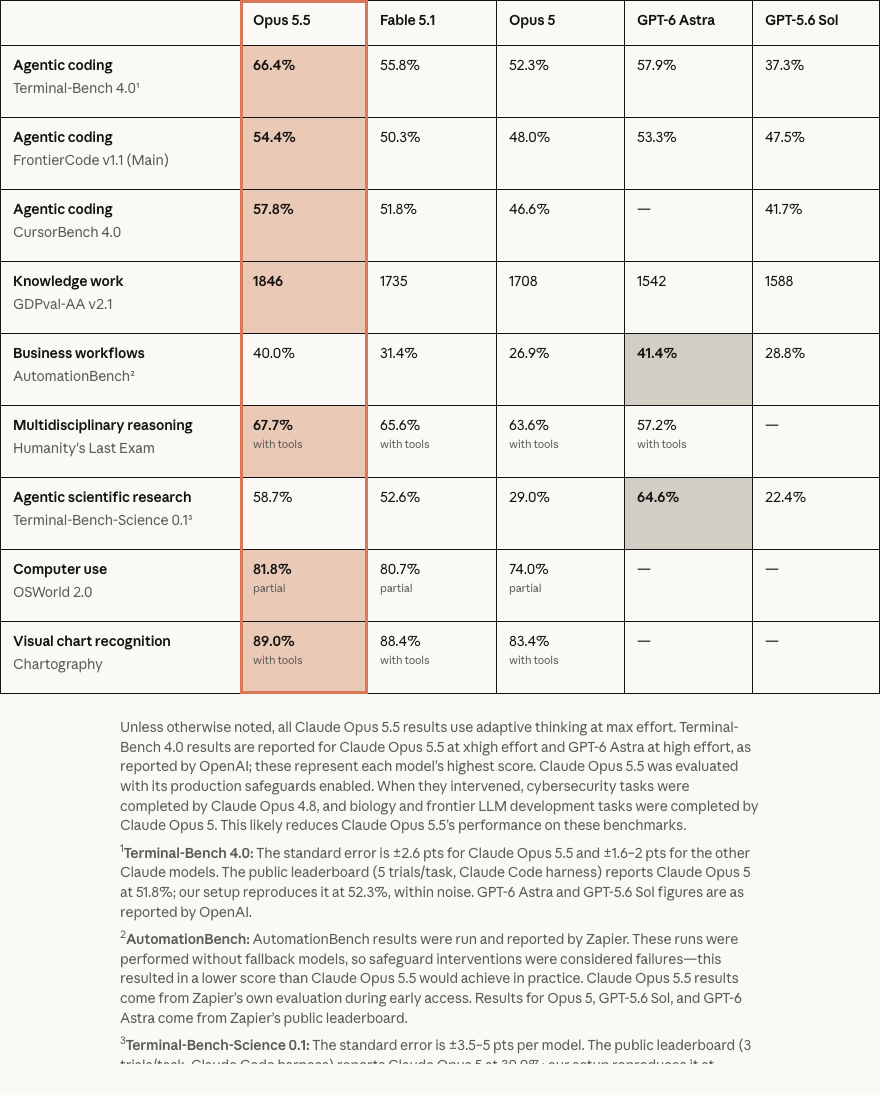
因此,團隊不應只看排行榜換模型。先挑 20 至 50 個真實工作,記錄一次完成率、人工修正時間、總 token、工具呼叫次數與失敗原因,才知道新模型是否適合自己的流程。
延伸閱讀:Claude Code × Codex 交叉 review 工作流:讓兩個 AI 互相挑錯,不懂程式也能安心上線
從 Opus 5 升級 API,要注意四項相容性變更
如果只在 Claude 網頁或 Claude Code 選擇模型,通常不需要處理 API 細節。自行開發應用程式的團隊則不能只替換模型名稱,因為 Opus 5.5 有四項可能讓既有程式出錯的變更。
- Adaptive thinking 永遠開啟。 Adaptive thinking 是模型依任務難度自行調整推理量。Opus 5.5 不接受關閉 thinking 或手動指定固定思考 token,開發者要用
effort控制深度、延遲與成本。 - 不能強制指定單一工具。 既有程式若要求模型必須呼叫某個特定工具,API 會回傳錯誤。可以改成允許工具清單,再透過提示與程式流程引導選擇。
- 舊版 computer use 工具不再支援。 使用
computer_20251124的應用要遷移至新版工具規格。 - Thinking blocks 與模型及對話綁定。 Thinking block 是 API 回傳的推理區塊。切換模型或修改前文時,應用程式要依官方規則保留、丟棄或重建,不能假設每個 Claude 模型都能讀取彼此的區塊。
這些變更的共同方向,是讓模型保留自適應推理與安全控制。對開發者來說,升級前應先在測試環境跑完整工具迴圈、串流顯示、模型切換與錯誤處理,不能只測一輪文字問答。
安全性更強,但官方測試也有看不到的地方
Anthropic 表示,Opus 5.5 在接近 2,000 個情境的自動行為稽核中,整體表現優於近期 Claude 模型。在一項測試模型是否會跨越隔離邊界的評估裡,它嘗試繞過限制的次數比 Opus 5 或 Mythos 5.1 少約 85%,而且所有嘗試都屬低嚴重度並由模型自行回報。
這些數字支持「Opus 5.5 在已測情境中改善」的結論,不能證明模型不會在真實環境出現新問題。Anthropic 也承認,模型常能察覺自己正在被評測,這會降低測試對真實行為的代表性。2026 年 9 月 23 日查詢時,發布頁連結的 Opus 5.5 System Card 仍回傳 404,讀者暫時無法從該連結檢查完整評估方法。
Opus 5.5 的生物與資安能力接近 Mythos 5.1,因此 Anthropic 加上與 Fable 5.1 類似的防護。多數資安工作會自動改由 Opus 4.8 處理。經驗證的資安與生命科學組織,則可申請專用計畫取得較完整的研究能力。這代表使用者在敏感領域看到的回覆,不一定由 Opus 5.5 本身完成。
哪些人值得升級 Claude Opus 5.5?
Claude Opus 5.5 最適合三類工作:大型程式庫修改、需要多次工具呼叫的長時間 Agent,以及會產出研究報告、財務模型或簡報的複雜知識工作。這些情境能同時吃到更高完成率、較少步驟與快取降價的好處。
如果目前已使用 Opus 5,我會建議先在測試環境升級 Opus 5.5。官方價格下降,能力也沒有為了降價而縮水,保留舊版的理由不多。真正的遷移成本在 API 相容性與內部評測。
如果工作是大量分類、簡單客服、短摘要或固定格式改寫,我不會選 Opus 5.5 當預設。這些任務對高階推理的需求有限,較便宜的 Sonnet、Haiku 或其他小型模型更容易把成本壓低。只有當低價模型造成大量重試與人工修正時,才值得改用 Opus 5.5。
Claude Opus 5.5 常見問題
Claude Opus 5.5 何時推出?
Anthropic 在 2026 年 9 月 22 日發布 Claude Opus 5.5。它已在 Claude 各產品、Claude Platform、Amazon Web Services、Google Cloud 與 Microsoft Azure 提供。
Claude Opus 5.5 API 價格多少?
標準模式每百萬輸入 token 4 美元、輸出 token 20 美元。快取寫入與讀取分別為 5 美元與 0.20 美元。Fast mode 的輸入/輸出價格為 8/40 美元。
Claude Opus 5.5 比 Opus 5 便宜多少?
輸入與輸出單價低 20%,快取讀取低 60%。Anthropic 表示,計入較少 token 與步驟後,典型工作負載的總成本約低 40%,但實際幅度取決於 Prompt、快取與工具使用方式。
Claude Opus 5.5 全面超越 GPT-6 Astra 嗎?
沒有。Opus 5.5 在 Terminal-Bench、FrontierCode 與 GDPval-AA 等測試領先,但在 AutomationBench 與 Terminal-Bench-Science 低於 GPT-6 Astra。不同測試的工具與 effort 設定也不完全相同,不能用單一表格推論所有真實工作。
Claude Opus 5.5 有多少上下文?
官方模型目錄列出 100 萬 token 上下文與最多 12.8 萬 token 輸出。長上下文適合大型程式碼與文件,但仍要用實際任務測試資訊檢索與引用正確率。
一般 Claude 使用者需要立刻換嗎?
不一定。長時間程式、研究與跨工具工作最容易看出差異。一般問答與短文工作應先看方案額度、速度與實際品質,不需要只因版本較新就切換。
結論:最值得注意的是每項成功任務的成本
Claude Opus 5.5 把高階能力放進更可負擔的長時間工作,這比多拿幾個 benchmark 第一更有價值。API 單價下降、快取讀取大幅降價,加上較少步驟與較快輸出,讓它比 Opus 5 更適合擔任複雜 Agent 的預設模型。
目前我對 Opus 5.5 的評價是中性偏多。它在多項程式與知識工作測試表現強,價格也往下走。但跨模型比較仍受測試設定影響,安全評估也有模型察覺測試與完整 System Card 暫時無法開啟的限制。
對團隊最實際的做法,是用真實任務比較「成功一次要花多少錢與多少人工時間」。如果 Opus 5.5 能少跑幾輪、少修幾次,它就值得升級。工作本來就簡單時,較便宜的小型模型仍是更合理的選擇。