Raon-1 mini 是什麼?KRAFTON 30B 預覽模型的基準與免費 API 怎麼看
Raon-1 mini 是 KRAFTON 釋出的 30B 專家混合預覽模型,啟用參數約 4B,權重標示 Apache-2.0。本文依官網、文件與條款,整理七項基準的勝負、快與省記憶體的證據、Hugging Face 申請流程與免費 API 的限制。

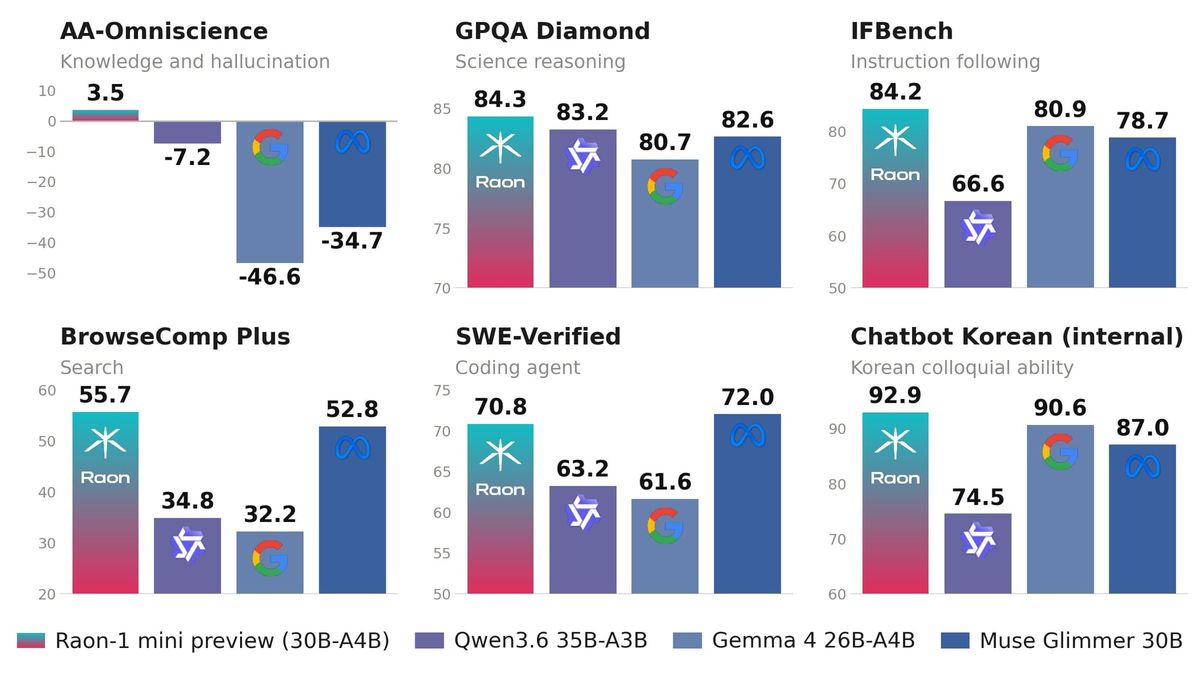
2026 年 10 月 21 日下午(台灣時間),韓國遊戲公司 KRAFTON 的 AI 團隊在 X 釋出 Raon-1 mini 預覽版。
貼文說它是 KRAFTON 從零訓練的 30B 專家混合模型,啟用參數 4B,在程式與代理任務上追平 Meta 的 Muse Glimmer,而且更快、更省記憶體。
遊戲公司自己訓練大型語言模型,再加上開放權重與限期免費的 API,讓人很想知道它能不能直接拿來用。專家混合模型是把模型拆成許多專家,每個詞元只啟動一小部分,所以 30B 是總參數,實際運算約 4B。
回到官方網站的比較表,Raon-1 mini 在七項基準中,有五項勝過同為專家混合的 Qwen3.6-35B-A3B 與 Gemma 4 26B-A4B。
但 MMLU-Pro 是五個模型中最低的 76.5,而且對上兩個密集模型,也就是 Qwen3.8-27B 與 Muse Glimmer 30B,在程式修復與長文件上仍落後。
所以「追平 Muse Glimmer」只在部分項目成立。至於「更快、更省記憶體」,官網只描述了架構,我在官網與文件頁都沒有找到速度或記憶體的數字,完整模型卡又需要申請才能讀。
實務上還有三件事要先知道:權重放在需填表申請的 Hugging Face 倉庫、免費 API 是限期測試,而且條款寫明提示詞會保存 14 天。
我的判斷是,Raon-1 mini 適合想試韓文與英文助理、想用相容端點低成本比較模型的開發者。需要影像輸入、長文件理解或穩定服務等級的團隊,現階段不適合。
要判斷它值不值得試,得先弄清楚這個預覽版到底是什麼規格。
Raon-1 mini 是什麼?KRAFTON 從零訓練的 30B 專家混合預覽模型
Raon-1 mini preview 是 KRAFTON 以 Raon 為品牌釋出的大型語言模型預覽版,型號寫成 30B-A4B,代表總參數約 30B、每個詞元啟動約 4B。
官方網站把它的架構歸納為三個設計。專家混合讓每次只動用必要的專家,線性注意力用較低的成本處理愈來愈長的對話,推測解碼則讓小模型先猜後面幾個詞元,再由大模型一次驗證。
KRAFTON 在貼文裡強調這是預覽版,最終版與更大的模型「即將推出」。所以現在看到的分數與規格,之後可能改變,官方文件也寫明預覽模型可能被修改或取代。
規格方面,文件列出上下文視窗是 262,144 詞元,輸入與輸出都只有文字,模型會先推理再回答,而且推理無法關閉。上下文視窗是模型單次能讀進去的資料量上限。
Hugging Face 倉庫在 10 月 21 日建立,主模型分成 7 個檔案,加總約 32.7 GB。
依 Hugging Face 的統計,實際參數約 28.8B,所以 30B 是型號上的概數。標籤顯示權重主要採 MXFP8 格式,並且附帶自訂程式碼。
同一個組織還放了幾個衍生版本。GGUF 版有 IQ4_XS 到 Q8_0 五種量化,大小約 16 到 31 GB。
MLX 與 NVFP4 版約 17.6 GB,推測解碼用的 DFlash 草稿模型約 2.7 GB。這些大小是我把 Hugging Face 檔案清單加總得到的。
官方文件還給了詞元換算,韓文大約每 2 到 3 個字一個詞元,英文大約每個單字一個詞元。這對估算費用與上下文很有用,也提醒你它的設計重心是韓文與英文。
規格講完,接著看官方拿出什麼成績來支持「追平」這個說法。
Raon-1 mini 基準成績:勝過同類專家混合模型,但沒有勝過密集模型
官方網站用七項代表性基準,把 Raon-1 mini 與四個大小相近的開放模型比較,分數越高越好。
以下我把官網的表格整理出來。前三個模型是專家混合,後兩個是官網標示的密集模型,也就是每個詞元都動用全部參數的模型。
| 基準 | 測什麼 | Raon-1 mini | Qwen3.6-35B-A3B | Gemma 4 26B-A4B | Qwen3.8-27B(密集) | Muse Glimmer 30B(密集) |
|---|---|---|---|---|---|---|
| MMLU-Pro | 廣泛知識 | 76.5 | 85.9 | 82.9 | 85.7 | 84.0 |
| GPQA Diamond | 研究所等級科學題 | 84.3 | 83.2 | 80.7 | 89.7 | 82.6 |
| IFBench | 遵守多重限制的指令 | 84.2 | 66.6 | 80.9 | 82.4 | 78.7 |
| SWE-Verified | 修復真實程式問題 | 70.8 | 63.2 | 61.6 | 74.6 | 72.0 |
| BrowseComp Plus | 搜尋並整合網頁 | 55.7 | 34.8 | 32.2 | 58.0 | 52.8 |
| AA-LCR | 長文件推理 | 67.3 | 69.3 | 67.0 | 80.3 | 81.3 |
| Chatbot Korean(內部) | 韓文口語對話 | 92.9 | 74.5 | 90.6 | 90.1 | 87.0 |
官網的紅字標出的是「專家混合模型中最高」。
依表格計算,它在 GPQA、IFBench、SWE-Verified、BrowseComp Plus 與韓文對話五項高於兩個專家混合對手,MMLU-Pro 與 AA-LCR 則不是最高。
把密集模型放進來,圖像就不同了。在 MMLU-Pro、SWE-Verified 與 AA-LCR,它低於兩個密集模型。
在 GPQA 與 BrowseComp Plus,它勝過 Muse Glimmer,但輸給 Qwen3.8-27B。只有 IFBench 與韓文對話,它高於所有四個對手。
貼文說「在程式與代理任務上追平 Muse Glimmer」。
對照表格,SWE-Verified 是 70.8 對 72.0,低 1.2 分,BrowseComp Plus 是 55.7 對 52.8,高 2.9 分,所以說接近是合理的,說追平要加上「這兩項」。
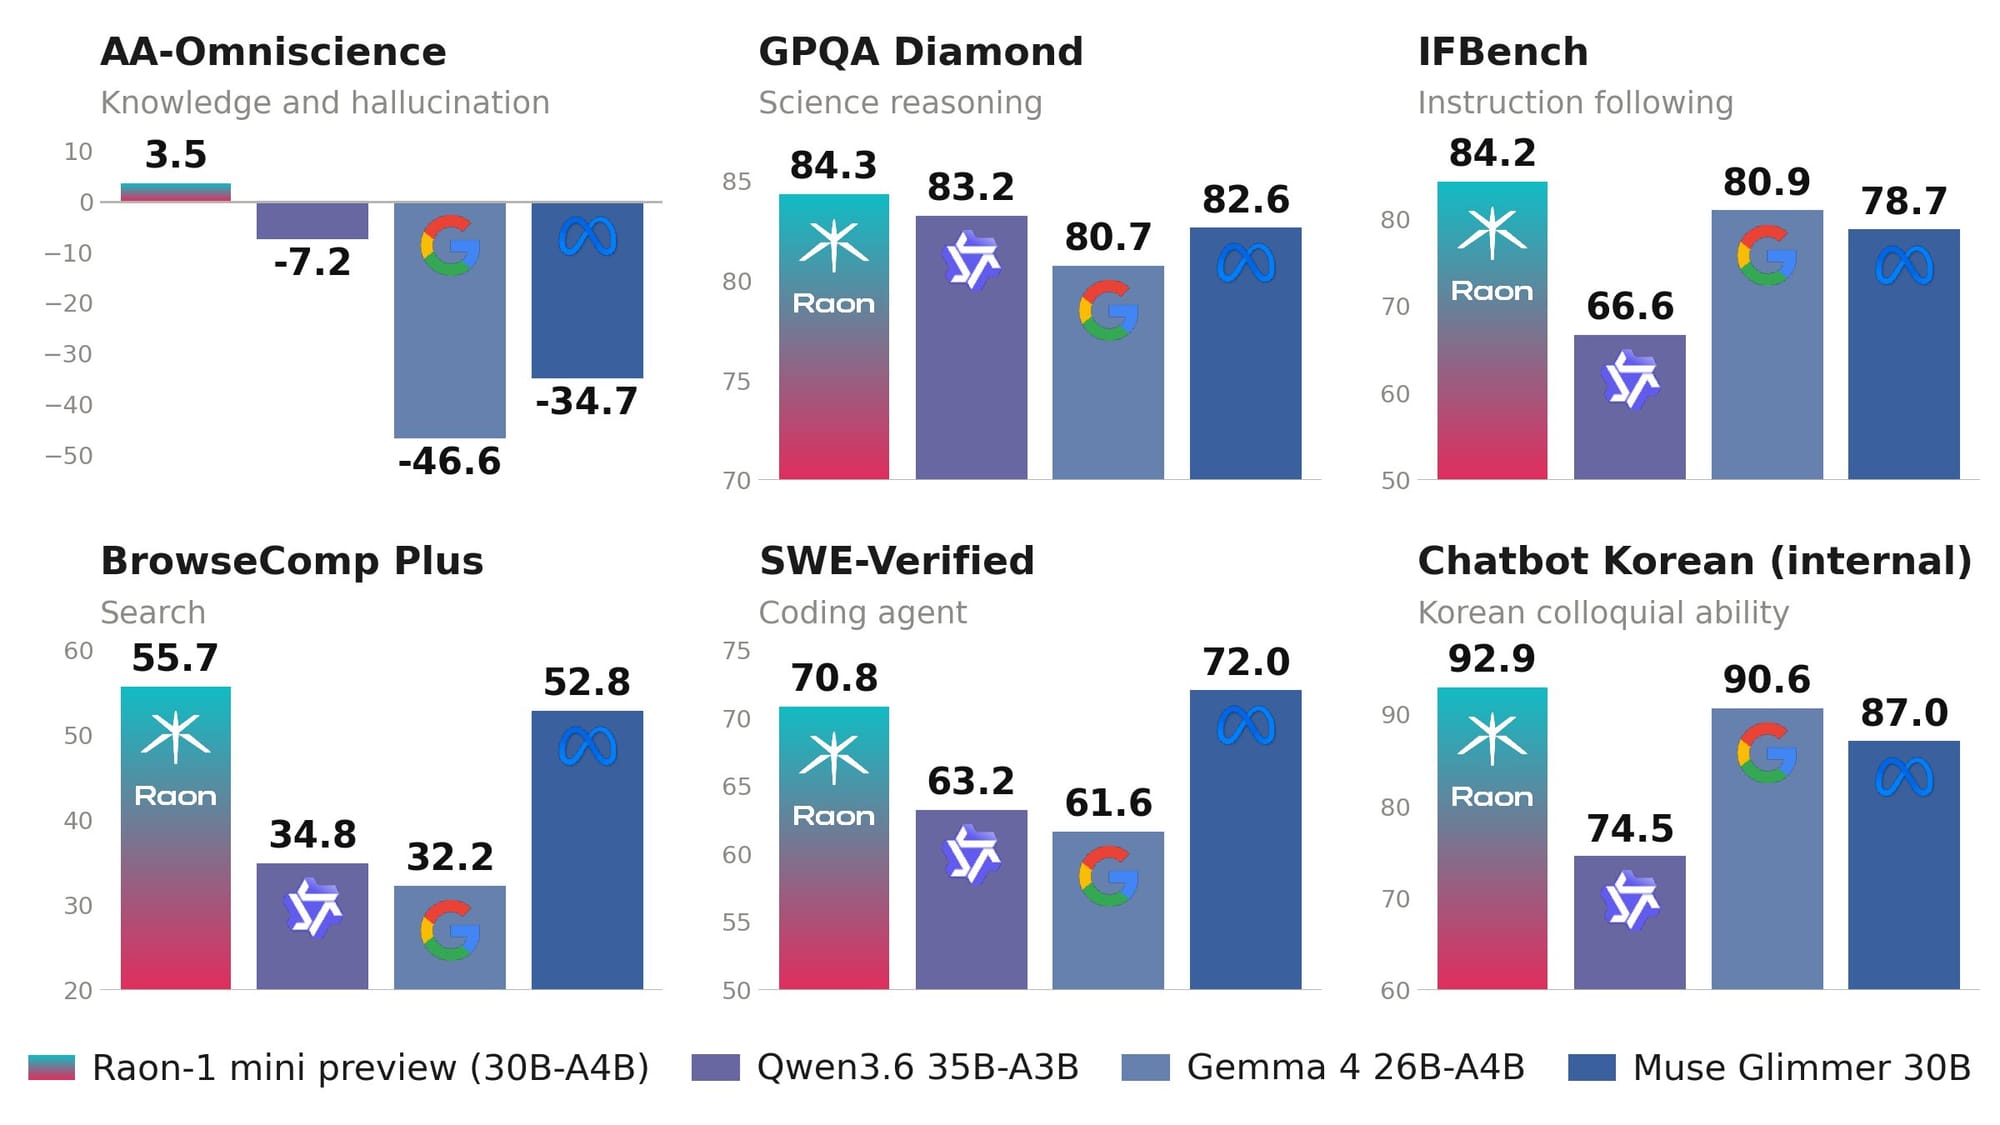
官網另一張圖有第八項基準 AA-Omniscience,它得 3.5,Qwen3.6-35B-A3B 是 −7.2,Gemma 4 是 −46.6,Qwen3.8-27B 是 −0.5,Muse Glimmer 是 −34.7。
依官網的說明,這項基準衡量答對率,也看模型不知道時會不會拒答。分數同時含答對與少亂答兩種成分,所以不能直接當成知識量。
這也解釋了為什麼官網說它在「知識」類最高,表格裡的 MMLU-Pro 卻是最低。官網的「知識」類最高,指的是 AA-Omniscience,兩項測的是不同的事。
延伸閱讀:Muse Spark Open 開放權重:兩台 Mac Studio 能跑,企業採用還要看什麼?
這些分數怎麼讀?誰測的、對手的數字從哪來
這些分數都是 KRAFTON 自己公布的,頁面沒有說明對手分數是引用原報告,還是用同一套設定自行重跑。
這一點很重要,因為同一個模型在不同人手上的分數常常不同。
Meta 在 Muse Glimmer 自己的模型卡上,以高推理強度列出 SWE-Bench Verified 76.0、IFBench 77.0、GPQA Diamond 83.5 與 AA-LCR 80.0。
Raon-1 mini 官網表格裡的 Muse Glimmer 分別是 72.0、78.7、82.6 與 81.3。兩邊有高有低,差距最大的是 SWE-Verified 的 4 分,原因可能是推理強度或測試框架不同,官網沒有說明。
另外,官方貼文附的柱狀圖縱軸沒有從 0 開始,例如 IFBench 從 50 起算、BrowseComp Plus 從 20 起算,視覺上會放大差距。看圖時要回到標示的數字,不要用柱子高度判斷。
韓文對話分數來自內部基準,外部無法重現。它能說明 KRAFTON 針對自己的目標語言做了調整,但不能拿來和其他公司的模型做公平比較。
完整的 18 項基準放在 Hugging Face 模型卡。因為該倉庫需要申請存取,我無法讀到全文,所以本文只引用公開的官網與文件頁。
Raon-1 mini 的「更快、更省記憶體」有證據嗎?
貼文說 Raon-1 mini 比 Muse Glimmer 更快、更省記憶體。官網的支持是架構說明:專家混合只動用約 4B 參數,Muse Glimmer 是 29.6B 的密集模型,每個詞元要動用全部參數。
依這個設計,每個詞元的運算量確實應該小很多,粗略比較是 4B 對 29.6B。但官網與文件頁沒有給出每秒生成詞元數、首字延遲或顯存用量的測量值,所以「快多少」目前沒有數字可查。
記憶體就更要分開看。專家混合省的是每個詞元的運算量,所有專家的權重仍要放進記憶體,所以 Raon-1 mini 的 32.7 GB 檔案不會因為只啟動 4B 而變小。
另外,這個檔案的權重主要已是 FP8 格式,Meta 的 Muse Glimmer 模型卡則以完整精度標示目標約 64 GB 顯存,壓到約 4 位元後語言模型不到 20 GB。兩邊的精度不同,不能直接比大小。
官網說線性注意力讓長對話仍能有效整理資訊,至於是否降低記憶體成長,我沒有看到實測數字。AA-LCR 長文件項目的分數落後於兩個密集模型,也提醒你效率與長文件品質需要一起驗證。
所以這句話目前只有架構上的理由,沒有公開的數據支持,建議自己用同一台機器量測每秒詞元數與顯存。
怎麼取得與試用 Raon-1 mini:Hugging Face 申請、免費 API 與相容工具
權重在 Hugging Face 的 KRAFTON 組織下,標示 Apache-2.0,但倉庫設為「申請後存取」。申請表要填姓名、單位、職稱、國家、預定用途,並勾選同意 Apache 授權,狀態是自動核准。
倉庫標籤含 custom_code,通常表示載入模型需要執行倉庫裡的自訂程式碼。建議先讀過那些程式碼,並在隔離環境測試,不要在放有金鑰的機器上直接執行。
另一條路是官方的託管 API。流程是在官網填申請表,收到邀請信後註冊主控台,再自行發行 API 金鑰。模型代號是 raon-1-mini-preview。
API 同時支援三種格式:OpenAI 的 Chat Completions 與 Responses,以及 Anthropic 的 Messages。
所以 Claude Code、Codex 與其他相容工具,只要改基礎網址與金鑰就能呼叫。要注意 OpenAI 格式的網址是 https://raon-api.krafton.ai/v1,Anthropic 格式與 Claude Code 則不加 /v1。
curl https://raon-api.krafton.ai/v1/chat/completions \
  -H "Authorization: Bearer $RAON_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "raon-1-mini-preview", "messages": [{"role": "user", "content": "Hello!"}]}'
官方也提供一行安裝腳本,直接把網路上的腳本交給 bash 執行。官方文件自己建議先讀過腳本再執行,或改走手動設定,我也建議這樣做,因為腳本會在你的機器上寫入檔案、調整設定。文件另附 --uninstall 選項可以還原。
相容不代表功能一致。文件列出,這個 API 不保存對話狀態,所以 Responses API 的 previous_response_id、檔案搜尋、程式執行與 MCP 工具會被拒絕,必須每次把完整對話送進去。
推理無法關閉,也不能調整強度,reasoning_effort 這類參數會被接受但沒有效果。推理詞元計入輸出上限,所以 max_tokens 設太低時,答案可能是空的。
取樣參數也不能自己調。文件寫明溫度固定為 1.0、top_p 為 0.95,即使請求裡帶了別的值也會被忽略。Raon 自己能代為執行的工具只有網頁搜尋,而且要看組織是否啟用。
能呼叫只是第一關,免費期與條款才是更需要先讀的部分。
延伸閱讀:EAGLE-4 是什麼?貼文稱 Qwen3.8-27B 達 961.6 tokens/s 的條件與授權
Raon-1 mini 的限制與風險:免費期、資料保存與條款
最大的實務風險是免費期。官網寫的是「限期免費」,條款也說 KRAFTON 保留日後收費或導入商業授權的權利,並會在生效前通知。所以不要把服務建立在永遠免費的假設上。
條款還有幾項限制。測試授權是有限、可撤銷的,只供評估與開發,KRAFTON 也可以隨時終止測試或停止服務。
另外,你不能用服務的輸出去訓練競爭模型。條款最後修訂日是 10 月 20 日。
條款也要求使用者自行承擔風險,並補償 KRAFTON 因你的使用或你的代理行動引起的第三方求償。KRAFTON 的總賠償責任上限是 100 美元,爭議由韓國法律與首爾法院管轄。
資料方面,10 月 21 日生效的隱私政策寫明提示詞會保存,並於儲存 14 天後刪除。在你同意的前提下,KRAFTON 會把個資假名化後,用來訓練、評估與改進模型。所以不要在提示詞裡放個資或機密。
服務也可能把資料傳到美國與韓國,部分委外作業在海外處理。若你的資料有地區限制,要先確認這一點。
還有授權範圍的分別。條款明說,Apache 授權只涵蓋 Hugging Face 上下載的模型與權重,並不涵蓋官方託管的 API 與 playground,那一側依託管存取條款。
最後是證據的限制:七項基準都是廠商自測,其中一項是內部基準,完整模型卡需要申請,速度與記憶體沒有數字。這些都要靠你自己的測試補上。
適合誰、不適合誰:試用 Raon-1 mini 前的檢查
Raon-1 mini 適合想做韓文與英文雙語助理原型的開發者,也適合想用 Anthropic 或 OpenAI 相容端點,低成本比較多個模型的團隊。
它不適合需要影像或檔案輸入的應用,因為模型只讀文字。需要長文件推理的工作也要小心,AA-LCR 的分數落後兩個密集模型。正式上線的服務更不適合,因為免費期、模型版本與條款都可能改變。
官方也沒有說明中文表現,只提到韓文與英文,所以以中文為主的使用者要先自己測。
試用前可以準備 20 題自己的任務,涵蓋韓文與英文、查資料、程式修復各幾題。同一批題目也交給你目前使用的模型,並固定相同的框架與設定。
記錄時除了答對率,也要記錄推理詞元占比與延遲。因為推理一律開啟,所以同樣的問題,它可能花掉更多輸出詞元。
最後把 API 條款的版本、模型代號與測試日期存檔。預覽模型會變動,今天的結果下週可能就不同。
Raon-1 mini 常見問題
Raon-1 mini 真的追平 Muse Glimmer 了嗎?
只在部分項目。SWE-Verified 低 1.2 分、BrowseComp Plus 高 2.9 分,但 AA-LCR 長文件低約 14 分,MMLU-Pro 也低。官網也承認紅字只代表專家混合模型中最高。
Raon-1 mini 可以商用嗎?
下載的權重標示 Apache-2.0,原則上允許商用。官方託管 API 則依測試條款,只供評估與開發,日後可能收費。正式商用前仍建議自行確認授權文字。
Raon-1 mini 支援中文嗎?
官方只說明支援韓文與英文,沒有提到中文。如果你的場景是中文,要自行測試。
免費 API 會一直免費嗎?
不保證。官網寫明是限期免費,條款保留收費權利。模型價格目前為零,但詞元用量與請求頻率仍有限制。
為什麼只是預覽版?
KRAFTON 在貼文裡表示這只是第一眼,最終版與更大的模型即將推出。所以現在的規格、分數與服務條件都可能調整。
先用自己的任務測,再決定要不要換
Raon-1 mini 的價值,在於一家遊戲公司用 4B 啟用參數做出可與同類專家混合模型比較的成績,又以 Apache-2.0 放出權重,並提供相容多種工具的免費端點。
但分數是廠商自測,速度與記憶體沒有數字,免費期與資料保存都有條件。我會把它放進測試名單,用韓文與英文任務試過,再決定是否投入。
想持續追蹤開放權重模型與代理工具的更新,可免費訂閱 AI 郵報,並以官方文件與模型卡核對後續變動。
資料來源
- Raon-1 mini preview 官方網站:https://raon-mini.krafton.ai/en
- Raon API 官方文件:https://raon-mini.krafton.ai/en/docs
- Raon API 文件索引與全文(llms.txt):https://raon-mini.krafton.ai/llms.txt
- Raon 託管服務條款:https://raon-mini.krafton.ai/en/terms
- Raon 隱私政策:https://raon-mini.krafton.ai/en/privacy
- Raon-1-mini-preview(Hugging Face,需申請存取):https://huggingface.co/KRAFTON/Raon-1-mini-preview
- Muse Glimmer 30B 模型卡(Hugging Face):https://huggingface.co/meta-models/Muse-Glimmer-30B
- X 貼文(KRAFTON AI 官方帳號,熱度線索):https://x.com/Krafton_AI/status/2112772568776339709