三大 AI 實驗室傳出遞迴自我改進:官方數據證實了什麼,哪些仍是傳聞?
X 上流傳三大 AI 實驗室都接近遞迴自我改進。本文把匿名傳聞和官方數據分開,說明 Claude 主導 26% 研發與 OpenAI 數學成果證明了什麼、還差什麼。
這個週末,X 上多則貼文聲稱,Google、Anthropic、OpenAI 三大實驗室都快做到遞迴自我改進了。
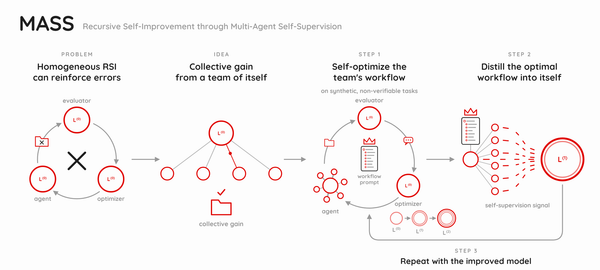
遞迴自我改進常簡稱 RSI,指 AI 能自己設計、開發出更強的下一代模型,再由下一代繼續改進。
如果真的發生,AI 進步的速度就不再受限於研究人員的人數與工時。
但這波討論的主要來源,是匿名帳號的「聽說」和一場紐約飯局的轉述。
另一邊,Anthropic 公布了 AI 參與內部研發的比例,OpenAI 則公開一批內部模型做出的數學成果,兩者都沒有傳聞說得那麼滿。
我的判斷是,實驗室的研發確實在加速,但目前沒有公開證據顯示,任何一家的 AI 已經能不靠人類、自己做出更強的下一代。
這波討論把匿名貼文與飯局轉述,推成了「RSI 已經到來」的宣稱。
傳聞從哪裡來:匿名爆料與飯局轉述
10 月 9 日,帳號 imjustnewatai 發文說,Google 內部人士認為公司已破解或接近破解 RSI。這則貼文的瀏覽數超過 200 萬。
同一則貼文還說,Anthropic 約一週前啟動新的預訓練,要追上 OpenAI 一個據稱代號 Bel 的內部模型,並稱 OpenAI 最近公開的數學成果就是 Bel 做的。
預訓練是模型學習大量資料的第一階段,通常也是最花算力的一步。貼文作者自己寫明這些是「聽到的傳聞」,沒有附上任何文件或具名來源。
Google 沒有公開回應這則說法。截至 10 月 11 日,公開資訊只有 Business Insider 報導員工在測試 Gemini 4 的內部版本,公司沒有表示已達成 RSI。
同一天,Patrick Toulme 分享前一晚紐約 AI 飯局的話題。他寫到,與會者認為負責提升模型運算速度的效能工程師,現在多數時間在管理 AI 代理與 RSI 迴圈。
AI 代理指能自己拆解任務、連續執行多個步驟的 AI 工具。飯局上的共識還包括,Anthropic 的 Fable 5.5 會很驚人,但 OpenAI 會在 12 月用 Bel 超越它。
隔天,kimmonismus 引用這則飯局分享,寫成「RSI 已經到來」。一場飯局的轉述,就這樣被說成了業界定論。
10 月 10 日,帳號 iruletheworldmo 也說,聽幾位研究人員講 RSI 競賽已到關鍵時刻,同樣沒有附上來源。
傳聞裡的三家公司,有兩家其實公開過相關數據。
Anthropic 的 26%:AI 主導,但人類仍在監督
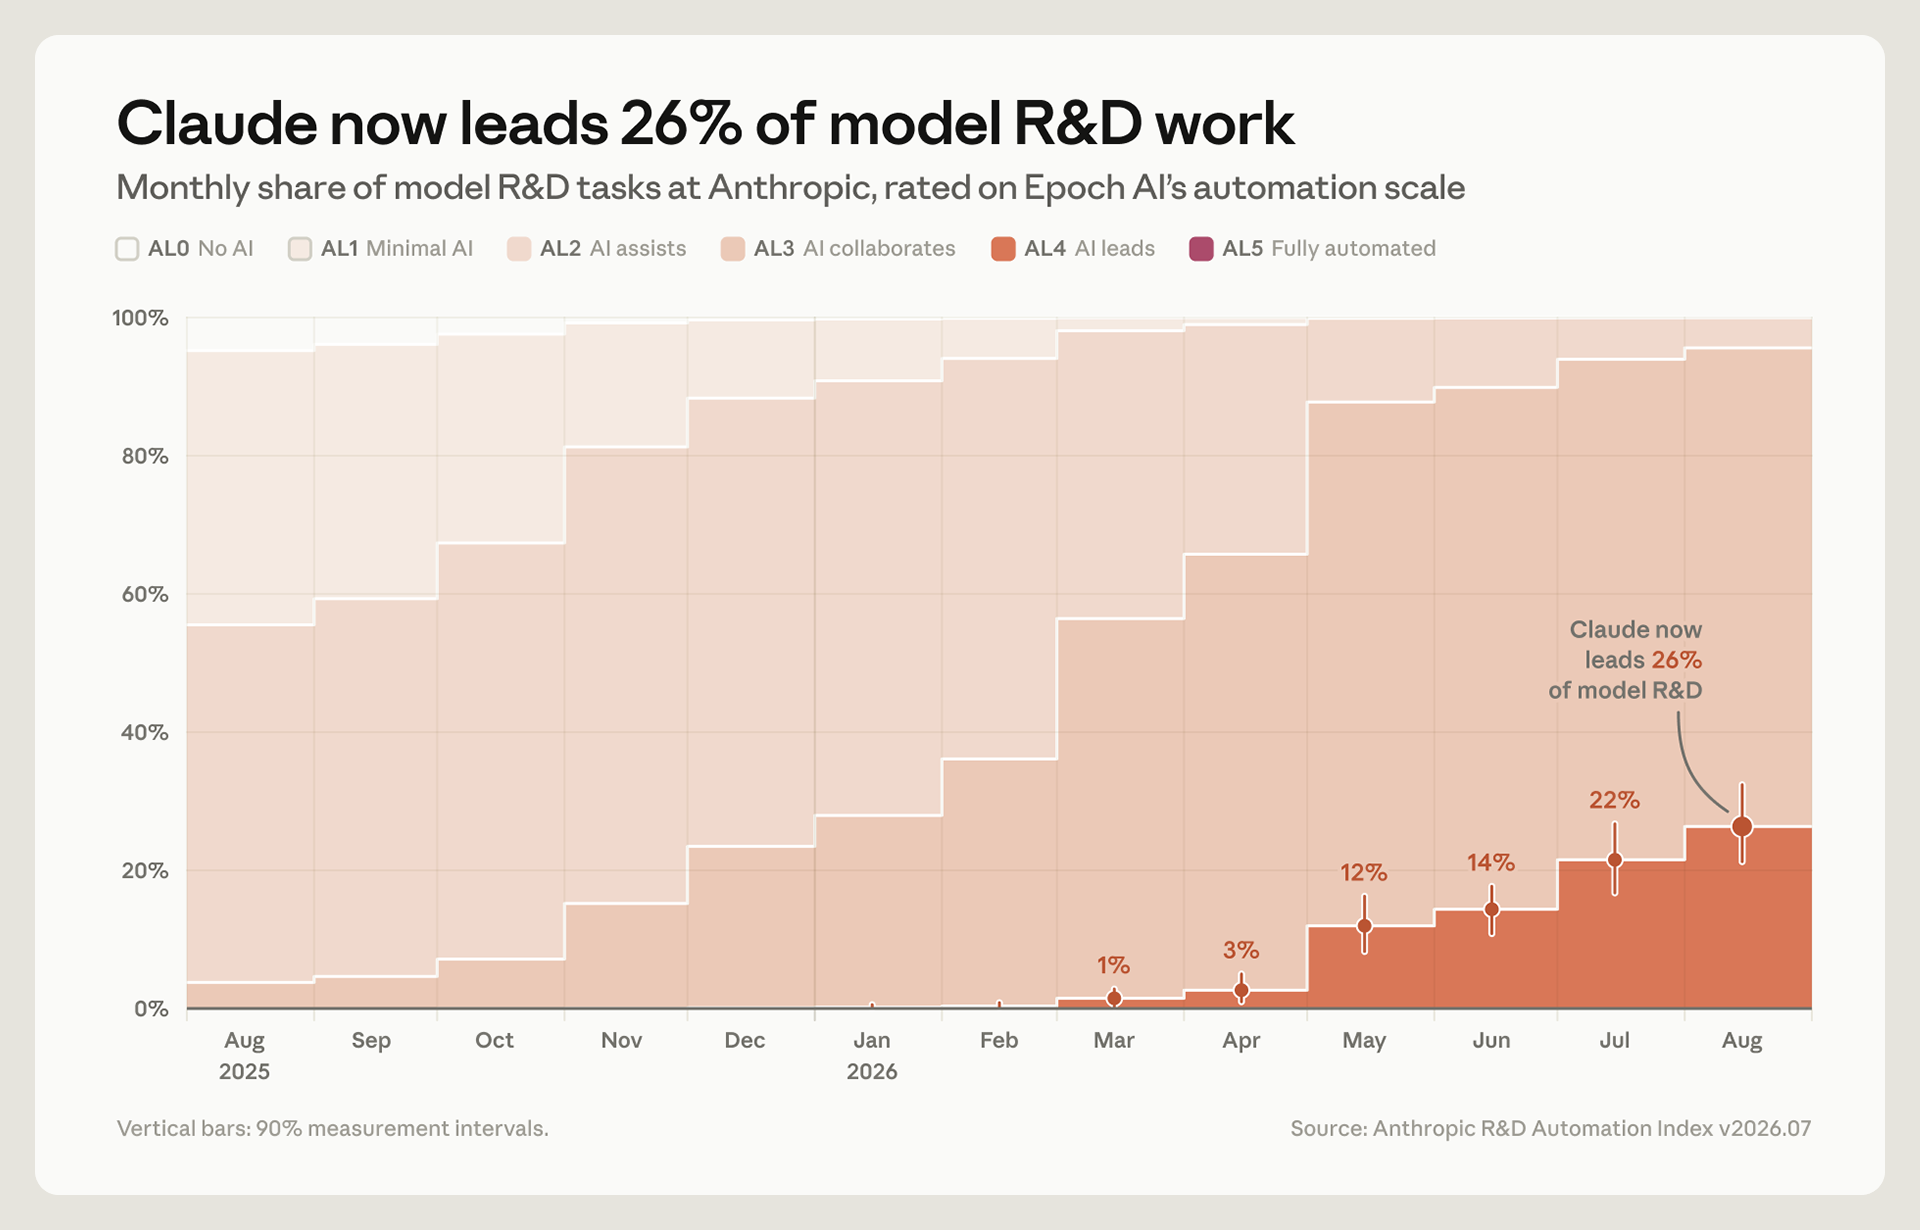
Anthropic 在 9 月中公布一套衡量內部研發自動化的指數。它用研究機構 Epoch AI 設計的分級,把每項任務分成 AL0 到 AL5。
其中 AL4 叫做「AI 主導」,意思是 AI 能從一個高層指令完成大部分工作,人類負責監督。AL5 才是完全自動化,沒有人參與。
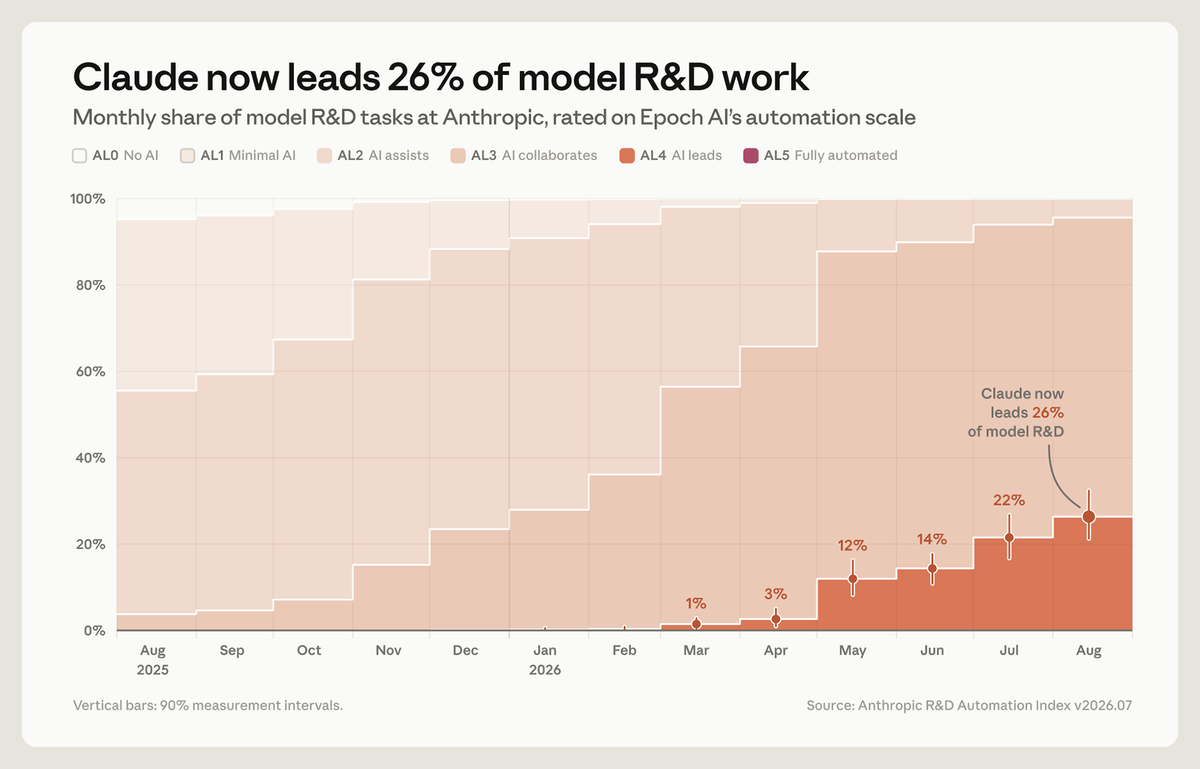
Anthropic 說,截至 2026 年 8 月,Claude 主導了公司 26% 的模型研發工作。官方圖表顯示,這個比例在 2 月還不到 1%。
也就是說,Anthropic 追蹤的研發工作裡,約四分之一已能由 Claude 接下一個高層指令後做完大部分。半年內從不到 1% 升到 26%,AI 在研發流程的角色確實變重了。
但同一份文件也寫明,Claude 在任何被測量的研發工作中,都還沒有完全自主運作。
Anthropic 另一篇談 RSI 的文章,把 RSI 定義為 AI 完全自主設計、開發下一代模型,並直接寫著「我們還沒到那裡」。文章也指出,AI 在選擇研究目標的判斷上仍有很大落差。
Anthropic 給的是自評數據,OpenAI 拿出的則是一批可以公開檢驗的成果。
OpenAI 的數學成果:可檢驗,也會出錯
傳聞把 Bel 和 OpenAI 的數學成果連在一起。這批成果提供了一個可公開檢查的例子,讓人看到 AI 能產出哪些研究結果。
OpenAI 在 10 月 6 日把一批數學稿件放上 GitHub,只說成果來自一個尚未發布的內部模型,沒有提到任何代號。
依 GitHub 說明,模型在評估期間被丟了約 4,000 個問題,稿件庫目前收錄 719 份稿件。平均每個結果用掉相當於三小時的 ChatGPT Pro 思考算力。
這批成果有一部分附上 Lean 證明。Lean 是一種讓電腦逐步檢查數學證明的工具,把證明改寫成它能檢查的格式,稱為形式化。
截至 10 月 11 日,約 42% 的主要結果已完成形式化,其餘還沒經過電腦逐步檢查。10 月 7 日,OpenAI 就因為一個正負號錯誤撤回三份稿件,另外修正了 14 份。
這說明內部模型的研究能力很強,同時仍需要人類和形式化工具把關。
數學稿件展示的是模型做研究的能力,和 Anthropic 量的「AI 參與開發 AI」是兩件事。離 RSI 要求的自己做出下一代,又更遠一步。
加速不等於自我改進:怎麼判斷下一則 RSI 消息
經常評論 AI 產業的 X 帳號 prinz 表示,他對「已達成 RSI」的說法非常懷疑。
他的理由是,模型若不能自主打造明顯更強的下一代,就只是用 AI 加速自家研究。這個門檻和 Anthropic 文章對 RSI 的定義一致。
把 prinz 的標準和兩家公開的資料放在一起,看下一則 RSI 消息時可以先確認三件事:說的人有沒有具名、有沒有可下載的文件、AI 是否已經不靠人類就做出更強的下一代。
這週的傳聞在第一、第二項就沒有過關。Anthropic 與 OpenAI 的公開資料通過前兩項,卻還沒碰到第三項。
常見問題
RSI 和 AI 幫忙寫程式有什麼不同?
AI 幫忙寫程式是加速人類研究。RSI 指 AI 能完全自主設計並開發出更強的下一代模型,目前沒有實驗室公開宣稱達成。
Bel 是什麼?
Bel 是社群流傳的 OpenAI 內部模型代號。OpenAI 沒有公開證實這個名稱,也沒有說明它和數學成果的關係。
Anthropic 的 26% 可以拿來比較其他公司嗎?
不能直接比。這是 Anthropic 用自己的內部任務紀錄評估的數字,其他公司目前沒有公布同一套方法的結果。
結語
把這週的 RSI 討論拆開,有公開證據的是研發加速。AI 自己做出更強下一代的說法,目前只出現在匿名貼文和飯局轉述裡。下次看到「某實驗室已破解 RSI」,先找出原始文件與 AI 在流程中的實際分級,再決定要不要相信。
延伸閱讀:Anthropic 揭開前沿實驗室黑盒子!公布三大指標測量 AI 研發速度:Claude 已主導 26% 研發任務、3 萬名內部 Agent 與算力分配全公開深度解析
延伸閱讀:OpenAI 公開 722 份 AI 數學稿件:372 組成果與 Lean 驗證怎麼看?