ToyBlocks 是什麼?Ai2 用積木模擬定位機器人失敗原因,真機測試怎麼看?
Ai2 推出 ToyBlocks 可控積木模擬,串起任務、示範資料、訓練與故障定位。85,336 段長示範、參考元件與真機 15/30 測試應如何分開理解?

機器人把積木堆倒時,失敗可能來自看錯字母、排錯步驟,也可能只是夾爪沒有放穩。只看最後成功或失敗,很難知道下一輪該改哪裡。
Ai2 在 2026 年 11 月 6 日推出 ToyBlocks,把機械臂與積木放進可控制的模擬桌面,讓研究者能改變資料、任務和模型,再追查結果。
它是 FoundationWorlds 構想的第一個環境,範圍刻意縮小,才能完整掌握積木位置、目標與動作,而不是重建整個家庭。
平台會自動規畫並產生示範,也能訓練、評估高低兩層模型,甚至把其中一層換成正確參考元件,找出另一層在哪裡失手。
第一批釋出含 85,336 段長流程示範,每段再包含多個技能。真機測試則是另一組規模較小的證據,不能把兩種數量放在一起。
我認為 ToyBlocks 的價值,是讓機器人研究能回答「為什麼失敗」,而不只多放一段成功影片。讀者可以從資料如何產生,看到故障如何定位,再對照模擬轉真機的條件。
先理解為何選擇積木,才看得出這個小世界刻意保留了哪些難題。
為什麼只用積木,仍能研究機器人難題?
環境小,讓任務與物理狀態可控制,但翻面找字母、排序與堆疊仍需要感知、推理和精準動作。這使簡單桌面成為可研究的環境,而不只是容易成功的展示。
Ai2 官方介紹把這類環境比作科學實驗中的小型培養皿。研究者先控制少量條件,才有機會分辨改變資料或模型之後,結果為什麼不同。
積木表面有字母或圖片,因此機器人可能需要先翻動,才能看見藏在背面的資訊。拿起一塊積木與判斷它是否符合目標,是兩種接在一起的工作。
例如要堆出三個指定字母,機器人需要先找對積木,再確定字面朝向,最後安排堆疊順序。任務會跨越數個動作,不能只靠一次抓取成績說明全部能力。
環境還能改變積木大小、桌面高度與物理性質。因為每個條件都可控制,研究者可以針對同一種動作安排不同變化,而不必每次重新布置真實實驗室。
官方希望 FoundationWorlds 同時具備合理物理與外觀、自動任務和示範生成、推理及靈巧操作挑戰,以及特定領域內較完整的任務涵蓋。
把範圍限在桌上積木,才比較可能同時掌握這幾件事。它因此適合研究這個領域內的學習問題,並未宣稱同一批結果已涵蓋洗衣、廚房或全部家庭工作。
要逐一改變這些條件,先需要能重複產生的任務與示範。這也是平台不只公開一份固定資料的原因。
85,336 段示範,怎麼從任務自動產生?
規畫器把短技能串成長任務,再由模擬執行、渲染與標註產生訓練資料。研究者可以改變示範組合,觀察模型接著學到什麼。
短技能包含推動、翻面、旋轉,以及抓取和放置。官方使用強化學習與動作規畫產生這些技能,前者透過嘗試和回饋學習行動,後者計算機械臂的移動方式。
產生技能時,模擬器能提供積木的精確位置與方向。這種資訊在真實機器上通常要從感測器推估,因此能協助產生示範,卻不能直接當成部署時已解決感知問題。
接著,任務與動作規畫器 TAMP 會選擇技能、安排順序,並規畫技能之間的移動。例如先翻面確認字母,再抓取搬到目標位置,形成一段完整操作。
長流程與單一動作要分開計數
首批 85,336 段是長流程示範,每段依資料組合包含約六至十二個技能。它們合計接近 1,600 小時機器人執行資料、約 1.44 億影格,並非同樣數量的人類遙控示範。
官方說能在單張 GPU 上平行產生並執行數百個計畫,最高達即時速度的 24 倍。這是資料生成的供應商敘述,不能改寫成實體機械臂動作快了 24 倍。
完整程式庫說明也把執行與渲染分開。執行階段先記錄狀態與動作,畫面由後續渲染產生,再把資料整理成 LeRobot 格式供模型訓練。
同一段執行可以渲染成不同外觀版本,所以多一段隨機背景影片,不一定代表多了一條獨立物理軌跡。理解這個流程,才不會把視覺副本直接當成新的行為經驗。
資料可變之後,研究者才有機會追問,多加哪一種經驗能改善哪一種錯誤。而要定位錯誤,還得拆開決定做什麼與真的做出動作的兩層模型。
高階規畫與低階動作,如何分開定位失敗?
把其中一層換成已知正確的參考元件,就能檢查另一層是否造成失敗。這讓完整任務失敗後,還能繼續追查原因。
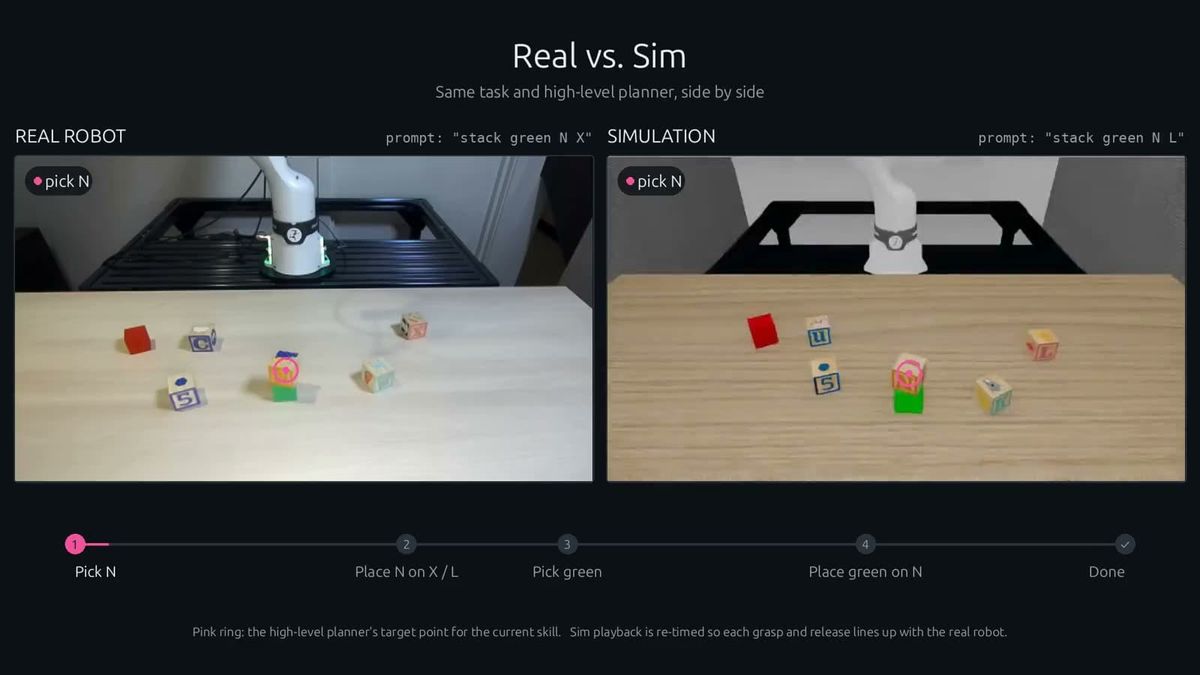
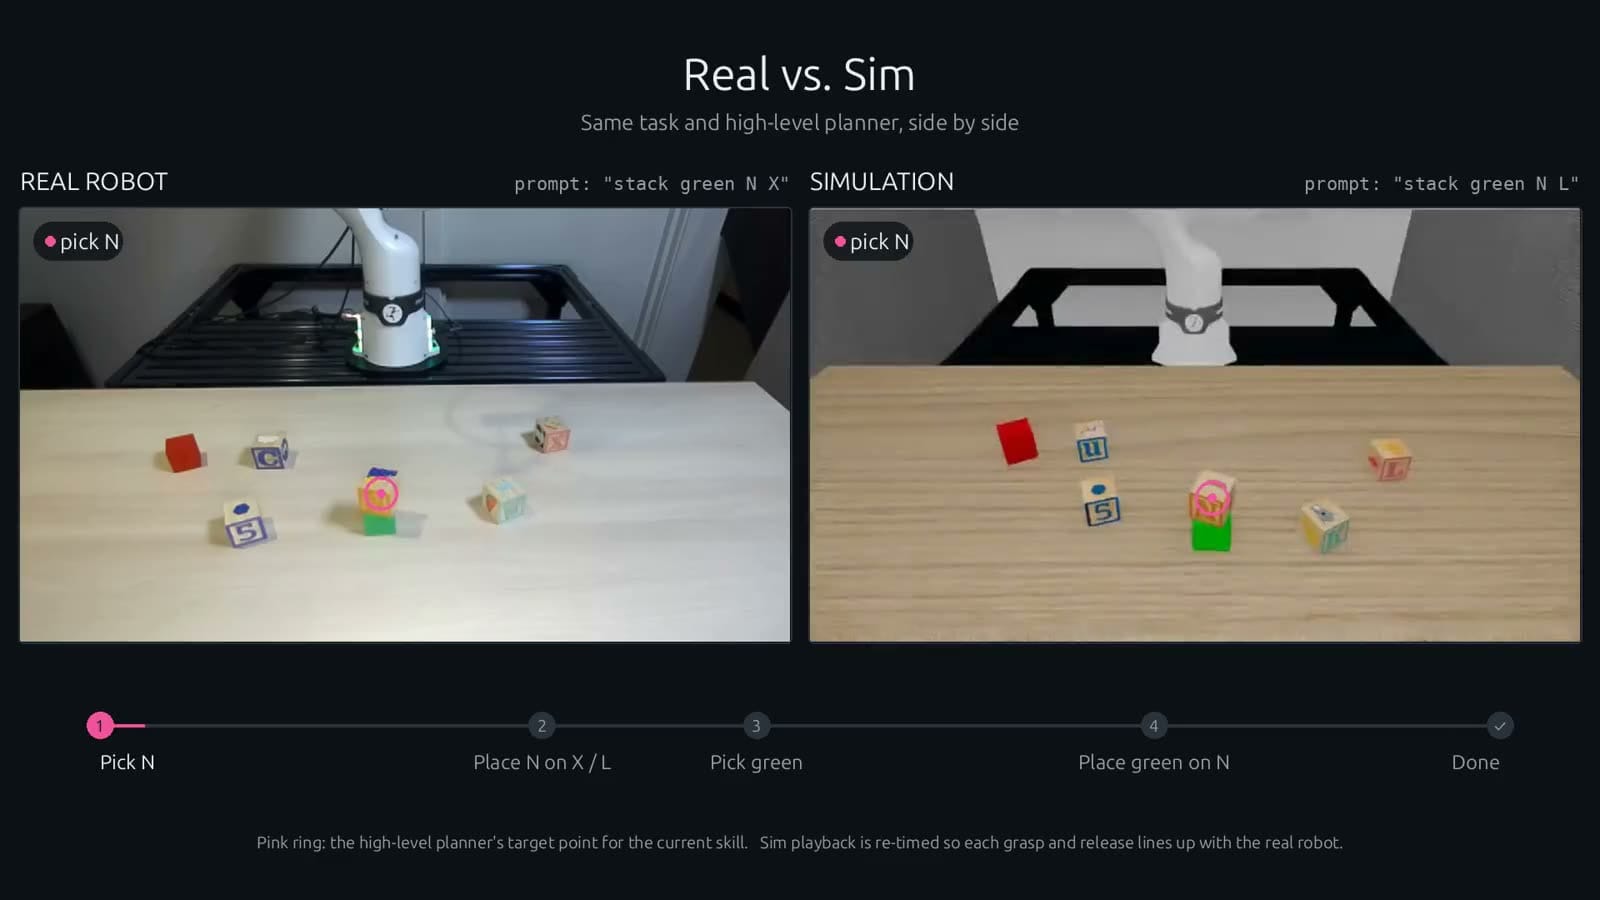
官方示範以 Molmo 2 作高階模型,決定下一步用什麼技能、對哪塊積木執行。它透過畫面上的指向位置指定目標,而不是自行輸出每個關節的全部動作。
ManiFlow 則是低階模型,依指令控制機械臂。完成技能後,它會暫停,再詢問高階模型下一個指令,因此長任務由多輪決定和執行組成。
如果最後字母放錯,可能是規畫器選錯積木,也可能是動作模型沒完成原本正確的指令。單一成功率把這兩種錯誤放在一起,並不容易知道訓練該補哪一層。
正確參考元件不是另一個萬能模型
官方稱這種參考元件為 oracle,可以理解成在受控環境中提供正確計畫或動作的基準。把它替換到高階或低階,便能分別觀察剩下那層的表現。
這裡能做到替換,是因為模擬環境掌握完整狀態與任務目標。它是研究工具的設計,不表示真實機器在每次失敗後都會自動取得正確答案。
ToyBlocks 用 PDDL 表示任務條件,也就是把目標寫成規畫器能判斷的規則。規畫與評估沿用相同規格,因此除了整體成功,也能計算完成了多少步驟。
平台還會記錄執行速度、施加在物體上的力量等資訊。這些資料能讓研究者分辨「做對但很慢」與「尚未完成」,而不只把兩者濃縮成一個分數。
失敗狀態也能送回資料產生流程,規畫新的示範與恢復動作。於是,評估找到的缺口可以成為下一批資料的起點,形成同一套研究循環。
延伸閱讀:FineART 開放機器人資料與模型:40,543段示範,子任務標註為何重要?
積木位置、字母與任務變化,如何檢驗泛化?
測試把熟悉範圍內的新配置,和超出訓練範圍的配置分開,避免只用同一種成功率概括能力。兩者要求模型處理的變化不同。
官方研究堆疊、拆堆、翻面與旋轉。例如只在桌面左側產生訓練場景,再到右側測試,便能研究模型是否把技能延伸到原本沒有練習的位置。
另一種安排是用兩塊與五塊的高度訓練,再測試三塊與四塊的堆疊。這與跨越原本工作區邊界不同,所以內插與外推不宜混成「任何位置都能做」。
資料產生器還能調整某種技能比例,或補足既有資料缺口。研究者因而可以比較,增加旋轉與抓放示範之後,翻面的表現是否跟著改善。
拼字還需要判斷任務是否可能
若場景缺少某個目標字母,機器人就無法完成拼字。官方對工具代理的研究特別保留這種情況,讓模型不只要找與堆,還要判斷能不能完成。
其中一組設定有一半場景缺少必要字母,模型成功完成或正確宣告不可完成的比例為 63%。這個數字把兩種正確結果合計,不能直接當成真機堆字成功率。
同樣地,積木表面有規律時,模型可能從已看到的圖片或字母推斷背面;沒有規律時,便需要多翻幾面。任務設計因此能拆開推理和實際搜尋的關係。
這些測試說明平台能研究哪些問題,並未證明現有模型已普遍解決空間泛化。模擬裡能分出原因之後,仍要把能力帶到真實機械臂,觀察物理差異。
模擬轉真機的 50%,代表什麼範圍?
完整三字母任務在真機完成十五次、共三十次,和單技能八成多的成績回答不同問題。兩種測量需要保留各自分母。
官方以 Franka FR3 機械臂搭配 Robotiq 夾爪,測試三十種場景配置,每個場景有四至十塊訓練時見過的積木。若操作人員因不安全動作而介入停止,也會計為失敗。
高階 Molmo 2 加低階 ManiFlow 的完整系統,在模擬完成 111 次、共 200 次,成功率 55.5%。真機完成 15 次、共 30 次,成功率 50%。
這組比較採用最容易的場景,字母可見而且朝向正立。因此,它不能直接回答字母全被遮住、任意新物件或整間家庭的長流程表現。
單獨測量 ManiFlow 技能時,模擬與真機分別為 80% 與 81.1%,計算對象是技能執行。高階系統則算整段拼字任務,不能用前者替完整任務補成八成成功。
轉移之前,物理與視覺都經過處理
資料生成前,團隊先調整模擬中的關節摩擦與馬達相關慣性,讓模擬軌跡更接近真機。生成時,再變動物體大小、摩擦、桌高、光線、材質與相機條件。
執行時使用正面與手腕相機取得觀察。若模型需要深度圖,官方以成對 RGB 影像透過 FastFoundationStereo 推估較乾淨的距離資訊,而非直接依賴有雜訊的深度感測讀值。
因此,從模擬到真機的結果,來自資料、物理校準與觀察處理共同配合。它不是把任意模擬模型直接放進不同硬體,就保證能得到相同成功率。
現在公開哪些工具,哪些仍待後續釋出?
目前包含模擬資產、任務與示範產生器、示範資料、模型訓練和評估工具,整合式強化學習訓練仍是後續計畫。
這與前面技能由強化學習產生並不矛盾。一部分能力已用來建立技能,但官方明說,完整整合的 RL 訓練功能尚未包含在當前套件。
兩個已訓練模型分別以 Molmo 2 與 ManiFlow 為基礎,用來展示高低階分工。團隊另計畫在數週後提供更大資料、更多技能與更完整基準,這些都需要等待後續釋出。
程式主庫採 Apache 2.0,但 cuRobo、ManiFlow、Molmo 2 與代理子模組,以及下載資產另有條款。主庫授權不能代替全部素材的使用條件,技術報告也仍標示即將提供。
延伸閱讀:Gym-Anything for Robotics 公開 RoboWorld:AI 建模擬環境,測試 0% 要怎麼讀?
ToyBlocks 常見問題
這是新推出的一台機器人嗎?
它是以機械臂與積木為核心的模擬研究框架,串起資料產生、訓練與評估,並用既有真機設備研究轉移效果。
85,336 段等於同樣數量的抓取嗎?
那是長流程示範,每段約包含六至十二個技能。技能執行、影格與完整任務,各有不同計數方式。
現在已附全部未來功能嗎?
整合式強化學習訓練與較大後續資料仍在規畫,技術報告尚未提供。本文沒有下載大型資料或實際執行訓練。
從一種可定位的失敗開始理解機器人學習
ToyBlocks 把任務、資料、模型和評估接在同一個受控世界裡,讓一次失敗有機會回到可以改變的具體原因。
如果你想看懂機器人示範,我會先選擇「找錯物件」或「選對卻沒放穩」這類明確問題,再看研究如何替換參考元件和補充資料。這比只用一次成功影片判斷整套能力,更容易理解下一步需要改善什麼。