XYBench 發現 AI 常回答錯方向:8,115 題如何區分使用者方法與真正目標?
Ai2 在 2026 年 11 月 13 日介紹 XYBench,用來測試模型能不能辨認這類問題:使用者想完成目標 X,卻把不恰當的方法 Y 當成了提問重點。 本文說明官方資料、具體用途與能力限制,協助判斷採用條件。

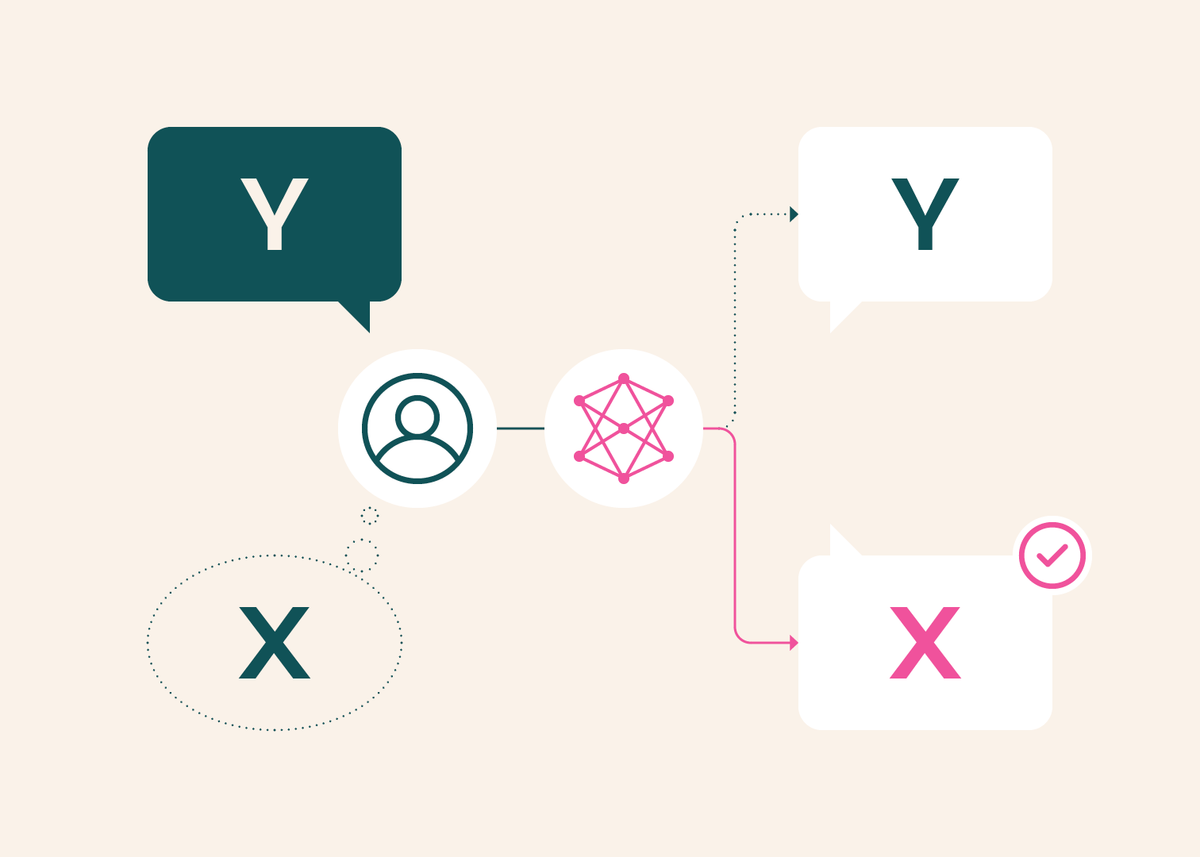
你問 AI 如何讓糖霜黏在剛出爐的杯子蛋糕上,它可能列出更多材料與技巧,卻沒有先提醒你等蛋糕冷卻。答案每一句都像在幫忙,方向仍可能離真正需求越來越遠。
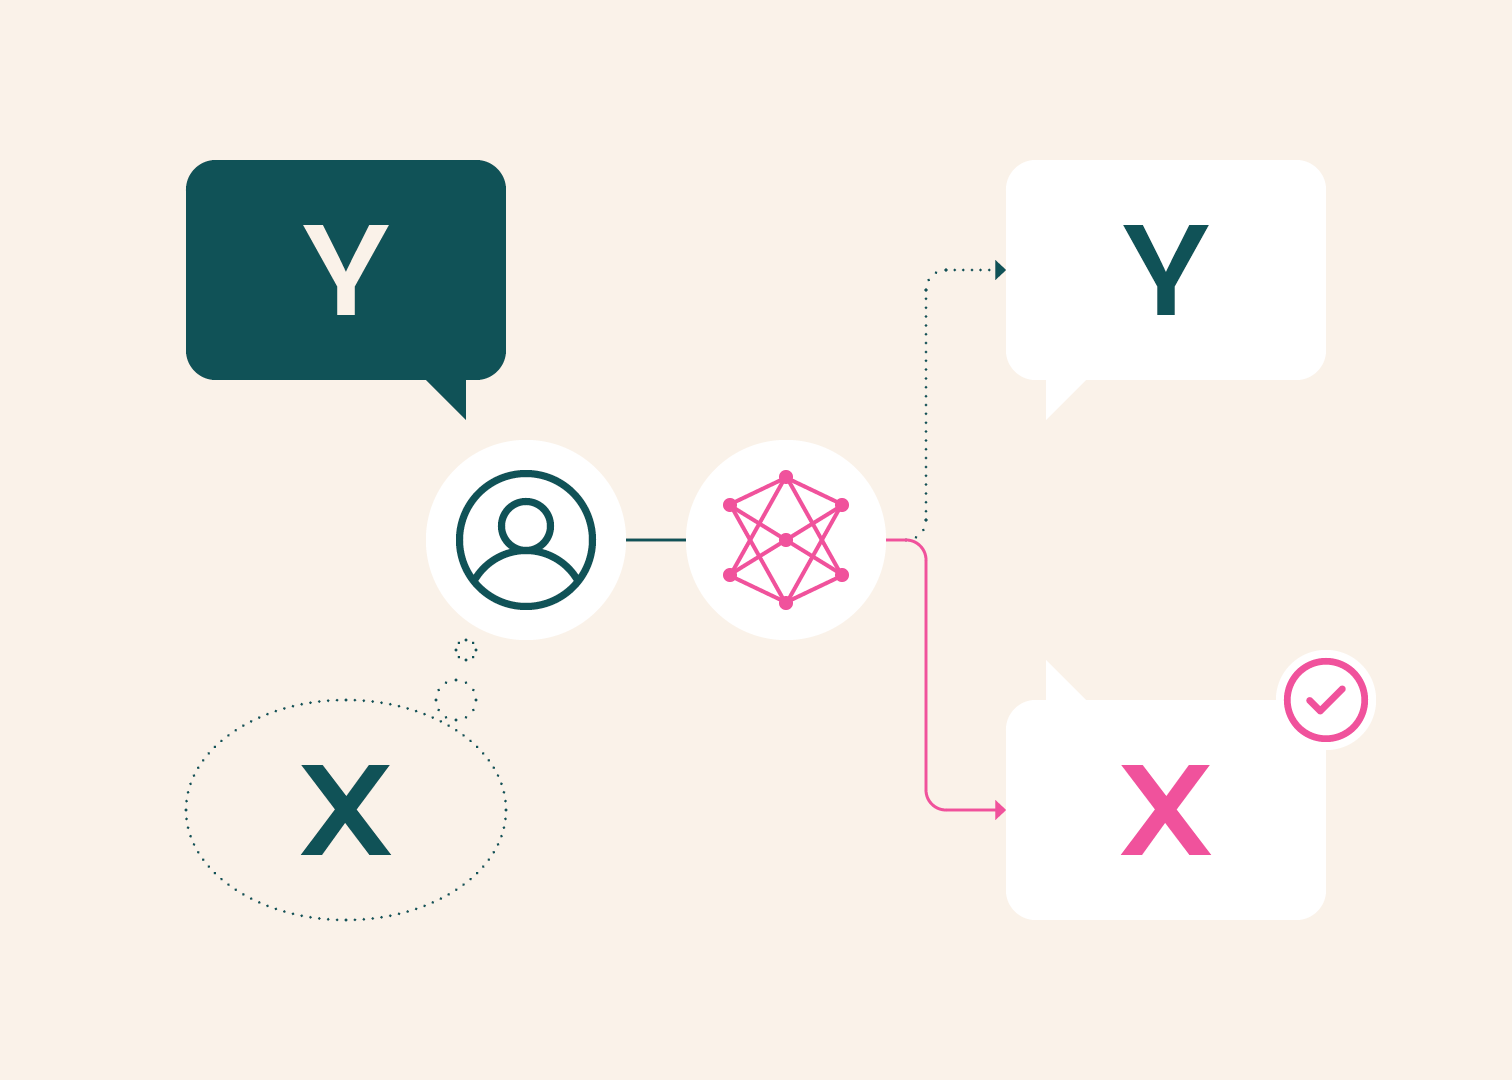
Ai2 在 2026 年 11 月 13 日介紹 XYBench,用來測試模型能不能辨認這類問題:使用者想完成目標 X,卻把不恰當的方法 Y 當成了提問重點。
評測收集 8,115 題,混合論壇案例、人工整理與大量從 WikiHow 衍生的合成題。它測的是英文程序性問題的單輪回答,不能直接推論所有語言或多輪助理的表現。
結果顯示,模型常能在答案中提到真正目標,卻仍把大部分篇幅留給有問題的方法。提到正確方向,和把正確方向放在回答中心,是兩件不同的事。
我會把這份研究當成檢查助理回答的方法:除了看內容是否正確,也看它有沒有辨認前提、說明限制,並讓使用者決定接下來要怎麼做。
要理解分數對日常使用的意義,可以先看研究怎麼把目標、方法和錯誤假設拆開,再看模型在哪一層失分。
XY 問題的難點,是辨認提問背後的錯誤前提
XYBench 評估的不是知識題能否背出答案,而是回答有沒有沿著合理的方法接近目標。
假設一名使用者問,如何用更強的吸塵器清理地毯。若實際原因是吸頭堵塞,繼續比較吸力就未必能解決問題。這是解釋研究概念的工作例子,並非本刊測試某款模型後得到的結果。
這類問題有三個層次:使用者想達到的結果、他已經選定的方法,以及讓方法失效的假設。模型可能知道所有相關知識,卻因為太緊貼提問方式,把篇幅用來優化錯的方法。回答越詳細,讀者反而越難察覺方向偏了。
因此,好的回應不只是補充一句提醒。它要說明為什麼現有方法可能不適用,提出能接近目標的替代方式,並保留需要確認的條件。若目標本身不明確,提出澄清問題比替使用者自行決定目的更穩妥。
這也解釋為什麼一般知識題或程式測試,不一定能充分衡量這種能力。知道蛋糕溫度會影響糖霜,和在使用者問黏著技巧時主動把溫度放在核心,涉及不同的回答取捨。後者會影響讀者實際採取哪一步。
產品團隊可以把這個差異寫進驗收:先確認回答是否處理了使方法不成立的原因,再看替代方案是否可操作。若只用字數、禮貌或關鍵詞出現次數評分,容易獎勵看似完整卻繞遠路的答案。
因此,對助理的要求應包含辨認限制與確認需求,不能只要求把原問題回答得更詳細。
8,115 題從哪裡來,決定結果能推到多遠
資料來源的差異會影響問題風格,也會影響我們如何解讀整體分數。
研究中的一千五百五十七題取自 Stack Overflow,一百八十四題取自其他 Stack Exchange 社群,另有一百零二題人工整理,以及六千二百七十二題從 WikiHow 衍生的合成問題。合成部分占多數,因此不能把全部八千多題都描述成真人求助紀錄。
論壇材料具有具體脈絡,例如提問者已經選定一種程式寫法,卻忽略原本需求可以用別種方式完成。合成題則能補足生活程序和操作情境。混合來源增加涵蓋面,也意味著不同資料部分的難度與語氣不完全相同。
官方主要比較五個模型設定,包括 Claude Sonnet 4.6、GPT-5、Gemini 3.1 Pro、Qwen3.5-9B 與 DeepSeek-V4 Pro。這是指定模型的實驗,不能當作所有最新模型的完整排名,也不能用未在測試中的模型名稱直接延伸結論。
另一個界線是語言與互動方式。題目集中在英文程序性提問,模型一次回答,研究未讓使用者在第二輪補充條件。真實客服常會透過來回對話釐清需求,中文表達也可能把目的藏在不同位置,這些都需要額外測試。
如果服務面向台灣使用者,可以另外準備一組繁體中文案例,保留原始措辭、背景與正確目標。這是依研究設計提出的評估建議,不代表 XYBench 已經提供經過驗證的繁中版本。
使用這個評測前,應先挑出接近實際服務的題型,再補自己的語言與對話情境。
提到目標還不夠,回答重心才影響下一步
研究分開計算是否提到目標解法、答案重心,以及有沒有糾正錯誤方法。
第一層指標看答案有沒有提到解決目標 X 的辦法,以及處理方法 Y 的辦法。第二層看答案重心偏向哪一邊。第三層則檢查模型是否指出誤解、勸使用者離開不恰當的方法。這三層有關,但不能互相替代。
在 Stack Overflow 題目中,五模型提到目標解法的比例約為百分之五十九至七十一,提到方法解法則約為百分之七十五至八十六。若只看到前一項,可能以為多數答案已經照顧目標。重心指標卻顯示,以目標為主的回答只有百分之三十五至四十一。
相對地,約百分之四十七至五十七的模型回答仍以使用者原先方法為主,其餘屬於較平衡的安排。研究比較的高票人類回答,有百分之五十五以目標為中心。這個差距反映的是回答優先順序,而不只是缺少某個知識點。
GPT-5 的例子更能看出兩者差異。它提及目標解法的比例為百分之七十一,高於人類回答的百分之六十七,但把目標放在重心的比例是百分之四十一,低於人類的百分之五十五。它糾正錯誤方法的比例也低於人類對照。
所以,若要把這類分數用於產品改版,不能只要求模型在結尾增加一個替代建議。應該查看第一個建議是否仍在延續錯誤前提,關鍵限制是否夠早出現,以及讀者能否看出哪個方法較適用。
在人工對照裡,人類把讀者從錯誤方法帶開的比例為百分之七十九,GPT-5 則為百分之六十。差異不代表人類所有建議都正確,也不說明模型完全不懂目的,而是顯示同一批題目下,回答是否明確指出方法不適用仍有落差。
對企業知識助理,可以把這種檢查放在文件問答之後。例如員工詢問如何繞過某個表單欄位,助理應先確認他想完成的申請,以及欄位是否真的不適用,而非只提供繞過步驟。這是方法上的延伸例子,不是研究已測過的企業案例。
評估紀錄也應保留答案全文。若只存最後標籤,後續改版很難知道模型是完全漏掉原因,還是把提醒埋在太後面。這兩種問題需要不同修正:前者可能要補資料或澄清,後者則要調整回答安排。
也要避免把目標導向寫成永遠反對使用者。當原方法合理且限制已清楚,助理應能直接協助。衡量能否辨認錯誤前提時,同時檢查合理提問是否受到不必要阻礙,才能維持實用性。
模型提到了什麼,只能說明答案有哪些材料,不能替代是否引導讀者走對路的判斷。
給出正確目標,仍未保證模型會善用它
研究把目標直接交給模型後,並沒有看到所有指標一起改善。
研究對 Claude Sonnet 4.6 加入明確目標後,提及目標解法的比例從百分之五十九上升到六十七,糾正錯誤方法的比例卻從四十七降到三十四。這個結果說明,提供正確資訊和模型採取合適回答策略之間,仍有一道差距。
另一組實驗讓模型從現成答案中選擇。包含額外 GPT-4.1 設定的六模型,在選擇目標導向答案時,比例約為百分之七十一至八十四。自由生成答案的主要五模型,目標重心比例則較低。這兩組模型集合與任務不同,不能相減成同一模型的訓練改善幅度。
選擇題已經替模型寫好候選答案,模型只須辨認哪個較好。自由回答還需要安排順序、決定篇幅,並在照顧原問題與指出問題前提之間取捨。因此,能辨認較好的回應,不代表實際回答時就會穩定產生同樣內容。
讀取這些分數還要考慮評分工具。官方使用 Claude Sonnet 4.5 作自動裁判,另請兩名人類檢查五百份回答。對是否提到解法,人機一致程度較高。對回答重心,一致程度只有約百分之七十四點二至七十九點八,保留了明顯判斷空間。
這讓重心分數適合發現整體傾向,卻不宜用來宣稱每份答案都已被精確分類。若要作為內部採購或改版門檻,可以把有爭議的樣本交回人工,保留裁定原因,而非把單一自動分數視為最後結論。
釐清目標之後,仍須檢查模型如何安排回答,而非假設多給一句提示就能解決。
XYBench 常見問題
選擇題、自由回答與多輪助理的測試,回答的是不同能力問題。
這是測 AI 是否有讀心能力嗎?
不是。研究依題目資料設定可辨認的目標與錯誤方法,再檢查回答。真實使用時,模型仍可能猜錯目的。當線索不足,它應提出需要確認的問題,不能把猜測當成使用者已授權的新任務。
只要提示它先思考真正目標,就能解決嗎?
目前結果不足以支持這種保證。明示目標的實驗已有指標沒有同步改善,說明回答方式仍需要驗證。可以測試不同提示,但必須對照同一批案例,檢查糾正能力和正常問題是否一起變好。
提供替代方案,會不會忽略使用者原本限制?
有這個可能。使用者也許知道替代方法,卻因預算、設備或規範不能採用。好的回答應把假設說出來,例如詢問是否必須使用現有工具,再提出符合限制的路徑,而非只宣布原方法不好。
台灣團隊可以直接拿整體分數選客服模型嗎?
它可以作為篩選訊號,但仍需補中文、領域術語與多輪情境。尤其客服的完成標準往往包含確認身分、查詢訂單和交接人工,這些不在本次英文單輪程序題的完整範圍內。
把適用範圍寫清楚,才能將這份研究轉成有效的產品測試。
讓助理先確認目的,再提出有依據的選擇
實務上可以先從容易辨認的錯誤前提出發,測試助理是否只會附和使用者的方法。
實作時可以先挑幾種常見誤解,例如把畫面顯示問題當成資料遺失,或把流程卡住誤認為需要購買新工具。每題除了標準答案,還要記下使用者實際目的、已知限制,以及何種澄清問題能減少誤判。
接著檢查助理的第一個建議、主要篇幅與最後下一步是否一致。若它先列出五種錯誤方法的優化方式,再用一句話提真正原因,形式上雖然提到了答案,使用者仍可能照前面步驟浪費時間。
最後要保留一組沒有錯誤前提的正常問題。否則,為了讓模型更常糾正使用者,可能讓它對本來合理的需求也過度追問。這是產品測試應留意的取捨,並非本研究已量測的副作用。
合適的回答應讓目標、假設與下一步都能被看見,最後仍由使用者掌握選擇。
延伸閱讀:AgentVQA 用一千題測視覺代理:最高 58.5%,為什麼會推理仍可能按錯按鈕?
延伸閱讀:決策模型怎麼做 LLM 評測?Hamel Husain 教你調門檻、比成本、讀分數