CATT 追查 AI 訓練來源:答案答對了,為何仍找不到教過它的文件?
CATT用虛構知識建立已知訓練來源,檢查AI資料歸因。解析整篇平均如何稀釋關鍵文字、負對數勝算與高分詞元改善,以及單詞答案與版權追查的界線。

CATT 問的問題和搜尋來源不同:AI 已經答對一個問題,研究者能否找回真正讓它學會答案的訓練文件?
模型可以引用一個相關頁面,但相關不等於曾經教會它。要測這件事,先得知道正確的訓練來源,否則方法猜錯時也很難發現。
東北大學與 MIT 研究者在 2026 年 10 月 29 日公開 CATT 論文,讓模型學習人工編造的知識,藉此建立已知答案的來源追蹤測試。
研究發現,增加同一事實的不同表述,或加入詞彙很像卻無關的內容,會讓部分既有歸因方法更難找回證據。答案學會了,來源分數卻可能被整篇其他文字稀釋。
作者調整評分方式與關鍵文字的聚合,讓多個方法在測試裡改善。但成果仍限於特定微調與單詞答案,沒有直接解決所有生成內容的版權追查。
對關心 AI 透明度的讀者,它提供的是如何驗證來源追蹤工具的線索。先看研究怎麼替模型建立確定的學習紀錄,才能理解後面的改善。
CATT 怎麼知道哪份文件真正教會模型?
研究先讓模型學一套不存在於原始知識裡的規則,讓答案的可能來源可被列清楚。這種安排避免研究者把模型原本就知道的內容,誤算成新增文件的影響。
依原始論文,團隊使用 Qwen3.5-4B,透過 LoRA 微調學習虛構事實。微調是在既有模型上繼續訓練,LoRA 則只更新一部分額外參數,讓實驗較容易反覆進行。
虛構事實讓來源有答案可對
第一種任務教模型新的函數對應。例如,假設一個新符號無論收到哪個數字,都固定回傳另一個新符號,研究者就能明確列出哪些訓練文件教過這個對應。
測試問題會換成訓練時沒出現的問法,因此不只是在找完全一樣的句子。模型要能答出新規則,歸因工具則要把支持規則的文件排在其他文件之前。
第二種任務更接近條件判斷。虛構規則依物件的某個屬性,把它分到不同隊列,測試時再給新的物件組合,觀察來源工具能否找到決定答案的規則。
這兩種任務都用人工設計的知識維持可核對性。它們沒有直接重現整個網路的資料規模,但讓「哪份文件支持這個答案」不再只是研究者事後猜測。
研究也把「同一事實有幾份文件」和「一共要學幾個事實」分開調整。前者增加的是同一知識的不同證據,後者增加的是彼此競爭的知識,混在一起就無法知道工具為何變差。
多數方法會在三個資料順序種子上比較。種子控制訓練時的隨機安排,因此不同執行間的變動,也需要留在結果裡,而不是只選最好看的一次作結論。
要是跳過這一步,只拿真實名人或城市知識測試,模型可能在許多地方學過同一件事。即使工具找到一篇合理文章,也難以知道它找到的是原因,還是另一個相同說法。
有了已知來源,CATT 才能逐一增加資料難度,而不是把不同資料集的差異混成一個成績。
Can we trace an AI model's answers back to its training data?
— Steven Yu (@lamsheeper) October 30, 2026
Surprisingly, even when we know exactly which documents taught a model a fact, attribution methods often fail to find them.
Our CATT benchmark investigates why and uncovers two simple fixeshttps://t.co/mgmOj0q4V7🧵 pic.twitter.com/LOoKiHq5ef
相同知識寫得更多,為何反而難找證據?
文件越多不一定讓歸因更容易,因為支持答案的線索可能只占整篇少數文字。資料的重複程度和文件裡的其他內容,都會改變來源分數。
這裡的重複不是把同一檔案複製很多份,而是用不同說法表達同一事實。這更接近網路文章的情況:同一件事可能被放進介紹、案例或不同風格的敘述。
看起來相似,未必真的支持答案
研究也加入模仿問題格式、卻不提供所問答案的文件,測試工具會不會只抓表面詞彙。這項干擾只用於函數任務,沒有套在所有條件分流任務裡。
假設問題問某個函數的回傳值,一份文件雖然寫得很像測試問題,談的卻是另一個函數,就不該取得很高的來源排名。這是本文延伸的解釋例,不是新增研究數據。
CATT 的召回率也有明確分母:若一個問題有若干份已知支持文件,就看最高的同樣數量排名裡,找回其中多少。它測的是證據找回能力,不是模型答案答對多少。
假設一個問題有三份支持文件,工具前三名找回其中兩份,召回率就是三分之二。即使模型答案完全正確,工具仍漏了一份來源,這也說明兩種成績不能互相代替。
相反地,一個方法可能很會找詞彙相似的文件,卻沒有辨認哪些文件真的教過規則。因此,研究才需要在已知支持文件之外放入干擾,避免只獎勵看起來像來源的結果。
因此,模型可以把事實學得很好,來源工具卻排錯文件。兩件事沒有矛盾,因為回答問題和追蹤訓練影響使用不同的判斷方式。
作者觀察到,部分依學習訊號計分的方法,遇到更多表述與干擾時表現下降。相對地,簡單的詞彙搜尋在這組資料表現不錯,也提醒讀者這個測試仍有明顯的文字線索。
這不代表一般搜尋都比歸因工具可靠,而是受控測試把某些失敗暴露出來。下一步就要拆開一篇文件的總分,看有用線索究竟在哪裡消失。
換評分與挑關鍵文字,35到72個百分點怎麼讀?
作者修改的是現有歸因工具如何評估文字貢獻,而不是另外訓練一個更會答題的模型。關鍵變化在文字位置的計分,以及這些分數如何合成一篇文件的排名。
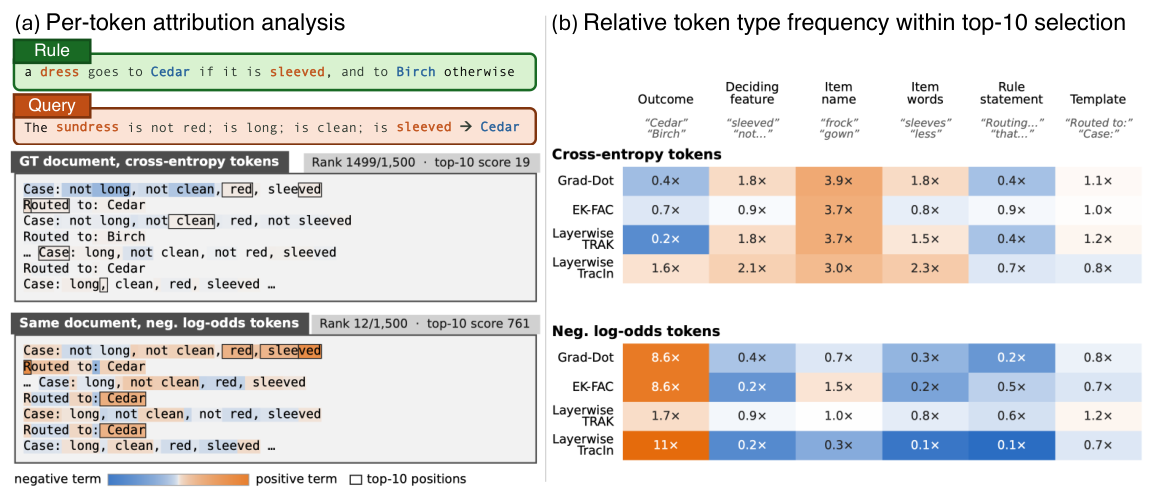
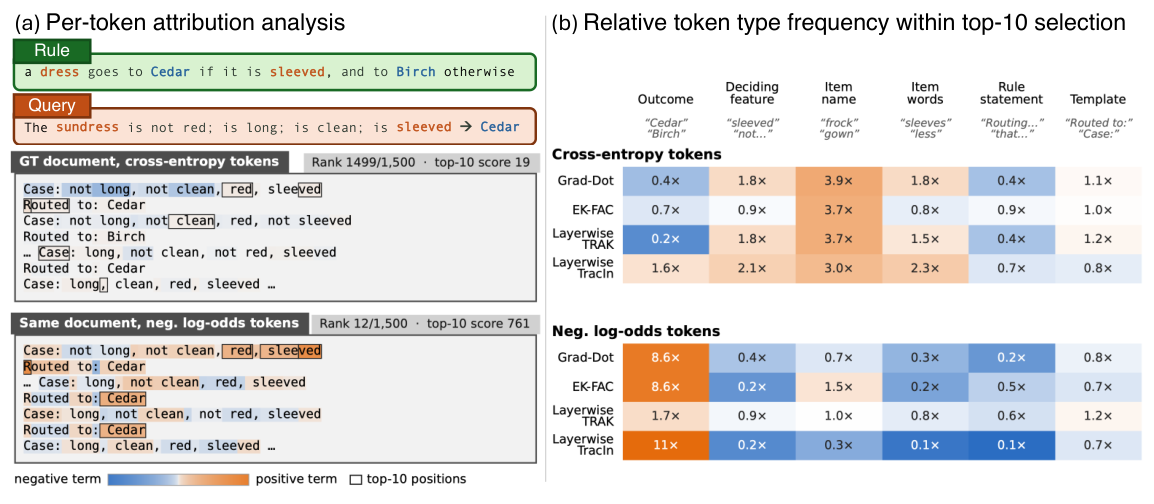
模型處理文字時會切成 token,也就是文字的計量與處理單位。一篇文件可能只有少數 token 直接表達所問的事實,其餘內容則是背景或敘述。
模型已經很有把握的詞,也可能很重要
研究指出,常用的交叉熵計分,會讓模型已經很有信心預測的正確文字,留下很小的梯度。梯度可理解為訓練時調整參數的方向與強弱,這裡被用來估計資料影響。
但「模型很確定」不等於「這個詞沒有教學價值」。如果關鍵答案詞的訊號已被縮小,再把整篇所有文字平均,重要證據就可能被背景內容沖淡。
作者改用負對數勝算處理梯度,保留高信心文字的影響訊號。再只聚合較高分的文字位置,讓文件排名更集中於支持答案的部分。
這兩個改動是互補的:只挑高分文字,仍可能挑到原本計分偏好的背景詞,只換計分卻平均全文,也可能繼續受到其他位置影響。
改善幅度屬於受測方法和設定
論文報告,對六種具有相應詞元分數的既有方法,兩項修改在受測設定的平均召回率提升三十五至七十二個百分點。這不是一般使用者上傳任意文件,就能得到相同改善的保證。
官方也展示一個近乎完美分開支持文件與其他文件的單例。但單例的百分之百召回率,只能說明訊號在那個設定裡可以被找出,不能代表整份研究或所有真實資料都達到百分之百。
甚至挑幾個文字位置最合適,也會隨任務改變。規則判斷可能需要多個位置共同表達條件,因此不能把只看十個 token 當成普遍最佳答案。
受控題庫的改善還需要接受另一種檢查:排名高的文件,拿掉後是否真的會影響模型?
把文件移除再訓練,為何答題變差反而是好訊號?
如果移除高排名文件後,模型更難答出相關事實,表示排名較能指出有影響的資料。這是拿實際重新訓練的結果,檢查來源分數是否有意義。
團隊在外部的 FTRACE-TREX 測試這件事。流程先替訓練文件排序,按固定數量移除,再重新訓練模型,測量相關事實的正確率下降多少。
外部重新訓練測試使用八個種子,讓同一移除策略接受多次訓練波動的檢查。這和 CATT 多數方法的三個種子是不同設置,不能把兩邊當成同一批模型執行。
這次希望下降的是移除證據後的表現
這和一般追求高準確率的圖表方向相反。若工具真的挑中重要文件,移除它們理應讓相關知識比較難學,所以較大的下降,反而支持歸因排序更有效。
在最大移除數量的設定,一個方法的正確率的下降幅度約由八個百分點增至四十個百分點,論文依未四捨五入數值報告約四點九倍改善。這是移除重要資料的效果,沒有讓模型答題能力提高四點九倍。
外部測試也顯示,改用負對數勝算對三個受測方法在各移除數量都有幫助。但再加上只取高分文字的效果較不一致,相對於全部文字的同種計分,可能往兩邊變動。
這個差異讓結論更具體:更好的學習訊號處理有跨測試證據,最佳聚合方式仍會依資料而變。不能因兩個改動在 CATT 配合得很好,就要求每個外部任務都得到同樣結果。
而重新訓練本身很花資源,也解釋為何實務上需要近似歸因方法。CATT 的貢獻是讓近似方法有一個比較清楚的檢查起點,而不是讓昂貴的因果驗證消失。
CATT 對來源透明度有什麼用,還不能判定什麼?
它讓來源工具先面對已知答案的測試,並把目前仍不可靠的條件具體列出。這比只展示幾個看似合理的來源,能更直接檢查工具有沒有找對。
但研究主要處理單一文字單位的答案,以及單一任務微調。長篇回答可能結合多個概念與文件,不能假定同一種排序已能完整追出每個句子的訓練原因。
影響分數不是法律上的歸屬判定
論文也提醒,文字位置的梯度分數不是刪掉該詞後的精確因果結果,因為後面的模型狀態已經包含前文資訊。彩色標記可以協助分析,仍需要理解它計算的是什麼。
因此,這項研究不能單憑一個排名,就替所有生成內容決定版權責任。從受控知識的影響訊號,到真實資料來源、授權與法律歸屬,中間還有不同問題。
作者已在官方專案頁公開程式、資料與相關模型成果,讓其他研究者可以檢查受測設定。本文未重新執行實驗,也沒有把可下載當成所有依賴資產都採相同授權。
對一般讀者,較值得帶走的判斷是:引用一篇相關文章、找出訓練時真正有影響的文件,以及證明移除它會改變行為,分別需要不同證據。
未來若能把相同診斷擴到長回答與多任務模型,來源透明度才會更接近實際應用。想追蹤這類原始研究,歡迎免費訂閱 AI 郵報。
CATT 常見問題
CATT 是新的搜尋模型嗎?
它是一套受控的訓練資料歸因測試,也研究既有方法的評分改動。它關注模型怎麼學到答案,和找一篇內容相似的網頁不同。
找到高分文件,就代表那是唯一來源嗎?
不能。測試裡可以有多份文件教同一事實,真實世界的知識來源更複雜。歸因分數也只是特定方法下的影響估計。
可以直接用它查任何聊天機器人的訓練資料嗎?
本次研究依賴可存取的模型與已知微調資料,沒有提供任意商用聊天工具的完整訓練紀錄查詢功能。
若想進一步理解「看懂模型」和「測對表現」的差別,可以接著閱讀以下分析。
延伸閱讀:AI 可解釋性快有突破?Goodfire 神經元研究的 90%估計、方法與安全限制
延伸閱讀:AA-Omniscience v1.1 更新:題數減半,為什麼 AI 分數下降不等於退步?
原始資料來源