Factory Droid 1.0 用程式串起工具:AI 寫程式的成本,為何取決於執行框架?
Factory Droid 1.0 用程式串起工具,降低反覆讀取日誌的成本。解析 Script、Terminal-Bench 4 測試口徑、快取與失敗恢復,以及哪些開發團隊值得比較。

讓 AI 修一個程式錯誤,真正耗時的常常是讀檔、跑測試、翻日誌,再決定下一步。Droid 1.0 這次瞄準的,就是模型能解題,整趟工作卻仍來回很多次的情況。
這也讓同一個模型放進不同工具,出現不同帳單與完成時間。差別不只在提示詞,也在模型如何取得資料、執行動作。
Factory 在 2026 年 10 月 29 日推出 Droid 1.0,主打包住模型與工具的執行框架,讓多個操作能由一段程式接起來。
原始結果留在程式裡,模型只讀需要的摘要,因此可以少傳部分重複資料,也減少等模型決定每個小步驟的時間。
不過官方比較也顯示,較便宜不一定較快。評估這次更新,得把成功率、每個成功任務的成本與時間放回同一條件。
對經常交付長任務的開發者,Droid 1.0 提供值得比較的執行方式,而第一個要拆清楚的,就是框架如何改變模型呼叫工具的次數。
Droid 1.0 改的是執行框架,為何同模型也會有差別?
執行框架決定模型每一步能看見什麼、如何動作,以及失敗後如何繼續。Factory 稱它為 harness,可以把它理解成替模型安排工作的那層程式。
模型負責判斷要修哪裡,框架則把讀檔、執行測試、修改檔案等工具接給它。因此,兩套產品即使用同一個模型,仍可能因為資料提供方式不同而走出不同路線。
例如,模型需要在數百個檔案中找出使用某個函式的位置。如果每讀一份檔案都回到模型,它就要一次次處理指令、先前對話與新結果,才能繼續找下一份。
把檔案搜尋與篩選交給程式後,模型可以直接讀到符合條件的項目。少掉的主要是協調往返,而搜尋與讀檔本身仍要實際執行。
Droid 1.0 的官方說明表示,這套框架也供終端介面與 Droid SDK 使用。SDK 是讓其他應用程式接入能力的開發工具,因此團隊可以把同一套代理放進自己的流程。
這次已提供 macOS、Windows 桌面應用與終端安裝方式。不過選擇哪個入口,不會改變團隊仍需提供專案環境與測試條件的事實。
當一個任務需要很多工具,反覆請模型回來讀結果,就會成為額外成本。Droid 1.0 最主要的改變,是把其中一部分交給 Script 執行。
Introducing Droid 1.0: the new engine behind Factory’s agent.
— Factory (@factory) October 29, 2026
Built for complex projects and everyday development:
>more accurate
>more efficient
>faster than ever before pic.twitter.com/HgaeDIrRJ1
Script 把工具串成程式,省下的是哪一段往返?
Script 讓模型先寫一段 JavaScript,再由程式依序或並行呼叫工具。彼此獨立的工作可以同時進行,有前後依賴的工作則能等上一個結果後再繼續。
這段程式執行的沙盒本身沒有檔案、網路或系統存取能力,仍須透過提供的工具完成操作。因此,寫成程式主要改變工作如何編排,並沒有直接開放整台電腦給它。
讀取結果可以先留在變數裡篩選,最後只印出需要的摘要。模型於是不用把每份日誌都重新讀一遍,但完整結果仍可保留,遇到問題時再查。
同樣的工具數量,可以少呼叫幾次模型
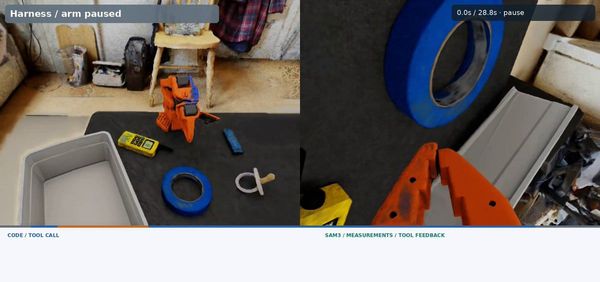
Factory 以修復單元測試的案例說明,兩種方式都做了十五次工具操作。直接呼叫工具需要十次模型請求,Script 則用五次模型請求完成。
官方示意時間從五十六點八秒變成四十一點六秒,其中工具執行時間來自量測,直接呼叫的排列則用相同工具時間重建。這能解釋往返如何影響等待,仍不能推成每個任務都會省下同樣比例。
另一個整理 Linear 待辦的案例,包含三百一十二次工具呼叫。Script 用兩次模型請求,直接呼叫的三十六次則是假設每次最多處理十個工具的估算。
這個例子重要的地方,是程式能逐一核對修改前後的欄位,只把變更結果印回模型。若發現非預期欄位被改,它可以按事先寫好的條件停止,避免只靠一句「已完成」判定整批成功。
並行也需要看工作是否獨立。讀取不同檔案可以同時進行,但修改檔案後再跑測試,就必須等待修改完成,否則較快取得的只是舊版本結果。
官方說明允許程式等待最多五分鐘後先交回目前輸出,也可以從開始就放到背景。這讓長測試不必被塞進一次模型回合,但使用者仍要分清楚「工作已啟動」和「結果已確認」,才不會在背景尚未完成時接受交付。
但摘要也有取捨。若程式一開始篩錯條件,模型看到的摘要同樣可能漏掉問題,所以具體規則與完整日誌仍有價值。
因此摘要應保留可供判斷的結果,讓模型不必再讀全部原始日誌。至於這種改變能省多少,還要看官方比較採用哪種任務與成本口徑。
成功率、成本與時間,要如何讀同一張比較表?
Factory 的成績出自公司自己執行的 Terminal-Bench 4 比較。它把多套代理放在相同模型與任務條件下測試,仍屬發布者測試,本文沒有獨立重跑。
比較於 2026 年 10 月 23 日至 28 日進行,每個任務各跑三輪,使用指定版本的 Codex、Claude Code、Cursor、Devin 與 OpenCode。因此結果對應當時版本,不能直接代表每個工具之後的更新。
官方在 GPT-6.1 Sol 的圖表列出 Droid 通過率 57.6%,每個通過任務成本 0.79 美元。Codex 的通過率為 54.0%,但成本與耗時的比較還有另一個篩選條件。
成本和時間只拿雙方三輪都通過的共同任務相比,再按模型供應商牌價計算。因此,它回答的是「相同成功工作花多少」,和把全部失敗嘗試都算進團隊月帳單,並不是同一個問題。
使用 Claude Opus 5.5 時,Droid 圖表通過率為 65.2%,每個通過任務成本 4.73 美元。公司表示,相較受測其他框架,成本最高低了 24%。
省錢與省時間可能朝不同方向
GPT-6.1 Sol 的對照最能看出取捨:Factory 表示 Droid 比 Codex 成本低 12%,但完成相同成功任務的時間多 10%。如果團隊在等緊急修補,較低帳單未必足以抵銷等待。
Opus 5.5 的結果則不同。官方稱 Droid 相較受測其他框架,每個成功任務耗時少 16% 至 26%,顯示同一套框架的效益仍受模型影響。
方法說明也保留特別處理:部分 Opus 5.5 試次因內容審查停止,改用 Opus 5 重跑。Devin 因停下來詢問使用者的部分任務,另有計分處理。這些都會影響如何把榜單搬回實際工作。
團隊因此應先決定自己要減少等待、降低費用,還是提高完成比例,再挑對應指標。把所有數字濃縮成「全面更快」,會失去這份比較最有用的資訊。
同一模型較省錢卻多花時間的結果,也說明選擇框架仍要配合團隊在意的指標。工具呼叫減少後,剩下每次請求是否重讀舊內容,也會繼續影響成本。
快取與失敗恢復,為什麼影響長任務?
工具呼叫變少之後,每次剩下的請求是否重讀舊內容,仍會影響費用。提示詞快取讓供應商重用先前處理過的開頭,因此請求前段改一個地方,就可能讓後面的內容失去重用機會。
Droid 把工作中才找到的新工具放到請求末尾,保留原本的開頭。這對長對話有意義,因為越靠後才加入變動,就越有機會保住已處理的部分。
Factory 公開的七天遙測截至 10 月 22 日,涵蓋二千零四十萬次正式環境請求,排除 CI 與評測。CI 是程式提交後自動建置和測試的流程,和一般使用者工作分開計算。
公司稱典型請求有 98% 輸入從快取讀取。若按 token 數量加權,比例則是 91.5%。Token 是模型計算文字用量的單位,因此兩個比例的分母不同,不能任選較高者當整體費用折扣。
長任務也需要明確停損條件
快取不能解決代理重複犯錯,所以框架另設重試與停止規則。連續相同工具呼叫達到一定次數會先提醒,再停止。有新結果的輪詢則可以繼續,避免把正常等待誤判為卡住。
長時間工作也可以移到背景,完成後再喚回模型。這讓代理不必一直用請求詢問工作好了沒,同時仍保留追蹤與停止的入口。
官方還列出初始請求縮短 37% 的結果,但兩版使用不同模型與 tokenizer。Tokenizer 是把文字切成 token 的方式,所以這個比例不能直接拿來推算所有工作都少付 37%。
用字元數看相同兩版初始請求,則從五萬七千零三十五減到三萬六千八百零二,少了約百分之三十五。這能避開文字切分差異,但仍只描述啟動內容,尚未包含每件工作之後讀入的專案資料。
但這些規則會因模型而異,所以調整框架還需要驗證哪些改動真的適用。Factory 的改進流程,也把這個差異放在工程師審查之前。
代理改進代理,工程師要保留哪個決定?
Agent Factory 會從失敗紀錄提出改法,但是否上線仍由工程師審查合併。代理讀取評測與真實使用摩擦後,需要提出假設,再對受影響的模型做控制比較。
官方舉出的行號案例很具體:每次讀檔都附行號,能讓某個 Opus 任務少花 22% 成本,卻讓 GLM 與 Kimi 增加成本,因為那些模型沒有相同的重讀問題。
Factory 因此把行號改成需要時才請求的選項。這說明一個在單題有效的技巧,若直接套在每個模型與每次讀檔上,也可能變成負擔。
工程師保留的決定,是證據是否足以支持改動,以及代價是否可以接受。代理能提出更多實驗,不代表測試口徑、產品需求與上線責任會自動消失。
對採用團隊而言,這種流程比「代理會自己變好」更可操作。若自己的工作大多是少量檔案、一次修改,Script 的協調優勢可能不如大量工具任務明顯。
也可以把現有失敗拆開看。若問題是需求寫不清楚,換框架未必補得上。若問題是讀取大量重複結果與連續往返,才更接近 Droid 1.0 想處理的範圍。
這種條件式改進,讓團隊更有理由拿自己的任務比較,而不是只選排行榜第一名。
哪些團隊值得試,如何比較才不被平均數誤導?
適合先比較的是經常讀大量檔案、跑多輪測試或並行任務的團隊。可以選一件近期完成的工作,保留原始專案狀態、需求與驗收方式,觀察代理是否交付相同成果。
如果要比較修錯,就保留能重現錯誤的測試與預期結果。單看「測試通過」仍不夠,因為代理也可能刪除測試或縮小檢查範圍,所以應一起看它最後修改了哪些檔案。
時間也要分開記錄。模型開始工作到交付結果的時間,和人閱讀修改、補問題、重新測試的時間,會影響團隊最後能省多少工作。
依 2026 年 10 月 30 日的Factory 價格頁,Pro 每月 20 美元,Plus 每月 100 美元、用量約為 Pro 五倍,Max 每月 200 美元、約十倍。這些方案採用量限制,並非無限執行。
Teams 則列每團隊每月 60 美元,加上每席每月 40 美元,最多十席。企業客製需求另洽,實際地區、稅費與帳號額度仍以採購時顯示為準。
因此可以先從自己確實會做的長任務比較,而不必為了使用並行功能而製造更多工作。能在相同成果要求下穩定省下的成本,才是比宣傳倍數更有用的採用理由。
延伸閱讀:Factory Delegations 正式開放:從 Slack、Linear 派工作給 Droid,權限與審查怎麼設?
延伸閱讀:Factory OpenCompute 開放私人預覽:代理沙盒放進自家雲端,哪些資料仍要確認?
常見問題
Droid 1.0 是 Factory 自己訓練的新模型嗎?
Droid 1.0 是安排模型、工具與工作流程的代理執行框架。它支援多個模型家族,因此比較結果要一起看使用哪個模型與哪些任務,不能把產品版本當成新模型參數規模。
每個任務都會因為 Script 而更便宜嗎?
官方結果顯示效益與工具數量、模型及任務有關。需要大量搜尋、篩選與操作的工作,比單步修改更有機會減少往返,但仍要把失敗重跑與人工審查算進實際成本。
工具能自己改進,還需要工程師嗎?
Factory 公開的流程由代理提出變更與實驗,工程師審查證據並決定合併。使用者也仍要確認自己專案的修改與驗收,產品測試通過不會取代專案責任。
如果你想持續追蹤 AI 開發工具如何改變工作流程,歡迎免費訂閱 AI 郵報。