SO-101 Bench v1 公開:模擬排名與真機一致,為何成功率仍不能照搬?
SO-101 Bench v1以低成本手臂數位孿生比較機器人政策。理解模擬真機排名一致、成功率仍有落差,以及代理框架、時間和訓練成本的影響。

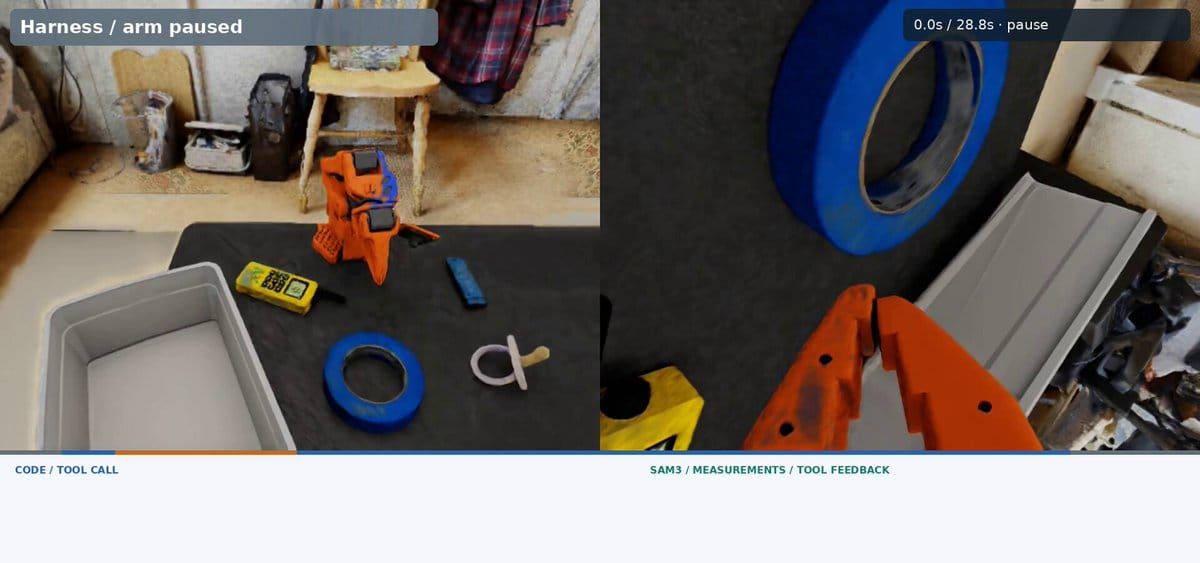
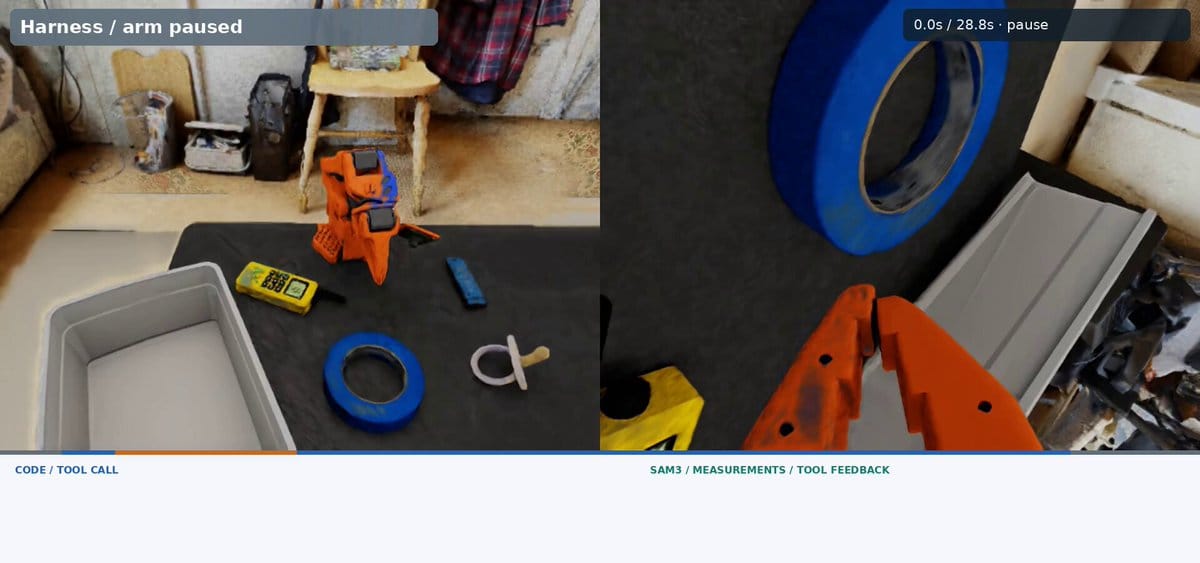
同一個機械手臂政策,在模擬裡看似較好,搬到桌上真機是否仍較好?這裡的政策是把觀察轉成動作的控制模型,SO-101 Bench v1 想讓這個問題可以反覆比較。
研究者 Truman Hickok 在 2026 年 10 月 28 日公布 v1,以真實桌面建立數位孿生。數位孿生是用模擬重建對應設備與場景,讓工作能重複測試。
五個只靠模擬資料訓練的政策,換到真機後保留相同排名。但模擬仍高估成功率,排名相同不代表兩邊完成比例一樣。
研究也顯示,讓語言代理寫程式並把部分動作交給學習政策,能形成另一種分工。不過,模型、操作框架與測試範圍都要一起看。
已有機器人研究環境的人,可以用它比較方法。只想花約一百二十美元買一套自動工作系統的人,仍要把電腦、訓練與整合成本算進來。
先從任務與物件切分看起,才能理解模擬到真機的一致性到底證明多少。
SO-101 Bench v1 測什麼,四項任務為何有五類?
評測用空間條件和物件變化,測政策是否能把東西放到要求的位置。依 專案頁 與 原始論文,任務包含放入容器、放在旁邊、放在兩者之間,以及按方向移動。
放入容器再分為一個與四個物件兩類,所以四種任務會形成五個評分類別。四個物件都要放妥,也讓完成條件比只處理一個物件更完整。
新物件,分成見過與沒見過的不同程度
評測有一百三十八個物件,分成四十八個見過的物件、四十三個未見過的實例,以及四十七個未見過的類別。實例可以理解為同類物品的新樣式,類別則要求跨到不同種類。
這讓讀者能分辨,政策是只會處理訓練時的物件,還是能把動作帶到新的外觀或種類。不能只看整體平均,就推論每一種新物件都有同樣表現。
主要評測包含九百一十六個回合,另有針對穩健性、規畫與記憶的子集合。這些子集合會重疊,不能把各自回合數相加,誤以為是主要評測之外互不相干的新試驗。
以假設的杯子為例,同一類別換了形狀或大小,可能要求政策調整抓取位置,換成另一種類物件,則可能連可抓部位與擺放方式都不同。這個例子只用來解釋切分目的,不是宣稱研究每種物件都有這些指定變化。
因此,新實例和新類別分開,能讓研究者追問失敗出現在哪一層。如果看過的物件已能放準,換外觀就掉分,與連原有物件也無法完成,需要處理的問題不同。只報一個平均值,容易漏掉這個方向。
本次新事件是 v1 正式發布,並非這套研究第一次出現。較早已有 v0,十月二十七日論文與隔日作者發布,讓讀者能對應這次版本的資料與評測範圍。
任務固定後,模擬與真機才能用相近條件比較。
SO-101 Bench v1 is out! It’s an accessible (~$120 robot) real2sim2real robot learning benchmark: policies trained only in sim keep their rankings on the real robot, and an agent + VLA combo beats every fine-tuned VLA/WAM on the primary eval (1/8) pic.twitter.com/hYDA0rpZnY
— Truman (@h1ckok) October 28, 2026
排名完全保留,為何仍不能說模擬等於現實?
五個政策在配對佈局上的相對先後一致,絕對完成率卻仍有落差。研究把這五個只用模擬資料訓練的控制模型,放到四十五個相配的佈局,在模擬與真機兩邊評估。
相配佈局的作用,是盡量保留桌面安排和工作目標,讓政策移到真機後仍在處理可比較的問題。否則物件位置與任務不同,分數改變就不一定來自模擬和現場的差異。
排名看先後,成功率看完成多少
研究報告的 Spearman 排名相關為一,另列排名反轉指標為零。這支持受測五個政策在本次配置下維持先後,並非百分之百的任務都成功。
可以用假設說明:兩個政策在模擬裡一個較高、一個較低,到真機後都下降,但原本較高者仍領先。此時排名可以一致,成功率卻完全不相同,這正是相對比較與絕對完成量的差別。
原作者指出模擬會高估成功,所以研究者或許可用它先篩選較有希望的政策,卻不能直接用模擬分數承諾現場完成比例。要估實際工作,仍需真機資料。
另一組相關數字,回答不同問題
論文另比較只用真實資料與只用模擬資料訓練的 GR00T N1.6,跨十五個任務與物件切分組合,得到 Pearson 相關〇點八六、Spearman 〇點七四。
這組比較同時改變訓練來源與測試領域,與前面的五政策配對實驗不同。不能把兩組相關數字放在一起,當成只隔離模擬精準度的一次驗證。
它們都提供研究線索,但可支持的判斷要各自保留。政策排名是否一致、分數是否接近,以及訓練資料能否轉移,並不是同一個問題。
這個差別也提醒,訓練資料與評分方式要一起保留。
共同訓練預算,如何讓九種政策比較更清楚?
共同訓練預算讓方法可以對照,卻不等於每一款政策的能力上限。主要比較納入九種學習政策與兩個語言代理,研究者保留各方法在相同實驗條件下的成績。
資料包含三千六百二十九段模擬示範,約十八點五小時,另有約四千四百段真實示範、約二十小時。兩份資料應分開看,不能因總量超過八千段,就推定主要政策比較把兩種來源全部混合訓練。
主要學習政策,使用哪一份資料?
主要評測中的學習政策採模擬示範,使用四張 A100、各八十 GB 的 GPU 微調三十六小時。GPU 是適合平行運算的處理器,微調則是讓既有模型依這份資料繼續調整參數。
研究用三十九個保留驗證回合挑選模型版本。保留資料的用途是讓選擇有共同依據,而不是把每個版本都拿最終測試反覆挑到最好,再當成一次比較。
固定時間和硬體有助於讀者理解資源條件,也限制了解讀。某款政策如果在這個預算下較低,不能直接宣稱它在任何訓練時長、資料或設定下都不可能更好。
最終主要成績是十五個任務與物件切分組合的平均成功率,並附信賴區間。平均讓各組成為比較單位,也表示讀榜時仍值得查看各組,了解政策在哪些新物件或空間要求上變弱。
平均方式也會影響比較重點。十五個組合等權計算,表示案例較多的一組不會只因數量大就主導成績。讀者仍應回到各組結果,才知道整體領先是不是來自自己最需要的能力。
如果自己的工作只涉及其中一類物件,整體領先不一定就是最佳選擇。先找到對應任務的結果,再看它有多少回合與什麼訓練條件,才能對準實際用途。
當代理加入抓取政策後,模型之外的操作框架也會改變結果。
代理加抓取政策,為何框架與模型都要比較?
語言代理可安排與修正工作,學習政策則接手部分動作,兩者形成分工。代理不必自己逐步輸出每個關節的控制,也可以寫程式呼叫已有能力,並在看到結果後調整。
這裡的操作框架,是模型周圍的觀察工具、程式介面、可呼叫動作與回饋安排。相同語言模型被放進不同框架,能做的事可能不同,因此不能把整段成果全歸給模型名稱。
83.2% 與 85%,不是同一張成績單
論文的主要評測裡,代理搭配視覺語言動作政策取得百分之八十三點二。這是指定組合與主要模擬評測的結果,範圍限定於該組方法,真機完成率仍需另行測量。
研究另做六十回合的對照,固定 PyRUA-Lean 框架與 Galaxea 控制政策,再更換語言模型。這份較小測試中,Sol 為百分之八十五、Argon 七十七、DeepSeek 六十五、MiMo 五十五。
六十回合與九百一十六回合的範圍不同,不能把八十五當成主要榜單的新高,再與八十三點二直接排高低。比較分數以前,先保留分母與組合,才能知道究竟換了什麼。
這些系統的推理設定與服務成本也不同,快取還可能影響帳單。控制政策固定有助於觀察語言模型的差異,卻不會讓其他執行條件自動完全相同。
為何這種分工值得研究?
以「放在兩者之間」為例,代理可以先決定目標位置,再把抓取或移動交給學習政策。動作完成後,再觀察物件是不是落在要求區域,便能把規畫與操作分開檢查。
這是假設性的分工說明,本文沒有重跑該流程。如果失敗,可以先追查選錯目的地、抓取未成功,或放置後沒有確認,而不必把所有問題都叫成政策不夠強。
但前提仍是框架提供的工具真的可用,且觀察能反映結果。若某個政策在自己的設備上沒有相同動作介面,研究組合就不能原封不動套上去,仍需整合與測試。
看懂分工之後,執行時間和費用也需要按同一條件計算。
影片看起來流暢,實際等待與硬體成本呢?
模擬計算時間會暫停,所以一倍模擬播放不代表真實工作等速完成。研究在語言模型思考時暫停模擬,畫面上的物理動作因而不包含全部等待。
這個設定有利於控制實驗,卻不能拿來估使用者等一件工作要多久。若模型反覆觀察、寫程式和修正,完整耗時還要加上計算與工具執行,不能只量影片長度。
部分真機示範另採五倍播放,應依原標示理解。快轉能方便看整段動作,但不會把真實交付速度改成播放速度,也無法證明過程不需要監督。
約一百二十美元,買到的是哪一部分?
專案使用低成本 SO-101 手臂,約一百二十美元是手臂的入門估價。它沒有把電腦、GPU、桌面物件、相機整合與模型服務全部包成同價套裝。
政策的訓練、執行與語言代理服務也有不同資源需求。若研究目標是重跑完整比較,和只測一個已訓練版本,準備的設備與時間便不同,不能只從手臂標價推算整個實驗預算。
此外,程式、資料與第三方模擬資產有各自授權。專案公開讓人能檢查與沿用研究,不代表每一項依賴都具有同一種任意商用權利。
因此,先用熟悉的任務確認條件,比只看低價手臂更有幫助。
從一個配對任務,看方法能否帶回自己的桌面
我建議同時保留任務、物件與執行條件,讓模擬和真機各自留下結果。這是根據公開研究提出的比較方法,本文沒有獨立操作手臂或驗證這些政策。
例如先固定一組容器與放置要求,確認兩邊的觀察和成功條件能對上。接著比較政策先後與完成比例,便能同時看到「哪個較好」和「實際完成多少」,避免只留下有利的其中一項。
若更換物件或控制政策,也應註明版本。這讓後續進步有前提可回查,不會把換了較容易場景的結果誤當原本困難已被解決。
相對排名和實際成功率都看得到,才知道哪一段方法值得沿用。
延伸閱讀:RoboJev 開放機器人成功判斷模型:95.2% 成績、每千次 0.19 美元怎麼讀?
SO-101 Bench 常見問題
排名相關為一,代表成功率百分之百嗎?
它描述受測政策的相對先後一致。研究明確指出模擬會高估成功,真機完成比例仍需另外看,不能用排名相關代替成功率。
83.2% 與 85% 可以直接比較嗎?
前者來自主要評測的指定代理組合,後者是六十回合對照裡的成績。任務集合與設定不同,應各自保留,不能直接當成同榜前後名次。
花約一百二十美元就能重跑整套研究嗎?
那是手臂估價,並未包含完整運算與實驗環境。依要訓練政策、執行模型或重現真機比較,還需要不同設備與整合工作。
讓相對比較,接回實際能完成的工作
SO-101 Bench v1 提供了模擬和真機之間的一組具體比較,但它最值得保留的訊息,是排名與完成率要分開讀。前者幫助研究者篩選方法,後者才對應現場可交付多少。
先把自己的任務與研究條件對齊,再觀察政策和代理如何分工。這樣低成本手臂才會成為可比較的研究入口,而非把一段流暢影片當成完整自動化承諾。
延伸閱讀:AGIBOT GO-3 Preview 與 Worken 公布:機器人出貨後,如何算出有用工作?
歡迎免費訂閱 AI 郵報,持續追蹤機器人評測、訓練資料與部署條件。