Firecrawl 是什麼?GitHub 破 20 萬星的開源網頁轉 Markdown 引擎,為什麼 RAG 與 AI 代理都少不了它?
mendableai/firecrawl 是什麼?GitHub 突破 20.4 萬星的開源網頁資料引擎,能將動態 SPA 網頁與 PDF 轉成乾淨的 LLM-ready Markdown 與 JSON,並原生支援 MCP 與 n8n 整合。

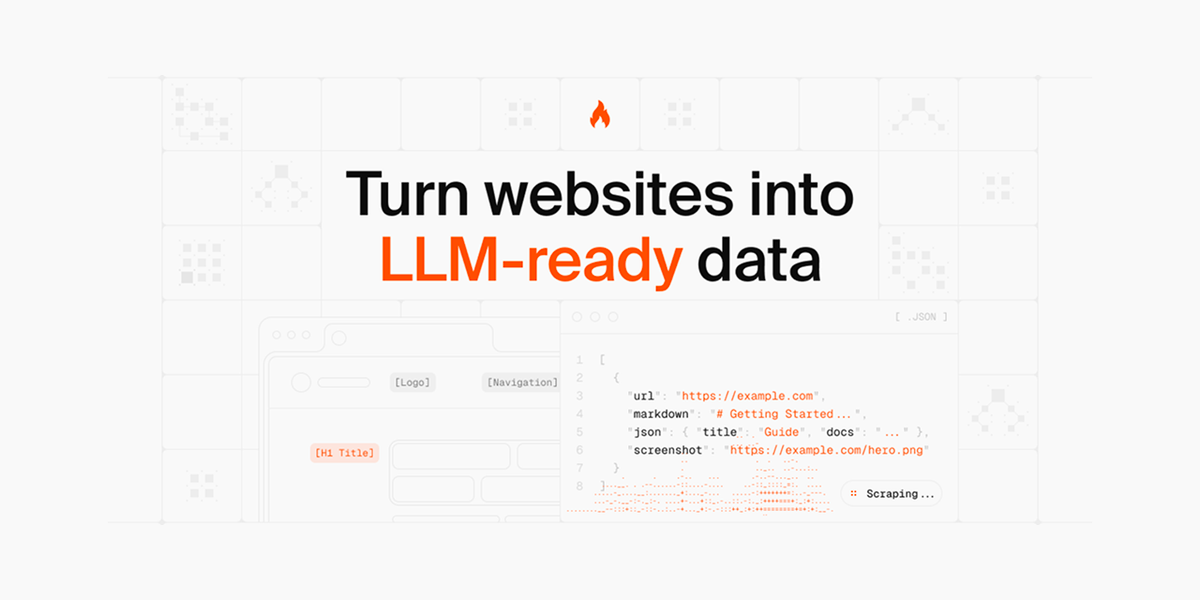
做企業內部知識庫或 RAG(檢索增強生成)系統時,最浪費模型額度的不是問答本身,而是爬回來的網頁裡夾雜了成千上萬行導覽列、廣告標籤與 JavaScript 殘碼,把模型的腦袋塞得一團亂。
在 GitHub 上已經累積超過 204,336 顆星標的開源專案 mendableai/firecrawl,正是專為「把雜亂網頁變成 AI 吃得下的乾淨養分」而生的網頁資料引擎。
它能自動渲染現代單頁應用程式(SPA)與動態載入內容,將整個網站、單一頁面或線上 PDF 直接轉換成結構極度乾淨的 Markdown 或指定格式的 JSON,並透過官方 MCP 伺服器無縫接進 Claude、Cursor 與 n8n 工作流。
與其讓工程師花幾週維護各種網頁解析規則,Firecrawl 把「抓取、渲染、去雜訊、全站地圖索引(Map)與結構化抽取」包成統一介面,讓 AI 代理能精準拿到最新公開資訊。
對正在建置競品監測、技術文件問答或自動化研究流程的台灣開發者來說,弄懂 Firecrawl 的開源授權邊界與自架門檻,能讓資料管道事半功倍。接下來,我們拆解它的核心能力與導入實務。
延伸閱讀:Awesome-MCP-Servers 是什麼?逼近 10 萬星的開源 MCP 伺服器總目錄,開發者找工具必逛指南
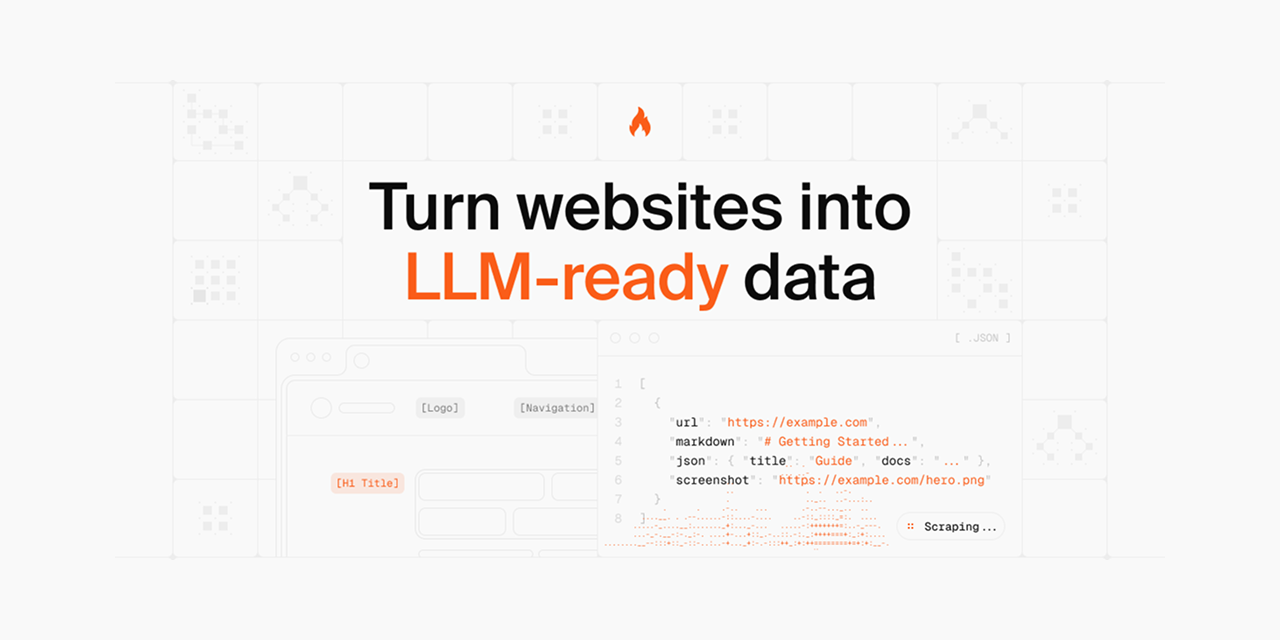
為什麼傳統爬蟲抓回來的 HTML,直接餵給大模型會出事?
一般 HTTP 請求抓回來的原始網頁不僅體積龐大,還常常因為前端框架還沒執行完畢而只拿到一個空殼。
就算把整段 HTML 丟給大模型整理,動輒幾萬個無意義的 <div> 與樣式標籤也會瞬間吃光輸入 Token,甚至干擾檢索準確度。
Firecrawl 在底層處理完無頭瀏覽器渲染與版面主體辨識後,只輸出保留標題階層、表格與超連結的純淨 Markdown。這讓向量資料庫的切塊品質大幅提升,也讓代理在有限的上下文視窗裡能一次消化更多來源。
| 資料擷取方式 | 傳統 Requests + BeautifulSoup | Firecrawl 網頁資料引擎 |
|---|---|---|
| 動態網頁(React/Vue)支援 | 無法執行前端腳本,常抓到空白頁 | 支援完整渲染與捲動載入 |
| 輸出格式與雜訊 | 需針對每個網站手寫 CSS 解析規則 | 直接輸出乾淨 Markdown 或結構化 JSON |
| 代理與工作流生態 | 需自行封裝 API | 原生提供官方 MCP Server 與 n8n 節點 |
五大核心指令與開發者最常串接的管道
根據 Firecrawl 官方 GitHub 倉庫與文件,開發者可以依照需求呼叫五種主要動作,大幅減少不必要的多餘爬取:
Scrape(單頁精準擷取)與 Map(全站網址測繪)
當你只需要確認某個官方產品頁的最新價格或規格時,用 Scrape 即可秒取;若想先摸清整個技術文件網站有哪些子頁面,可以先跑極低成本的 Map 取得完整網址清單,再挑重點抓取。
Crawl(全站遞迴爬取)與 Search(搜尋即抽取)
適合需要定期同步整個開源文件庫進企業知識庫的情境,或直接透過 Search 讓代理搜尋關鍵字並把前幾名結果一併轉成 Markdown 回傳。
原生串接 MCP 與無程式工具
官方同步維護了 Firecrawl MCP Server,讓你在 Claude Code 寫程式遇到陌生套件時,能直接叫代理去爬最新官方文件;同時也提供 n8n 節點,方便營運團隊免寫程式建置每日競品動態摘要。
延伸閱讀:PydanticAI 是什麼?累積破 2.1 萬星的 Python 代理框架,如何用型別安全終結 AI 亂吐格式?
企業自架前必看:AGPL-3.0 授權與算力限制
許多團隊看到開源就會直接想拉進公司內網自架,但使用前務必注意 Firecrawl 核心倉庫採用的是 AGPL-3.0 授權。
如果你修改了它的程式碼並對外提供網路服務,依法必須開源你的修改內容;單純在公司內部做資料管線或直接使用官方託管雲端 API 則不受此限制。
此外,若自架高併發全站爬取任務,後端需要搭配 Redis 與無頭瀏覽器叢集,對記憶體與頻寬有一定要求。
常見問題(FAQ)
Q1:Firecrawl 跟一般瀏覽器自動化代理(如 Browser Use)差在哪?
Firecrawl 專注在「把網頁內容高速轉成乾淨的 Markdown 與結構化資料」,適合讀資料與建 RAG;Browser Use 則擅長模擬真人點擊、登入表單與跨頁互動操作。
Q2:不會寫程式的人可以用 Firecrawl 嗎?
可以。除了註冊官方雲端帳號取得 API 金鑰貼進 n8n 或 Dify 使用外,也能直接把它的 MCP 伺服器掛進支援桌面端的 AI 助理裡。
Q3:抓取網頁資料時會消耗很多費用嗎?
如果是透過官方託管服務,依抓取頁數採點數計費,通常也有免費試用額度;自架開源版則只需負擔自己的主機與代理伺服器資源。
Q4:它能處理網頁裡的表格跟 PDF 檔案嗎?
支援。Firecrawl 會將網頁內的 HTML 表格轉換為標準 Markdown 表格語法,也能直接解析公開網址指向的 PDF 文件文字。
結語:好模型更需要乾淨的外部資料管線
AI 系統的回答品質上限,往往取決於餵給它的資料有多乾淨。Firecrawl 用超過 20 萬顆星的社群驗證,替開發者省下了最枯燥也最容易出錯的網頁清洗工程。
建議今天先用官方提供的單頁擷取或 MCP 伺服器,試著把你最常查詢的技術文件轉成 Markdown 餵給代理,立刻就能感受到檢索準確度的差異。
歡迎免費訂閱 AI 郵報,每週追蹤更多實測工具教學與開源代理生態動態。