miHoYo 發表通用 VLA 遊戲代理模型 Gamer!看螢幕輸出鍵鼠操作,推論延遲壓低至 65 毫秒
由米哈遊 Honkai AI 研發團隊與多所頂尖大學合作推出的 Gamer,是專為長時程即時互動設計的通用視覺-語言-動作基礎模型,支援純視覺鍵鼠控制並透過 Streaming-vLLM 達 20.1 倍加速。

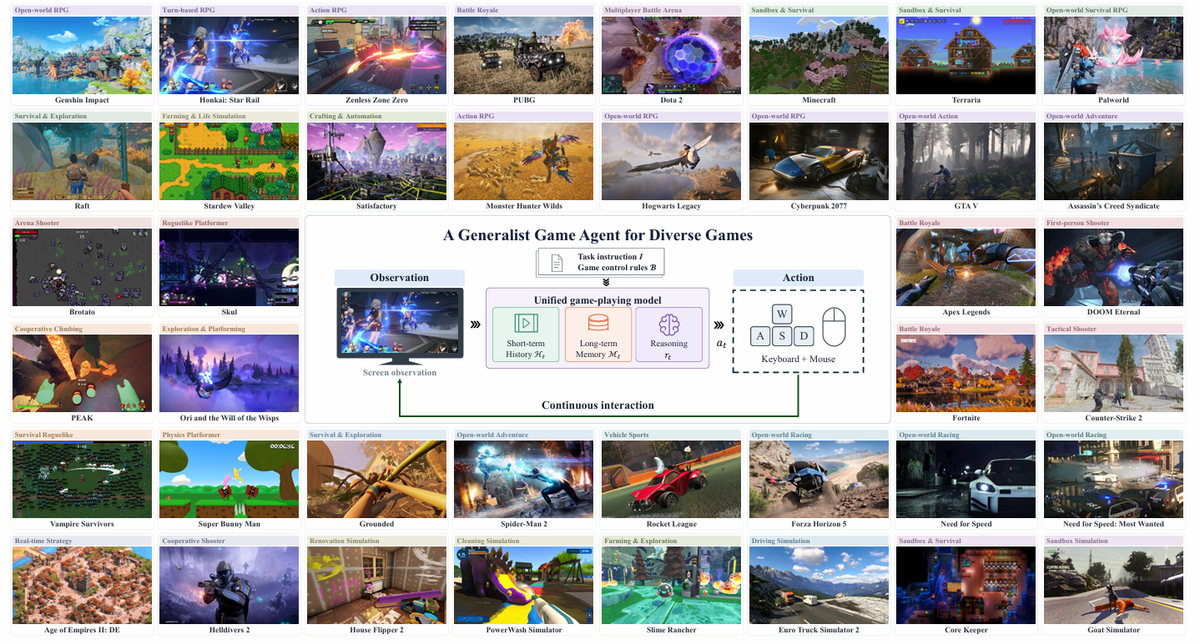
過去的遊戲 AI 代理往往必須仰賴遊戲開發商提供的內部 API,才能讀取角色座標、血量或地圖物件等「特權狀態」。這類作法雖然在單一遊戲裡表現不錯,一旦換到不同引擎的 2D 或 3D 遊戲,整套系統幾乎就得重寫。
為了解決這項通用性瓶頸,米哈遊(miHoYo)Honkai AI 研發團隊聯手新加坡國立大學、清華大學、中國科學院大學與中國科學技術大學研究人員,於 2026 年 11 月正式公開 Gamer(Generalist Vision-Language-Action Foundation Model for Long-Horizon Real-Time Game Agent)。論文同步登上 arXiv 與 Hugging Face Daily Papers,並於 GitHub 以 Apache-2.0 授權釋出系統提示詞與動作格式實作。
Gamer 採用「純視覺輸入、裝置層級輸出」的統一介面:模型只看螢幕畫面,並直接輸出與人類玩家完全相同的鍵盤與滑鼠指令,就能跨越傳統 2D 圖形介面與複雜的 3D 開放世界執行長時程任務。
為了克服長對話與即時互動的效能牆,研究團隊更提出結合記憶摘要的時間感知強化學習演算法(TA-GRPO),以及將推論延遲從 1306 毫秒壓低至 65.12 毫秒的 Streaming-vLLM 引擎。
究竟這套能同時打《崩壞:星穹鐵道》、《原神》與《Minecraft》等多元環境的通用遊戲代理是如何訓練出來的?目前開源釋出了哪些元件,又有哪些部分尚未公開?以下帶你深入拆解。
為什麼通用遊戲代理需要 VLA 架構與統一鍵鼠介面?
所謂視覺-語言-動作(Vision-Language-Action,簡稱 VLA)基礎模型,原本常見於機器人控制領域,目的是讓模型直接把看到的影像與語言指令,轉化為連續的物理動作。將 VLA 概念搬進數位遊戲世界,最大的優勢在於「不挑遊戲」。
只要遊戲跑在電腦螢幕上,無論底層是 Unity、Unreal Engine 還是復古 2D 引擎,人類玩家都只透過顯示器接收視覺訊號,並用鍵盤與滑鼠進行操控。Gamer 把這套人類互動介面標準化,讓所有遊戲共享同一組觀察與動作格式。相較於傳統強化學習代理只能針對單一關卡訓練、換一張地圖或更換 UI 排版就失效的限制,這種純視覺與通用鍵鼠控制介面,讓模型能直接從畫面中判讀小地圖、任務追蹤欄、對話選項與敵人動作前搖,具備跨遊戲遷移與泛化的結構優勢。
根據官方釋出的系統提示詞模板,開發者只需要在提示詞中填入 {GAME_NAME}(遊戲名稱,同時用於開場設定與按鍵標題)、{GAME_RULES}(環境描述、畫面可見資訊、目標與計分規則),以及 {KEY_BINDINGS}(每行一組大小寫敏感的 - <key> -> <effect> 鍵位對應表;若涉及 3D 射擊或視角瞄準,則須加入 - Mouse X Y -> aim / rotate the camera (X>0 right, Y>0 down) 格式),就能讓模型理解當前遊戲的操作邏輯,並以固定頻率規劃未來 200 毫秒的鍵鼠動作序列。模板同時嚴格規範輸出標籤、標點與換行格式,確保模型產生的操作指令能被下游執行器穩定解析。這種設計讓單一基礎模型具備跨遊戲遷移的潛力,從《崩壞:星穹鐵道》、《原神》、《絕區零》等大型 3D 動作與開放世界作品,到《Minecraft》與《毀滅戰士:永恆(DOOM Eternal)》等第一人稱沙盒與射擊環境,都不需要為每款遊戲單獨設計 API 轉接層。
延伸閱讀:KradleBench 用 Minecraft 測 AI 代理:即時世界、多人合作與榜單限制
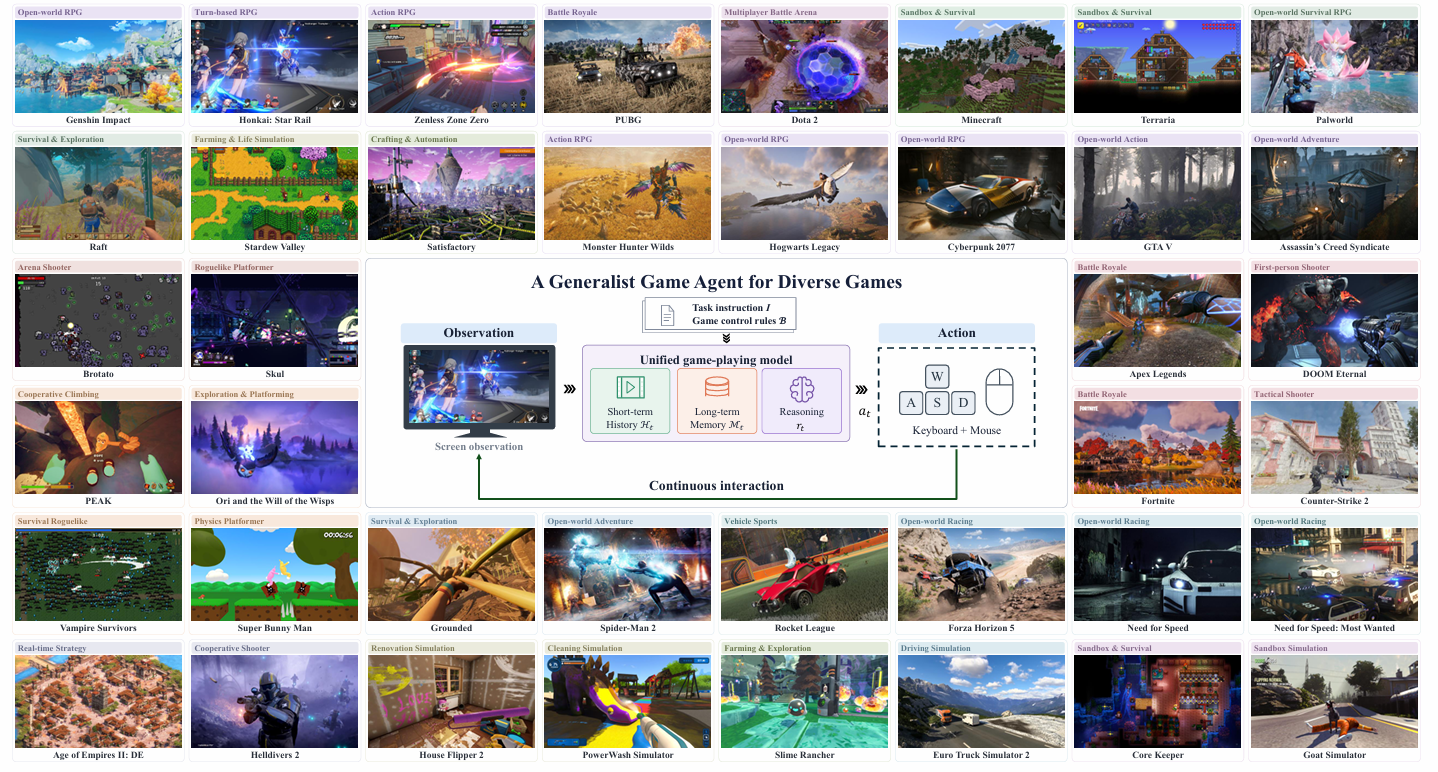
三階段訓練管線:從海量鍵鼠軌跡到長時程記憶強化學習
要讓一個多模態模型學會玩複雜的 3D 動作與解謎遊戲,不能只靠一般的圖文問答微調。Gamer 團隊設計了一套完整的三階段訓練管線,逐步建立視覺控制、稀疏推理與長時程規劃能力。
階段一:裝置層級的繼續預訓練(CPT)
團隊首先收集了數萬小時、橫跨多款模擬遊戲與具身環境的螢幕畫面與鍵盤滑鼠操作軌跡,並結合通用多模態資料進行繼續預訓練(Continued Pre-Training)。這個階段的核心目標是讓模型學會物理與虛擬世界的動態規律,建立「畫面變化」與「按鍵反應」之間的底層直覺。
階段二:稀疏推理監督式微調(Sparse-Reasoning SFT)
如果代理每 200 毫秒都要產生長篇大論的思考過程,根本來不及在即時遊戲中閃躲或轉向。因此,Gamer 在微調階段導入了「稀疏推理(Sparse Reasoning)」機制:在日常移動或常規操作步驟時,模型直接輸出動作;只有在遇到解謎、對話選項或戰術切換等關鍵決策點時,才先生成推理過程。同時,模型也學會維護一份「持久化記憶摘要(Persistent Memory)」,用來記錄已完成的目標、失敗嘗試與接下來的計畫。
階段三:時間感知的強化學習(TA-GRPO)
長時程遊戲任務動輒需要數十分鐘才能完成,遠超過單一模型的上下文視窗長度,在過程中若只依賴偶爾出現的任務通關獎勵,模型很難分辨究竟是五分鐘前的哪一次轉向或對話選擇導致最終失敗。此外,自由探索時的微小操作誤差一旦在長序列中不斷累積,往往會讓角色卡在地形角落或偏離主線。
為了解決有限上下文視窗、滾動誤差累積與稀疏獎勵三大難題,團隊提出時間感知群組相對策略優化(Temporal-Aware GRPO,簡稱 TA-GRPO)。演算法將長軌跡切分為由持久化記憶摘要串聯的多個片段,在互動過程中,策略模型會同時參考遊戲控制規則、任務指令、近期畫面與動作,以及跨視窗保留的記憶摘要來決定下一步;演算法則透過可驗證的環境回饋進行時間維度的信用分配,讓模型學會在長時程任務中持續修正路線並維持目標一致性。
Streaming-vLLM 如何把推論延遲壓低 20.1 倍?
即使模型決策再聰明,只要伺服器端推論一次超過一秒鐘,角色在 3D 遊戲裡早就被怪物擊敗或撞牆了。為了讓大型多模態模型滿足即時遊戲的毫秒級反應需求,Gamer 團隊打造了雲邊協同的 Streaming-vLLM 推論引擎。
這套引擎結合了三項關鍵技術:
- 持久化上下文複用(Persistent Context Reuse):重複利用歷史畫面的键值快取(KV Cache),避免每幀都重新計算過去的螢幕狀態。
- 已驗證推測解碼(Verified Speculative Decoding):在不犧牲輸出準確度的前提下平行預測多個動作 Token。
- 提早動作派發(Early Action Dispatch):在整個序列尚未完全生成結束前,提早將可執行的前端按鍵指令送往遊戲客戶端。
根據官方在 GitHub 公布的效能數據,以 NVIDIA H200 搭配 Qwen3.5-35B-A3B MoE 模型組態進行測試時,未經最佳化的基準設定(TP1 單卡張量平行)端到端請求延遲高達 1306.00 毫秒,幾乎無法應付即時動作遊戲的節奏;而在套用上述累積最佳化與 TP4 四卡張量平行設定後,請求延遲大幅降至 65.12 毫秒,達成 20.1 倍的推論加速,終於跨過即時 3D 遊戲互動的反應門檻,並能同時服務大量並發的模擬遊戲環境進行線上評估與強化學習探索。
下表整理官方公布的推論延遲對比:
| 引擎組態 | 張量平行設定 | 端到端請求延遲 | 加速幅度 |
|---|---|---|---|
| 基準推論(Baseline) | TP1 | 1306.00 ms | 1× |
| Streaming-vLLM 完整最佳化 | TP4 | 65.12 ms | 20.1× |
實戰表現如何?《崩壞:星穹鐵道》支線與多元小遊戲實測數據
為了驗證三階段訓練的實質效益,研究團隊在《崩壞:星穹鐵道》(Honkai: Star Rail)的保留測試任務中,比較了 CPT、SFT 與線上強化學習(RL)三個階段的表現。
測試項目涵蓋兩個分別包含 30 個與 55 個里程碑的長時程支線任務,以及橫跨 7 種不同類型的 40 個小遊戲實例:
- 「機巧鳥七故障/機會使然的盜賊(Opportunity Makes the Thief, Part I)」支線任務:里程碑完成率從 CPT 階段的 34.4%,大幅提升至 SFT 的 72.2%,最終在 Gamer-RL 階段達到 80.0%。
- 「獸性難馴(Bestial Ferocity)」支線任務:完成率從 CPT 的 47.9% 進步到 SFT 的 69.1%,最終在 Gamer-RL 達到 83.6%。
此外,官方在 GitHub 儲存庫與專案展示頁面上,也公開了多段無剪輯的實機錄影,涵蓋兩大典型長時程場景:第一類是「長時程任務執行(Long-Horizon Quest Execution)」,展示代理如何在包含導航、NPC 對話推進與多步驟任務進度記憶的 3D 世界中連續行動;第二類是「解謎與即時互動(Puzzle Solving & Real-Time Interaction)」,呈現模型在判讀場景規則、做出關鍵決策並同步輸出連續鍵鼠操作的能力。研究團隊指出,即便是重複性的鍵盤與滑鼠軌跡資料,只要配合合適的擴展法則與演算法,就能讓模型在跨足數位與物理特性的環境中穩定習得複雜技能。
目前開源了哪些資源?開發者與研究人員該怎麼跟進?
雖然論文與展示影片相當驚豔,開發者在評估導入或復現研究時,仍需看清楚目前的開源進度。根據 RainBowLuoCS/Gamer 官方儲存庫公布的進度清單,目前已經正式釋出並可立即查閱的項目包括:
- 研究論文(arXiv:2611.18397):完整揭露模型架構、資料配比與 TA-GRPO 演算法細節,同步收錄於 Hugging Face Daily Papers。
- 系統提示詞與動作格式規範:包含遊戲規則注入模板、大小寫敏感的鍵位對照格式與推理觸發標記,開發者可直接取用這套統一介面規範對接自家模擬環境。
- 實機展示與專案頁面:可透過專案官網與 GitHub 檢視跨遊戲的長期任務操作錄影與強化學習演進對比。
- 相關模型集合:Hugging Face 上的
THUSI-Lab/gamescaling-model集合追蹤了團隊在遊戲縮放律上的相關基礎模型資產,便於研究社群進一步對照視覺-語言模型在鍵鼠控制上的擴展表現。
至於許多基礎設施工程師最關注的 Streaming-vLLM 推論引擎程式碼,目前在官方進度清單中仍標記為「規劃釋出中(尚未開源)」。換句話說,現階段研究團隊已經把通訊協議、提示詞設計與訓練方法攤開在陽光下,但若想在自己的多卡環境直接重現 65 毫秒的低延遲串流部署,還需要等待後續程式碼正式釋出。
延伸閱讀:Karpo Decision 31B 開放權重:不生成長文的決策模型,適合哪些代理任務?
常見問題(FAQ)
Q1:Gamer 需要修改遊戲程式碼或讀取遊戲記憶體嗎?
不需要。Gamer 完全透過螢幕截圖作為視覺輸入,並輸出標準的鍵盤按鍵與滑鼠座標移動指令,不依賴遊戲內部 API 或特權狀態。
Q2:為什麼 Gamer 要特別設計「稀疏推理」?
因為遊戲互動要求即時性。如果每 200 毫秒都讓語言模型輸出長篇推理文字,延遲會高到無法遊玩;稀疏推理讓模型只在關鍵決策點思考,其餘例行移動直接輸出動作。
Q3:65.12 毫秒的推論延遲是在什麼硬體上測得的?
根據官方 README 數據,該數據是在 NVIDIA H200 搭配 Qwen3.5-35B-A3B MoE 架構下,啟用 TP4 張量平行與 Streaming-vLLM 完整最佳化後測得的端到端請求延遲。
Q4:現在可以直接下載 Gamer 的模型權重與 Streaming-vLLM 來跑嗎?
目前 GitHub 已公開論文、系統提示詞與動作格式規範,Hugging Face 上也有相關的研究模型集合 THUSI-Lab/gamescaling-model 可供查閱模型規模與訓練脈絡,但負責低延遲串流推論的 Streaming-vLLM 推論引擎在官方進度清單中仍處於尚未釋出狀態,需持續關注專案後續更新。
總結
米哈遊 Honkai AI 研發團隊與多所大學合作發表的 Gamer,展現了通用視覺-語言-動作(VLA)模型在數位互動世界的強大潛力。透過統一的鍵鼠介面、結合記憶摘要的 TA-GRPO 強化學習,以及將推論延遲壓低 20.1 倍的 Streaming-vLLM 設計,Gamer 成功讓單一模型跨越多款 2D 與 3D 遊戲執行長時程任務。
更重要的是,這項研究證明了即使僅透過大量裝置層級的螢幕畫面與鍵鼠操作軌跡進行規模化訓練,模型也能同時在具備物理直覺與數位規則的環境中習得穩健的長時程技能。對於正在探索電腦操作代理(Computer-Use Agent)與具身智慧的研究團隊來說,Gamer 提供的提示詞介面規範與雲邊協同推論思路,無疑是目前最值得持續追蹤的開源基準之一,也讓人更期待官方後續釋出 Streaming-vLLM 完整程式碼。