Hugging Face 預告模型量化教學:筆電部署前,llama.cpp 與 vLLM 要先懂什麼?
Hugging Face 預告模型量化直播,涵蓋 llama.cpp 與 vLLM。先看懂量化如何減少記憶體需求、本機執行與模型服務的差別,再準備設備規格、目標模型與測試問題。

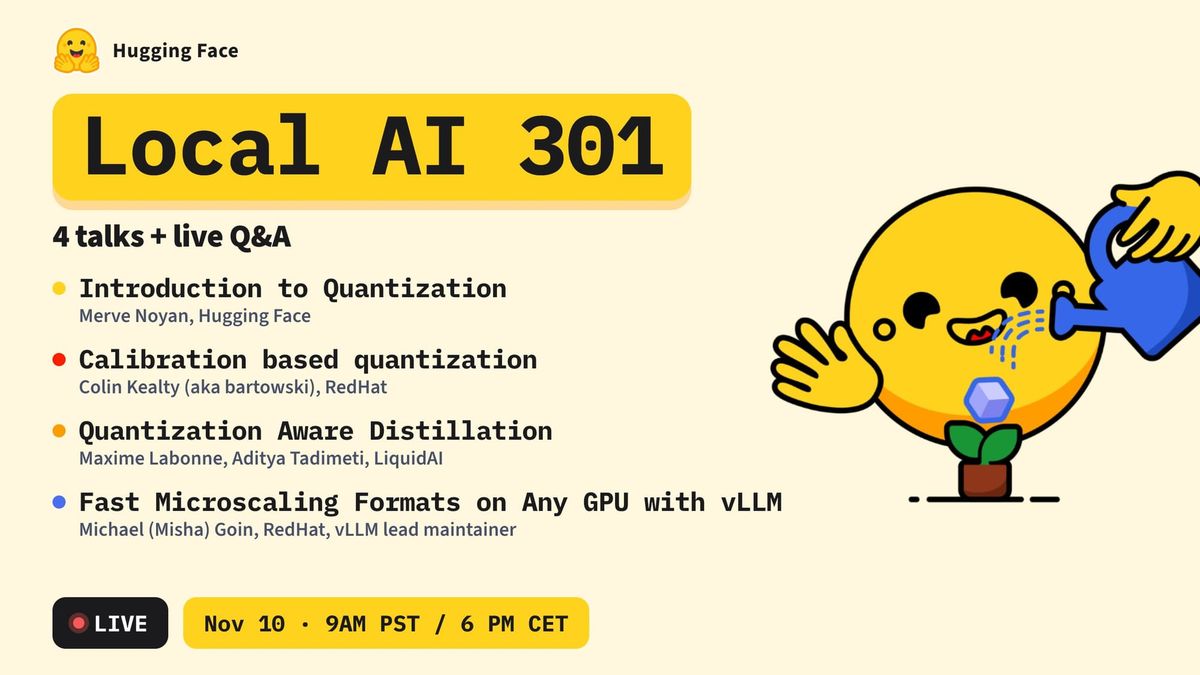
想讓模型在筆電上跑,第一道門檻往往是記憶體。Hugging Face 預告一場量化直播,主題就是把模型縮小到更容易部署。
11 月 5 日的官方貼文提到 llama.cpp、vLLM 與多位講者,並預告下週二直播。想參與的讀者,可以先整理自己的設備與部署問題。
參與前先理解量化在省什麼,才知道該準備哪些硬體與模型問題。
Hugging Face 量化直播將介紹如何降低部署門檻
Hugging Face 的預告把重點放在模型縮小與部署實務,並提到 llama.cpp、vLLM。貼文列出 Merve Noyan、Maxime Labonne 等講者,供讀者追蹤官方活動資訊。
官方宣傳圖列出的時間是 11 月 10 日上午 9 點 PST、下午 6 點 CET,換算台灣時間為 11 月 11 日凌晨 1 點。想參與的人可由原貼追蹤直播入口,先記下設備與部署需求。
量化如何減少模型記憶體需求
量化是用較精簡的數值表示模型參數,以減少儲存與運算需求。代價可能是部分精度改變,因此除了檔案變小,也要測自己在意的回答品質。
模型本身不是唯一記憶體支出,執行環境與長對話也會占用空間。即使下載檔案放得進硬碟,仍不代表筆電能以理想速度執行。
llama.cpp 與 vLLM 的學習入口如何選
學習時可以先把需求分成個人本機使用與多人服務。llama.cpp 常被用於本機模型執行,vLLM 則著重模型服務與批次處理;實際支援仍應對照所選模型和硬體文件。
因此,先寫出硬體、模型、對話長度與預期同時使用人數,比先決定量化位元數更有幫助。這些條件會決定應該比較哪些格式與執行方式。
參與前先準備硬體、模型與一組測試問題
量化之後,所有大型模型都能在筆電跑嗎?
不能這樣推論。模型大小、格式支援、可用記憶體與運算速度都會影響結果。
看 Hugging Face 直播前可以準備什麼?
記下自己的設備規格,挑一個想部署的模型,再準備一組有參考答案的問題。直播中就能聚焦詢問記憶體、速度與品質取捨,而不只看壓縮比。
想持續追蹤這類 AI 工具與工作方法,可以免費訂閱 AI 郵報。