Hy-SimulMT 中英同傳模型開源:約 3 秒落後是什麼指標,語音輸出還需要什麼?
Hy-SimulMT 開源中英雙向同聲傳譯模型。解析約三秒 StreamLAAL 指標、限定樣本的人類口譯比較、另外配置 TTS 的原因,以及官方部署與授權條件,幫助團隊判斷如何試做會議翻譯。

線上會議要跨語言溝通,等講者整段說完再翻譯,對話就容易停住。Hy-SimulMT 希望在音訊持續進來時,同步產生翻譯,縮短聽眾等待意思的時間。
Tencent Hunyuan 於 2026 年 10 月 26 日公開這款中英雙向同聲傳譯模型,並提供模型權重,也就是訓練完成後用來運作的參數檔,以及推論與訓練工具。它的核心用途,是讓中文與英文來回溝通。
官方主打約三秒的低延遲,但這個數字量的是翻譯相對於原話的落後程度,並非送入音訊後多久第一次聽到聲音。兩者混在一起,會誤判現場使用體驗。
語音輸出也有額外條件。模型可以支援翻譯流程,但要產生翻譯語音與聲音複製,仍需配置另一項文字轉語音服務。
我的判斷是,有中英會議需求與部署能力的團隊,適合拿它做受控原型。若期待下載後就取得任意語言、完整語音的即用服務,還有整合工作需要完成。
要判斷這些工作值不值得,先看同傳模型處理的問題,以及它留下哪些系統分工。
Hy-SimulMT 是什麼?在講者還沒說完時翻譯
Hy-SimulMT 接收串流語音、進行中英雙向同傳,目的是讓聽眾更早接到翻譯。串流表示聲音持續分段送入,系統不必等完整錄音結束才開始處理。
根據 Tencent Hunyuan 官方模型卡,它針對會議、演講與訪談等現場溝通情境,希望在等待時間和翻譯品質之間取得平衡。
這和先錄完一段話、產生整份逐字稿,再翻譯的工作方式不同。因為講者還在補充,同傳系統已經要決定哪些意思足夠明確,可以先交給另一種語言的聽眾。
例如,假設一句話前半段提到要增加預算,後面卻加上「除非測試沒有通過」。若太早把前半段說成確定決策,聽眾可能在條件尚未出現前,就得到不完整的意思。
這是假設情境,並非本刊測試結果。但它說明同傳的困難不只在辨識單字,也在持續接收原話時,安排翻譯的先後、保留條件並處理後續修正。
官方另外公開 SimulInfer 和 SimulTrain,前者用來提供模型推論服務,後者是接續訓練工具。已有模型可用,不代表每個採用團隊都必須先重新訓練。
越早開口,能利用的原文上下文就越少,因此速度必須和意思是否完整一起比較。
約三秒落後,和三秒開始說話差在哪裡?
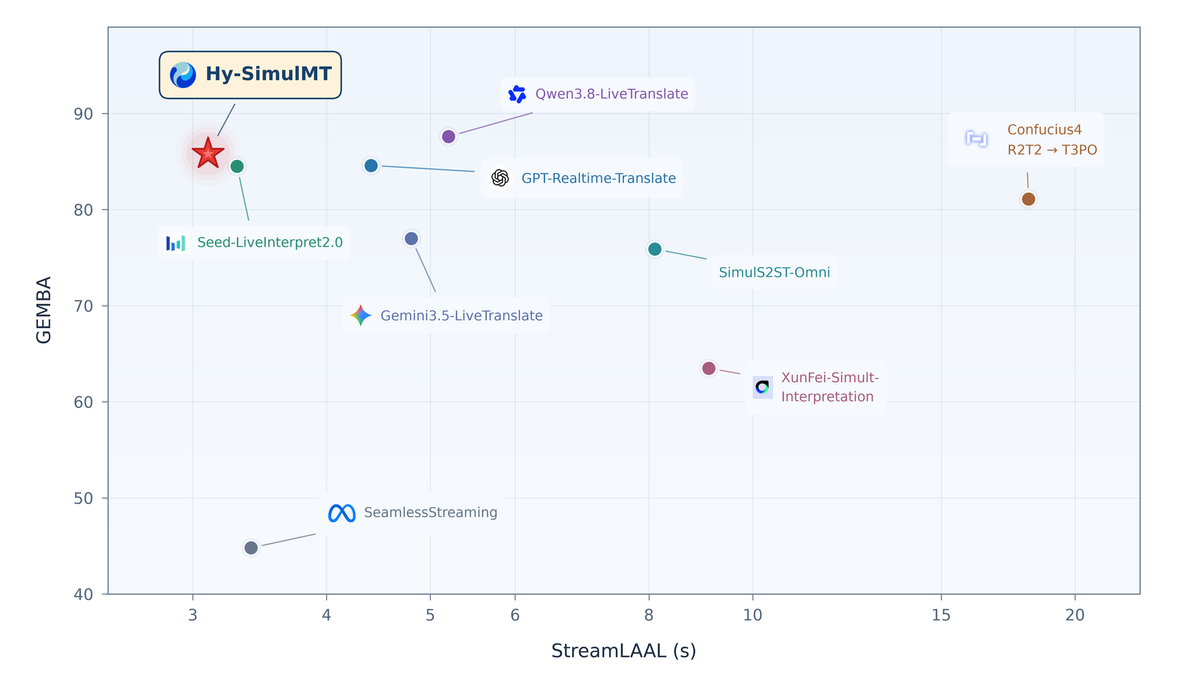
官方約三秒指 RealSI 長錄音測試中的 StreamLAAL,衡量串流翻譯相對原話的落後程度。它不是從送入聲音到首次產生翻譯語音的等待時間。
第一次聽到翻譯要等多久,影響的是開場等待。整場談話進行時,翻譯持續落後講者多少,則會影響聽眾能否跟上討論,因此需要另外觀察。
一套服務即使很快發出第一句話,後續翻譯仍可能越積越慢。因此,單獨展示開場反應,不能代替長段音訊的同傳落後指標,三秒也不能直接當成產品的固定回應保證。
官方圖表的橫軸是 StreamLAAL,數值較低表示落後較少;縱軸是 GEMBA 翻譯品質評分,較高較好。兩個方向一起看,才知道縮短等待是否犧牲了內容。
在這次公司評測中,Hy-SimulMT 的 StreamLAAL 約三秒,是圖中對照系統最低。它的 GEMBA 高於所比較的開源模型,以及五項商用 API 中的四項。
API 是讓應用程式向另一項服務送出要求並取得結果的介面。這裡比較的是特定服務與測試設定,不能把「高於四項」改寫成所有商用翻譯都已被超越。
本刊沒有重新跑出這些數字,也沒有把官方展示當成實測。實際會議還會加入收音、網路、翻譯服務及語音合成的等待,需要另外量測完整流程。
理解時間的口徑後,還要看不同語音場景的翻譯品質是否一致。
能比專業口譯員更好嗎?限定樣本和不同榜單一起看
官方測試提供一組有參考價值的比較,但樣本與評分範圍不足以代表所有現場口譯工作。新聞標題若省略這個範圍,就容易把有限結果擴大成通用結論。
團隊收集十八段中英文錄音,都是 2026 年 9 月起新出現在網路上的內容,每段約六分鐘,涵蓋軟體與 AI、醫療、教育等十個領域。
參與者有六位具實務經驗的同傳口譯員,其中三位持 CATTI 一級口譯證書,三位持二級證書。比較時,各證照組都取三人中最高的分數。
公司據此描述,模型在這組樣本的翻譯品質可與專業口譯員相當,且常有較低延遲。但官方也明示,這不構成語音品質、聲音相似度等面向的全面評估。
短音訊榜單同樣有強弱之分。以下保留官方表格中的三個系統,數值越高越好,方便看出 Hy-SimulMT 並沒有在每種資料上都領先。
| 官方短音訊評測 | Hy-SimulMT | Qwen3.8-LiveTranslate | Gemini3.5-LiveTranslate |
|---|---|---|---|
| FLEURS | 90.3 | 88.4 | 92.4 |
| CoVoST2 | 75.5 | 82.1 | 74.4 |
| ACL6060 | 81.2 | 80.5 | 82.6 |
| RealSI-Sentence | 84.7 | 84.4 | 82.2 |
其中 RealSI-Sentence 的 84.7 是完整官方表格所有列出系統中最高,其餘欄位則有其他系統較高。表格把整列模型名稱加粗,也不代表每欄都是第一。
所以,這組資料適合作為挑選試用對象的依據,再回到自己的談話類型確認。六分鐘演講的比較,不能直接保證嘈雜多人討論、專業協商或所有口音都同樣可靠。
即使文字翻譯符合需求,要讓聽眾聽到另一種語言,仍需要語音合成那一段。
翻譯語音與聲音複製,為什麼要另外接 TTS?
官方部署說明要求配置文字轉語音服務,才能輸出翻譯語音並使用聲音複製。TTS 就是把文字合成可播放聲音的技術,和模型產生翻譯文字分屬不同環節。
完整流程可以理解成:接收原始語音、持續產生翻譯,再由 TTS 說出譯文。哪一段花多久、送往哪個服務,都會影響聽眾最後的體驗。
因此,模型下載完成、文字也順利出現,還不能證明聲音輸出已經可用。因為還要把 TTS 連線、可用聲音、播放和錯誤回應一起接好,才是一條能聽見的流程。
官方展示包含英翻中和中翻英,也呈現保留講者聲音特徵的能力。不過,這兩支影片是離線重播,官方已提醒不能把影片播放時間當成即時延遲測量。
它們適合用來觀察譯文、聲音特徵和說話方式,至於現場是否跟得上,仍得回到持續收音的流程確認。看得出聲音相似,也不等於所有聲音品質都已獲得驗證。
若準備使用聲音複製,應事先取得講者同意,並說明聲音將用在哪個場景。這是採用建議,不能把官方提供示範解讀成任何人的聲音都可任意拿來使用。
這個分工也讓部署費用與可用條款,需要按元件分別確認。
開放權重如何部署?模型、硬體與服務費分開看
模型以 Apache 2.0 公開,但實際系統還包含推論環境、TTS 服務及各自條款。免費取得權重,和取得一項不需付費維護的線上同傳服務,是兩件不同的事。
官方 vLLM 部署說明以 Linux、NVIDIA 運算顯示卡及相容驅動環境為主。vLLM 是載入模型並提供推論的工具,團隊仍需準備足夠記憶體和服務環境。
模型名稱中的 30B 與 A3B 指總參數和啟用參數規模,參數是模型運作的數值。A3B 不能讀成只需要三 GB 記憶體,因為權重和執行中的資料都要占用空間。
對想用不同框架的團隊,官方也列出 llama.cpp 與 SGLang-Omni 路徑,但兩者條件不完全相同。因此,選擇前應確認模型格式、輸出種類和目前支援範圍。
截至 2026 年 10 月 29 日查核,模型卡提醒 llama.cpp 支援尚未併入官方專案,現有提交先支援命令列推論,伺服器支援仍在規劃。不能把部署段落當成所有正式版本已可直接執行。
SGLang-Omni 的該整合則提供翻譯文字,需要另接 TTS,並有限定模型版本。替換推論框架時,應確認這些差別,不能只因介面看起來相近就假設功能全部相同。
使用時也要保留第三方元件的授權資訊,例如專案使用的語音辨識元件。模型本身的條款,不能代替所有相依工具與外部 TTS 服務的條件。
本次資料未提供一個適用所有部署的每小時價格。運算設備、外部語音服務、連線與維護都會改變總成本,因此應以預計會議長度估算,而不是直接宣稱零成本。
取得能運作的環境後,可以先用一段有人工對照的會議片段檢查整條流程。
用會議片段驗收中英轉換,別只看流暢的聲音
我建議先固定一段可分享、有正確翻譯的片段,比對專名、否定句和轉換時機,再測完整對話。以下是採用方法,並非本刊已完成的效能測試。
先保留原話和人工確認的譯文,選入包含數字、條件與更正的內容。因為聲音自然時,聽眾更容易忽略意思缺漏,對照文本才能指出究竟漏掉哪個條件。
例如,會議說的是「目前不批准,補完資料後再討論」,就應確認譯文沒有只留下批准或再討論。這類檢查比單純詢問聲音是否流暢,更接近使用者要避免的誤解。
接著連續播放較長內容,觀察翻譯是否逐漸落後、是否在後文出現時修正前面的意思。因為修正太晚時,聽眾可能已依前一個版本回話,這也是同傳體驗的一部分。
時間紀錄則分開保存首次文字、首次聲音和持續翻譯的落後程度。這能讓團隊找到等待發生在哪個環節,而不把所有問題都歸到模型的三秒指標上。
最後把語音服務的費用、講者同意與人工接手安排進原型。當整段流程都能重現,才有足夠依據決定是否擴大到較長會議或更多使用者。
讓聽眾更早得到正確意思,才是值得擴大使用的同傳成果。
若想比較另一條即時翻譯路線,可以接著了解交錯輸入與語音輸出的設計,以及它們對持續對話的影響。
延伸閱讀:殺入人類同傳 2.3 秒極限區間!阿里發表 Qwen3.8-LiveTranslate:Interleave 交錯架構、Thinker-Talker 雙模、多人語音分離與端到端即時翻譯深度解析
若需求更接近錄音整理或語音代理,也可以從轉錄、語音生成與服務價格的分工,重新界定要採用哪一類工具。
延伸閱讀:Voxtral 3 是什麼?Mistral 語音轉錄、語音生成與代理 API 的價格與限制
Hy-SimulMT 常見問題 FAQ
模型頁列很多語言,代表都能同聲傳譯嗎?
本次官方發布與核心說明明確以中文、英文雙向同傳為範圍。模型頁的語言標籤不能直接擴寫成所有列出語言都具有相同的同傳支援。
約三秒,代表三秒後一定會聽到翻譯嗎?
不代表。這是特定 RealSI 長錄音評測的 StreamLAAL 落後指標,不是首次語音輸出時間,也不構成所有網路、硬體與語音服務配置的固定保證。
只下載模型,就能產生複製聲音的翻譯嗎?
完整語音輸出和聲音複製需要另外配置 TTS 服務。應先確認翻譯文字、語音合成與播放器三段都能正常工作,再驗證實際等待與聲音表現。
人類對照結果,能證明所有專業口譯都可被取代嗎?
不能。官方比較限定十八段錄音、六位參與者和該次評分設定,也不是聲音品質等面向的全面檢驗。採用判斷仍應回到工作內容與可接受的錯誤範圍。
中英會議原型值得試,採用依據要涵蓋完整流程
Hy-SimulMT 的價值,在於把中英翻譯的品質和長段溝通中的等待放在一起處理。官方數據提供了新候選,但最終成果還取決於語音合成與部署方式。
對能自架服務的團隊,我會先用固定片段驗證意思和持續落後,再考慮更多場景。一般使用者則可以先確認現成工具的實際語言與功能,避免把模型開放誤認為服務已經全部包好。
歡迎免費訂閱 AI 郵報,持續追蹤語音模型、即時翻譯與開放工具的實際使用條件。