Anthropic 共同創辦人 Jack Clark 對 IMF 說「奇點已經開始」:他是怎麼一步步論證的?
Anthropic 共同創辦人 Jack Clark 對 IMF 說「奇點已經開始」,他的論證有六步,證據越往後越薄。另有 RTX Spark 對上 Mac 的本地 AI 實測、REA 兩週衝上 35 萬顆星、Zeabur 與 Character.AI 退場、TasteVal 等本週 AI 大事。
OPENLAB 2026 早鳥倒數!12/5 一起來玩 AI,全球指標品牌陸續解鎖!
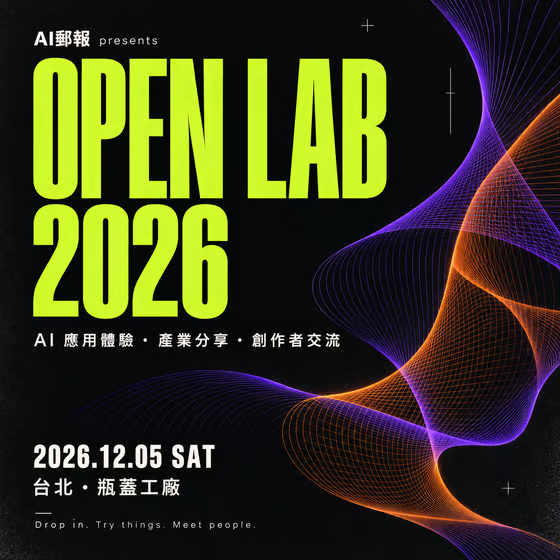
今年 12 月 5 日,AI 郵報將在台北瓶蓋工廠舉辦 OPENLAB 2026!這次我們希望把活動變成一座真正能動手玩的 AI 實驗場,不只是聽講座、看產品展示,而是讓每個人都能親自體驗 AI 的各種可能性。
目前已有數個全球指標品牌正式確認參與,完整合作陣容與活動內容,我們將在接下來幾週陸續揭曉。不過,今天想先跟大家分享其中一個我們很期待的活動區域:AI Playground!
🎡 AI Playground:轉出一道任務,帶走一件作品
這次 OPENLAB 將規劃多個 AI PC 體驗主題桌,涵蓋 AI 影像與影片生成、Agent × n8n 自動化工作流、AI Coding、AI 音樂、AI 資安等不同應用。
現場可以透過任務輪盤抽取挑戰,再前往對應的主題桌實際操作。例如讓一張照片動起來、用 AI 打造自己的自動化流程,或是生成一段專屬配樂。每個體驗區都會有志工協助引導,即使沒有相關技術背景,也能跟著完成挑戰,帶著自己的作品離開。
我們希望大家來到 OPENLAB,不只是知道 AI 又推出了哪些新功能,而是能真正感受到:原來這些技術已經可以用在自己的工作與生活中。
除了 AI Playground,當天也將安排 AI 短講、Live Demo、產品體驗、創作挑戰,以及首次公開的《2026 AI 郵報讀者調查》,讓大家一起回顧這一年 AI 帶來的變化。
🎟️ 早鳥票 NT$500,10/31 中午截止!
目前 OPENLAB 2026 早鳥票已進入倒數階段,10 月 31 日(六)中午 12:00 截止,票價 NT$500,之後將恢復一般票 NT$800。 門票包含當天的活動體驗、講座分享、飲品與餐點。
活動資訊
- 日期: 2026 年 12 月 5 日(六)
- 地點: 台北瓶蓋工廠
- 時間: 13:00 報到、13:30 正式開場、17:30 餐敘交流
- 票價: 早鳥 NT$500/一般 NT$800
不論你是想認識更多 AI 同好、探索新的工具與應用,或只是想找個下午好好玩 AI,都很歡迎來 OPENLAB 2026 跟我們交流。
AI 能做什麼,你已經看過很多。這一次,換你動手。
全球品牌與講者陣容也將陸續公布,期待 12 月 5 日在台北瓶蓋工廠見到大家!
本週焦點事件
- Anthropic 共同創辦人 Jack Clark 對 IMF 說「奇點已經開始」:他是怎麼一步步論證的?
- NVIDIA RTX Spark 筆電開賣:同樣 128GB 記憶體,跑本地 AI 比得過 Mac 嗎?
- 開源工具 REA 兩週衝上 35 萬顆 GitHub 星:讓 Claude Code 和 Codex 替你拆開沒有原始碼的軟體
- Zeabur 兩度被入侵後宣布結束營運,Character.AI 也進入破產拍賣
- 衡量 AI「研究品味」的新測驗 TasteVal:Opus 5.5 贏過 24 位頂尖實驗室專家,Jack Clark 把 AI 自我改進的時程提前到 2027
Anthropic 共同創辦人 Jack Clark 對 IMF 說「奇點已經開始」:他是怎麼一步步論證的?
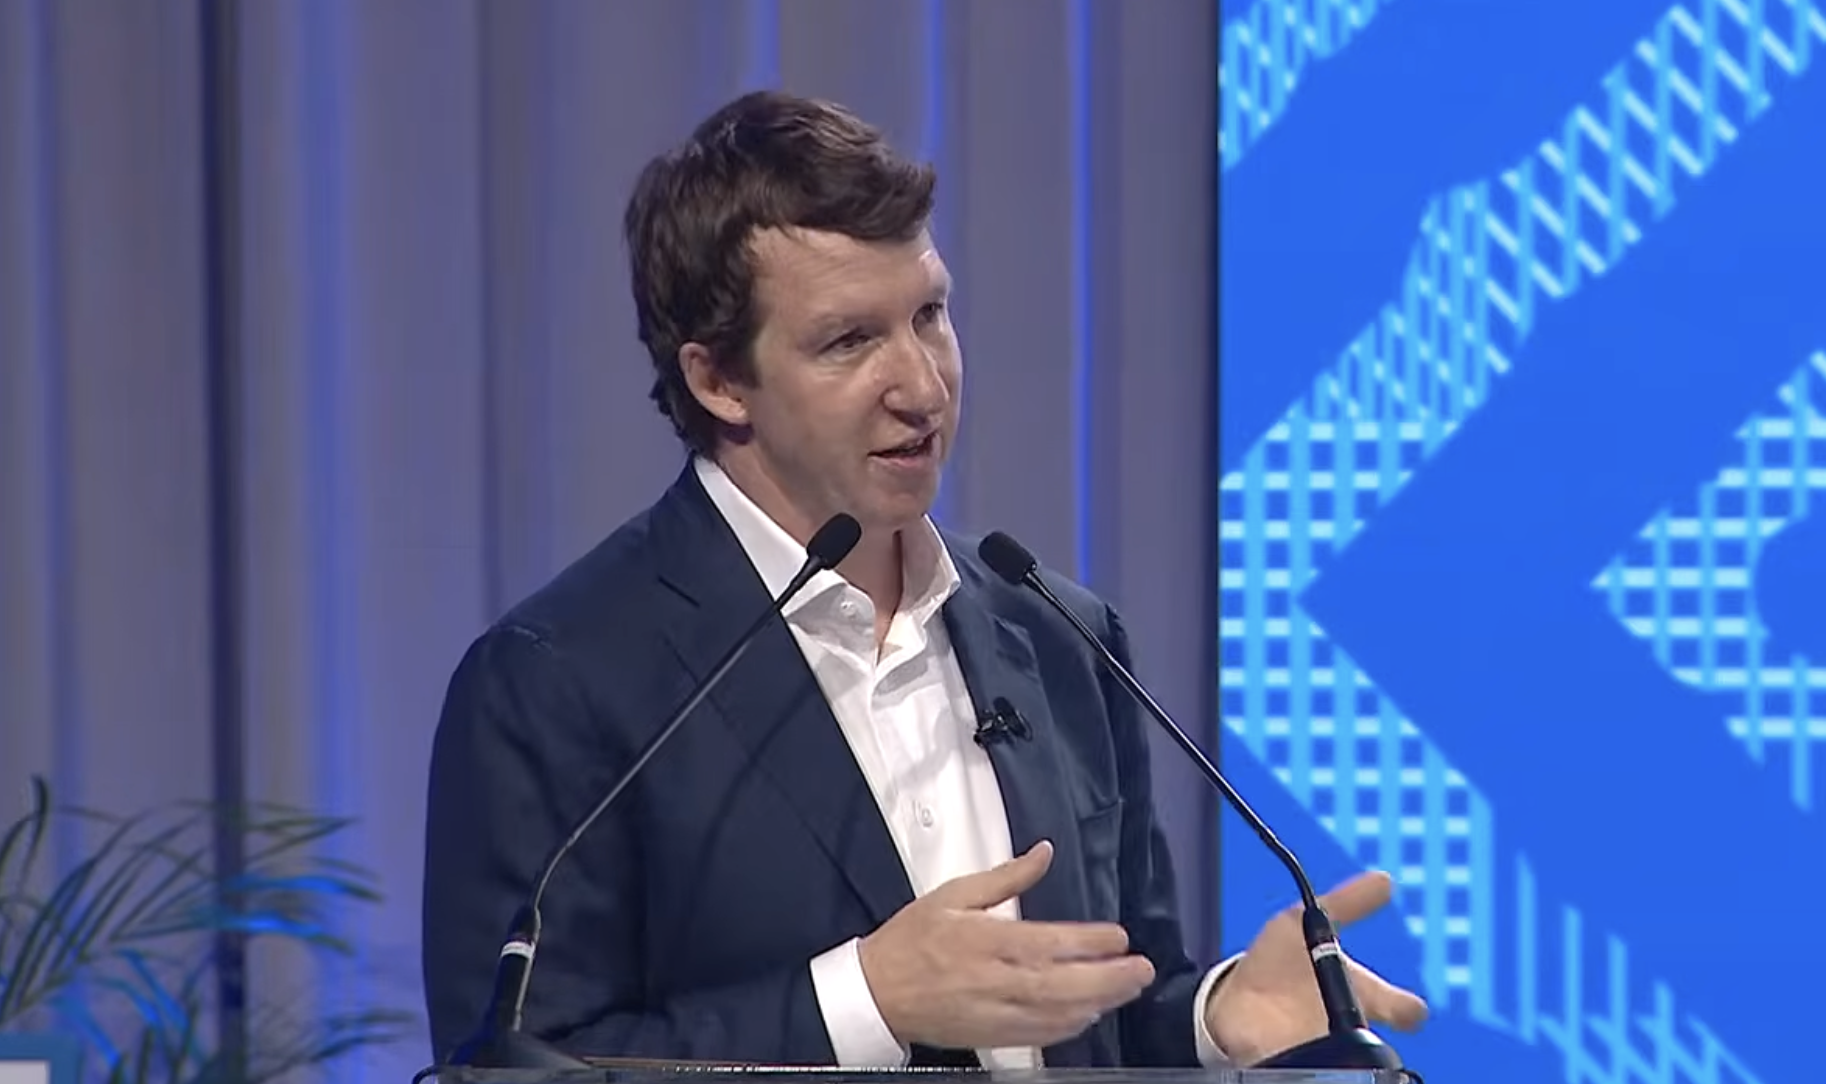
10 月 17 日週六,Anthropic 共同創辦人 Jack Clark 站上曼谷 IMF 與世界銀行年會的講座,對各國財政與經濟官員說:「我相信今年我們已經取得令人信服的證據,顯示奇點現在已經開始。」
他引用科幻作家 Vernor Vinge 在 1993 年提出的「技術奇點」(Technological Singularity)概念,描述當超越人類的智慧,能比人類更快地推動技術進步,那現有的社會、經濟與科技預測模型都可能失去效用的轉折點。
但奇點的關鍵不只是 AI 變得比人類聰明,因為如果單純只是比人聰明,那基本上去年就已達成,所以重點是 AI 能不能開始參與技術研發,甚至能協助開發下一代更強大的 AI,技術進步就可能形成自我加速的循環。
Clark 認為,2026 年的現在,我們已經開始看見這個循環出現的跡象。他的論證大致可以整理成六個階段(這一段論述比較長,但我個人認為蠻值得大家閱讀,因為同時可以從具體上的數據,回顧 AI 成長的速度)。
首先,Clark 從人類研究生產力面臨的瓶頸談起。他指出,過去半世紀,多數國家的研究生產力持續下降,即使研究人員數量大幅增加,產生重大突破卻變得越來越困難,也就是經濟學界所說的「好點子越來越難找」(Ideas Are Getting Harder to Find),所以人類研究、發現、發明的曲線已越來越平滑。
第二步是程式碼。Clark 說 AI 現在的程式能力等於或勝過多數軟體工程師,Anthropic 研究人員的程式碼產出約是公司前四年的 10 倍。重要的是,AI 研究本身也高度依賴程式開發,當 AI 能加速寫程式,也等於開始協助加速自身的研發流程。 這是技術自我加速最直接的早期跡象之一。
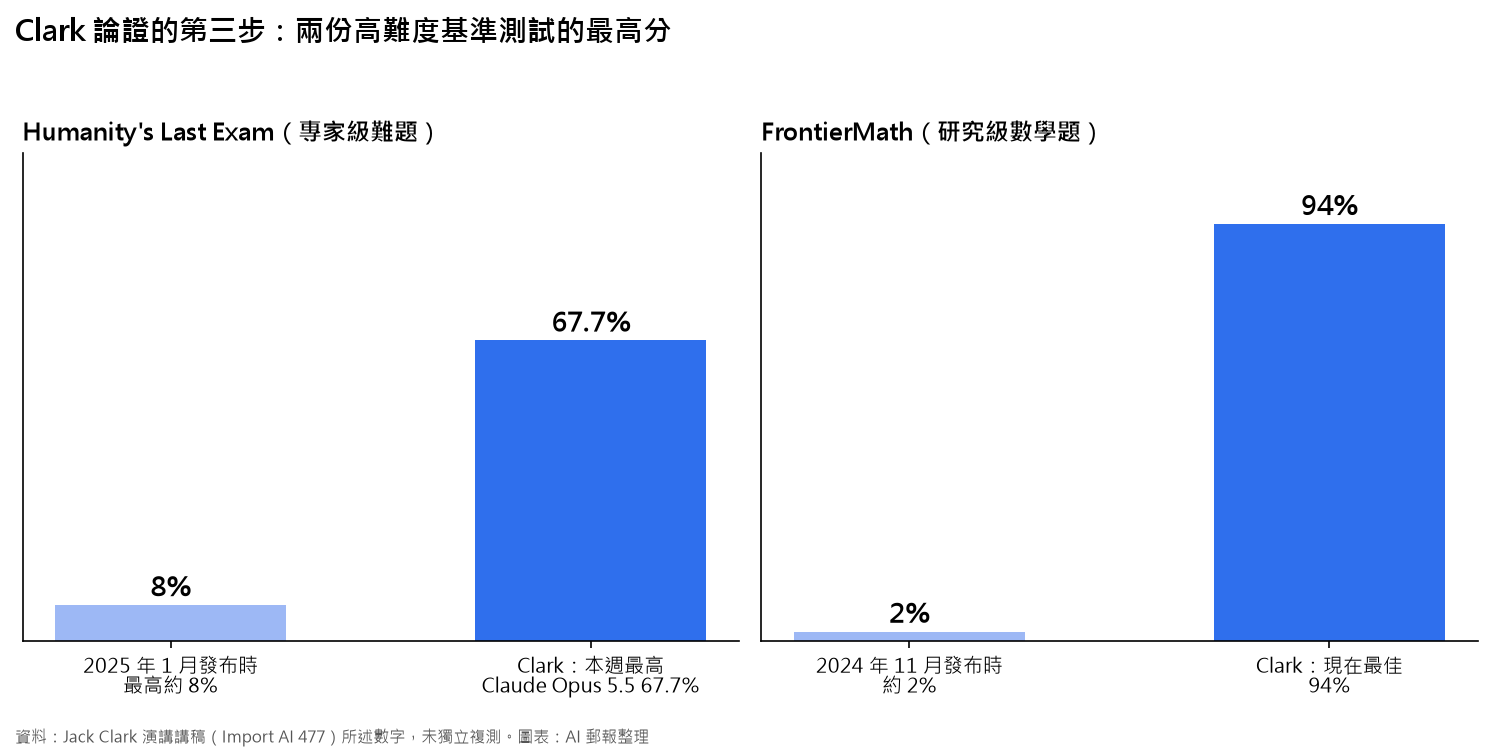
第三步是基準測試。Humanity's Last Exam 是 2025 年 1 月發布的專家級難題集,發布時最高分約 8%;Clark 說「截至本週」最高分是 Claude Opus 5.5 的 67.7%。FrontierMath 是研究級數學題,2024 年 11 月發布時約 2%,他說現在最佳成績已達 94%。這代表 AI 正快速逼近過去只有頂尖專家才能處理的科學難題,從協助整理既有知識,逐漸走向參與前沿研究。
第四步是他用來支撐「創造力」的案例。TheoPhysEval 是演講前一週發表的論文,由各國物理學家編寫了 50 題未公開的理論物理題。GPT-6-Astra 起初得分在八十幾,Opus 5.5 緊追在後;模型反過來質疑專家提供的標準答案,專家重算後發現部分計算確實有錯,修正後 Astra 達到 98%(49 題)。物理學家 Suvrat Raju 甚至表示,他不知道有哪個人能在沒有 AI 協助下解出題集中相當比例的問題。這意味著 AI 不只是照著人類提供的答案解題,甚至開始能糾正專家,展現獨立科學推理的潛力。
第五步是三個科學領域的例子。數學方面,Clark 說 AI 系統已經「提出」千禧年大獎難題、雅可比猜想與數個 Erdős 問題的解法,部分核心洞見甚至來自 AI;生物方面,研究者利用 AI 從零設計病毒、尋找新藥候選物,部分進入試驗的藥物也大量借助 AI 設計;機器人方面,AI 則越來越能遠端自主操作實驗設備。這些案例顯示 AI 正從單純處理資訊,逐漸參與提出假設、設計實驗到驗證結果的科學研究流程。
第六步是將研究能力大量複製。Clark 說自己花了將近 40 年累積知識與經驗才走到今天,但如果能同時運行數百、數千個具備類似能力的 AI 系統呢?培養一批專業科學家需要 10 到 15 年與數百萬美元,AI 卻可以在算力允許下快速部署。他援引 UNESCO 估計,全球約有 1,000 萬名科學家,如果未來這些人可以指揮十億個虛擬科學家,研究產能就可能不再受到人類人才培養速度的限制。而當大量 AI 科學家也能投入 AI 研發,就可能形成「更強的 AI → 更多研究突破 → 更強的 AI」的加速循環。
論證之後是政策要求。Clark 說自己十年來一直勸政府建設電力與資料中心,但如果 AI 真的開始加速科學研究,下一階段的瓶頸可能轉移到機器人、實驗設備,以及把新發現送進臨床、工廠與農田的管道。因為即使 AI 能在一天內提出上千種新藥候選物,臨床試驗仍需要時間;即使 AI 能設計新材料,也需要實體設備進行驗證。因此,真正的技術加速不只依賴更強大的模型,還必須有足夠的現實世界基礎設施。
風險方面,他特別點名生物與網路武器,要求生物研究必須有「最嚴格的人類監督與透明」,也警告讓 AI 參與 AI 研究必須「極其謹慎,否則可能失去對技術的控制」。他要求各國制定「不尋常且嚴肅的規則」,規範這項技術與開發它的公司,發展必須慢而審慎,並認為人類剩下的準備時間只有「幾年」。
觀察筆記
我覺得 Clark 這場演講最值得注意的,反而是他對下一階段 AI 基礎建設的判斷。
過去幾年,我們一直在討論 GPU、電力、資料中心,因為算力是 AI 發展最直接的限制。但當 AI 開始具備科學研究能力,瓶頸可能就會從數位世界轉移到實體世界。
這個轉變其實很好理解:AI 可以在短時間內提出上千種新藥候選物,但臨床試驗不會因此縮短成幾天;AI 可以快速設計出新材料,但仍需要實驗室與設備驗證。當「產生新發現」的速度開始超過「驗證與應用」的速度,真正稀缺的資源就可能從算力轉向實驗設備、機器人與實體基礎設施。
這也是為什麼 Clark 不只呼籲政府繼續投資資料中心,更強調下一階段應該建設科學實驗與機器人基礎設施。我認為這個觀察很重要,因為它意味著 AI 的下一波競爭,不一定只是誰擁有最強大的模型,而是誰有能力將 AI 產生的知識,最快轉化成真實世界的成果。
AI 郵報學院近期開課:
零基礎也能玩 API:用 AI 加速前端串接與資料篩選
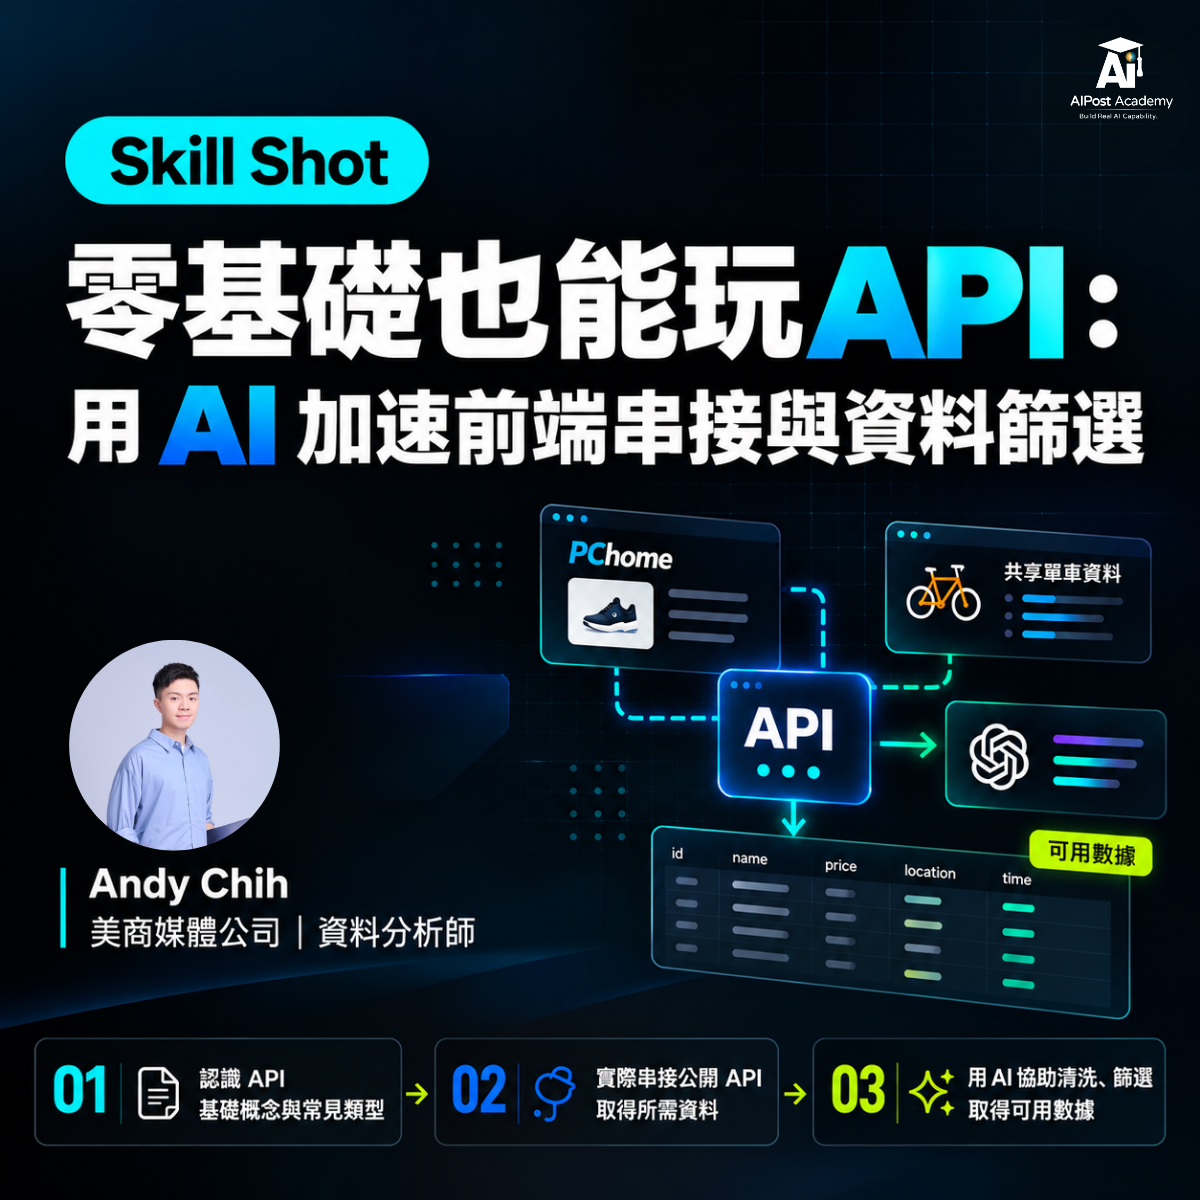
由統計系出身、擁有五年以上經驗的美商媒體公司資料分析師 Andy Chih,親自帶你用 AI 跨過「資料從哪裡來」這道門檻,不只會下載 CSV,也能自己用 API 取得資料。
課程以五個環節帶你操作:
- 搞懂 API 的基礎概念與常見類型
- 案例一|PChome 電商商品 API:蒐集商品資料並延伸到競品分析
- 案例二|共享單車公開 API:觀察站點、時段與需求量
- 用 AI 協助撰寫串接程式,完成資料清洗與篩選
- 把 API 取得的資料應用在資料分析
下課後,你將帶走課程提供的程式碼範例、Prompt 範例與 API 端點整理(資源包於直播後三天內上線),以及能直接用在作品集與工作上的 API 資料取得方法。
特別適合:
- 想了解 CSV 以外資料取得方式的資料分析職場人
- 準備資料分析作品集、想加入 API 資料來源的人
- 轉職或跨領域累積資料分析能力、沒有程式基礎的初學者
用 Claude Code 把 Podcast 音檔一次做成 YouTube 長片
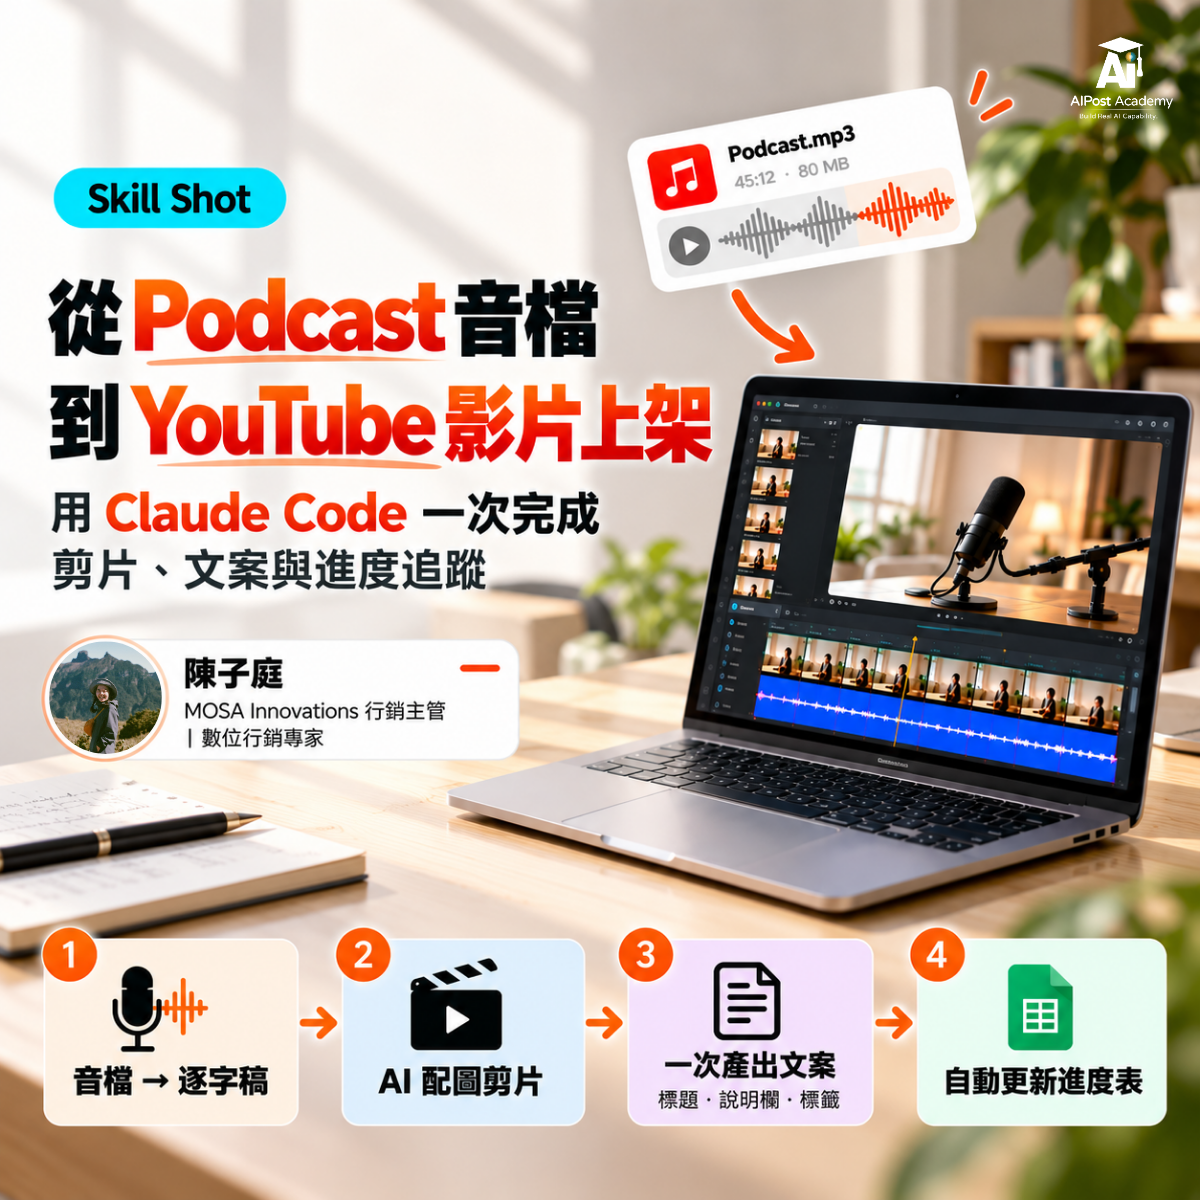
由具七年以上行銷經驗、現任智慧單車新創 MOSA Innovations 行銷主管的陳子庭,親自帶你用 Claude Code 走完「錄完 Podcast 之後」最耗時的後製流程。
課程延伸自 Skill Shot 09,以四個實戰環節帶你操作:
- 讓 AI 讀取照片,判斷每張圖該放在 Podcast 的哪一段,並處理直式、拍歪、重複與檔名不清的問題
- 把音檔與照片組裝成 YouTube 長片:前 20 秒預告字幕、片頭、主體配圖與片尾行動呼籲
- 從 Podcast 內容一次產出封面標題、影片標題、說明欄與標籤,不寫出節目沒提到的內容
- 選定標題後,自動把標題、說明欄與標籤填進 Google 試算表製作進度表
下課後,你將帶走一套「音檔 → 逐字稿 → 配圖剪片 → 文案 → 進度表」的後製流程,以及課程講義、懶人包與模板資源包,也清楚哪些工作適合交給 AI、哪些仍需要自己確認。
特別適合:
- Podcast 與 YouTube 創作者
- 需要固定產出內容的團隊、內容企劃與社群工作者
- 已完成 Podcast 音檔整理、想接續製作 YouTube 長片與文案的人
NVIDIA RTX Spark 筆電開賣:同樣 128GB 記憶體,跑本地 AI 比得過 Mac 嗎?
NVIDIA 在台北舉辦 RTX Spark 發表會,宣布搭載這款晶片的筆電全球同步開賣,ASUS、Dell 等六個品牌都有機型,台灣建議售價從新台幣 119,069 元起。最多 128GB 統一記憶體,AI 運算力是 1 petaflop,換句話說,以前要桌機工作站等級的電腦,現在全被塞進一台輕薄能攜帶的筆電。
一般的 Windows 獨顯筆電,CPU 有一池記憶體,GPU 另有一池顯示記憶體,容量通常遠小於 128GB,模型要在兩池之間搬來搬去,大模型就放不下。統一記憶體讓 CPU 與 GPU 共用同一池,模型權重一次放進去,GPU 直接讀。模型能不能載入,看的是記憶體容量;載入之後跑多快,看的是記憶體頻寬與運算力。Apple Silicon 的 Mac 早就是這個設計,RTX Spark 把同樣的設計帶進 Windows 筆電,並且保有 CUDA。CUDA 是 NVIDIA 的 GPU 軟體平台,多數 AI 工具與模型都先支援它。
這次發表會的代表機型之一,是 ASUS 推出的 ProArt P16(H7607),官方主打全球首款搭載 NVIDIA RTX Spark 的 ProArt 筆電。除了最高 128GB 統一記憶體、可在本機執行約 120B 參數的大型語言模型,機身厚度僅 12.9mm、重量約 1.77 公斤,並配備最高 4K、120Hz 的 Lumina Pro OLED 螢幕。
對創作者來說,這代表過去需要工作站才能處理的大模型,有機會直接帶到拍攝現場、咖啡廳或客戶端運行,不必將未公開的素材與資料上傳雲端。對開發者而言,則能透過 CUDA、PyTorch 等工具在本機測試 AI 模型與 Agent 工作流。不過,128GB 與 120B 都是官方最高規格,實際效能仍取決於模型量化方式、記憶體頻寬與軟體支援。
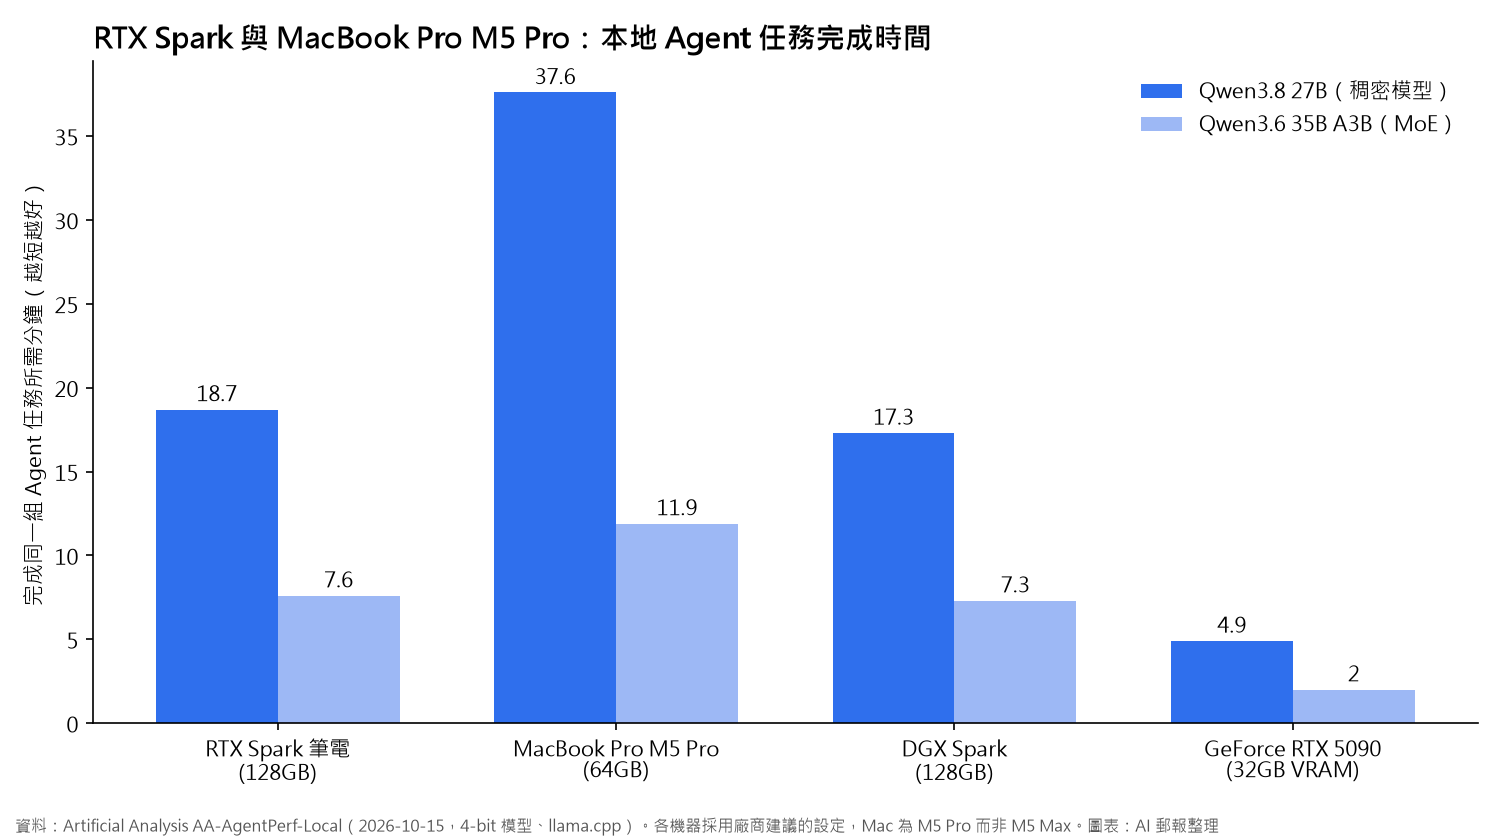
但與蘋果產品相比,128GB,到底誰比較強?國外評測網站 Artificial Analysis 重播 8 段錄下來的 Agent 任務,每一輪都帶著最多 56K 的上下文重新送出,結果 RTX Spark 跑 Qwen3.8 27B 花 18.7 分鐘,MacBook Pro M5 Pro(64GB)花 37.6 分鐘。
規格與價格對照
| 項目 | RTX Spark(20 核) | MacBook Pro M5 Max |
|---|---|---|
| 最大記憶體 | 128GB(僅 20 核版本) | 128GB |
| 記憶體頻寬(規格表) | 約 300GB/s | 614GB/s(40 核 GPU 版本) |
| GPU | 6,144 核 Blackwell(CUDA) | 最高 40 核 GPU(Metal/MLX) |
| 美國標價(2026-10-17) | 5,899.99 美元(Surface Laptop Ultra,128GB/1TB) | 6,699 美元(14 吋,128GB/2TB) |
| Geekbench 多核(Tom's Hardware 引述) | 約 23,700 | 約 35,600 |
| 軟體 | Windows on Arm,CUDA、PyTorch、llama.cpp | macOS,LM Studio、Ollama 兩邊都能跑 |
逆向工程工具 REA 兩週衝上 35 萬顆 GitHub 星:讓 Claude Code 和 Codex 替你拆開沒有原始碼的軟體
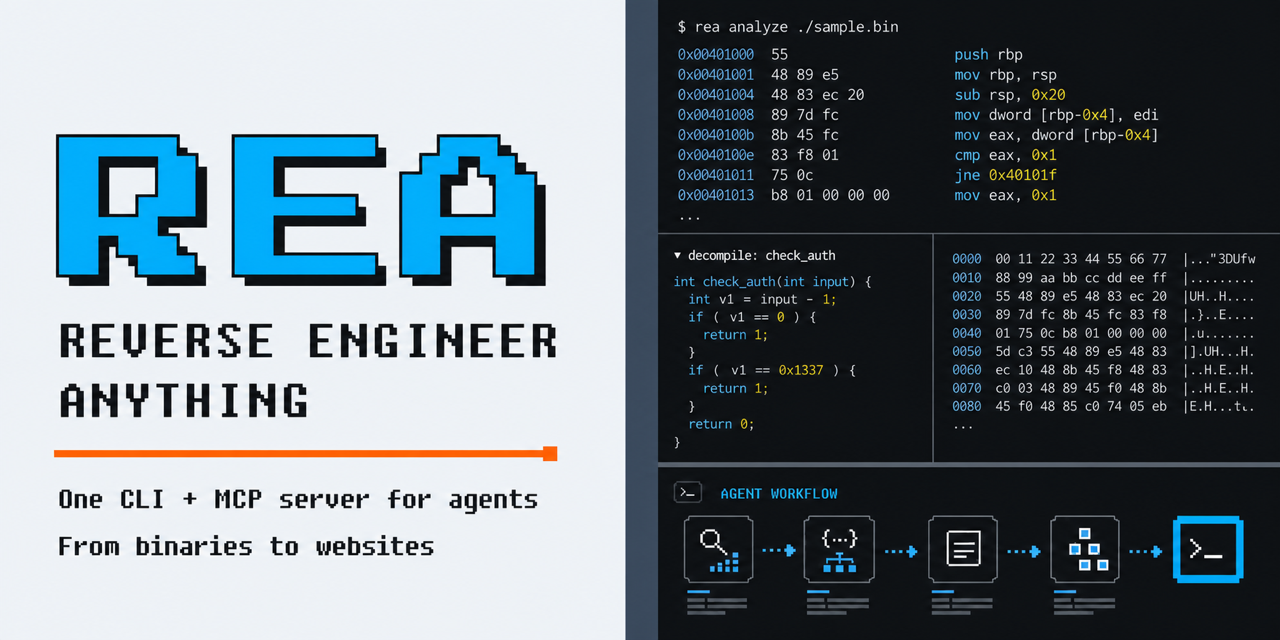
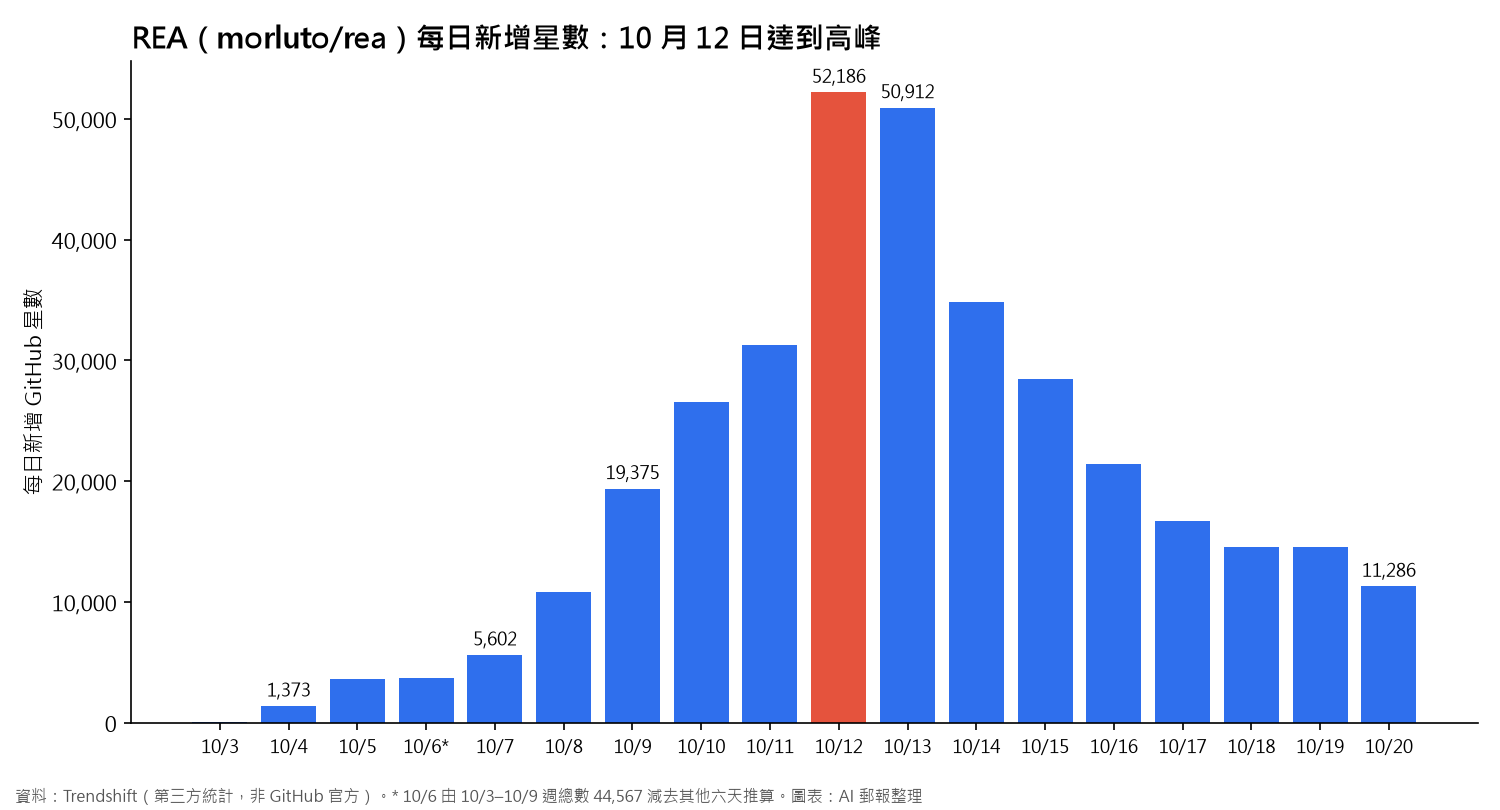
REA(Reverse Engineer Anything)是 GitHub 使用者 morluto 的開源專案,4 月 14 日建立,10 月第一週開始爆紅,到 10 月 21 日 GitHub 上顯示約 350,886 顆星、88,193 個 fork。它的賣點在 README 的第一句:看到喜歡的功能,理解它到底怎麼運作,一路到二進位檔的層級。
逆向工程是什麼?不看原始碼,從已編譯的程式反推它怎麼運作,傳統上要同時操作 Ghidra、IDA、Hopper 這類專業工具,並逐段閱讀反編譯結果。而這個 REA 工具本身是一個 MCP 伺服器與命令列工具,把這些專業工具包成程式代理能呼叫的介面,沒有另外實作反編譯器。
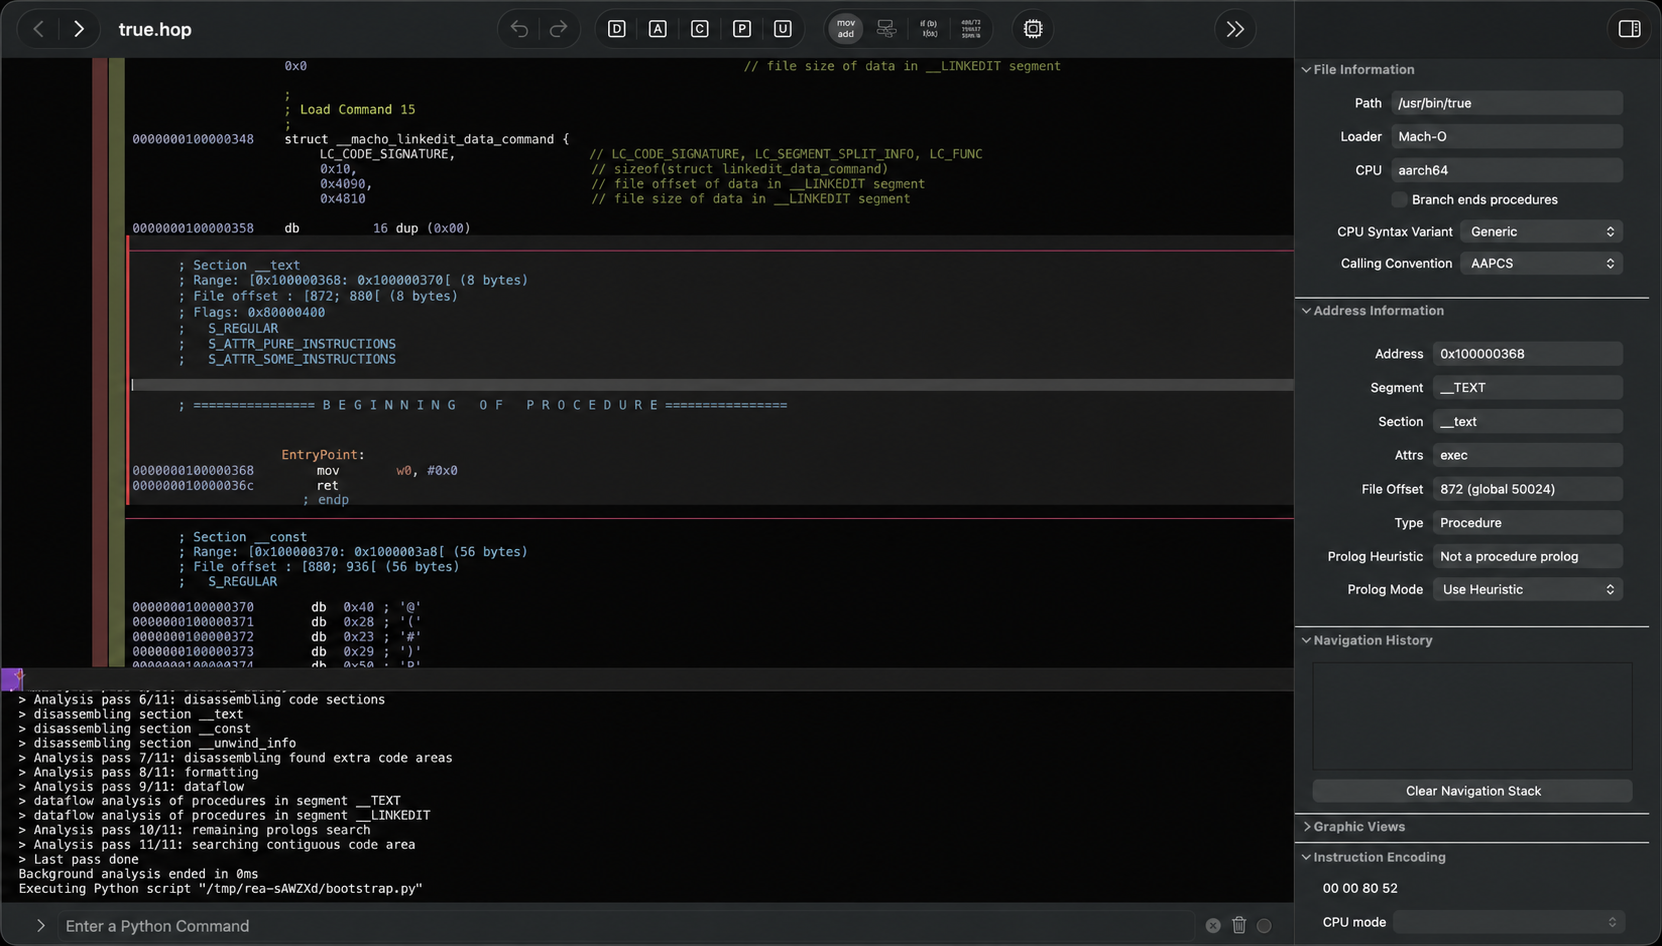
安裝用 npx rea-agents setup,需要 Node.js 22.19 以上;專案以 MIT 授權開源。原生分析需要另外取得 IDA、Hopper 等工具的合法授權,並支付你所用代理的模型費用。用途限於合法研究、教學、互通性、軟體保存,以及分析自己擁有或獲授權的軟體,也明講不授權任何破解版本。
Zeabur 兩度被入侵後宣布結束營運,Character.AI 也進入破產拍賣
Zeabur 創辦人林沅霖在 10 月 17 日宣布,這個由台灣團隊打造的雲端部署平台將逐步結束營運,12 月 31 日前所有服務全部停止。直接原因是 10 月 14 日(UTC)發生的第二次資安事件,公司說影響範圍比 8 月底的第一次更大,調查仍在進行,完整報告尚未公布。
Zeabur 是雲端部署平台:開發者把程式碼或 Docker 服務交給它,由它在 AWS、Google Cloud 等雲端主機上跑起來,省去自己設定伺服器的麻煩。服務分兩種,專用伺服器是一個客戶獨占,共享叢集則是多個客戶共用。如果你是接案工程師或做 side project 的人,大概知道這類平台的賣點:把 OpenAI 或 Anthropic 的 API 金鑰、資料庫密碼放在「環境變數」裡,平台幫你保管。問題在於,平台的資料庫一旦被讀取,這些祕密就一起外洩。就像把家裡的備用鑰匙交給社區管理室保管,平常很方便,管理室被闖入的那一天,每一戶的鑰匙會一起不見。
8 月 27 日(UTC)的第一次事件,攻擊者利用某位用戶部署的 NextChat 服務漏洞進到內部網路,從快取取得沒有權限範圍、也沒有到期時間的舊版 API 金鑰,其中一把屬於團隊管理員;有了這把金鑰,攻擊者取得 AWS 最高權限,進而讀取存放專案設定的正式資料庫,部分專案的環境變數被讀到,內容包含第三方 AI API 金鑰、雲端憑證與資料庫密碼。公司的監控沒有偵測到入侵,直到用戶回報 API 金鑰被濫用,團隊才在 8 月 28 日確認。9 月 7 日公布事故報告時,公司承認金鑰管理、權限分離、網路隔離與監控都有缺口。
第二次事件的細節還不多。依 Zeabur 狀態頁,除共享叢集外,部分 Google Cloud 專用伺服器也被未授權存取,攻擊者取得平台資料庫的讀取權限,受影響的資料包含服務環境變數、帳號資訊、API token 與 zSend 金鑰。林沅霖也說,結束營運還有三個背景因素:AI 讓雲端部署的需求增加,同時也大幅降低了部署門檻;成長遇到瓶頸;系統從快速打造的專案一路改方向,複雜度與維護負擔不斷上升。
Zeabur 時間線
| 日期 | 事件 |
|---|---|
| 2026-08-27(UTC) | 第一次資安事件 |
| 08-28 | 團隊在用戶回報 API 金鑰被濫用後確認事件 |
| 09-07 | 公布 8 月事故報告 |
| 10-14(UTC) | 第二次資安事件,公司稱影響大於第一次 |
| 10-17 | 宣布結束營運;新專用伺服器與網域停售;餘額退款開放申請 |
| 12-01 | 專用伺服器停止續費並依到期日陸續關閉;共享叢集暫停運行 |
| 12-31 | 所有專用伺服器與共享叢集全面停止 |
如果你的服務還在 Zeabur 上,眼前有幾件事。把放過的所有 Secret 都轉一遍:
1. OpenAI、Anthropic、OpenRouter 等第三方金鑰、資料庫密碼、雲端憑證,並重新產生 Zeabur API token
2. 檢查 Google Cloud 專用伺服器上有沒有陌生的 SSH 金鑰;備份資料並規劃搬遷,網域可以自己從控制台轉出。
3. Zeabur 正在準備遷移指南,其中也有提供給 AI 程式代理閱讀的版本。賠償與退款要分開向 Zeabur Support 申請;Zeabur 註冊地在美國、沒有台灣分公司,跨境爭議的路徑是先找客服,再依序考慮 eConsumer 或信用卡的 chargeback。
同一週,Character.AI 也進入破產拍賣
Character.AI 的母公司 Character Technologies 在 10 月 12 日向德拉瓦州法院聲請第 11 章破產,目標是在法院監督下出售幾乎所有資產。Disney 擔任「stalking horse」(打底出價者),以 2,000 萬美元取得部分智慧財產的非專屬永久授權與特定法律請求權,並同意向至少 60 名員工發出聘用邀請,估計年薪總額約 6,000 萬美元。
stalking horse 是先談好的底價,其他買家要出得更高才能取代它。公司在文件中說,雖然有龐大且投入的用戶群,卻被高成本與潛在的訴訟責任及監管介入拖累;前年 Character.AI 曾被一位 14 歲男孩的母親控告,另外也面臨包括德州檢察長在內的兒童安全調查。
AI 連「研究品味」都超越人類?TasteVal 測驗:Opus 5.5 實驗效率達專家 2.3 倍
當 AI 已經能協助寫程式、執行實驗,下一個問題是:AI 能不能像真正的研究員一樣,判斷哪些實驗值得做、又該如何根據結果調整研究方向?
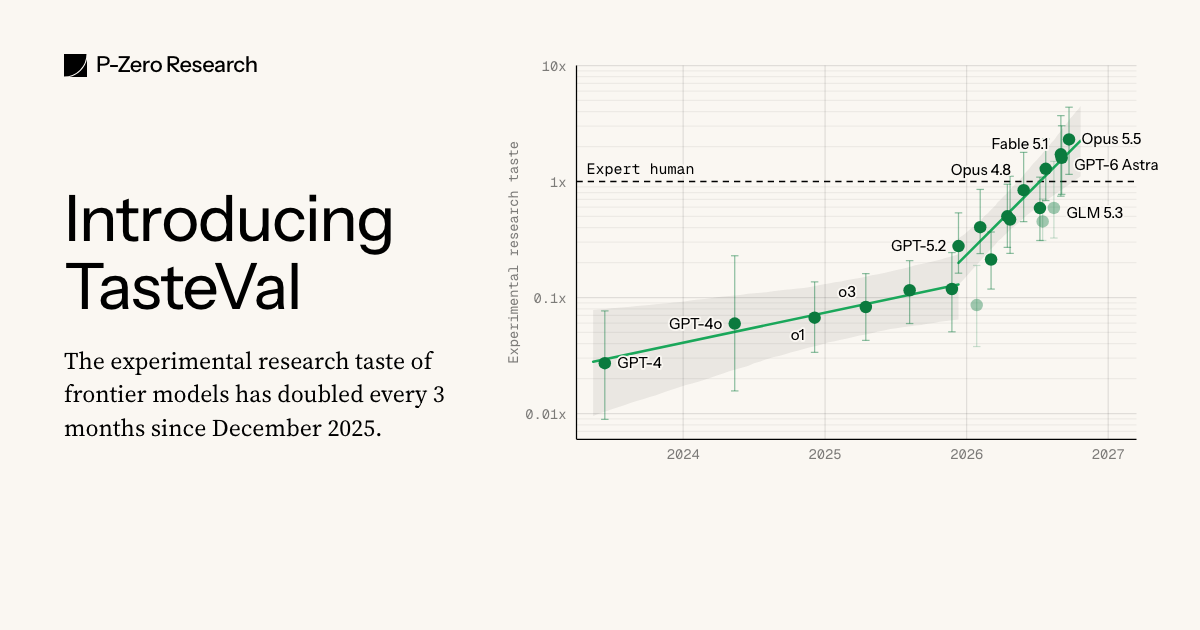
10 月 6 日,P-Zero Research 發表了一項新測驗 TasteVal,試圖衡量 AI 的「研究品味」(Research Taste)。這裡的品味不是審美,而是研究者面對有限時間與資源時,能否設計有價值的實驗,並從結果中找出下一步方向。這項能力也是 AI 能否進一步自主研發 AI、實現「遞迴自我改進」(Recursive Self-Improvement,RSI)的重要條件。
TasteVal 的設計很有意思。研究團隊準備了 8 項 AI 研發任務,涵蓋模型預訓練、微調、資料整理與對抗提示等領域,受測模型只負責規劃實驗、分析結果,真正寫程式與執行實驗則交給固定的 Coding Agent,使用單張 NVIDIA H100 GPU。每次測試最多提供 40 GPU 小時或 120 小時的實際執行時間,藉此排除模型寫程式能力的差異,專注比較研究決策的品質。
假設一位人類研究員需要 100 小時的實驗算力才能達到某個成果,AI 只需要 50 小時就能達成,那 AI 的實驗研究效率就是人類的 2 倍。研究團隊邀請了 24 位曾任職於 OpenAI、Google DeepMind、NVIDIA 等機構的專家參與,並以各任務表現最好的專家嘗試作為比較基準。
結果顯示,Claude Opus 5.5 的實驗算力效率達到人類專家基準的 2.30 倍(95% 信賴區間為 1.15~4.37 倍),而每次嘗試的平均成本只有專家的約 1/30。更值得注意的是,從 2025 年 12 月開始,前沿模型的實驗算力效率平均約每 3 個月翻倍,相較此前約 14 個月翻倍,進步速度明顯加快。不過,這項加速沒有同樣出現在最終研究成果的評分上。
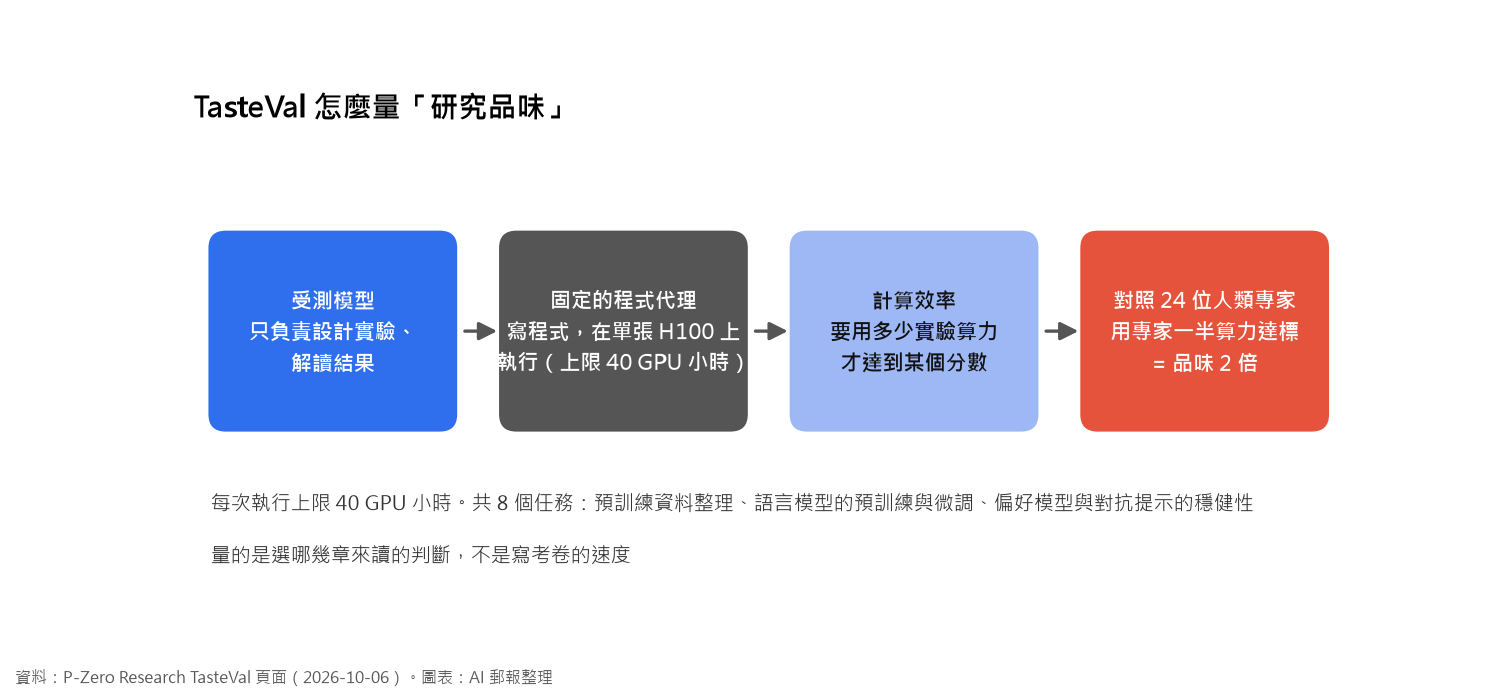
這個結果之所以重要,是因為過去我們討論 AI 研究自動化,焦點多半放在寫程式、執行實驗等工作。但真正的研究往往不是把實驗做完就好,而是知道下一個實驗該做什麼,才能用最少資源取得最有價值的結果。 TasteVal 顯示,AI 在這種實驗規劃與判斷能力上,也開始展現超越部分人類專家的表現。如果 AI 不只會執行研究,還能決定如何有效率地推進研究,就有機會進一步加速下一代 AI 的開發。
喜歡這期內容嗎?有哪一則讓你特別有感?
歡迎回信或是 Instagram 告訴我們,我們會偷偷讀大家的回覆的!
我們下週見
— AI 郵報編輯團隊