NVIDIA AI Cluster Runtime 是什麼?五步驟驗證 Kubernetes 與 Dynamo 推論環境
NVIDIA AI Cluster Runtime協助檢查GPU Kubernetes與Dynamo底層環境。解析版本配方、兩條快取路由、五步驟驗證與GPU資源限制,分清平台設定與應用效能。

NVIDIA AI Cluster Runtime 是給 GPU Kubernetes 叢集使用的開源設定產生與驗證工具,簡稱 AICR。Kubernetes 負責協調多台機器上的容器,AICR 則協助檢查推論所需元件是否配合得起來。
團隊把模型放上叢集後,仍可能遇到驅動、資源分配與排程不相容。因為應用設定只描述模型怎麼跑,沒有保證底層環境已準備好。
NVIDIA 在 2026 年 10 月 30 日發布技術指南,並於 11 月 3 日透過官方帳號介紹這套 Apache 2.0 開源工具。兩個日期分別是原文發布與社群傳播時間。
它將分散式推論框架 Dynamo 的底層需求寫成配方,固定元件版本、相容限制與驗證項目,讓平台團隊可以重現同一組設定。
這也把環境準備和模型應用部署分開,工程師先檢查驅動、排程與網路,再處理模型的實際服務表現,較容易判斷問題落在哪一層。
不過,使用者仍須準備自己的叢集與部署工具,效能驗證也會使用 GPU。官方配方提供可檢查的起點,實際負載仍要另外量測。
對正在建置多節點推論的團隊,先弄清楚底層依賴,才知道 AICR 能接手哪些工作,以及哪些責任仍在自己手上。
為什麼在 Kubernetes 跑 Dynamo 推論,不能只管上層模型設定?
在 Kubernetes 叢集上執行分散式推論時,定義模型怎麼跑的部署圖只是最頂層,底層的叢集執行環境也會影響服務能否運作。
只要底層少了一個驅動元件或排程設定不合,上層的模型容器就連啟動都成問題。
在 NVIDIA 的推論架構裡,開發者會撰寫一份名為 DynamoGraphDeployment 的自訂資源設定。
這份設定用來指定 vLLM、SGLang 或 TensorRT-LLM 等推論引擎,要如何在叢集的容器節點裡運作。
但這張推論圖只描述了應用程式的邏輯,它預設底下的叢集已經具備完整的硬體控制能力。
如果叢集沒有安裝對應版本的 GPU 驅動、沒有標記硬體拓撲,或者排程器不懂得同時啟動一整組推論節點,部署就會卡在半路。
依 NVIDIA 技術部落格發布的完整驗證指南,AICR 是 NVIDIA DSX AI Factory 平台的核心開源元件。
它的核心任務就是把這些底層叢集環境需求,打包成版本鎖定的可重現配方。
在隨附的 dynamo-platform 1.4.2 圖表中,官方也正式將自訂資源定義升級為 nvidia.com/v1beta1,取代原有的 v1alpha1 介面。
更重要的是,從 Dynamo 1.4 開始,前端路由器、推論工作節點與入口元件都能直接透過 Kubernetes 原生資源互相探索。
所以 AICR 的預設安裝路徑已經不再部署 NATS 訊息伺服器,只把 NATS 留給有特殊需求的團隊手動開啟,減少預設需要安裝的元件。
為了讓讀者看清一套生產級推論環境到底包含哪些底層積木,以下我把 AICR v1.0.0 針對 Amazon EKS 叢集搭配 NVIDIA GB200 NVL72 與 GB300 NVL72 系統所鎖定的核心元件版本整理成表格:
| 底層環境需求類別 | 負責解決的叢集問題 | AICR v1.0.0 配方鎖定元件與版本 |
|---|---|---|
| GPU 驅動與軟體堆疊 | 確保容器節點具備相容的 GPU 驅動與執行環境 | NVIDIA GPU Operator v26.7.1 |
| 硬體特徵探索 | 自動偵測並標記叢集內的 GPU 節點供排程識別 | Node Feature Discovery 0.19.0 |
| 動態資源分配|DRA | 透過 Kubernetes 原生動態介面安全掛載並分配 GPU | NVIDIA DRA GPU Driver 0.5.0 |
| 拓撲與群組排程 | 依硬體拓撲同時放置多節點推論工作群組 | KAI Scheduler v0.16.9 |
| 推論工作負載編排 | 將多個推論服務元件視為協調一致的群組進行啟動與擴縮 | Grove v0.1.0-alpha.13 |
| 節點健康監控與調校 | 在工作負載落到異常節點前先提供健康訊號與系統調校 | NVSentinel v1.25.0、NodeWright Operator v0.19.0 |
| 分散式推論與入口 | 提供 Dynamo 控制平面、快取感知路由與原生網路入口 | Dynamo Platform 1.4.2、Agent Gateway v1.5.0 |
| 指標與可觀測性 | 收集叢集、加速器與推論服務的即時運作指標 | Kube Prometheus Stack 84.4.0、Prometheus Adapter 5.3.0 |
表格呈現的分工說明,模型應用下面仍有多種基礎設施要協作。特定配方的版本組合有適用環境,不能直接當成每套叢集的通用清單。
過去平台工程師必須自己測試這些元件的相容性,現在 AICR 直接把測試通過的版本組合、雜湊檢查碼與節點容忍度寫進同一份配方裡。
當底層的驅動、排程與健康檢查都透過配方鎖定版本後,接下來的核心問題就是推論引擎如何利用這套叢集環境,把長對話請求精準送到正確的 GPU 上。
TCP 請求平面與 ZMQ 快取事件分離,如何解決代理長對話的重算瓶頸?
針對經常重複帶入長篇系統提示詞與工具定義的 AI 代理工作負載,Dynamo 1.4.2 透過分離請求通道與快取事件通道,讓路由器依工作節點回報的快取事件選擇去向。
如果可沿用前文的運算結果,就有機會減少重算;實際命中率仍取決於工作負載。
在大型語言模型推論中,KV 快取是用來暫存前文運算結果的高速記憶體區塊。因為 AI 代理在執行任務時,每一輪對話都會不斷疊加之前的對話歷史與工具說明。
如果下一輪請求被送到一張沒有這段前文快取的 GPU 上,系統就得從頭重算整段前綴,白白浪費算力與等待時間。
同時,Dynamo 還支援預填充與解碼分離的架構,也就是把負責消化長篇輸入提示詞的預填充節點池,和負責逐字產生回答的解碼節點池拆開獨立擴縮。
一旦發生快取未命中,預填充節點池就必須重新處理提示詞,因此路由品質成為影響吞吐量的因素之一。
為什麼單靠預測式路由會在記憶體吃緊時失準?
有些推論系統會採取預測式路由,也就是路由器只根據「我上次把哪個請求送給哪張卡」,自己猜測那張卡現在應該還留著哪些快取資料。這種做法雖然簡單,但在高負載叢集環境下卻很容易失準。
因為當 GPU 記憶體空間不足時,底層推論引擎會自動把較舊的快取區塊驅逐出去,而只靠歷史紀錄猜測的路由器無法只憑先前的派送紀錄得知這些驅逐動作。
久而久之,路由器腦中的快取地圖就會和 GPU 實際持有的資料產生嚴重漂移,導致大量請求被送錯叢集節點。
ZMQ 本地事件發布如何維持即時快取狀態?
為了消除這種狀態漂移,AICR 部署的 Dynamo 1.4.2 預設將「請求平面」與「快取事件平面」拆成兩條獨立通道。
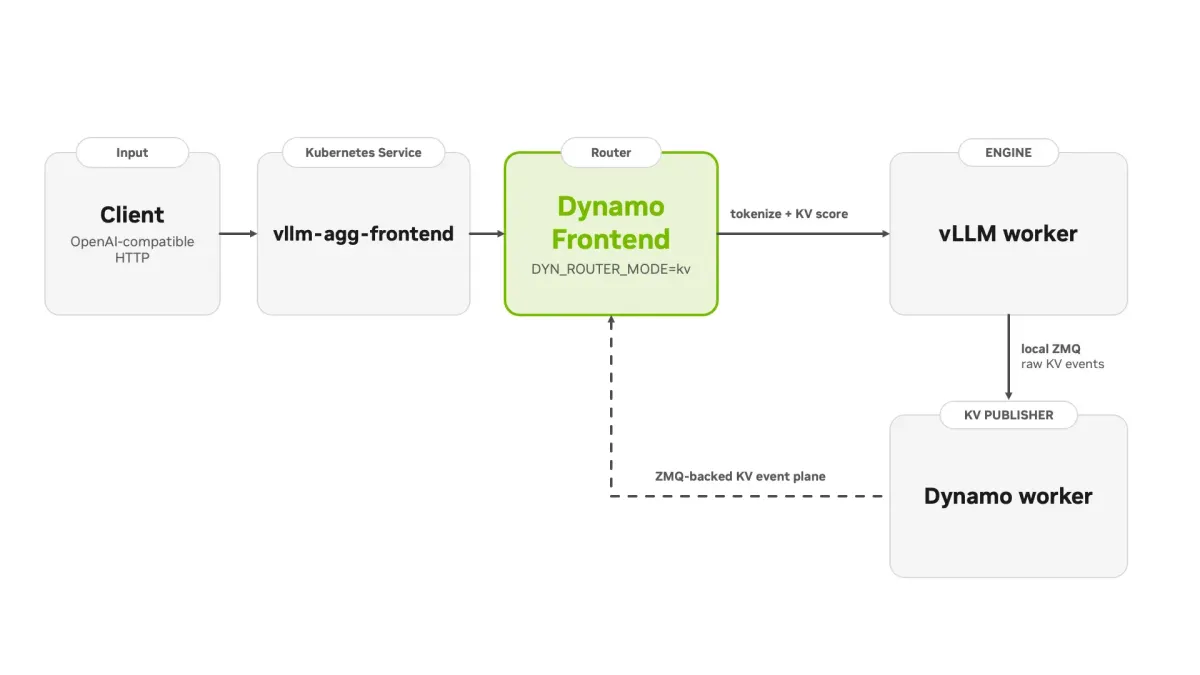
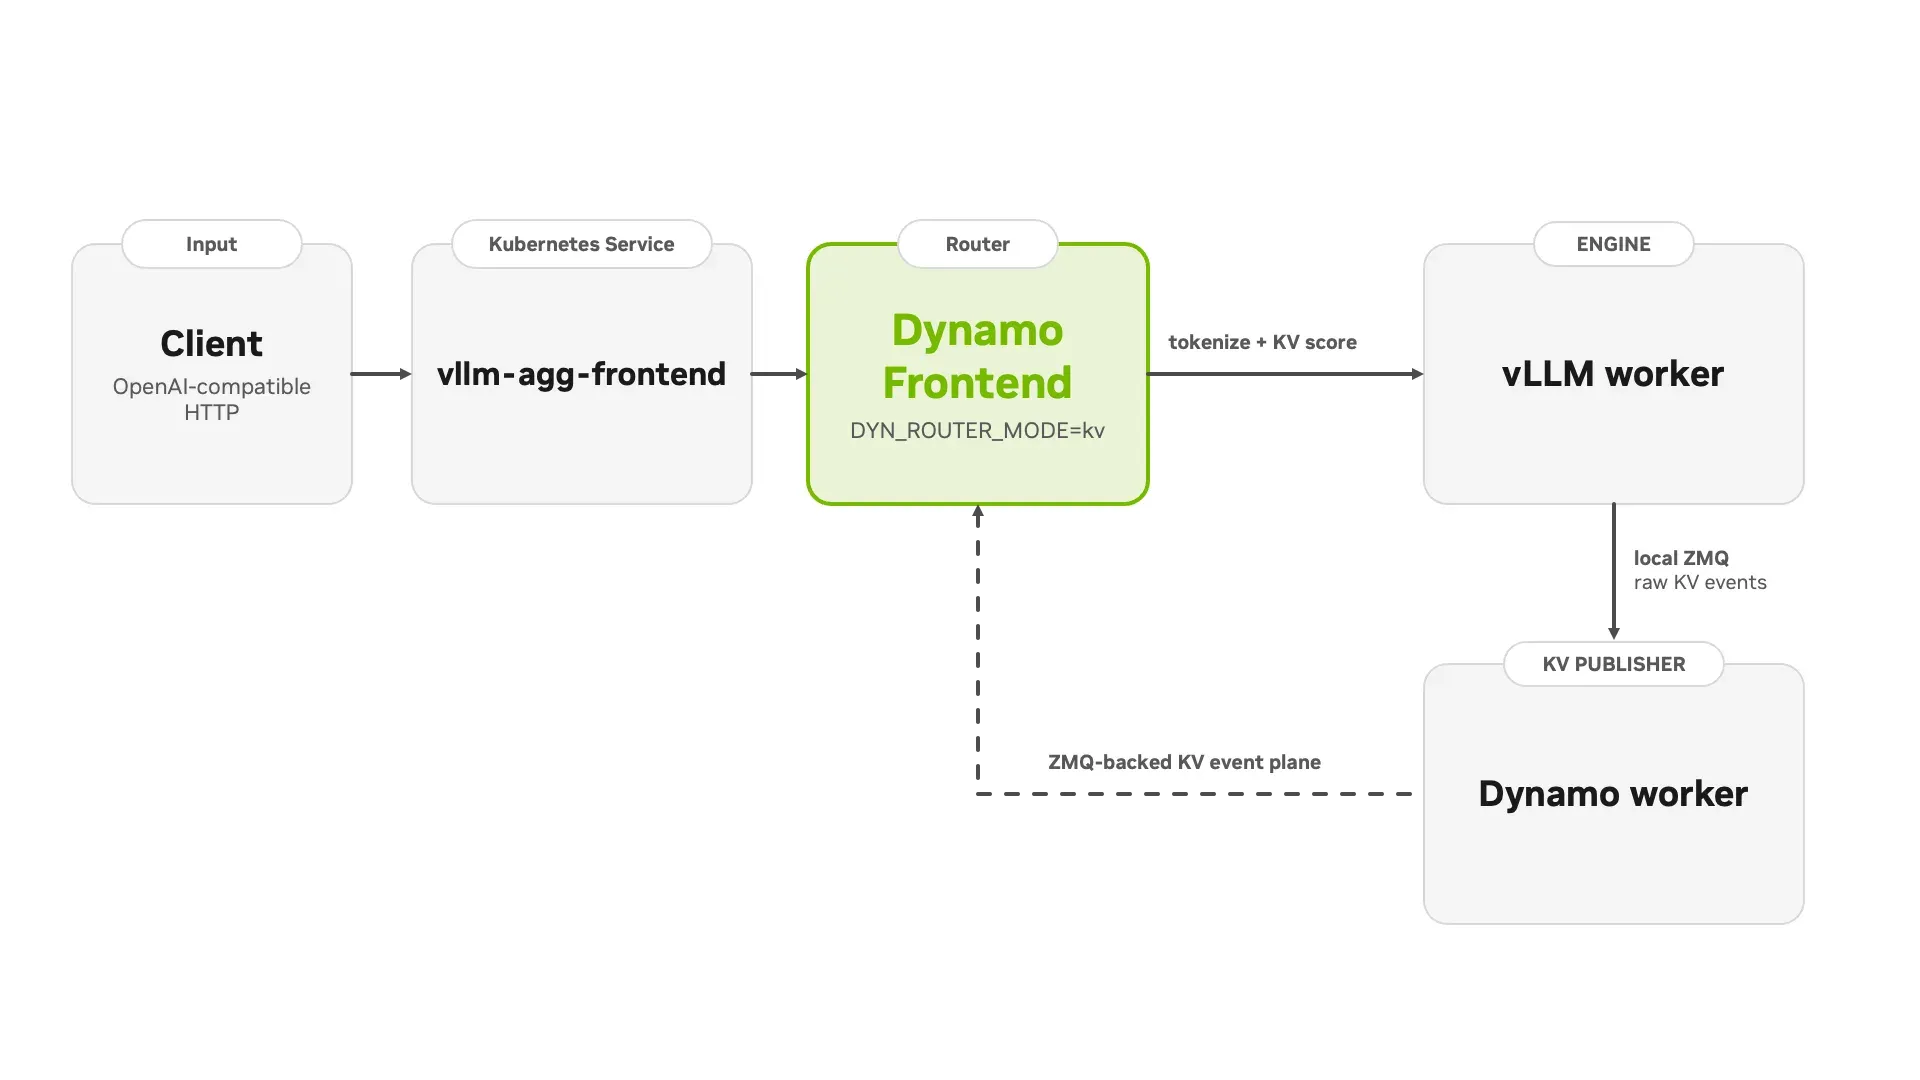
模型推論的文字請求預設走穩定的 TCP 通道,而快取變動則改由輕量級訊息佇列 ZMQ 即時回報。
具體來說,每個 vLLM 推論工作節點在啟動時,都會開啟前綴快取並掛上本地的 ZMQ 發布器,例如綁定在 tcp://*:5557 連接埠。
只要該節點新增或清除了任何快取區塊,就會立刻透過本地 ZMQ 發出原始事件。
接著,運行在同一個節點上的 Dynamo 工作執行期會訂閱這個本地事件源,將格式標準化後重新發布到整個 Dynamo 事件平面上。
因此前端路由器在做決定時,看的是各叢集節點即時回報的快取狀態,而不是只根據先前派送紀錄預測。事件回報仍是分散式系統的一部分,不能據此推定所有請求都一定命中快取。
有了即時回報的快取狀態後,平台團隊還必須在兩種不同的 Kubernetes 網路入口架構之間,選出最適合自己團隊分工的路由路徑。
Dynamo Frontend 與 Gateway API 兩條路由路徑該怎麼選?
AICR 為 Kubernetes 叢集上的 Dynamo 推論提供並驗證了兩條路由路徑,分別是預設的 Frontend 路由器與標準網路介面 Gateway API。
這兩者的差別在於由誰負責把網路請求呼叫轉發給後端的推論工作節點,團隊可以根據自己是否需要共用叢集網路入口來做選擇。
第一條路徑是預設的「Dynamo Frontend 路由器」。
在這種模式下,系統會把 Dynamo Frontend 直接放在一個標準的 Kubernetes Service 後面,並將路由模式設為 DYN_ROUTER_MODE=kv。
當客戶端發送相容於 OpenAI 介面格式的請求進來時,Dynamo Frontend 會先將文字切詞,接著根據前綴快取重疊率與各節點目前的負載進行評分。
選出最適合的工作節點後,就由 Frontend 自己透過 TCP 請求平面把任務派發過去,適合單一模型端點或最精簡的部署拓撲。
第二條路徑則是整合 Kubernetes Gateway API 推論擴充套件 GAIE 與 Dynamo 端點挑選外掛 EPP。
在 AICR 的範例中,請求呼叫會先進入 agentgateway 這類共用閘道器,並透過路由介面對應到由 Dynamo 運算子自動建立的推論節點池。
這時閘道器會先呼叫 Dynamo EPP 外掛,由外掛計算快取重疊率並挑出最佳節點,再把挑選結果與路由中繼資料回傳給閘道器。
接著由閘道器親自把 HTTP 請求轉發到目標節點內的 Frontend 邊車容器。
該邊車容器會以 --router-mode direct 直接模式運作,依已選定的路徑接收請求,避免再做一次節點挑選。
為了方便架構師快速對照,以下我把這兩條官方驗證路徑的核心差異整理成比較表:
| 比較項目 | 路徑一:Dynamo Frontend 路由器 | 路徑二:Gateway API|GAIE 搭配 Dynamo EPP |
|---|---|---|
| 網路入口擁有者 | Dynamo Frontend Service 獨立負責 | 共用的 Gateway 與 HTTPRoute 資源統一管理 |
| 節點挑選與轉發分工 | Frontend 同時負責挑選節點與派發請求 | EPP 只負責挑選節點,實際網路轉發交給 Gateway |
| 請求傳遞路徑 | 客戶端 → Frontend → 推論工作節點 | 客戶端 → Gateway → 節點內 Frontend 邊車 → 推論工作節點 |
| 需要額外安裝的元件 | 僅需 Frontend 與推論工作節點 | 需額外配置相容於 GAIE 的閘道器、InferencePool、EPP 與邊車 |
| 最適合的團隊情境 | 應用團隊獨立擁有單一模型端點,追求最精簡架構 | 平台團隊集中管理多模型共用入口、逾時、重試與降級規則 |
從表格可以看出,兩條路徑底層用的都是同一套即時快取評分邏輯,差別主要在網路入口由哪一層管理。
如果平台團隊希望用標準的 Gateway API 介面統一控管所有模型的逾時與重試策略,就選第二條路。
另外官方也在文中預告了一項效能升級路線。在目前的 Dynamo 1.4 版中,第二條路徑是透過 Go 語言框架搭配 CGO 橋接器,來嵌入 Rust 寫成的快取路由器。
而從下一代 Dynamo 1.5 起,官方將直接改用原生 Rust 編寫的 EPP 實作輕量級介面。
官方預期此改動能減少跨語言橋接的每次請求開銷。這是文中的後續路線,不能當成目前1.4配方已具備的結果。
選好符合團隊架構的路由路徑後,工程師就能透過 AICR 的五個標準步驟,把這些複雜元件一步步部署到叢集並完成自動化驗收。
AICR 的五步驟配方與驗證流程怎麼跑?有哪些使用限制?
AICR 將執行環境的建立拆成快照、產生配方、渲染打包、部署與驗證五個步驟,核心原則是先檢查配方描述的環境條件,再安裝上層模型應用。
這提供區分環境與應用問題的檢查順序,公告沒有量化所有團隊能節省多少排錯時間。
步驟一與步驟二:擷取叢集快照並產生對應配方
流程的第一步是執行 aicr snapshot 指令。
系統會在叢集內啟動一個驗證工作,自動鎖定標記為擁有 GPU 的節點,把目前的硬體型號、作業系統核心與已安裝元件拍成一份 snapshot.yaml 快照檔。
第二步則是執行 aicr recipe 指令,傳入剛才的快照檔,並指定工作意圖為推論、目標平台為 Dynamo。
配方引擎會根據快照裡的雲端環境與加速卡型號,自動組合出一份鎖定所有元件版本的 recipe.yaml 配方檔。
如果團隊想在還沒連上正式叢集前先測試配方能不能套用在另一套環境,也可以使用 aicr validate --no-cluster 執行離線檢查。
不過離線模式只能核對宣告式的版本與設定約束,需要實際跑容器的行為檢查則會標示為略過。
步驟三與步驟四:渲染多格式部署包並執行安裝
第三步是透過 aicr bundle 將抽象配方渲染成可以直接部署的設定檔目錄。
除了教學範例使用的 Helmfile 與預設的 Helm 腳本外,NVIDIA/aicr 官方開源儲存庫 也支援將同一份配方輸出為 Argo CD、Flux、Terraform 或 Rancher Fleet 等多種持續交付格式。
第四步則是實際把這包執行環境安裝進叢集。
以 Helmfile 為例,工程師可以先跑 helmfile diff 檢視變更,再跑 helmfile apply 依序安裝各層元件,系統會自動照依賴順序把底層驅動到上層監控逐層建好。
步驟五:三階段自動化驗收與工具邊界限制
環境裝好後,第五步也是最關鍵的一步,就是執行 aicr validate 對活體叢集進行實測驗收。
AICR 的驗證分為部署、相容性與效能三個階段,前兩個階段會檢查 GPU 可分配容量、nvidia-smi 狀態、DRA 權限、群組排程、Prometheus 指標與閘道器就緒度。
在官方案例中,部署與相容性檢查通過後,才會安裝 DynamoGraphDeployment 模型應用。
至於效能驗證階段因為會實際部署一個暫時性的推論工作負載並佔用測試中的實體 GPU,官方建議另外排程獨立執行。
除了命令列工具 aicr 之外,該專案還提供了可跑在叢集內部的 REST 介面伺服器 aicrd、方便直接嵌入程式的 Go 語言開發套件,以及用來比對兩個叢集設定漂移的 aicr diff。
若要核對供應鏈安全,也能透過符合 SLSA Build Level 3 規範的 aicr verify 執行 Cosign 離線簽章驗證。
在評估導入前,團隊也必須認清官方明確列出的五項邊界限制。
AICR 的定位很單純,它並未包辦新的 Kubernetes 發行版、硬體佈建工具、雲端代管控制平面、底層雲端平台取代方案或通用設定管理系統。
因此,它非常適合已經擁有 EKS、GKE、AKS 或自建 GPU 叢集、需要穩定運行多節點推論的平台工程團隊。
相反地,若團隊還沒建好底層叢集、期待一鍵連雲端虛擬機都自動開好,就必須先用雲端供應商或硬體佈建工具把基礎環境架起來。
透過這套先驗收底層再部署應用的標準流程,平台團隊就能把原本難以重現的叢集調校經驗,轉化為每次擴建都能自動核對的工程規範。
NVIDIA AI Cluster Runtime 常見問題
NVIDIA AI Cluster Runtime 是一套新的 Kubernetes 發行版嗎?
不是。
官方在文件開頭就明確定義,NVIDIA AI Cluster Runtime 是一套叢集執行環境設定產生器與驗證器,使用者必須自己準備好 GPU Kubernetes 叢集與部署工具,再由它產出經過驗證的元件設定與檢查報告。
Dynamo 1.4.2 在 Kubernetes 上還需要強制安裝 NATS 嗎?
預設不需要。
因為從 Dynamo 1.4 開始,各個服務元件已經可以直接透過 Kubernetes 原生資源互相探索,所以 AICR 提供的 dynamo-platform 1.4.2 預設不再安裝 NATS,只保留為選用設定。
為什麼 AICR 的效能驗證階段要跟部署驗證分開跑?
因為部署與相容性驗證只檢查驅動、排程器與網路資源是否就緒,而效能驗證階段會在叢集裡實際啟動一個暫時性的推論服務來測試吞吐與延遲,過程中會直接佔用實體 GPU 算力,所以必須分開排程。
除了 Amazon EKS 之外,AICR 還支援哪些環境與加速卡?
官方儲存庫列出多種平台與加速卡的選項,但每種平台、硬體與工作負載仍須對照實際配方。這篇官方指南示範的是指定環境的 Dynamo 推論,不應據此保證任意雲端與硬體組合都已驗證。
先確認叢集條件,再量測自己的模型服務
對已有GPU叢集的平台團隊,AICR能把環境設定和驗證結果留下來,供後續擴建比對。但尚未備妥叢集的團隊,仍需先完成硬體與雲端環境,才能使用這份配方。
想持續追蹤 AI 開發工具、代理架構與工程實務限制,歡迎免費訂閱 AI 郵報。
延伸閱讀
延伸閱讀:SageMaker AI 開放 GPU 分割推論:一張顯卡放多個模型,七個分區不等於七倍省錢
延伸閱讀:NVIDIA gds-diag 開源診斷工具:讓 Claude Code、Codex 找出 GPU 儲存傳輸卡在哪裡