輝達 SC26 發表 Rubin HPC GPU 與 Nemotron for Science!單卡破 5 萬核心攜手國實驗室打造科學 AI 代理
輝達在 SC26 超算大會發表專攻科學運算的 Rubin HPC GPU(單卡逾 5 萬 CUDA 核心、2028 年上市),並開源 Nemotron for Science 模型與化學基準資料集。

很多人聽到輝達推出新一代超算晶片,第一反應通常都是「那是不是又用來訓練更大的聊天機器人?」
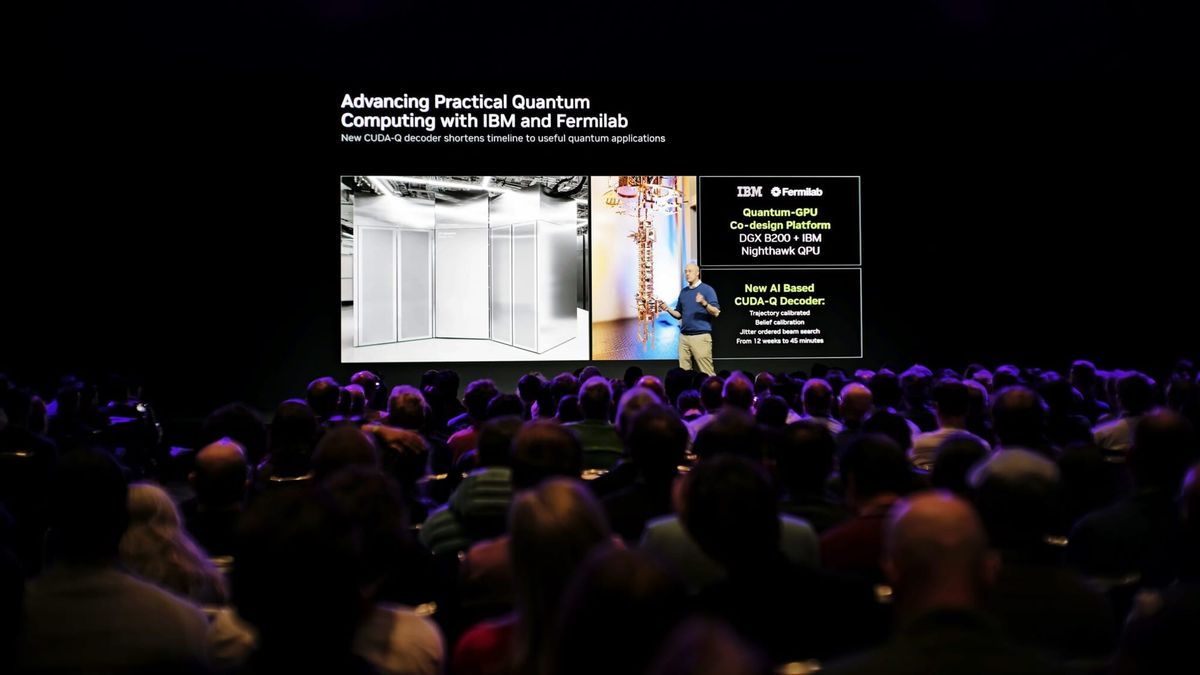
但在 2026 年 11 月 17 日於芝加哥登場的 SC26 全球超級電腦大會上,輝達執行副總裁 Ian Buck 端出的新藍圖,瞄準的卻不是寫文章或畫圖的通用模型,而是人類最硬核的基礎科學研究。
從模擬黑洞影像、預測新材料結構,到推動下一代化學與生物分子推理,輝達在會上一口氣端出了硬體與軟體雙引擎:預定於 2028 年登場的 Rubin HPC GPU,以及完全開源的「Nemotron for Science」科學模型套件。
這顆單卡就塞進超過 5 萬個 CUDA 核心的科學專用旗艦處理器,加上即將在 2027 年初先行亮相的 192 顆處理器 Vera 機櫃系統,正式宣告高效能運算(HPC)與 AI 代理正在徹底合流。
對台灣半導體供應鏈、學研機構與研發工程師而言,這場發表不只預告了未來兩到三年超算架構的演進方向,更展示了科學研究如何從「人工寫程式跑模擬」全面轉向「AI 科學代理自主設計實驗」。
接下來我們會帶你看懂 Rubin HPC GPU 為什麼把核心數推破五萬大關、Nemotron for Science 開源套件裡裝了什麼寶藏、CUDA-X 科學函式庫如何把黑洞運算從一個多月壓縮到八分鐘,以及量子與傳統超算如何走向混合排程。
Rubin HPC GPU 登場:單卡破 5 萬 CUDA 核心的科學算力怪獸
要理解為什麼輝達要在原本的 Vera Rubin 平台之外,特別為高效能運算打造一款 Rubin HPC GPU,得先看懂科學模擬跟一般 AI 訓練在算力需求上的根本差異。
平常我們訓練語言模型或圖像生成模型時,系統追求的是極致吞吐量,常常可以用較低的數值精度來換取驚人的運算速度,反正多幾個小數點誤差不會影響對話流暢度。
但科學研究完全是另一回事。無論是航空流體力學模擬、核融合反應推演、氣候變遷預測還是新藥分子動力學計算,只要算錯一個微小的浮點數誤差,整個實驗模擬結果就可能全面失真。
因此,這顆被納入 Vera Rubin 平台版圖、預計於 2028 年正式上市的 Rubin HPC GPU,正是專為這種「高精度科學計算與 AI 混合負載」量身打造的專用處理器。
超過 5 萬核心、第七代 NVLink 與稀疏加速代表什麼
根據 Ian Buck 在 SC26 大會上的揭露,Rubin HPC GPU 在單一晶片封裝內塞進了創紀錄的超過 50,000 個 CUDA 運算核心,並搭配第七代 NVLink 高速互連技術與專屬的稀疏資料加速架構。
用白話文來說,CUDA 核心數量突破五萬大關,就像是在同一座工廠裡同時開出五萬條精密組裝線,能讓龐大的三維物理網格或分子矩陣同步運算。
而第七代 NVLink 則像是把這座工廠跟旁邊幾百座工廠之間的高速公路徹底拓寬,讓多顆 GPU 在分工計算同一個超級大題目時,資料交換不再卡在傳輸瓶頸上。
至於稀疏資料加速,則是針對科學模擬中常見的「大量矩陣元素其實都是零」的特性做硬體級跳過優化,讓晶片不用把寶貴電力浪費在無意義的零值乘法上,實質大幅推升科學模擬的每瓦效能表現。
2027 年初先上陣的 192 顆 Vera CPU 機櫃
在等待 2028 年 Rubin HPC GPU 登場的過渡期,輝達也為超算中心準備了先發部隊:預計在 2027 年初率先部署的 Vera 機櫃級系統。
這套機櫃將直接整合高達 192 顆客製化 Vera 中央處理器,專門承接傳統超算中心最龐大的結構化模擬、資料前處理與系統調度工作,確保超算機構在進入下一代 GPU 世代前,就能先用高能效的機櫃架構替換掉老舊耗電的傳統伺服器。
延伸閱讀:輝達擴展 Vera CPU 機櫃級平台!192 顆客製處理器進駐德國氣候超算,能效翻倍挑戰 x86
Nemotron for Science 開源套件:把頂尖實驗室的科學大腦搬上 Hugging Face
如果說 Rubin HPC 是未來的肌肉,那麼輝達在 SC26 同步發表的「Nemotron for Science」,就是讓這具超級身體真正懂得做科學研究的大腦。
過去很多開源大型語言模型雖然很會寫日常文章或基礎程式,但一遇到高深化學反應路徑、生物蛋白質結構推論或物理實驗數據判讀,往往會開始一本正經地胡說八道。
為了填補這個落差,輝達這次把整套「Nemotron for Science」以開源套件形式放到 Hugging Face 平台上,裡面包含三大核心組件:具備視覺與長文推理能力的 Nemotron 3.5 Super VL 模型、收錄近 50,000 道高難度化學推理題目的 LitmusBench v0.2 基準資料集,以及完整的後訓練(Post-training)實作配方。
為什麼 128GB 的 DGX Spark 就能跑得動
最讓中小型實驗室與大學研究團隊眼睛一亮的,是這套科學模型並不只屬於擁有數千張頂級顯卡的國家級超算中心。
輝達特別強調,Nemotron for Science 的架構經過精心調校,研究者甚至只需要一台配備 128GB 統一記憶體的桌上型 DGX Spark 設備,就能在本機端順利執行與微調這套科學模型。
這意味著化學系教授、生技新創或台灣半導體製程研發工程師,不必每次想測試一個新材料假說就得寫計畫書去排國家超算中心機時,也不必把敏感的未公開實驗配方上傳到外部公有雲,直接在辦公室桌機上就能擁有一個專屬的科學研究助理。
阿貢國家實驗室與日本理化學研究所已經率先導入
這套工具並不是停留在簡報上的概念模型,現場已經有全球頂尖科研機構率先採用並展現成果。
美國阿貢國家實驗室(Argonne National Laboratory)正基於此架構推進 StructBioReasoner 專案,用來加速結構生物學的複雜推理與研究自動化;而日本頂尖科研重鎮理化學研究所(RIKEN)也將其納入 RIKYU 計畫中,探索 AI 代理如何直接參與前沿科學計算流程。
| 發表核心項目 | 推出時程與定位 | 關鍵技術規格與內容亮點 | 對科研與產業的實際意義 |
|---|---|---|---|
| Rubin HPC GPU | 2028 年上市,Vera Rubin 平台成員 | 單卡破 50,000 個 CUDA 核心、第 7 代 NVLink、稀疏資料加速 | 專攻高精度科學計算與 AI 代理混合負載 |
| 192 顆 Vera CPU 機櫃 | 2027 年初先行部署 | 單一機櫃整合 192 顆客製 Vera 處理器 | 提前承接高能效超算任務與傳統模擬轉型 |
| Nemotron for Science | 即日起於 Hugging Face 開源釋出 | Nemotron 3.5 Super VL、LitmusBench v0.2(近 5 萬道化學題)、後訓練配方 | 支援 128GB DGX Spark 本機運行,加速科學 AI 代理落地 |
| CUDA-X Science 與 Slurm 26.11 | 軟體生態與排程器持續更新 | cuPhoton、cuPotential 函式庫,Slurm 26.11 支援 GPU 與量子混合排程 | 黑洞運算從逾一個月縮短至 8 分鐘,打通古典與量子算力 |
延伸閱讀:Vera Rubin MLPerf Training 6.1 首秀:最高兩倍速度,為什麼要比相同 GPU 數?
CUDA-X 科學函式庫與 Slurm 26.11:讓黑洞運算從一個多月縮短到八分鐘
在硬體發表之外,熟悉超算領域的工程師都知道,輝達真正的護城河一直都是底層軟體生態系,這次 SC26 上公布的 CUDA-X Science 函式庫成績單就是最好的證明。
以天文物理界極具代表性的「事件視界望遠鏡(Event Horizon Telescope)」黑洞觀測計畫為例,科學家必須把全球各地電波望遠鏡收集到的海量訊號進行關聯運算(Correlation),才能拼出人類看到的黑洞影像。
過去這項極度繁重的訊號處理工作,往往需要耗費超過一個月的運算時間;但在導入輝達專為科學訊號加速打造的 cuPhoton 函式庫後,同樣規模的運算任務竟然被壓縮到短短 8 分鐘就完成。
除了光學與訊號領域的 cuPhoton,輝達也同步推進如 cuPotential 等專攻物理與材料勢能計算的函式庫,讓原本必須從頭手寫底層平行運算程式碼的科學家,能直接套用高度最佳化的加速元件。
Slurm 26.11 打通 GPU 與量子電腦的混合排程
另一個在超算圈極具指標性的軟體進展,則是廣泛用於全球超級電腦的開源工作排程器迎來了 Slurm 26.11 版本。
這個新版本首度把「GPU 與量子處理器(QPU)的混合排程」變成標準能力。
未來的科學運算不會是量子電腦取代 GPU,而是像交響樂團一樣分工合作:由量子處理器負責最擅長的分子能態或組合優化探索,再立刻把中間結果交給旁邊的 GPU 叢集做大量數據清洗與 AI 誤差修正。
Slurm 26.11 讓這兩種截然不同的算力資源能在同一套排程系統下自動排隊與切換,為「量子-古典協同超算」鋪平了實際運作的道路。
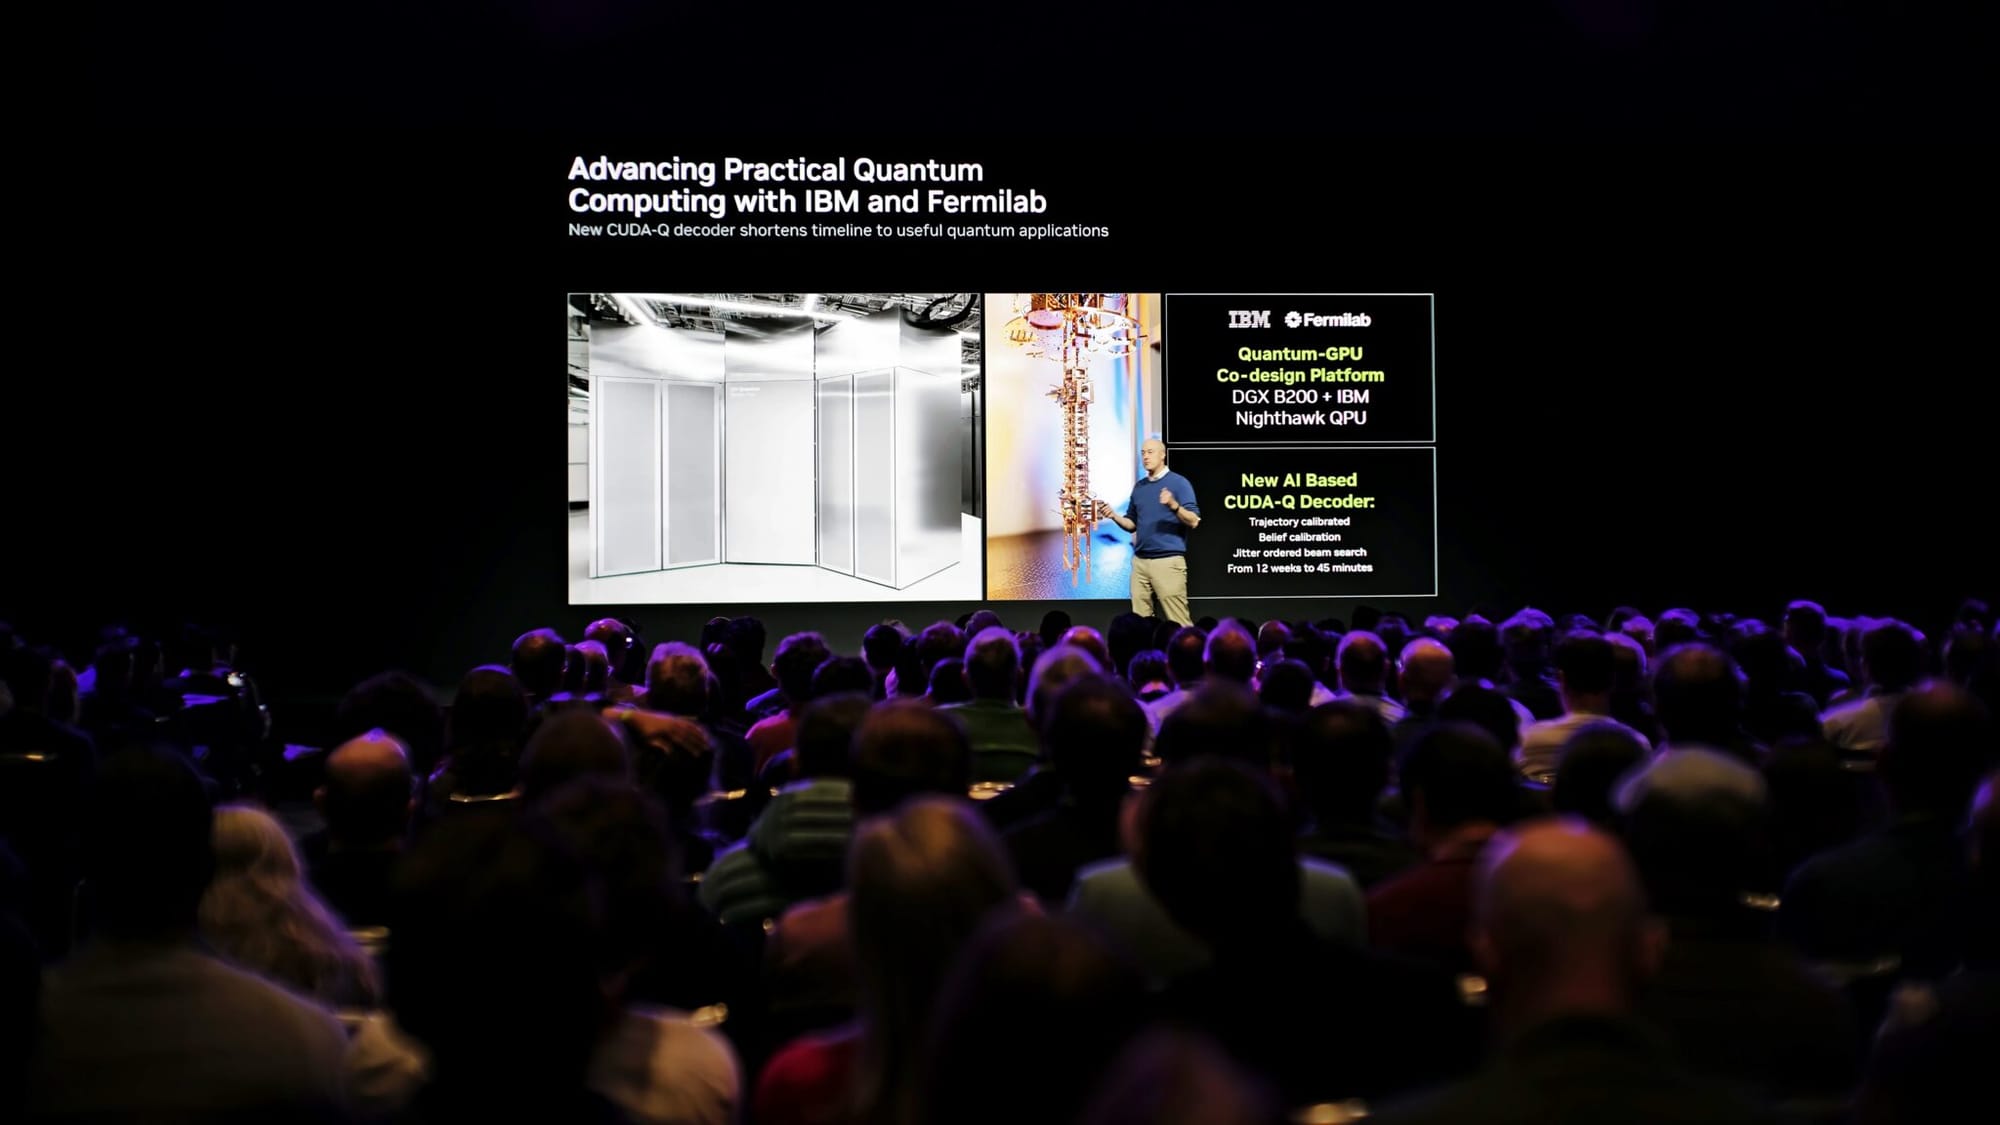
延伸閱讀:IBM 聯手輝達與費米實驗室打造量子-古典協同平台,同步攜手 AMD 開源 Pelagos 解碼器框架
對台灣半導體供應鏈與學研團隊的啟示
把 SC26 的整場發表串起來看,對台灣產業界與學術界有兩個非常清楚的訊號。
第一是硬體供應鏈的高階規格持續拉升。從 2027 年初的 192 顆 Vera CPU 機櫃,到 2028 年單卡超過五萬核心與第七代 NVLink 的 Rubin HPC GPU,代表未來資料中心對先進製程、CoWoS 先進封裝、高層數載板以及液冷散熱方案的技術門檻只會越來越高,台灣在先進製造與伺服器整機組裝上的核心地位也將隨之延續。
第二則是本土研發機構與企業該如何善用「開源科學模型」。台灣在半導體材料、化工配方、生技醫療與氣象防災領域都累積了極深厚的實驗數據,過去卻苦於缺乏專屬的領域推理模型。
隨著 Nemotron for Science 把基礎模型、近五萬題化學基準與完整後訓練配方開源,加上桌上型 128GB 設備就能就地執行,台灣的研發團隊完全有機會用自己累積的領域數據微調出專屬的「材料或製程 AI 代理」,把過去仰賴資深工程師經驗的試錯過程大幅縮短。
台灣大學實驗室與產業研發中心導入的實作路徑
對台灣的理工科系實驗室與材料化學企業而言,要真正把這波科學 AI 工具落地,並不需要等到 2028 年 Rubin HPC 問世才開始動作。
研發團隊現在就可以先從 Hugging Face 下載 LitmusBench v0.2 化學推理基準資料集,用它來測試目前手邊既有的模型在分子結構判讀、反應路徑預測與實驗條件推論上的準確率底線。
接著,團隊可以利用官方釋出的後訓練配方,把自家實驗室過去累積的論文筆記、專利摘要與失敗實驗紀錄整理成高品質微調語料,在單台 128GB 桌上型設備上進行領域適應訓練。
這種「先用開源基準找落差、再用私有實驗數據補專業」的漸進式作法,能讓研究人員在不外洩核心機密配方的前提下,逐步建立起真正懂自家領域的科學研究助手。
更重要的是,這套桌上型開發流程能與國家級超算中心無縫銜接:平時在個人工作站完成模型微調與小規模測試,等到需要進行大規模分子模擬或長週期氣候推演時,再把成熟的代理流程送進大型叢集加速,讓每一分算力預算都花在刀口上。
常見問題(FAQ)
Rubin HPC GPU 跟一般的 Rubin AI 晶片有什麼差別?
Rubin HPC GPU 是 Vera Rubin 平台中專為高效能科學運算設計的成員,預計於 2028 年推出。它單卡擁有超過 5 萬個 CUDA 核心、支援第 7 代 NVLink 與稀疏資料加速,特別強化科學模擬所需的高精度計算與 AI 混合工作負載能力。
Nemotron for Science 包含哪些內容?一般團隊拿得到嗎?
拿得到。輝達已經把 Nemotron for Science 完整開源在 Hugging Face 上,內容包含 Nemotron 3.5 Super VL 模型、收錄近 5 萬道化學推理題的 LitmusBench v0.2 基準資料集,以及完整的後訓練教學配方,研究團隊可以免費下載並依需求微調。
執行 Nemotron for Science 一定要買大型超算機櫃嗎?
不需要。根據輝達在 SC26 的說明,這套科學模型套件可以直接運行在配備 128GB 統一記憶體的 DGX Spark 桌上型設備上,大幅降低了大學實驗室與企業研發部門導入科學 AI 代理的硬體門檻。
Slurm 26.11 支援混合排程有什麼實際用途?
Slurm 是全球超算中心最主流的工作排程系統。26.11 版本支援 GPU 與量子電腦的混合排程後,科學家就能在同一個計算任務中自動協調古典超算與量子處理器,讓兩者分工解決複雜的化學、物理與優化難題。
結語
輝達在 SC26 大會上發表的 Rubin HPC GPU 與 Nemotron for Science,清楚勾勒出科學研究的下一個黃金十年:硬體端靠著破五萬核心的專用架構與量子混合排程打破物理模擬天花板,軟體端則透過開源科學模型與領域基準資料集,讓 AI 真正成為能讀懂實驗數據、協助設計新分子與新材料的數位科學家。
特別值得台灣學研界與研發型企業關注的是,這次輝達沒有把科學 AI 鎖在少數國家級超算中心裡,而是透過 Hugging Face 開源與 128GB 桌面級設備相容性,把工具直接交到每位研究者手中。
如果你也想持續追蹤輝達 Vera Rubin 世代硬體演進、開源科學模型實戰與量子超算整合動態,歡迎免費訂閱 AI 郵報,或點擊下方延伸閱讀深入掌握輝達最新的晶片與生態系布局。