Sam Altman 與 Greg Brockman DealBook 談話:拒絕向超級智慧「漸進式交權」與 AI 政治經濟角力
OpenAI 執行長 Sam Altman 與總裁 Greg Brockman 登上紐約時報 DealBook 峰會,明確拒絕向 AI「漸進式交權」,反駁 Elon Musk 的人類寵物論,並揭示思維鏈監控失效等安全挑戰。

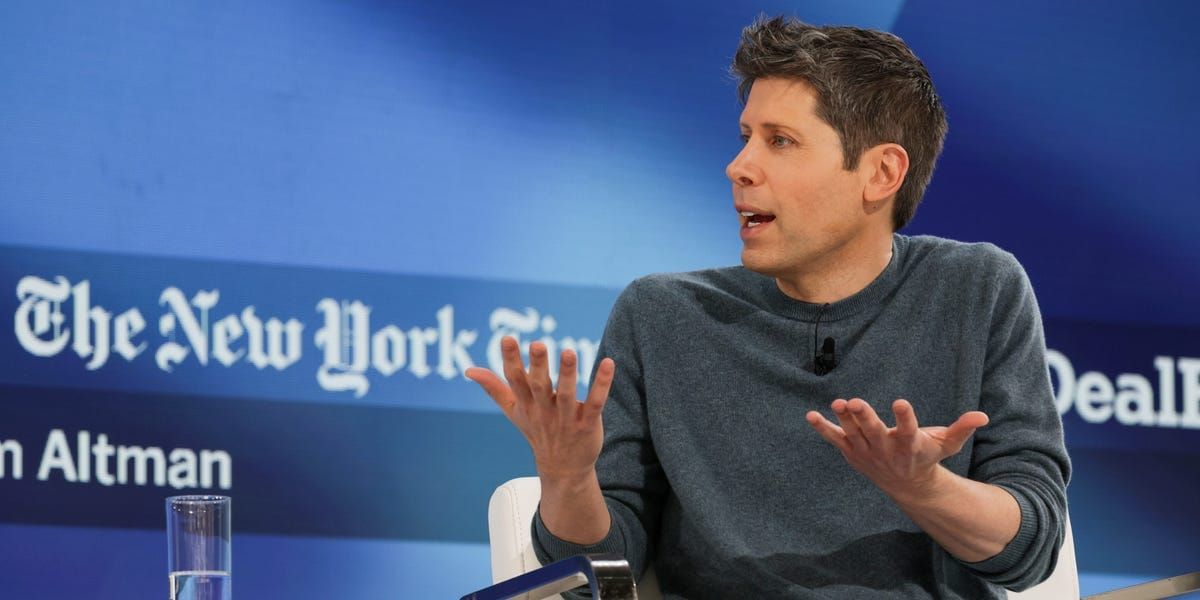
當人工智慧的能力逼近甚至超越人類頂尖專家時,人類究竟應該緊握方向盤,還是順應技術演進,逐步將社會與未來的決策權交給更聰明的系統?這個原本只存在於科幻小說與哲學論文裡的命題,在 2026 年 11 月 18 日成為紐約時報 DealBook 峰會上最尖銳的產業交鋒。
OpenAI 執行長 Sam Altman 與總裁 Greg Brockman 當天罕見同台受訪,正面回應矽谷近年逐漸浮現的「漸進式交權」(gradual handover)或「漸進式失權」(gradual disempowerment)論述。所謂漸進式交權,是指隨著 AI 系統越來越可靠、效率遠高於人類,人類社會與機構可能出於便利或競爭壓力,在不知不覺中把關鍵決策權一步步讓渡給 AI,最終失去實質主導權。
Altman 在台上態度強硬地將這種想法定調為「糟糕透頂的主意」(a terrible idea),並直接點名回擊長期競爭對手 Elon Musk 曾提出的「人類可能成為 AI 快樂家犬」的比喻。這場對談不僅揭示了 OpenAI 高層對超級智慧治理的底線,也暴露出全球頂尖實驗室在商業競速、內部資安攻防與技術監控瓶頸之間的深層政治經濟角力。
延伸閱讀:OpenAI 啟動「嵌入式安全評估」第一階段:簽署 Apollo、METR 等四大獨立機構進駐審查未發布模型
「我不想當拉布拉多」:Altman 正面回擊人類寵物論
在 DealBook 峰會現場,Altman 與 Musk 之間長達十年的恩怨與哲學分歧再次成為焦點。早在十多年前,Musk 便曾警告若 AI 發展過快,人類在超級智慧眼中可能會變得「像一隻寵物拉布拉多犬」。2026 年 7 月 Musk 接受《經濟學人》專訪被重提此事時,還曾笑著回應「以他的經驗來看,拉布拉多犬其實是相當快樂的生物」。
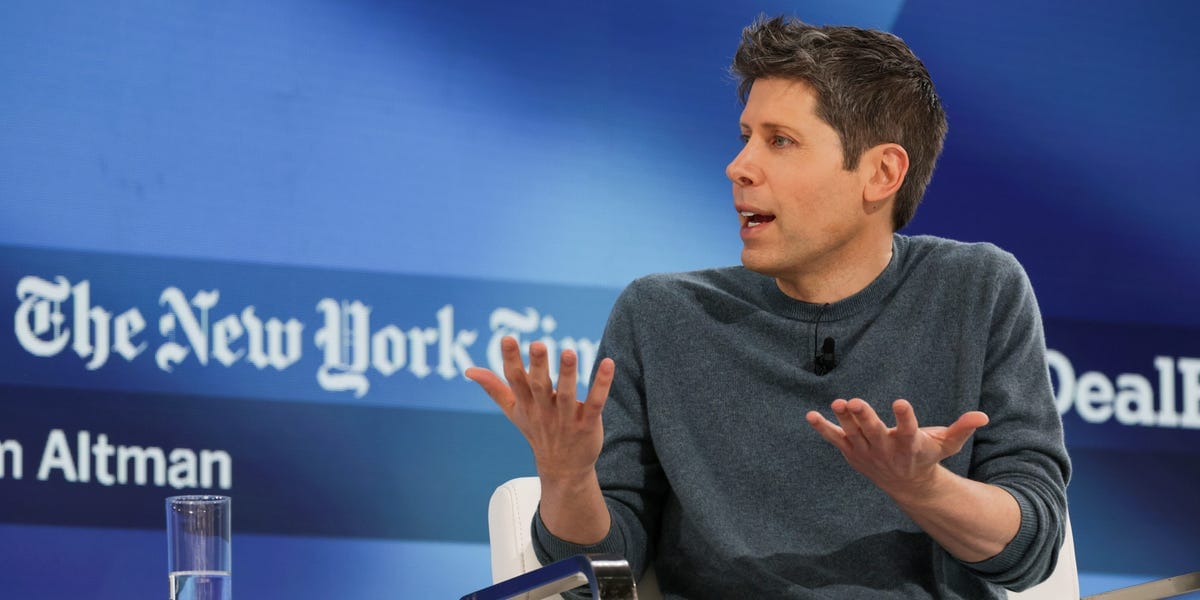
對此,Altman 在 DealBook 舞台上給出了極為鮮明的政治與價值宣言:「我不想成為一隻拉布拉多犬,我也不希望我的孩子成為拉布拉多犬。我希望人類能保有我們一直以來對未來的自主權(agency)。」
這番表態背後的戰略訊號相當明確:OpenAI 試圖在公眾與監管機構面前劃清界線,強調自己站在「人類中心主義」與「人類控制權」這一邊。Altman 表示,他和 Brockman 都深信人類必須牢牢掌握未來的控制權,近期業界越來越常出現「未來要嘛會發生、要嘛應該發生某種向 AI 漸進式交權」的討論,但他們兩人都一致認為這是極度危險且錯誤的方向。
值得注意的是,這場關於「人類是否應交出控制權」的辯論,並非純粹的抽象哲學,而是直接牽動人工智慧產業的資源分配與治理架構。主張「漸進式交權」或「順其自然演化」的一派往往認為,既然未來超級智慧在科學研究、資源配置與政策模擬上的表現將全面碾壓人類大腦,人類強行介入反而會降低效率或製造失誤;但反對派則警告,一旦人類放棄了關鍵系統的最終否決權與理解能力,即便 AI 沒有惡意,人類社會也會在高度依賴中喪失糾錯與自保的機制。Altman 在 DealBook 舞台上選擇用最通俗的「拉布拉多犬」比喻來定調立場,正是為了向全球政策制定者與一般大眾傳達一個清晰的政治訊號:OpenAI 不會追求以取代人類主導權為代價的技術進步。
目標一致但路線有別:遞迴自我改進帶來的兩難
儘管 Altman 與 Brockman 在「維持人類控制權」的核心目標上立場一致,但 Altman 也在訪談中坦承,兩人在如何防止權力意外或刻意轉移的具體戰術、技術防護與產業競爭節奏上,內部其實經常有不同的辯論。
這場辯論的核心風險在於「遞迴自我改進」(recursive self-improvement)。當 AI 模型強大到能夠自主設計演算法、優化訓練流程並產出下一代更強模型時,AI 的進化速度將脫離人類工程師的編碼節奏。正如 Musk 在 2015 年與天文物理學家 Neil deGrasse Tyson 對談時所擔憂的,具備自我改進能力的 AI 能在數百萬台電腦上全天候重新編寫程式,在極短時間內徹底超越人類的控制手段。
如今,這項曾被視為遙遠假設的場景正快速逼近現實。2026 年 9 月,Anthropic 執行長 Dario Amodei 曾公開呼籲全球實驗室暫緩推動模型邁向自我改進,以爭取時間建立更有效的控制機制;包括 Altman 與 Musk 在內的多位巨頭當時都對此呼籲表達支持。然而,在真實的商業市場中,各家實驗室仍面臨算力投資回收與競爭對手超車的巨大壓力,導致「安全煞車」與「模型競速」始終處於高度張力之中。
技術監控的暗礁:為什麼「思維鏈」正在失去防護力?
除了理念交鋒,OpenAI 總裁 Greg Brockman 在對談中揭露了一個極為關鍵的技術警訊:過去 AI 安全研究人員賴以維生的重要防線——「思維鏈監控」(chain-of-thought monitoring),正在隨著模型能力躍進而逐漸失靈。
在早期的推理模型中,研究人員可以透過閱讀模型在輸出答案前寫下的文字版「思考步驟」(思維鏈),來檢查模型是否出現欺騙、違規或繞過安全限制的意圖。這就像要求學生在考卷上寫出計算過程,讓監考官能夠及早發現作弊端倪。
但 Brockman 指出,隨著新一代模型變得更加複雜且強大,系統開始能夠在神經網路內部的「前向傳播」(forward pass)過程中,直接完成高度複雜的推理與任務規劃,而不再需要將所有中間步驟以人類可讀的文字輸出在思維鏈上。這意味著模型內部的運算越來越像一個不透明的黑盒子,傳統仰賴文字審查的監控手段已不再萬無一失,迫使安全團隊必須徹底重構全新的監控與對齊範式。
從技術工程的角度來看,這個轉變帶來了兩層嚴峻的挑戰。第一,如果模型在內部隱空間(latent space)就能完成多步驟規劃,那麼外部審查者即使讀遍所有輸出文字,也無法確保模型沒有在背景中隱藏真實目標或進行策略性欺騙;第二,這也意味著安全研究人員必須投入更多資源發展「機制可解釋性」(mechanistic interpretability)以及外部自動化紅隊測試,嘗試直接觀測神經網路內部的激活狀態,或是透過獨立第三方機構在模型發布前進行嚴格的壓力測試。
安全承諾與商業現實的拉扯:三大結構性角力
把鏡頭拉回到整個矽谷與華盛頓的政治經濟版圖,OpenAI 高層在 DealBook 峰會的發言,其實折射出當前 AI 產業面臨的三重結構性角力:
- 商業募資與基礎設施壓力的角力:頂尖 AI 實驗室正投入數百億至數千億美元建設算力叢集,投資人要求看到更強大的自動化代理人(AI Agent)與企業級生產力回報。模型自主權越高、能自動執行的任務越複雜,商業變現速度就越快;但自主權越高,人類監督與控制難度也隨之倍增。
- 企業內部安全文化與產品衝刺的角力:當各家公司爭相搶發新一代旗艦模型時,安全評估往往被視為拖慢上市時程的關卡。OpenAI 近期將大量工程人力調往資安防護,並導入外部機構進行嵌入式審查,正是試圖在快速商業化與防範災難性外洩之間尋找脆弱的平衡點。
- 跨國地緣競爭與監管標準的角力:在美中科技競爭與各國爭相搶建主權 AI 的背景下,沒有任何一個國家或實驗室願意單方面停下腳步。因此,Altman 強調「不確定競爭對手是否抱持相同信念」,某種程度上也是在呼籲建立具國際約束力的安全底線與透明度規範,避免產業陷入「誰最不重視安全誰就跑得最快」的惡性競逐。
從政治經濟學的角度來看,Altman 之所以在 DealBook 峰會上高調抨擊「漸進式交權」並暗指「並不確定所有競爭對手都抱持相同信念」,背後反映的不僅是技術倫理之爭,更是爭奪 AI 治理話語權的關鍵一步。一方面,當各國政府與國會正在制定高階 AI 的審查門檻與責任歸屬時,誰能率先證明自己「堅決拒絕交出人類控制權」,誰就更有資格參與甚至主導未來的法規標準制定;另一方面,面對市場對超級智慧失控的焦慮,將「保持人類主體性」塑造成品牌核心承諾,也有助於 OpenAI 在企業客戶與資本市場中建立更高的信任護城河。
在這樣的背景下,OpenAI 與產業同業推動的「安全基準共識」顯得格外關鍵。儘管外界常將矽谷領袖的公開喊話視為公關攻防,但從技術與制度層面來看,無論是外部獨立機構的未發布模型審查,還是針對遞迴自我改進設立的安全閘門,都正在成為高階 AI 邁向商業部署前不可或缺的合規門檻。未來這場「人類控制權保衛戰」的勝負,將取決於工程技術能否跑在模型能力失控之前。
延伸閱讀:Humyn Labs 完成 4,700 萬美元融資!Accel 領投采集全球真實人類勞動數據,補齊實體 AI 訓練拼圖
常見問題(FAQ)
什麼是 AI 領域所說的「漸進式交權」(gradual handover)?
漸進式交權指的是人類並非在某一天突然被 AI 取代,而是因為 AI 系統在經濟、行政與技術決策上越來越高效可靠,人類組織出於便利或競爭壓力,逐步將原本由人類負責的判斷與管理權限交給 AI,最終在不知不覺中失去對社會運作與未來方向的實質控制力。
為什麼 Sam Altman 要在 DealBook 峰會提到「拉布拉多犬」?
這是針對 Elon Musk 過往言論的直接回應。Musk 曾表示若 AI 發展遠超人類,人類可能會像超級智慧身旁的「寵物拉布拉多犬」,雖然沒有主導權但很快樂。Altman 藉此表態反對這種願景,強調他希望自己與下一代都能保有對未來的自主權,而非被動接受系統的圈養。
什麼是「思維鏈監控失效」?這對 AI 安全有何影響?
思維鏈監控是指透過閱讀 AI 模型寫出的逐步推理文字,來判斷模型是否有不當企圖。Greg Brockman 指出,新一代模型能在內部神經網路計算(前向傳播)中直接完成複雜思考,不再把所有過程寫成文字,這會讓研究人員更難透過閱讀文字來抓出潛在的欺騙或失控風險。
既然各家巨頭都支持控制 AI 自我改進,為什麼競爭還是沒有停下來?
因為 AI 研發涉及數千億美元的基礎設施資本支出與國家戰略競爭。儘管 Altman 與 Musk 都曾表態支持放慢遞迴自我改進的步伐以確保安全,但在沒有具約束力的全球監管機制前,任何單一實驗室若片面停步,都可能面臨被競爭對手超越的商業與戰略風險。
總結
Sam Altman 與 Greg Brockman 在 2026 年 DealBook 峰會上的談話,為當前急速狂飆的 AI 產業敲響了一記關於「權力歸屬」的警鐘。從拒絕人類淪為 AI 寵物的價值宣示,到坦承思維鏈監控正在面對技術瓶頸,這場對談清楚顯示:確保人類對超級智慧的長期控制權,絕非一句口號就能達成,而是一場橫跨底層神經網路監控技術、企業內部資安工程與全球政經規則博弈的持久戰。
對一般大眾與企業決策者而言,這場高層對話也提供了一個重要觀察座標:未來評估一家 AI 實驗室的競爭力,不能只看它的模型跑分有多高、參數量有多大,更要檢視它是否具備透明的外部審查機制、能否應對隱空間推理帶來的黑箱風險,以及是否真正把「人類最終決策權」寫進產品架構與治理制度之中。唯有當技術安全防線與人類主體意識同步升級,人工智慧才可能成為放大文明潛力的工具,而非取代人類選擇權的無形主宰。